

Helló, Habr!
A koronavírus miatt kialakult helyzet fényében számos internetes szolgáltatás megnövekedett terhelést tapasztal. Például, mivel nem álltak rendelkezésre elegendő erőforrások. Nem mindig lehet csak erősebb hardver hozzáadásával felgyorsítani a szervert, azonban a vásárlói igényeket kezelni kell (különben elmennek a versenytársakhoz).
Ebben a cikkben röviden bemutatom a népszerű gyakorlatokat, amelyek lehetővé teszik a gyors és megbízható szolgáltatás kialakítását. Az általam kiválasztott fejlesztési sémák közül csak azokat emelem ki, amelyek jelenleg könnyen elérhetők.Minden egyes ponthoz vagy már léteznek könyvtárak, vagy lehetőség van a probléma megoldására felhőalapú platformon.
Horizontális skálázás
A legsimplebb és legjobban ismert pont. Általánosságban a leggyakrabban előforduló terheléselosztási sémák a horizontális és a vertikális skálázás. lehetővé teszi a szolgáltatások párhuzamos működését, ezáltal elosztva a terhelést közöttük. erősebb szervereket rendel, vagy optimalizálja a kódot.
Példának okáért egy absztrakt felhőtároló rendszer, amely hasonló az OwnCloudhoz, OneDrivehoz és így tovább.
A következő ábra egy tipikus sémát mutat be, azonban ez csak a rendszer összetettségét demonstrálja. Valahogy szinkronizálnunk kell a szolgáltatásokat. Mi történik, ha a felhasználó egy táblagépről mentette a fájlt, majd telefonon szeretné megnézni?
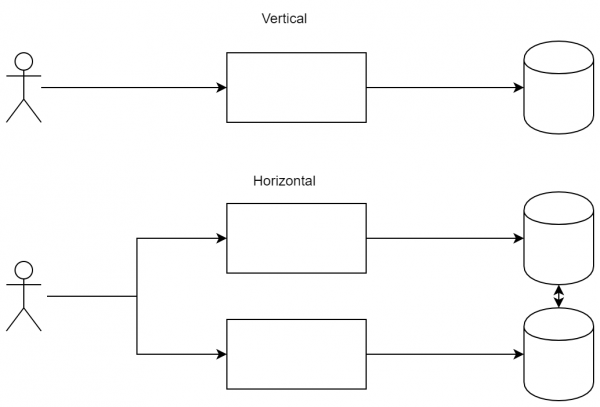
A megközelítések közötti különbség: vertikális skálázás esetén a csomópontok teljesítményét növeljük, míg horizontális skálázás esetén új csomópontokat adunk hozzá a terhelés elosztásához.
CQRS
meglehetősen fontos minta, mivel lehetővé teszi a különböző ügyfelek számára, hogy ne csak különböző szolgáltatásokhoz csatlakozzanak, hanem egyenlő eseményfolyamokat is kapjanak. Előnyei nem annyira nyilvánvalóak egy egyszerű alkalmazás esetén, azonban rendkívül fontos (és egyszerű) egy nagy terhelésű szolgáltatás számára. Lényege: a bejövő és a kimenő adatfolyamok nem metszhetik egymást. Azaz nem küldhet kérdést, és ne várjon választ; ehelyett kérdést küld a A szolgáltatásba, viszont választ kap B szolgáltatásból.
Ennek a megközelítésnek az első előnye, hogy lehetőség van a kapcsolat megszakítására (ebben a szavak tág értelmében) egy hosszú kérés teljesítése során. Vegyünk egy nagyjából szabványos folyamatot példának:
- A kliens kérdést küldött a szervernek.
- A szerver elindított egy hosszú feldolgozást.
- A szerver válaszolt a kliensnek az eredménnyel.
Tegyük fel, hogy a 2. pontban kapcsolat megszakad (vagy a hálózat újrakapcsolódik, vagy a felhasználó átmegy egy másik oldalra, megszakítva a kapcsolatot). Ebben az esetben a szerver nehezen tud válaszolni a felhasználónak arról, hogy pontosan mi lett feldolgozva. A CQRS alkalmazásával a folyamat kissé másképp alakul:
- A kliens feliratkozott a frissítésekre.
- A kliens kérdést küldött a szervernek.
- A szerver válaszolt, hogy "kérés elfogadva".
- A szerver válaszolt az eredménnyel az "1" pontból származó csatornán.
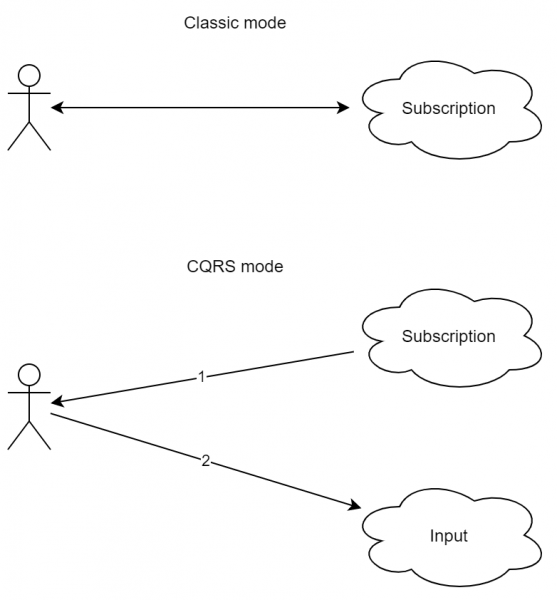
Mint látható, a rendszer kissé bonyolultabb. Ráadásul itt hiányzik az intuitív kérés-válasz megközelítés. Azonban, amint látszik, a kapcsolat megszakadása a kérés feldolgozása közben nem vezet hibához. Ráadásul, ha a felhasználó valójában több eszközhöz csatlakozik (például mobiltelefonhoz és táblagéphez), a válaszok mindkét eszközre érkezhetnek.
Érdekesség, hogy a bejövő üzenetek feldolgozásának kódja egyformán (nem 100%-ban) működik mind a kliens által kezdeményezett események, mind a többi esemény, köztük más kliens által érkezett események esetén.
Valójában azonban további előnyöket kapunk abból, hogy az egyirányú áramlást funkcionális stílusban lehet feldolgozni (RX és hasonlók használatával). Ez már komoly előny, mivel lényegében az alkalmazás teljesen reaktívvá tehető, funkcionális megközelítés alkalmazásával. Nagyobb programok esetén ez jelentősen csökkentheti a fejlesztési és karbantartási költségeket.
Ha ezt a megközelítést vízszintes skálázással kombináljuk, akkor az előny, hogy egy szerverre küldhetünk kéréseket, míg válaszokat másról kaphatunk. Így a kliens maga választhatja ki a számára kényelmes szolgáltatást, a rendszer pedig belsőleg még mindig helyesen tudja feldolgozni az eseményeket.
Eseményforrás
Ahogy tudjátok, a decentralizált rendszerek egyik fő jellemzője a közös idő és a közös kritikus szakasz hiánya. Egy folyamat esetén szinkronizálhatjuk (ugyanazokon a mutexeken), ahol biztosak vagyunk benne, hogy senki más nem futtatja ezt a kódot. Azonban egy decentralizált rendszerben ez veszélyes, mivel fölösleges erőforrásokat igényel, és megöli a skálázhatóság varázsát – végső soron minden komponens egyetlen dologra fog várni.
Ezért fontos tényt kapunk – egy gyors decentralizált rendszert nem lehet szinkronizálni, mivel ezzel csökkentenénk a teljesítményt. Másrészről azonban gyakran szükségünk van bizonyos komponensek konzisztenciájára. Erre alkalmazhatjuk a megközelítést a , ahol biztosítva van, hogy adatmódosítások hiányában, egy idő után az utolsó frissítést követően („végső soron”) minden kérés az utolsó frissített értéket fogja visszaadni.
Fontos megérteni, hogy a klasszikus adatbázisok esetében gyakran alkalmazzák a , ahol minden csomópontnak azonos információval kell rendelkeznie (ez gyakran úgy érhető el, hogy a tranzakciót csak a második szerver válaszának visszaérkezése után tekintik érvényesnek). Itt némi enyhítés van az izolációs szintek miatt, de az alapelvek változatlanok – egy teljesen konzisztens világban élhetünk.
De térjünk vissza az eredeti feladathoz. Ha a rendszer egy része építhető, akkor felállítható a következő séma.
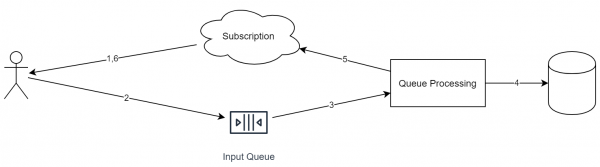
A megközelítés fontos jellemzői:
- Minden bejövő kérés egy sorba kerül.
- A kérés feldolgozása során a szolgáltatás további feladatokat is elhelyezhet más sorokban.
- Minden bejövő eseménynek van egy azonosítója (amely a deduplikáláshoz szükséges).
- A sor elvileg az "append only" elv szerint működik. Nem lehet elemeket eltávolítani belőle vagy átrendezni őket.
- A sor FIFO (első bejövő, első kimenő) elv alapján működik (elnézést a tautológiáért). Ha párhuzamos végrehajtásra van szükség, akkor a folyamat egyik szakaszában az objektumokat különböző sorokba kell áthelyezni.
Emlékeztetnék rá, hogy az online fájlmegosztó rendszert vizsgáljuk. Ebben az esetben a rendszer körülbelül így fog kinézni:
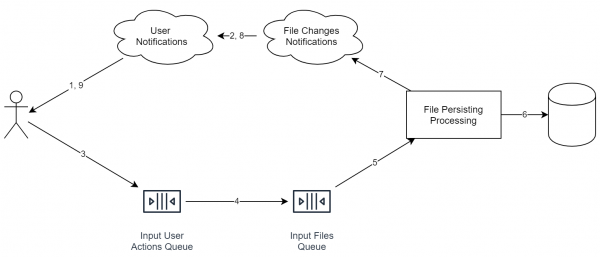
Fontos, hogy a diagramon szereplő szolgáltatások nem feltétlenül jelentenek különálló szervereket. Még a folyamat is ugyanaz lehet. A lényeg más: ideológiailag ezeket a dolgokat úgy választották el, hogy könnyen alkalmazható legyen a vízszintes skálázás.
Két felhasználó esetén a séma így fog kinézni (a különböző felhasználóknak szánt szolgáltatásokat különböző színekkel jelölik):
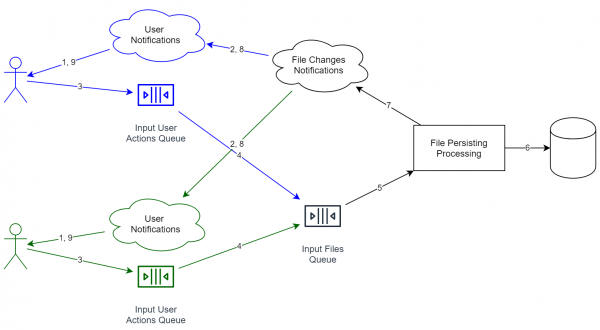
Az ilyen kombináció előnyei:
- Az információfeldolgozó szolgáltatások elkülönülnek. A küldemények is elkülönülnek. Ha növelnünk kell a rendszer áteresztőképességét, csupán több szolgáltatást kell indítanunk több szerveren.
- Amikor információt kapunk a felhasználótól, nem muszáj megvárnunk az adatok teljes mentését. Éppen ellenkezőleg, elegendő válaszolnunk „rendben”, majd fokozatosan elkezdhetjük a munkát. A küldemények ugyanakkor simítják a csúcsokat, mivel az új objektumok gyorsan adhatók hozzá, és a felhasználónak nem kell várnia a teljes cikluson.
- Példának hoztam egy deduplikáló szolgáltatást, amely megpróbálja egyesíteni az azonos fájlokat. Ha ez az 1%-os esetekben hosszú ideig fut, a kliens szinte nem fogja észrevenni (lásd fent), ami nagy előny, mivel már nem várunk el 100%-os sebességet és megbízhatóságot tőlünk.
Ugyanakkor azonnal láthatók a hátrányok is:
- A rendszerünkből hiányzik a szigorú koherencia. Ez azt jelenti, hogy ha például különböző szolgáltatásokra iratkozunk fel, elvileg különböző állapotokat kaphatunk (mivel az egyik szolgáltatás nem biztos, hogy időben megkapja a belső küldeményértesítést). Mint egy másik következmény, a rendszernek most nincs közös ideje. Tehát például nem lehet rendezni az összes eseményt egyszerűen az érkezési idő alapján, mivel a szerverek között lévő órák nem szinkronizáltak (többek között, hogy két szerveren ugyanaz az idő egy utópia).
- Most már nem lehet egyszerűen visszagörgetni eseményeket (ahogy azt az adatbázissal lehetne). Ehelyett új eseményt kell hozzáadni — , amely megváltoztatja az utolsó állapotot a szükségesre. Példaként egy hasonló területen: történet újbóli írása nélkül (ami bizonyos esetekben rossz) a git-ben nem lehet visszagörgetni egy commitot, azonban lehetőség van egy speciális , amely alapvetően csak a régi állapotot állítja vissza. Azonban a történetben megmarad a hibás commit és a rollback is.
- Az adatséma a kiadásokkal változhat, azonban a régi eseményeket most már nem lehet frissíteni az új szabványra (mivel az eseményeket elvileg nem lehet változtatni).
Ahogy látható, az Event Sourcing kiválóan működik a CQRS-sel. Sőt, egy hatékony és kényelmes sorozat érdekében, de anélkül, hogy az adatok folyamatait elválasztanánk, már önmagában is nehéz, mivel szinkronizálási pontokat kell hozzáadni, amelyek csökkentik a sorok összes pozitív hatását. Ha mindkét megközelítést egyszerre alkalmazzuk, akkor a program működésének kódját enyhén ki kell igazítani. A mi esetünkben, amikor fájlt küldünk a szerverre, a válaszban csak "ok" érkezik, ami csak azt jelenti, hogy "a fájl hozzáadására vonatkozó művelet megtörtént". Formálisan ez nem jelenti, hogy az adatok már elérhetők más eszközökön (például a deduplikáló szolgáltatás újraépítheti az indexet). Azonban egy idő után a kliens értesítést kap, hogy "az X fájl mentve lett".
Ennek eredményeként:
- A fájlok küldésének státusza nő: a klasszikus "fájl elküldve" helyett két státuszt kapunk: "fájl hozzáadva a szerver sorához" és "fájl mentve a tárolóba". Az utóbbi azt jelenti, hogy más eszközök már megkezdhetik a fájl beszerzését (figyelembe véve, hogy a sorok különböző sebességgel működnek).
- Mivel az elküldés információi most különböző csatornákon érkeznek, megoldásokat kell kitalálnunk ahhoz, hogy megkapjuk a fájl feldolgozásának státuszát. Ebből következik, hogy ellentétben a klasszikus kérés-válasz modellel, a kliens újraindítható a fájl feldolgozása közben, azonban a feldolgozás státusza helyes lesz. Ráadásul ez a pont lényegében dobozból eredően működik. Következésképpen most jobban toleráljuk a hibákat.
Sharding
Ahogy már korábban említettük, az eseményalapú rendszerekben nincs szigorú konzisztencia. Ezért használhatunk több tárolót bármilyen szinkronizálás nélkül. A feladatunkhoz közelítve, megtehetjük:
- A fájlokat típusok szerint elosztani. Például a képeket/videókat dekódolhatjuk és a hatékonyabb formátumot választhatjuk.
- Fiókok országok szerint történő szétválasztása. Sok törvény miatt ez szükséges lehet, azonban ez az architekturális séma automatikusan lehetővé teszi ezt.
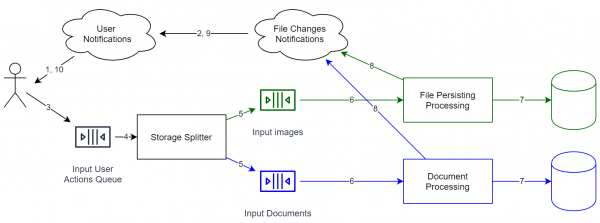
Ha adatokat szeretne áthelyezni egyik tárolóból a másikba, akkor itt már nem használhatók a hagyományos eszközök. Sajnos ilyen esetben meg kell állítani a sort, elvégezni a migrációt, majd újraindítani azt. Általános esetben az adatokat nem lehet "élesben" áthelyezni, azonban ha az eseménysor teljesen tárolva van, és van másolatunk a tároló előző állapotairól, akkor újrajátszhatjuk az eseményeket a következő módon:
- Az Event Source-ban minden eseménynek van egy azonosítója (ideálisan nem csökkenő). Ezért a tárolóhoz hozzáadhatunk egy mezőt — az utolsó feldolgozott elem azonosítóját.
- Megkettőzzük a sort, hogy minden esemény feldolgozható legyen több független tároló számára (az első az, amelyben jelenleg is tárolva vannak az adatok, míg a második új, de egyelőre üres). A második sort természetesen még nem dolgozzuk fel.
- Elindítjuk a második sort (azaz elkezdjük az események újrajátszását).
- Amikor az új sor viszonylag üres lesz (azaz az elemek hozzáadásának és eltávolításának közötti átlagos időeltérés elfogadható), el lehet kezdeni az olvasók átkapcsolását az új tárolóra.
Mint látható, a rendszerünkben sohasem volt szigorú konzisztencia. Csak a végső konzisztencia létezik, ami azt jelenti, hogy az események ugyanabban a sorrendben kerülnek feldolgozásra (bár eltérő késéssel). Ezt kihasználva viszonylag egyszerűen át tudjuk helyezni az adatokat anélkül, hogy megállítanánk a rendszert a világ másik végére.
Így folytatva a példát az online fájltárolóról, hasonló architektúra már számos bónuszt ad számunkra:
- Képesek vagyunk az objektumokat közelebb helyezni a felhasználókhoz, dinamikusan. Ezzel javítható a szolgáltatás minősége.
- A cégek belső adatokat is tárolhatnak. Például az Enterprise felhasználók gyakran megkövetelik, hogy adataikat ellenőrzött adatközpontokban tárolják (elkerülve az adatlopást). A sharding segítségével könnyedén támogatni tudjuk ezt. A feladat még egyszerűbbé válik, ha a megrendelőnek van egy kompatibilis felhője (például, ).
- A legfontosabb dolog, hogy ezt nem muszáj megtennünk. Kezdetben elég lenne egy tároló minden fiók számára (hogy gyorsabban elkezdhessük a munkát). Ennek a rendszernek a kulcsfontosságú jellemzője az, hogy bár bővíthető, kezdetben egész egyszerű. Csak annyira van szükség, hogy ne kelljen azonnal olyan kódot írni, amely milliónyi különálló független sorral dolgozik, stb. Ha szükséges, ezt a jövőben meg lehet csinálni.
Statikus Tartalom Tárhely
Ez a pont talán teljesen nyilvánvalónak tűnik, mégis nélkülözhetetlen egy viszonylag standard, nagy terhelésű alkalmazáshoz. A lényege egyszerű: az összes statikus tartalom nem arról a szerverről kerül kiadásra, ahol az alkalmazás található, hanem speciális, kifejezetten erre a célra kijelölt szerverekről. Ennek következményeként ezek a műveletek gyorsabban hajtódnak végre (a feltételezett nginx gyorsabban és költséghatékonyabban szolgáltat fájlokat, mint a Java-szerver). Ráadásul a CDN architektúra () lehetővé teszi, hogy a fájljainkat közelebb helyezzük a végfelhasználókhoz, ami pozitívan hat a szolgáltatás használhatóságára.
A legjobb és legtipikusabb példa statikus tartalomra egy weboldalhoz tartozó script- és képgyűjtemény. Ezekkel minden egyszerű: előre ismertek, majd az archívumot feltöltjük a CDN szerverekre, ahonnan a végfelhasználókhoz terítjük őket.
Valójában azonban a statikus tartalomra egy olyan megközelítést is alkalmazhatunk, amely hasonlít a lambda architektúrához. Térjünk vissza a feladatunkhoz (online fájltároló), amelyben a felhasználóknak fájlokat kell szolgáltatnunk. A legegyszerűbb megoldás közvetlenül az, hogy létrehozunk egy szolgáltatást, amely minden egyes felhasználói kérésre elvégez minden szükséges ellenőrzést (hitelesítés stb.), majd letölti a fájlt közvetlenül a tárolónkból. Ennek a megközelítésnek a legnagyobb hátránya, hogy a statikus tartalmat (mivel a meghatározott verziójú fájl valójában statikus tartalom) ugyanaz a szerver szolgáltatja, amely tartalmazza az üzleti logikát. Ehelyett létrehozhatunk egy következő sémát:
- A szerver URL-t ad a letöltéshez. Ez lehet file_id + key formátumú, ahol a key egy mini digitális aláírás, amely jogot ad a forráshoz való hozzáféréshez a következő egy napra.
- A fájlterítéshez egy egyszerű nginx felel, a következő opciókkal:
- Tartalom gyorsítótárazása. Mivel ez a szolgáltatás külön szerveren lehet, a jövőbeni igényekre is készítettünk némi tartalékot az utolsó letöltött fájlok lemezen való tárolásának lehetőségével.
- A kulcs ellenőrzése a kapcsolat létrehozásának pillanatában.
- Opcionálisan: tartalom folyamatos feldolgozása. Például, ha minden fájlt tömörítünk a szolgáltatásban, akkor a kicsomagolást közvetlenül ebben a modulban végezhetjük. Ennek következtében: az I/O műveletek ott zajlanak, ahol a legjobban illenek. A Java alapú archíváló sok felesleges memóriát igényelhet, de a szolgáltatás átírása üzleti logikával állapotgyakran használt Rust/C++ nyelvekre szintén nem biztos, hogy hatékony. Az esetünkben különböző folyamatokat (vagy akár szolgáltatásokat) használunk, így hatékonyan szétválasztható az üzleti logika és az I/O műveletek.
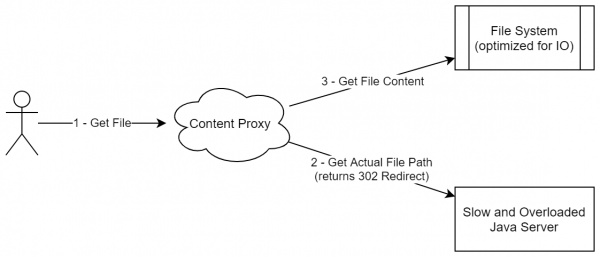
Ez a séma nem túlságosan hasonlít a statikus tartalom terjesztésére (mivel nem töltjük fel az összes statikus csomagot valahova), de a valóságban ez a megközelítés éppen az immutable adatok terjesztésével foglalkozik. Sőt, ezt a sémát más esetekre is általánosíthatjuk, amikor a tartalom nemcsak statikus, hanem egy nem módosítható és nem törölhető blokkok összességeként is megjelenhet (bár ezek hozzáadhatók).
Még egy példa (megerősítésül): ha dolgozott a Jenkins/TteamCity programmal, tudja, hogy mindkét megoldás Java nyelven készült. Mindkettő egy Java folyamat, amely a build-ek orkestrálásával, valamint a tartalom kezelésével foglalkozik. Különösen mindkettő rendelkezik olyan feladatokkal, mint a "fájl/mappa átadása a szerverről". Például: artefaktumok kiadása, a forráskód átvitele (amikor az ügynök nem közvetlenül a repóból tölti le a kódot, hanem azt a szerver végzi), naplókhoz való hozzáférés. Mindezek a feladatok különböző I/O terhelésekkel bírnak. Tehát a szerver, amely a bonyolult üzleti logikáért felel, hatékonyan kell, hogy kezelje a nagy adatmennyiségek áterjedését. És ami a legérdekesebb, hogy hasonló műveletet a nginx-re is delegálhatunk pontosan így (csak annyit kell a kéréshez hozzáadni, hogy a kulcsadatokat is megadjuk).
Ha azonban visszatérünk a rendszerünkhöz, akkor a következő séma jön létre:
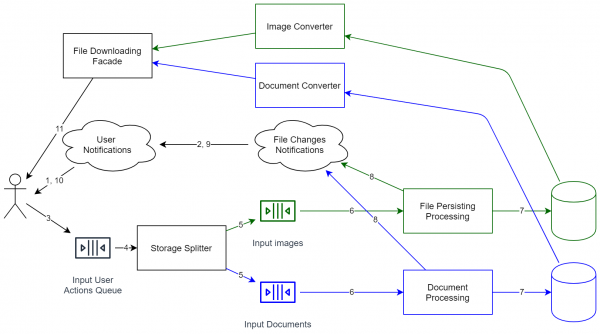
Amint látható, a rendszer radikálisan bonyolultabbá vált. Most már nem csupán egy mini-processzor, amely helyben tárolja a fájlokat. Most már nem a legegyszerűbb támogatásra van szükség, API verzióellenőrzésre stb. Ezért, miután minden diagramot elkészítettek, a legjobb, ha részletesen értékeljük, hogy megérik-e az ilyen költségek a skálázhatóság. Azonban ha szeretné bővíteni a rendszert (beleértve még több felhasználó kezelését), akkor ilyen megoldásokra lesz szükség. Ennek köszönhetően a rendszer architektúrája készen áll a terhelés növelésére (gyakorlatilag minden komponenst klónozni lehet a vízszintes skálázás érdekében). A rendszert leállítás nélkül lehet frissíteni (csak néhány művelet kissé lelassul).
Ahogy az elején már említettem, mostanában több internetes szolgáltatás is fokozott terhelést kap. Néhányuk egyszerűen leállt a megfelelő működésről. A rendszerek gyakorlatilag akkor mondták fel a szolgálatot, amikor a vállalkozásnak pénzt kellett volna keresnie. Tehát ahelyett, hogy késleltetett szállítást kínálnának, vagy azt javasolnák az ügyfeleknek, hogy "tervezzék meg a szállítást a következő hónapokban", a rendszer egyszerűen azt mondta: "menjetek a versenytársakhoz". Valójában ez az alacsony teljesítmény ára: a veszteségek pont akkor fordulnak elő, amikor a nyereség a legmagasabb lenne.
Zárás
Mindezek a megközelítések már régóta ismertek. A VK már régóta használja a statikus tartalom tárolásának ötletét a képek megjelenítésére. Számos online játék alkalmaz egy sharding rendszert a játékosok regionális elosztására vagy a játéktérképek megosztására (ha a világ egységes). Az eseményforrás megközelítést aktívan használják az elektronikus levelezésben. A kereskedők többségi alkalmazásai, ahol folyamatosan érkeznek az adatok, valójában a CQRS megközelítésen alapulnak, hogy szűrni tudják a beérkező adatokat. A vízszintes skálázást pedig már régen alkalmazzák számos szolgáltatásban.
Ami a legfontosabb, hogy ezek a minták mostanában nagyon könnyen alkalmazhatóak a modern alkalmazásokban (ha persze relevánsak). A felhők kínálnak shardingot és vízszintes skálázást egyszerre, ami sokkal könnyebb, mint különböző dedikált szerverek rendelése a különböző adatközpontokban. A CQRS használata is sokkal egyszerűbb lett, legalábbis az RX bibliotékák fejlődése miatt. Tíz éve egy weboldal ritkán tudta volna ezt támogatni. Az eseményalapú forrásgyűjtés is hihetetlenül könnyen beállítható, köszönhetően az Apache Kafka-hoz készült konténereknek. Tíz éve ez innovációnak számított, ma már a megszokott. Hasonló a statikus tartalom hostinggal: a kényelmesebb technológiáknak (többek között a részletes dokumentáció és a nagy válaszadatbázis miatt) ez a megközelítés még egyszerűbbé vált.
Összességében a több elég bonyolult architektúra minta megvalósítása most sokkal egyszerűbbé vált, ezért érdemes előre megfontolni. Ha egy évtizeddel ezelőtt egy alkalmazás elvetett egy fenti megoldást a bevezetés és működtetés magas költsége miatt, akkor most, egy új alkalmazás esetén, vagy a refaktorálás után, kialakítható egy olyan szolgáltatás, amely architektúrájában már bővíthető (teljesítmény szempontjából), és képes lesz új ügyféligények kiszolgálására (például a személyes adatok lokalizálásához).
És ami a legfontosabb: kérjük, ne használja ezeket a megközelítéseket, ha az alkalmazása egyszerű. Igen, szépek és érdekesek, de egy 100 fős csúcsforgalmú weboldal esetén gyakran elegendő egy klasszikus monolit (legalábbis kívülről, belül már minden modulisítható, stb.).
Forrás: habr.com
