

Azonnal elmagyarázom a cikk címét. Eredetileg jó, megbízható tanácsot akartam adni a reflexió használatának felgyorsítására egy egyszerű, de reális példán keresztül, de a benchmarking során kiderült, hogy a reflexió nem olyan lassú, mint gondoltam, a LINQ pedig lassabb, mint álmaimban. A végén még egy hibát is vétettem a mérésekben... Ennek a történetnek a részletei a kattintás után és a megjegyzésekben. Mivel a példa elég hétköznapi és alapvetően úgy lett megvalósítva, ahogy a vállalatokban szokás, számomra elég érdekesnek tűnik a bemutató: a cikk fő téma sebességére gyakorolt hatás nem volt észlelhető a külső logika miatt: Moq, Autofac, EF Core és más „körítés” miatt.
Az inspirációmat egy cikk hatására kezdtem el:
Mint látható, a szerző javasolja a lefordított delegátok használatát a reflexiós típusok módszereivel való közvetlen hívás helyett, mint a program gyorsításának remek módját. Természetesen van még IL kibocsátás is, de azt el szeretném kerülni, mivel ez a legmunkaigényesebb módja a feladat elvégzésének, ami sok hibát rejt magában.
Figyelembe véve, hogy mindig is hasonló véleményen voltam a reflexió sebességéről, nem szándékozom megkérdőjelezni a szerző következtetéseit.
Gyakran találkozom a reflexió naiv használatával a vállalati környezetben. Egy típust veszünk. Eszköz információt szerzünk. Meghívjuk a SetValue metódust, és mindenki boldog. Az érték eljutott a célmezőbe, mindenki elégedett. Az emberek nem buták — szeniorok és csapatvezetők — a saját kiterjesztéseiket írják az object-re, egy ilyen naiv megvalósítás alapján, „univerzális” mapper-eket egy típusból a másikba. A lényeg általában az: minden mezőt és minden tulajdonságot veszünk, iterálunk rajtuk: ha a tagok nevei megegyeznek, végrehajtjuk a SetValue-t. Időnként kivételeket fogunk el ott, ahol nem találtunk egy tulajdonságot az egyik típusnál, de itt is van megoldás, ami javítja a teljesítményt: Try/catch.
Láttam, hogy az emberek újra feltalálják a parsereket és a mappereket, anélkül, hogy teljes körű információval rendelkeznének arról, hogyan működik a már régebben kitalált kerék. Láttam, hogy az emberek ügyes megvalósításaikat elrejtik stratégiák, interfészek vagy injekciók mögé, mintha ez mentegethetné a későbbi káoszt. Az ilyen megvalósításoktól elfordultam. Valójában a valódi teljesítménycsökkenést soha nem mértem, és ha lehetőségem volt rá, egyszerűen kicseréltem a megvalósítást egy „optimálisabbra”, ha éppen úgy alakult. Így az első mérések, amelyekről alább lesz szó, igazán megleptek.
Azt hiszem, sokan közületek, amikor Richter-t vagy más ideológusokat olvasnak, találkoztak azzal a teljesen jogos állítással, hogy a kódon belüli reflexió rendkívül negatívan hat az alkalmazás teljesítményére.
A reflexió meghívása arra kényszeríti a CLR-t, hogy bejárja a gyűjteményeket a keresett metadadatok után kutatva, betölti azokat és feldolgozza stb. Ezen kívül a reflexió a sorrend bejárása során nagy mennyiségű memória allokálását eredményezi. A memóriafogyasztás közben a CLR megmozdítja a GC-t, és elkezdődnek a fagyások. Ennek lassúnak kellene lennie, hidd el. A modern produkciós szerverek vagy felhőgépek óriási memória mennyisége sem ment meg a magas feldolgozási késleltetésektől. Valójában, minél több memória áll rendelkezésre, annál valószínűbb, hogy ÉSZRE FOGOD VENNI, hogyan működik a GC. A reflexió elvileg egy felesleges piros rongy számára.
Ennek ellenére mindannyian használunk IoC konténereket és adatmappereket, amelyek működési elve szintén a reflexión alapul, azonban ezek teljesítményének általában nincsenek kérdései. Nem, nem azért, mert a függőségek bevezetése és a külső, korlátozott kontextusból való elvonás olyan szükséges dolgok, hogy a teljesítményt bármilyen esetben fel kell áldoznunk. Minden sokkal egyszerűbb – ezek valóban nem gyakorolnak jelentős hatást a teljesítményre.
Az a helyzet, hogy a legelterjedtebb keretrendszerek, amelyek a reflexió technológiáján alapulnak, különféle fortélyokat használnak a hatékonyabb működés érdekében. Általában cache-t használnak. Általában – ezek kifejezések és a kifejezésfán átkonvertált delegáltak. A legjobb automapper egy versenyképes szótárral rendelkezik, amely párosítja a típusokat azzal a funkcióval, amelyik már anélkül tudja átkonvertálni őket, hogy szükség lenne a reflexió meghívására.
Hogyan érhető el ez? Lényegében nem különbözik attól a logikától, amelyet maga a platform használ a JIT kódgenerálásához. Az első metódushíváskor az lefordításra kerül (és igen, ez a folyamat nem gyors), a következő hívásoknál viszont a vezérlés már a lefordított metódushoz kerül, és itt nem lesz jelentős teljesítménycsökkenés.
A mi esetünkben is alkalmazhatjuk a JIT fordítást, és ezután a lefordított viselkedést azonos teljesítménnyel használhatjuk, mint az AOT analógjait. Ebből a szempontból a kifejezések segítségünkre lesznek.
Röviden összefoglalva, a tárgyalt elv a következőképpen fogalmazható meg:
A reflektálás végső eredményét érdemes delegátusként tárolni, amely tartalmazza a lefordított funkciót. Minden szükséges objektumot a típusokról szintén érdemes egy, a típusaid, azaz a munkavállalók által tárolt mezőn kívül cache-elni.
Van ebben logika. Az egészséges ész azt mondja, hogy ha valami lefordítható és cache-elhető, akkor azt érdemes megtenni.
Előrehaladva érdemes megemlíteni, hogy a reflektálás során alkalmazott cache-nek vannak előnyei, még ha nem is használjuk az előzőekben javasolt kifejezés-fordítási módszert. Ezt a cikk szerzőjének tézisét csak megismétlem, amelyre fentebb hivatkoztam.
Most pedig a kódra. Nézzünk meg egy példát, amely a legutóbbi problémán alapul, amellyel egy komoly hitelintézet komoly termelésében kellett szembenéznem. Minden entitás fiktív, hogy senki ne találhassa ki.
Van egy entitás. Hívjuk Contact-nak. Vannak olyan levelek, amelyek standardizált tartalommal rendelkeznek, amelyekből a parser és a hidratáló létrehozza ezeket a kontakteket. Megérkezik egy levél, elolvassuk, kulcs-érték párokra bontjuk, létrehozzuk a kontaktot, és mentjük az adatbázisba.
Ez elemi dolog. Tegyük fel, hogy a kontakt rendelkezik néhány tulajdonsággal: Név, Kor és elérhetőség. Ezeket az adatokat a levélben adjuk át. A vállalkozás azt is szeretné, ha a támogató csapatok gyorsan hozzá tudnának adni új kulcsokat az entitás tulajdonságainak párokra történő térképezéséhez a levél testében. Abban az esetben, ha valaki hibázott a sablonban, vagy ha a kiadás előtt sürgősen el kell indítani a térképezést egy új partnerről, alkalmazkodva az új formátumhoz. Ekkor az új térképezési korrelációt olcsó adatfixként tudjuk hozzáadni. Tehát, ez egy valós példa.
Tesztelünk, létrehozunk teszteket. Működik.
A kódot nem fogom bemutatni: sok forrás keletkezett, és elérhetők a GitHubon a cikk végén található linken. Letöltheti őket, teljesen átkonfigurálhatja, és lemérheti, hogy ez hogyan hatna az ön esetére. Csak két sablonmódszer kódját mutatom be, amelyek megkülönböztetik a gyors hidratort a lassú hidratortól.
A logika a következő: a sablonmódszer párt kap, amelyeket a parser alaplogikája alakít. A LINQ szintje a parser és a hidratáló alaplogikája, amely lekérdezést végez az adatbázis kontextusán, és párokat rendel össze a parser kulcsaival (az ilyen funkciókhoz van kód LINQ nélkül összehasonlításra). Ezután a párok átkerülnek a fő hidratáló módszerbe, és az értékek beállítása történik az entitás megfelelő tulajdonságaiba.
A "Gyors" (Fast előtag a benchmarkokban):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Ahogy látjuk, statikus gyűjteményt használunk a tulajdonságok setterjeivel – ezek kompilált lambda kifejezések, amelyek az entitás setterét hívják. A következő kóddal hozzák létre:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
Összességében érthető. Bejárjuk a tulajdonságokat, delegáltakat hozunk létre, amelyek a settereket hívják, és eltároljuk. Ezután hívjuk őket, amikor szükség van rájuk.
A "Lassú" (Slow előtag a benchmarkokban):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Itt azonnal bejárjuk a tulajdonságokat, és közvetlenül meghívjuk a SetValue-t.
A példa kedvéért és demonstrációként elkészítettem egy egyszerű módszert, amely közvetlenül a párkapcsolatok korrelációs értékeit írja az entitás mezőibe. Előtag – Manual.
Most pedig vegyük a BenchmarkDotNet-t és vizsgáljuk meg a teljesítményt. És hirtelen... (spoiler — ez nem a helyes eredmény, a részletek lentebb)
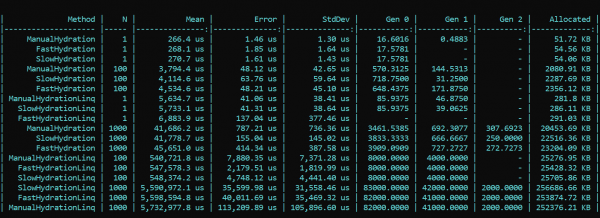
Mit látunk itt? A Fast előtagot viselő módszerek szinte minden futásnál lassabbak, mint a Slow előtagot viselők. Ez érvényes a memóriafoglalásra és a működési sebességre egyaránt. Másrészről a gyönyörű és elegáns térképezési megvalósítás, amely mindenhol a lehető legjobban használja a LINQ-ra tervezett módszereket, jelentősen rontja a teljesítményt. A különbség nagyságrendi. A tendencia nem változik a futások számának változásával. A különbség csupán a mértékekben van. A LINQ-nal 4 – 200-szor lassabb, a hulladék pedig körülbelül hasonló arányban nő.
FRISSÍTVE
Nem hittem a szememnek, de ami még fontosabb, hogy sem a saját szememnek, sem a kódomnak nem hitte el kollégánk — . Miután újraellenőrizte a megoldásomat, nagyszerűen felfedezte és rámutatott egy hibára, amelyet a végrehajtás során végrehajtott számos módosítás miatt a kezdeti és a végső implementáció között kihagytam. A Moq beállításban felfedezett hiba javítása után az összes eredmény a helyére került. A újbóli tesztelés eredményeinél a fő tendencia nem változik – a LINQ továbbra is nagyobb hatással van a teljesítményre, mint a reflexió. Azonban örömteli, hogy az Expression-ök fordításával végzett munka nem volt hiábavaló, és az eredmény látható a memóriafoglalásban és a végrehajtási időben is. Az első indítás, amikor a statikus mezők inicializálódnak, a „gyors” módszernél értelemszerűen lassabb, de később a helyzet megváltozik.
Itt van a újbóli tesztelés eredménye:
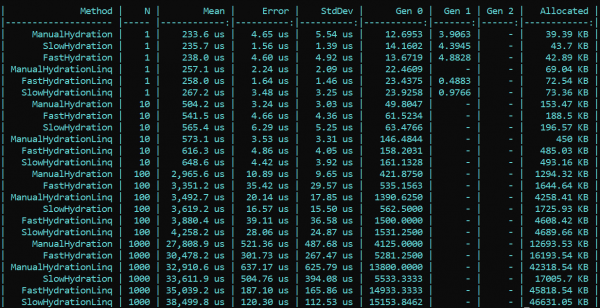
Következtetés: vállalati környezetben a reflexió használatakor különös trükkökre nincs szükség – a LINQ jelentősen csökkenti a teljesítményt. Ennek ellenére a magas terhelésű módszerek esetében, amelyek optimalizálást igényelnek, a reflexiót megőrizhetjük inicializálókként és delegátum fordítókként, amelyek később a „gyors” logikát biztosítják. Így megőrizheti a reflexió rugalmasságát és az alkalmazás gyorsaságát.
A benchmarkkód itt elérhető. Minden érdeklődő ellenőrizheti a szavaimat:
PS: A tesztekhez használt kód IoC-t alkalmaz, míg a benchmarkokhoz explicite építkezik. A végső megvalósításban levágtam minden olyan tényezőt, ami befolyásolhatja a teljesítményt és zavarossá teheti az eredményt.
PPS: Köszönet a felhasználónak a Moq konfigurációm hibájának felfedezéséért, ami hatással volt az első mérésekre. Ha valakinek a kedves olvasók közül elég karmája van, kérlek like-oljátok őt. Az illető megállt, belemerült, újraellenőrizte és felhívta a figyelmet a hibára. Úgy gondolom, hogy ez tiszteletre és szimpátiára méltó.
PPPS: Köszönet annak a precíz olvasónak, aki a stílushoz és megjelenéshez ragaszkodott. Az egységességért és kényelmességért vagyok felelős. A diplomáciai bemutatás hagy némi kívánnivalót maga után, de a kritikát figyelembe vettem. Kérem, közelítsenek a célszerszámhoz.
Forrás: habr.com
