

Javaslom, hogy ismerkedjen meg Alekszandr Valjalkin 2019 végi előadásának "Go optimalizálások a VictoriaMetrics-ban" átírásával.
— gyors és skálázható DBMS az időalapú adatok tárolására és feldolgozására (a feljegyzés az időt és az ehhez az időhöz kapcsolódó értékek egy halmazát képviseli, például a szenzorok állapotának periódikus lekérdezésén vagy a metrikák gyűjtésén keresztül).
Itt található az előadás videója —
Mesélek egy kicsit magamról. Én vagyok Alekszandr Valjalkin. Itt van . Érdekel a Go nyelv és a teljesítményoptimalizálás. Sok hasznos és kevésbé hasznos könyvtárat írtam. Ezek vagy a fastvagy a quick előtaggal kezdődnek.
Jelenleg a VictoriaMetrics-en dolgozom. Mi ez és mit csinálok ott? Erről fogok beszélni ebben a prezentációban.
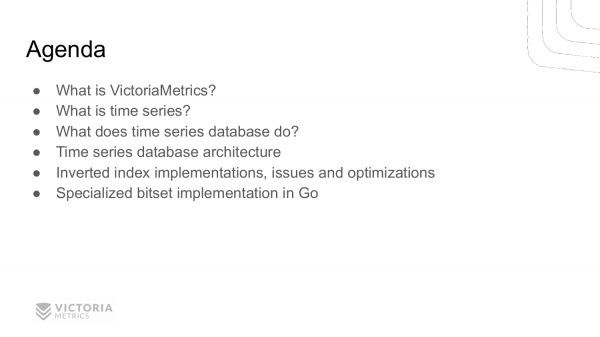
Az előadás terve a következő:
- Először elmondom, mi az a VictoriaMetrics.
- Ezután mesélek az időalapú sorokról.
- Majd elmondom, hogyan működik az időalapú adatbázis.
- Továbbá beszélek az adatbázis architektúrájáról: miből áll.
- Végül áttérek a VictoriaMetrics-ban található optimalizációkra. Ezek közé tartozik a megfordított index optimalizálása és a Go nyelv bitset megvalósításának optimalizálása.
Tudja valaki a VictoriaMetrics-t a teremben? Nincs mit tenni, már sokan ismerik. Ez jó hír. Akik nem ismerik— ez az időalapú sorok adatbázisa. A ClickHouse architektúrájára épül, néhány részlet a ClickHouse megvalósításából. Például olyanok, mint: MergeTree, párhuzamos számítás minden elérhető processzortagon, és a teljesítményoptimalizálás a processzor cache-be helyezett adatrészeken végzett munkával.
A VictoriaMetrics a legjobb adatkompressziót biztosít más időalapú adatbázisokhoz képest.
Függőlegesen skálázható — azaz több processzort és több memóriát adhat hozzá egy gépen. A VictoriaMetrics sikeresen kihasználja ezeket a rendelkezésre álló erőforrásokat és javítja a lineáris teljesítményt.
A VictoriaMetrics vízszintesen is skálázható — azaz további csomópontokat adhat hozzá a VictoriaMetrics klaszterhez, és a teljesítménye majdnem lineárisan nő.
Ahogy kitaláltad, a VictoriaMetrics egy gyors adatbázis, mert másról nem tudok beszélni. Go nyelven íródott, ezért erről mesélek ezen a meetup-on.
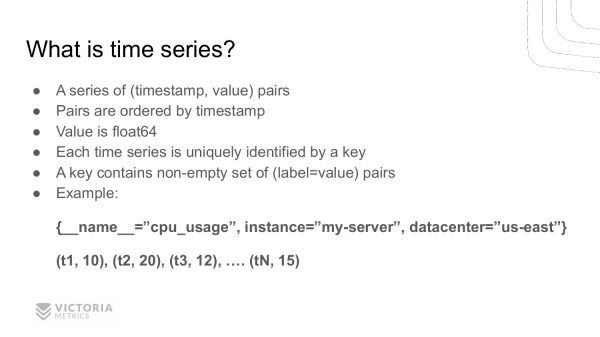
Ki tudja, mi az a időszaki sor? Sok ember tudja. Az időszaki sor egy pár sorozatot jelent (timestamp, érték), ahol ezek a párok időrendben vannak rendezve. Az érték egy lebegőpontos számot jelent – float64.
Minden időszaki sort egy egyedi kulcs azonosít. Mi alkotja ezt a kulcsot? Ez egy nem üres kulcs-érték pár halmazból áll.
Íme egy példa egy időszaki sorra. Ennek a sornak a kulcsa a következő párok listája: __name__="cpu_usage" – ez a metrika neve, instance="my-server" — ez az a számítógép, ahol ezt a metrikát összegyűjtötték, datacenter="us-east" — ez az adatközpont, ahol ez a számítógép található.
Így kaptunk egy időszaki sor nevet, amely három kulcs-érték párból áll. Ehhez a kulcshoz a következő párok listája tartozik: (timestamp, érték). t1, t3, t3, ..., tN — ezek az időbélyegek, 10, 20, 12, ..., 15 — a megfelelő értékek. Ez a cpu-usage az adott időpontban a megadott sorhoz.
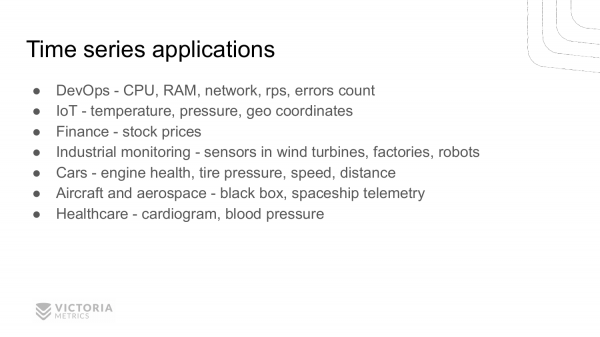
Hol lehet használni az időszaki sorokat? Valakinek van ötlete?
- A DevOps-ban a CPU, RAM, hálózat, rps, hibák száma stb. terhelését lehet mérni.
- IoT – mérhetjük a hőmérsékletet, nyomást, földrajzi koordinátákat és még sok mást.
- A pénzügyekben – nyomon követhetjük a különböző részvények és valuták árait.
- Ezen kívül az időszaki sorok használhatók a gyártási folyamatok monitorozására a gyárakban. Vannak felhasználóink, akik a VictoriaMetrics-t használják szélerőművek, robotok monitorozására.
- Az időszaki sorok hasznosak különböző eszközök szenzorainak információinak gyűjtésére is. Például a motorok esetében; a gumiabroncsok nyomásának mérésére; a sebesség, távolság mérésére; üzemanyag-fogyasztás mérésére stb.
- Az időszaki sorokat repülőgépek monitorozására is használják. Minden repülőgépen van egy fekete doboz, amely időszaki sorokat gyűjt a repülőgép egészségi paramétereiről. Az időszaki sorokat az űriparban is használják.
- Egészségügy – a vérnyomás, pulzus stb.
Lehet, hogy még vannak olyan alkalmazások, amelyekről megfeledkeztem, de remélem, hogy megértetted, hogy az időszaki sorokat aktívan használják a modern világban. És a használatuk volumene évről évre nő.
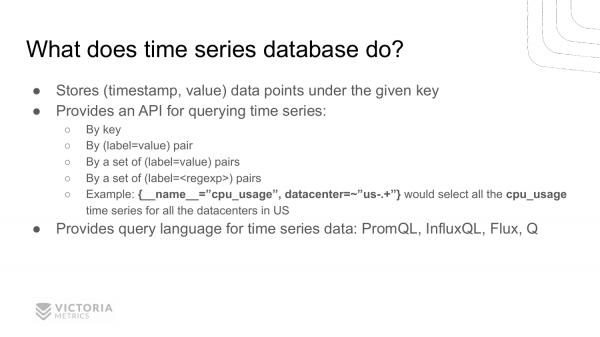
Miért szükséges az időszakos adatokhoz adatbázis? Miért nem lehet használni a hagyományos relációs adatbázist időszakos adatok tárolására?
Mert az időszakos adatok általában nagy mennyiségű információt tartalmaznak, amelyet nehéz hagyományos adatbázisokban tárolni és feldolgozni. Ezért jöttek létre a specializált adatbázisok időszakos adatokhoz. Ezek az adatbázisok hatékonyan tárolják a pontokat (timestamp, érték) megadott kulccsal. API-t kínálnak az adatok kulcs alapján történő olvasásához, egyetlen kulcs-érték pár szerint, vagy több ilyen pár szerint, vagy regexp alapján. Például, ha szeretné megtalálni az összes szolgáltatás CPU-terhelését az amerikai adatközpontban, akkor ilyen álkérdést kell használnia.
Az időszakos adatokhoz készült adatbázisok általában specializált lekérdező nyelveket használnak, mivel az SQL nem igazán alkalmas az időszakos adatokra. Bár vannak adatbázisok, amelyek támogatják az SQL-t, de az nem igazán megfelelő. Sokkal jobban megfelelnek azok a lekérdező nyelvek, mint , , , . Remélem, hogy valaki hallott ezek közül a nyelvek közül legalább egyikről. A PromQL-t valószínűleg sokan ismerik. Ez a Prometheus lekérdező nyelve.
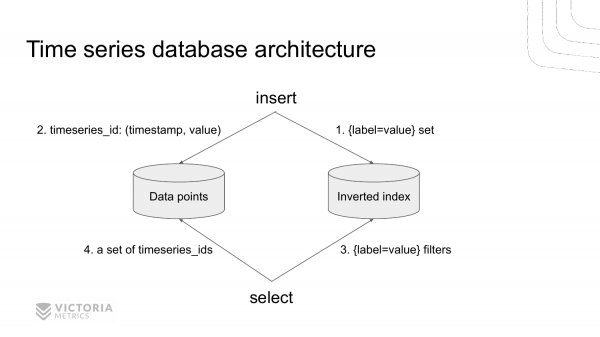
Így néz ki a modern időszakos adatbázis architektúrája a VictoriaMetrics példáján.
Két részből áll. Ez egy tároló az inverz index számára és egy tároló az időszakos adatok értékei számára. Ezek a tárolók külön vannak választva.
Amikor új bejegyzés érkezik az adatbázisba, először az inverz indexet kérdezzük le, hogy megtaláljuk az időszakos sor azonosítóját a megadott label=value sorozat szerint. Megtaláljuk ezt az azonosítót, és elmentjük az értéket az adatbázis tárolójába.
Amikor érkezik egy kérés az TSDB-ből történő adatlekéréshez, először az inverz indexhez nyúlunk. Kiolvassuk az összes timeseries_ids bejegyzést, amelyek megfelelnek a megadott label=valuesorozatnak. Ezután kiolvassuk az összes szükséges adatot az adatbázisból, amely az timeseries_ids.
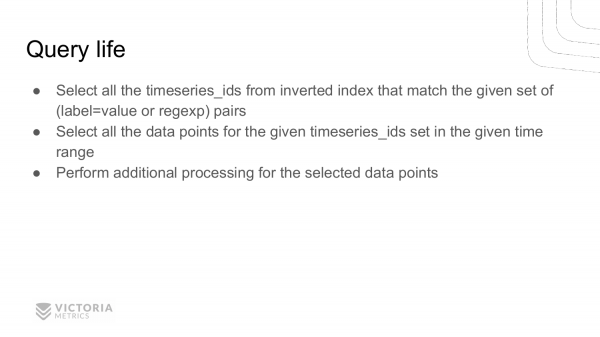
Tekintsük meg, hogyan dolgozza fel az időszakos adatbázis a bejövő select kérdést.
- Először kiolvassa az összes
timeseries_idsbejegyzést az inverz indexből, amelyek tartalmazzák a megadott párokatlabel=value, vagy amelyek megfelelnek a megadott reguláris kifejezésnek. - Ezután kiolvassa az összes adatpontot az adatbázisból a megadott időintervallumban a megtaláltak számára.
timeseries_ids. - Ezután az adatbázis számításokat végez ezekkel az adatpontokkal a felhasználói kérés szerint. Majd visszaadja a választ.
A prezentációmban meg fogom mutatni az első részt. Ez a keresés timeseries_ids az inverz index alapján. A második és harmadik részt később megtekinthetik , vagy várjanak, amíg elkészítek más előadásokat 🙂
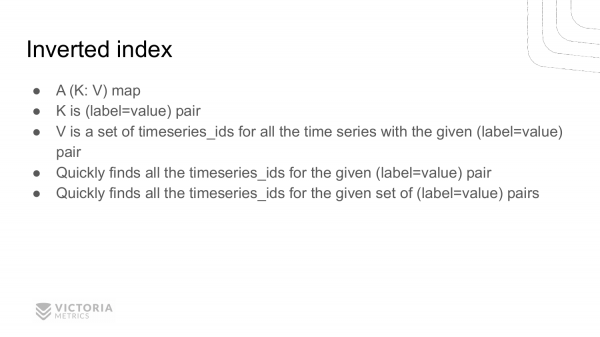
Lépjünk az inverz indexre. Sokan úgy gondolhatják, hogy ez egyszerű. Ki tudja, mi az inverz index és hogyan működik? Oh, már nem sokan vannak. Próbáljuk megérteni, mi ez.
Valójában minden egyszerű. Ez csupán egy szótár, amely a kulcsot egy értékhez rendeli. Mi a kulcs? Ez a pár label=value, ahol label és érték — ezek karakterláncok. Az értékek pedig egy halmaz timeseries_ids, amely tartalmazza a megadott párt label=value.
Az inverz index lehetővé teszi, hogy gyorsan megtaláljuk az összes timeseries_ids, amely rendelkezik a megadottal label=value.
Illetve lehetővé teszi, hogy gyorsan megtaláljuk timeseries_ids időszakokat több párhoz label=value, vagy a következők szerint párhoz label=regexp. Hogyan történik ez? A halmaz kereszteződésének megtalálásával timeseries_ids minden pár esetében label=value.
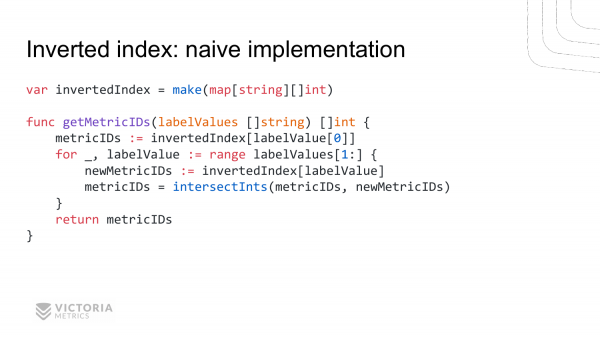
Nézzük meg az inverz index különböző megvalósításait. Kezdjük a legbasicabb, naiv megvalósítással. Így néz ki.
Funkció getMetricIDs megkapja a karakterláncok listáját. Minden karakterlánc tartalmazza label=value. Ez a funkció visszaad egy listát metricIDs.
Hogyan működik ez? Itt egy globális változó, amelyet invertedIndex. Ez egy szokásos szótár (map), amely a karakterláncot egy int-vágatlanra rendeli. A karakterlánc tartalmazza label=value.
A funkció megvalósítása: előhívjuk metricIDs az első számára, majd végigmegyünk az összes többi label=value, összegyűjtjük label=valueszámára. És meghívjuk a metricIDs intersectInts funkciót, amelyről később szó lesz. Ez a funkció visszaadja ezen listák kereszteződését.Amint látják, az inverz index megvalósítása nem túl bonyolult. De ez egy naiv megvalósítás. Milyen hátrányai vannak? A naiv megvalósítás legfőbb hátránya, hogy az inverz index a memóriában tárolódik. Az alkalmazás újraindítása után elveszítjük ezt az indexet. Nincs a lemezre való mentés. Az adatbázis számára ez az inverz index valószínűleg nem alkalmas.
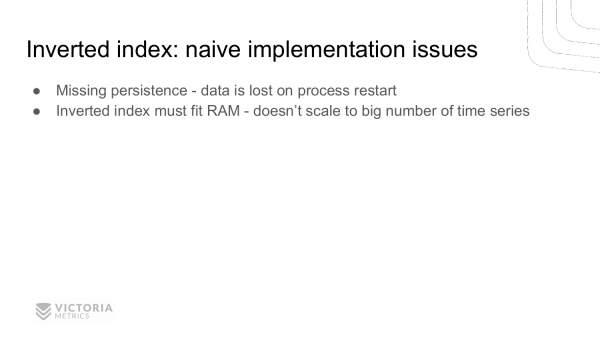
Amint látják, az inverz index megvalósítása nem túl bonyolult. De ez egy naiv megvalósítás. Milyen hátrányai vannak? A naiv megvalósítás legfőbb hátránya, hogy az inverz index a memóriában tárolódik. Az alkalmazás újraindítása után elveszítjük ezt az indexet. Nincs a lemezre való mentés. Az adatbázis számára ez az inverz index valószínűleg nem alkalmas.
A második hátrány is a memóriával összefügg. Az invertált indexnek a RAM-ban kell lennie. Ha meghaladja a RAM méretét, nyilvánvaló, hogy memóriahibát kapunk, és a program nem fog működni.
Ezt a problémát kész megoldások, például a következők segítségével lehet orvosolni: , vagy .
Röviden, szükségünk van egy adatbázisra, amely lehetővé teszi három művelet gyors végrehajtását.
- Az első művelet a felvétel
kulcs-értékebbe az adatbázisba. Ezt nagyon gyorsan végzi, aholkulcs-érték– ezek tetszőleges szövegek. - A második művelet az érték gyors keresése a megadott kulcs alapján.
- A harmadik művelet pedig az összes érték gyors keresése a megadott prefixum alapján.
A LevelDB és a RocksDB adatbázisokat a Google és a Facebook fejlesztette. Először a LevelDB jelent meg. Aztán a Facebook munkatársai átvették a LevelDB-t és elkezdték fejleszteni, létrehozták a RocksDB-t. Ma a Facebookon belül majdnem minden belső adatbázis RocksDB-n fut, beleértve azt is, hogy a MySQL-t átállították RocksDB-re. Ezt így nevezik: .
Az invertált indexet a LevelDB segítségével lehet megvalósítani. Hogyan lehet ezt megtenni? A kulcsként label=valuemegtartjuk. Az értékként pedig az idősort azonosítóját tároljuk, ahol a pár található. label=value.
Ha sok idősort tartalmazunk ezzel a párral label=value, akkor sok sor lesz az adatbázisban, amelyek azonos kulccsal és különböző timeseries_idsrendelkeznek. Ahhoz, hogy megkapjuk az összes listát timeseries_ids, amelyek ezzel kezdődnek, label=prefix, végzünk egy tartományi vizsgálatot, amelyre ez az adatbázis optimalizálva van. Tehát kiválasztunk minden olyan sort, amely ezzel kezdődik, label=prefix és megkapjuk a szükséges timeseries_ids.
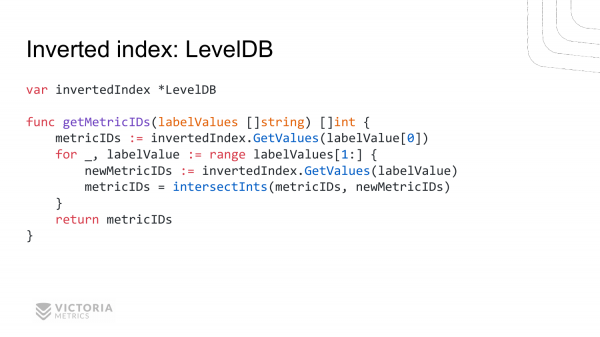
Íme egy példaszerű megvalósítás, hogy nézne ki Go-ban. Van egy invertált indexünk. Ez a LevelDB.
A funkció ugyanaz, mint az naiv megvalósításnál. Szinte sorban követi a naiv megvalósítást. Az egyetlen eltérés, hogy a map helyett az invertált indexre hivatkozunk. Megkapjuk az összes értéket az első label=value. Aztán végigmegyünk az összes fennmaradó páron label=value és megkapjuk a megfelelő metricIDs készleteket számukra. Ezután megtaláljuk az metszést.
Úgy tűnik, minden rendben van, de ebben a megoldásban vannak hátrányok. A VictoriaMetrics kezdetben az LevelDB alapú invertált indexet valósította meg. De végül el kellett állnia tőle.
Miért? Mert a LevelDB lassabb, mint a naiv megvalósítás. A naiv megvalósításnál a megadott kulcs alapján azonnal lekérdezzük az egész slice-ot. metricIDs. Ez a nagyon gyors művelet – az egész slice készen áll a használatra.
A LevelDB-nél azonban minden hívásnál a GetValues függvényt a label=value. Minden egyes sor esetében ki kell nyerni az értéket timeseries_ids. Ezekből timeseries_ids össze kell gyűjteni a slice-ot. timeseries_idsNyilvánvaló, hogy ez sokkal lassabb, mint egyszerűen hozzáférni egy normál map-hez kulcs alapján.
A második hátrány az, hogy a LevelDB C nyelven íródott. A Go nyelvből C függvények hívása nem túl gyors. Ez több száz nanosekundumot igényel. Ez nem túl gyors, mert egy átlagos Go függvényhívás, ami 1-5 nanosekundumot vesz igénybe, tízszeres teljesítménybeli eltéréshez vezet. A VictoriaMetrics számára ez életbevágó hátrány volt 🙂
Ezért írtam egy saját megoldást az inverz indexre. Ezt neveztük .
A mergeset a MergeTree adatstruktúrára épül. Ez az adatstruktúra a ClickHouse-ból származik. Nyilvánvaló, hogy a mergeset-nek optimalizálva kell lennie a gyors kereséshez timeseries_ids egy megadott kulcsra. A mergeset teljes egészében Go nyelven íródott. Megnézheti a . A mergeset megvalósítása a mappában található. Megpróbálhatja megérteni, mi történik ott.
A mergeset API-ja nagyon hasonlít a LevelDB és RocksDB API-jára. Azaz lehetővé teszi új bejegyzések gyors elmentését és a bejegyzések gyors kiválasztását egy megadott prefix alapján.
A mergeset hátrányairól később beszélünk. Most a VictoriaMetrics-szal kapcsolatos inverz index megvalósítása során felmerült problémákról beszélgessünk.
Miért merültek fel?
Az első ok a magas churn rate. Magyarra fordítva – ez a gyakori időbeli sorok váltakozása. Amikor egy időbeli sor véget ér, és egy új kezdődik, vagy sok új időbeli sor kezdődik. Ez gyakran előfordul.
A második ok az időbeli sorok magas száma. Eleinte, amikor a monitorozás népszerűvé vált, az időbeli sorok száma kicsi volt. Például minden számítógéphez figyelni kell a CPU, memória, hálózat és lemez terhelését. 4 időbeli sor minden számítógéphez. Tegyük fel, hogy 100 számítógépe van, és 400 időbeli sorral rendelkezik. Ez nagyon kevés.
Idővel az emberek kitalálták, hogy részletesebb információkat lehet mérni. Például mérheti a CPU terhelését nem az egész processzor, hanem minden egyes processzormag külön-külön. Ha 40 processzormagja van, akkor 40-szer annyi idősorral rendelkezik a CPU terhelésének mérésére.
De ez még nem minden. Minden egyes processzormagnak lehet több állapota, mint például az idle, amikor tétlen. Ezen kívül működés user space-ben, kernel space-ben és más állapotok is. Mindezeket az állapotokat is mérhetjük külön idősorként. Ez 7-8-szorosára növeli az idősorok számát.
Egy metrikából 40 x 8 = 320 metrikánk van mindössze egy számítógép esetében. Szorozzuk meg 100-zal, így 32 000-et kapunk a 400 helyett.
Aztán megjelent a Kubernetes. Ez még fokozta a helyzetet, mert a Kubernetesben sok különböző szolgáltatás hosztolható. Minden szolgáltatás több podból áll. Ezt mind figyelni kell. Ezenkívül folyamatosan telepítjük az új verziókat a szolgáltatásaiból. Minden új verzióhoz új idősorokat kell létrehozni. Ennek eredményeképpen az idősorok száma exponenciálisan nő, és szembesülünk a nagy számú idősorral foglalkozó problémával, amelyet high-cardinality-nek nevezünk. A VictoriaMetrics sikeresen kezeli ezt más idősor adatbázisokkal összehasonlítva.
Továbbítsuk részletesebben a high churn rate-t. Miért alakul ki a high churn rate a production környezetben? Mert egyes címkék és tagek állandóan változnak.
Például vegyük a Kubernetest, amelyben létezik a fogalom stb.);, azaz amikor új verziót telepítenek az alkalmazásából. A Kubernetes fejlesztői valamilyen okból döntöttek úgy, hogy a deployment azonosítóját hozzáteszik a címkéhez.
Mire vezetett ez? Arra, hogy minden új telepítésnél az összes régi idősor megszakad, és helyettük új idősorok indulnak új címkeértékkel, deployment_id. Ezekből az idősorokból számtalan, akár millió is lehet.
Fontos jellemzője ennek az egésznek, hogy az összes idősor mennyisége nő, de az aktív idősorok, amelyekhez adatok érkeznek, állandóak maradnak. Ezt az állapotot high churn rate-nek nevezik.
A fő probléma a magas fluktuációval kapcsolatban, hogy biztosítsuk az összes idősort kereső állandó sebességét egy adott címkehalmaz esetén egy meghatározott időintervallumban. Általában ez az időintervallum az elmúlt óra vagy az elmúlt nap.
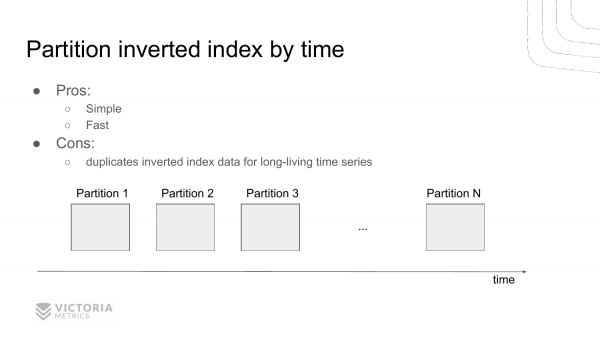
Hogyan oldhatjuk meg ezt a problémát? Íme az első lehetőség. Az inverz indexet különálló időszakokra osztjuk. Vagyis eltelik egy időintervallum, befejezzük a munkát a jelenlegi inverz indexszel. És létrehozunk egy új inverz indexet. Még egy időintervallum eltelik, létrehozunk egy másikat és még egyet.
És ezekből az inverz indexekből kiválasztunk egy halmazt, amely az adott időintervallumba esik. Ennek megfelelően innen választjuk ki az idősorok azonosítóit.
Ez lehetővé teszi az erőforrások megtakarítását, mert nem kell átnéznünk azokat a részeket, amelyek nem esnek az adott időintervallumba. Vagyis általában, ha az elmúlt óra adatait választjuk ki, akkor a korábbi időintervallumok esetében kihagyjuk a lekérdezéseket.
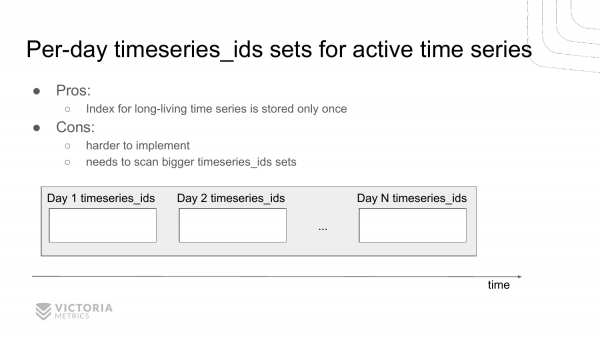
Van még egy megoldási lehetőség erre a problémára. Ez minden napra külön listát tárolni az azonosítókról, amelyek az adott napon találkoztak.
Ennek a megoldásnak az előnye a korábbi megoldáshoz képest, hogy nem duplikáljuk az idősorokkal kapcsolatos információkat, amelyek idővel nem tűnnek el. Állandóan jelen vannak és nem változnak.
A hátránya az, hogy egy ilyen megoldás bonyolultabb a megvalósításban és nehezebb a hibakeresésben. A VictoriaMetrics ezt a megoldást választotta. Történelmileg alakult így. Ez a megoldás is jól teljesít a korábbihoz képest. Mivel ezt a megoldást nem a megváltoztathatatlan idősorok adatinak minden partícióban való duplikálása miatt valósították meg. A VictoriaMetrics elsődlegesen a lemezterület fogyasztásának optimalizálására összpontosított, és a korábbi megvalósítás rontotta a lemezterület felhasználását. Ez a megoldás viszont jobban alkalmas a lemezterület fogyasztásának minimalizálására, ezért ezt választották.
Meg kellett küzdeni vele. A küzdelem abban állt, hogy ebben a megvalósításban akkor is sokkal nagyobb mennyiséget kell kiválasztani timeseries_ids az adatok számára, mint amikor az inverz index időben van felosztva.
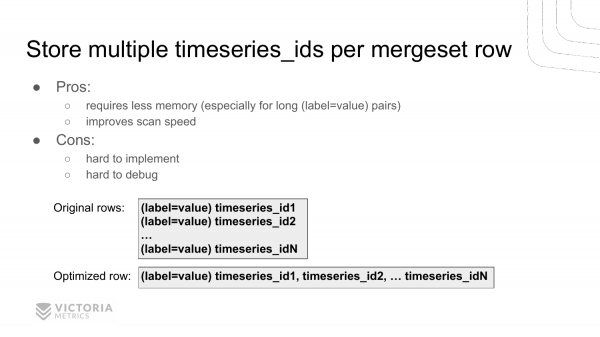
Hogyan oldottuk meg ezt a problémát? Eredeti módon oldottuk meg – azáltal, hogy több idősort azonosító tároltunk az invertált index minden rekordjában, nem pedig egyet. Tehát van egy kulcsunk label=value, amely minden időszakban megtalálható. Mostantól több ilyet tárolunk timeseries_ids egy rekordban.
Íme egy példa. Korábban N rekordunk volt, most pedig egy rekordunk van, amelynek prefixe megegyezik az összes többiével. Az előző rekord értéke tartalmazta az összes idősort azonosító id-t.
Ez lehetővé tette, hogy az ilyen invertált indexek bejárási sebességét 10-szeresére növeljük. Ráadásul csökkentette a memóriafogyasztást a cache számára, mert most egyetlen sort tárolunk label=value csak egyszer a cache-ben, összehasonlítva N-szer. Ez a sor nagy lehet, ha a címkékben és a tagekben hosszú szövegek tárolódnak, ahogy azt a Kubernetes szeret csinálni.
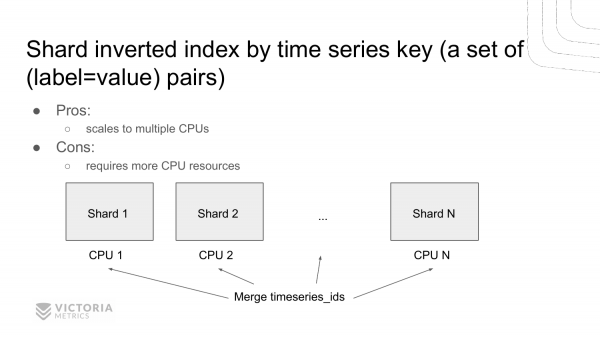
Egy másik lehetőség az invertált index keresésének felgyorsítására a sharding. Több invertált index létrehozása egyetlen helyett, és az adatok shardingja közöttük egy kulcs szerint. Ez egy halmaz key=value párokkal. Tehát több független invertált indexünk van, amelyeket párhuzamosan kérdezhetünk le több processzoron. Az előző megvalósítások csak egymagos üzemmódban működtek, tehát csak egyetlen magon tudták bejárni az adatokat. Ez a megoldás lehetővé teszi az adatok bejárását egyszerre több magon, ahogy a ClickHouse is szereti csinálni. Ezt tervezzük megvalósítani.
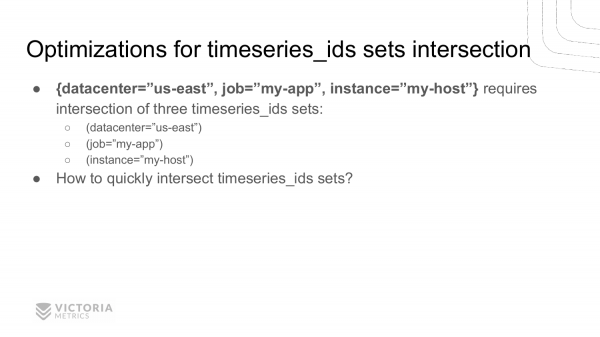
Most pedig térjünk vissza a disznóinkhoz – a metszeti függvényhez timeseries_ids. Nézzük meg, milyen megvalósítások lehetségesek. Ez a függvény lehetővé teszi, hogy megtaláljunk timeseries_ids egy adott halmaz számára label=value.
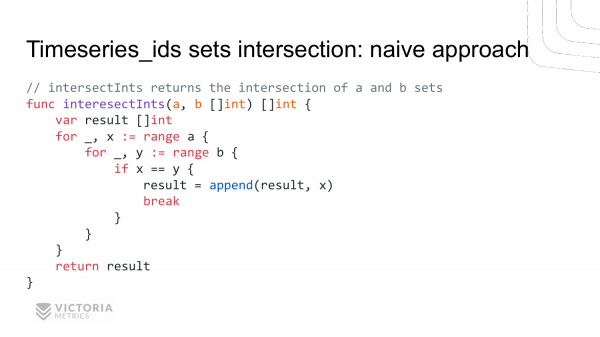
Az első lehetőség a naiv megvalósítás. Két egymásba ágyazott ciklus. Így érkezik be a függvénybe funkciót, amelyről később szó lesz. Ez a funkció visszaadja ezen listák kereszteződését. két slice — a és b. A kimenetnek vissza kell adnia nekünk ezen slice-ok metszetét.
A naiv megvalósítás így néz ki. Végigmegyünk a slice aösszes értékén, belül pedig végigmegyünk a slice bösszes értékén. Összehasonlítjuk őket. Ha megegyeznek, akkor megtaláltuk a metszetet. És elmentjük azt eredmény.
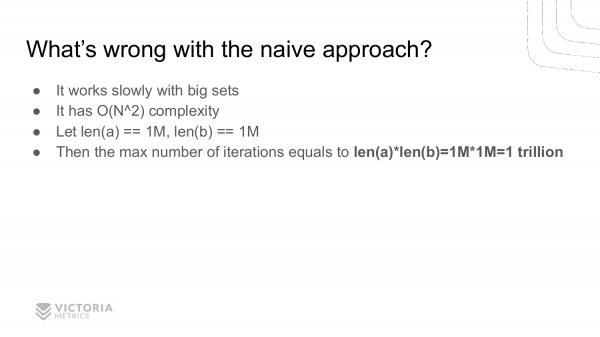
Mik a hátrányok? A kvadratikus bonyolultság – ez a legfőbb hátránya. Például, ha a slice-ok méretei a és b Ha millióról van szó, ez a funkció soha nem ad választ. Mert egymillió iterációt kellene végrehajtania, ami nagyon sok, még a modern számítógépek számára is.
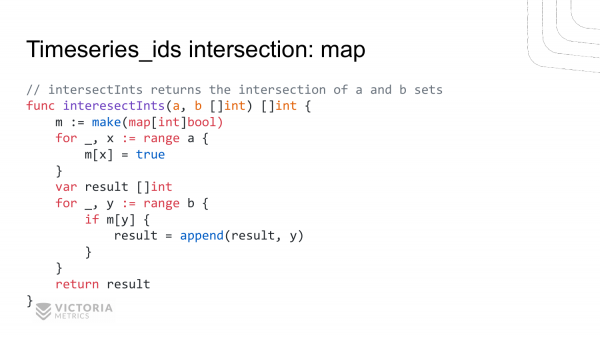
A második megvalósítás a map-re alapoz. Létrehozzuk a map-et. Ezt a map-et feltöltjük a slice összes értékével. a. Ezután egy külön ciklussal végigmegyünk a slice-on. b. És ellenőrizzük – van-e ez az érték a slice-ban. b a map-ben. Ha van, akkor hozzáadjuk az eredményhez.
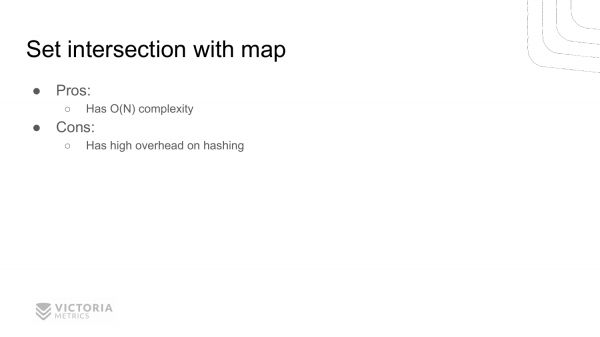
Mik a előnyök? Az előny az, hogy itt csak lineáris bonyolultság van. Tehát a funkció sokkal gyorsabban fog végrehajtódni nagyobbnál nagyobb slice-ok esetén. Egymilliós méretű slice esetén a funkció 2 millió iteráció alatt fog teljesülni, szemben a trillió iterációval, mint az előző funkcióban.
A hátránya viszont az, hogy ez a funkció több memóriát igényel a map létrehozásához.
A második hátrány – ez egy nagy vazon van a hash-elés miatt. Ez a hátrány nem túl nyilvánvaló. Számunkra sem volt túl nyilvánvaló, ezért kezdetben a VictoriaMetricsben a keresztmetszet megvalósítása a map-en keresztül történt. De később a profilozás megmutatta, hogy a fő processzorfedési idő a map írására és az érték meglétének ellenőrzésére megy el ebben a map-ben.
Miért pazarolják így a processzort? Mert a Go ezekben a sorokban hash-elési műveletet végez. Tehát kiszámítja a kulcs hash-ét, hogy később a megadott index alapján hozzáférjen a HashMap-hez. A hash számítási műveletek tíz nanomásodperc alatt végrehajthatók. Ez lassú a VictoriaMetrics számára.
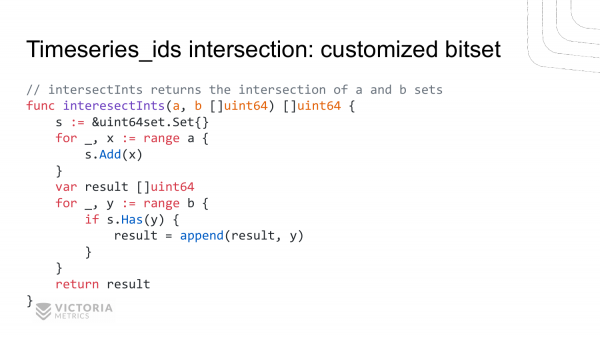
Úgy döntöttem, hogy bitset-et valósítok meg, kifejezetten erre az esetre optimalizálva. Így néz ki most a két slice keresztmetszete. Itt létrehozunk egy bitsetet. Hozzáadjuk az elemeket az első slice-ból. Majd ellenőrizzük ezeknek az elemeknek a meglétét a második slice-ban. És hozzáadjuk őket az eredményhez. Tehát szinte nem különbözik az előző példától. Az egyetlen, amit itt tettünk, hogy a map elérését egyedi funkciókkal helyettesítettük. add és has.
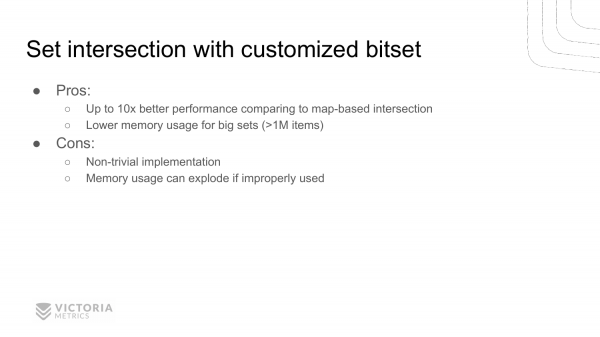
Első pillantásra úgy tűnik, hogy ez lassabban kellene működjön, ha korábban a standard mapet használták, és most még valami más funkciókat is hívnak, de a profilozás azt mutatja, hogy ez a megoldás tízszer gyorsabb, mint a standard map a VictoriaMetrics esetében.
Ezenkívül sokkal kevesebb memóriát használ az map-re alapozott megoldáshoz képest. Mivel itt biteket tárolunk a nyolchbájtos értékek helyett.
A hátránya ennek a megvalósításnak, hogy nem annyira nyilvánvaló, nem triviális.
Egy másik hátrány, amit sokan észre sem vesznek, hogy ez a megvalósítás bizonyos esetekben rosszul működhet. Vagyis, ez egy adott esetre optimalizált, a VictoriaMetrics időbeli sorok azonosítóinak metszetéhez. Ez nem jelenti azt, hogy minden esetben alkalmazható. Ha rosszul használják, nem teljesítmény-növekedést, hanem out of memory hibát és teljesítménycsökkenést kapunk.
Nézzük meg ennek a struktúrának a megvalósítását. Ha szeretnék látni, akkor a VictoriaMetrics forráskódjában található, a mappában . Ez kifejezetten a VictoriaMetrics esetére van optimalizálva, ahol timeseries_id egy 64 bites értéket képvisel, ahol az első 32 bit alapvetően állandó, és csak az utolsó 32 bit változik.
Ez az adatstruktúra nem tárolódik lemezen, csak a memóriában működik.
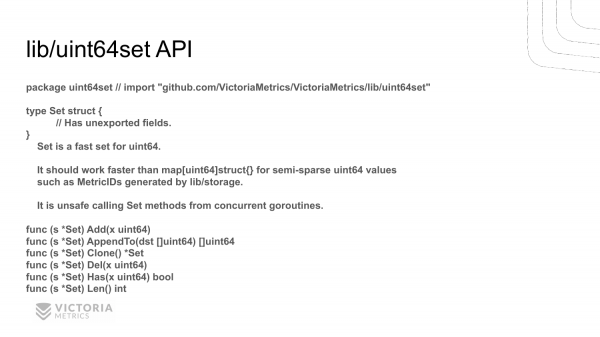
Íme az API-ja. Nem túl bonyolult. Az API kifejezetten a VictoriaMetrics konkrét felhasználási példájához van igazítva. Vagyis itt nincsenek felesleges funkciók. Csak azok a funkciók találhatók itt, amelyeket kifejezetten a VictoriaMetrics használ.
Van egy addfunkció, amely új értékeket ad hozzá. Van egy hasfunkció, amely ellenőrzi az új értékeket. És van egy delfunkció, amely törli az értékeket. Van egy segédfunkció is, len, amely visszaadja a halmaz méretét. A clone funkció klónozza a halmazt. És a appendto funkció átalakítja ezt a halmazt szeletre. timeseries_ids.
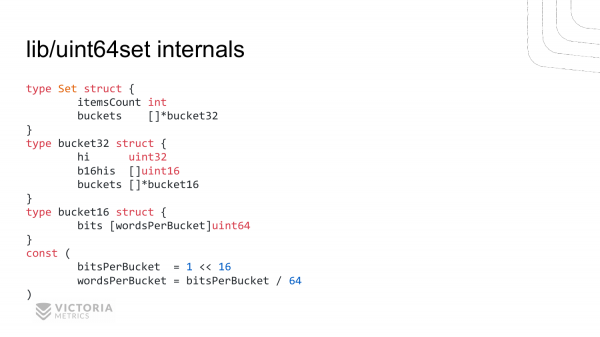
Íme, hogyan néz ki ennek az adatstruktúrának a megvalósítása. A halmazban két elem található:
ItemsCount– ez egy segédfeldolgozó mező, amely lehetővé teszi, hogy gyorsan visszaadja az elemek számát a halmazban. El lehetett volna élni nélküle, de hozzá kellett adni, mert a VictoriaMetrics gyakran lekérdezi a bitset hosszát az algoritmusai során.A második mező pedig a
buckets.Ez egy szelet abucket32struktúrából. Minden egyes struktúrában tárolódik ahimező. Ez a felső 32 bit. És két szelet –b16hisésbuckets.abucket16struktúrák.
Itt tárolódnak a 64 bites struktúra második részének felső 16 bitjei. Itt pedig a legalsó 16 bit bitsetei találhatók minden egyes byte-hoz.
A Bucket64 egy uint64tömbből áll. A hossza ezekből a konstansokból számítódik. Egy bucket16 maximum 4096 2^16=65536 bitet tárolhat. Ha ezt 8-cal osztjuk, akkor az 8 kilobájt. Ha ezt ismét 8-cal osztjuk, akkor az 1000 uint64 értéket jelent. Vagyis a Bucket16 – ez számunkra egy 8 kilobájtos struktúra. – ez egy 8 kilobájtos struktúra.
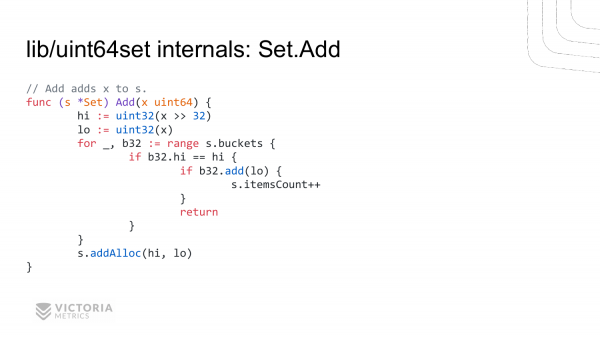
Nézzük meg, hogyan valósítják meg ennek a struktúrának az egyik módszerét, amely új érték hozzáadására szolgál.
Minden a következővel kezdődik: uint64 érték. Kiszakítjuk a felső 32 bitet, kiszakítjuk az alsó 32 bitet. Végigmegyünk az összes buckets.. Összehasonlítjuk a felső 32 bitet minden egyes bucketben a hozzáadandó értékkel. Ha azok megegyeznek, akkor meghívjuk a add b32 struktúrában lévő buckets.. És hozzáadjuk az alsó 32 bitet. Ha ez visszaadott igaz, akkor ez azt jelenti, hogy ezt az értéket hozzáadtuk, és eddig nem volt ilyen értékünk. Ha ez visszaadja hamis, akkor ilyen érték már létezett. Ezután növeljük az elemek számát a struktúrában.
Ha nem találtunk szükséges tároló a megfelelő hi-értékkel, akkor meghívjuk a addAlloc, amely új tárolót foglal, és hozzáadja azt a bucket struktúrához.
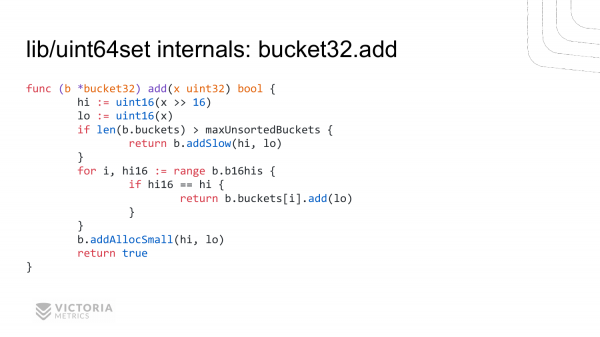
Ez a b32.addfüggvény megvalósítása. Hasonló az előző megvalósításhoz. Kiszámítjuk a felső 16 bitet, az alsó 16 bitet.
Aztán végigmegyünk az összes felső 16 biten. Megtaláljuk a megegyezéseket. Ha megegyezés történik, akkor meghívjuk az add módszert, amit a következő oldalon vizsgálunk meg a bucket16.
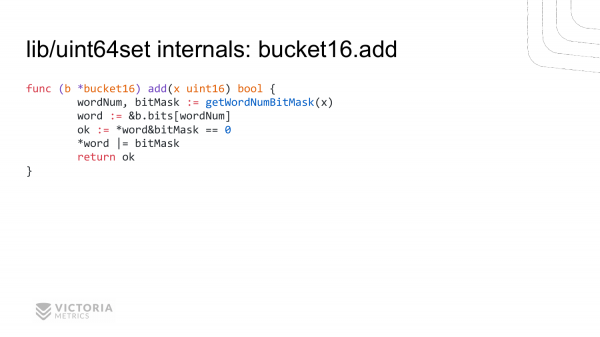
És ez a legalacsonyabb szint, amelyet a lehető legjobban optimalizálni kell. Kiszámítjuk az uint64 id értékét a szelet bitben, valamint a bitmask. Ez a maszk a 64 bites értékhez, amely segítségével ellenőrizhetjük ennek a bitnek a meglétét, vagy beállíthatjuk azt. Ellenőrizzük, hogy ez a bit be van-e állítva, majd beállítjuk, és visszaadjuk a megléte. Ez a megvalósításunk lehetővé tette, hogy a temporális sorokban lévő ids keresztmetszete 10-szer gyorsabb legyen a szokásos mapokhoz képest.
A VictoriaMetricsben ezen optimalizáció mellett sok más optimalizáció is van. Ezek többségét nem csak úgy adták hozzá, hogy ideálisnak tűnt, hanem a kód profilozása után a termelésben.
Ez a legfontosabb optimalizálási szabály - ne adjunk hozzá optimalizációt, feltételezve, hogy ott lesz a szűk keresztmetszet, mert előfordulhat, hogy ott nem lesz. Az optimalizáció általában rontja a kód minőségét. Ezért érdemes optimalizálni csak profilozás után, és lehetőleg a termelésben, hogy valós adatokkal dolgozzunk. Aki érdeklődik, megnézheti a VictoriaMetrics forráskódját, és tanulmányozhatja a többi ott található optimalizációt.
Kérdésem van a bitsettel kapcsolatban. Nagyon hasonlít a C++ vector bool megvalósítására, optimalizált bitset. Onnan vették a megvalósítást?
Nem, nem onnan. E bitset megvalósítása során az ids timeseries struktúrájára támaszkodtam, amelyeket a VictoriaMetrics használ. Az ő struktúrájuk úgy van kialakítva, hogy a felső 32 bit jellemzően állandó. Az alsó 32 bit változhat. Minél alacsonyabb a bit, annál gyakrabban változhat. Éppen ezért ez a megvalósítás kifejezetten erre az adatszerkezetre van optimalizálva. A C++ megvalósítás, amennyire tudom, az általános esetre van optimalizálva. Ha az általános esetet optimalizáljuk, az azt jelenti, hogy nem lesz a legoptimálisabb a konkrét esethez képest.
Ajánlom, hogy nézze meg Alexey Milovid előadását is. Körülbelül egy hónappal ezelőtt beszélt a ClickHouse specifikus optimalizálásairól. Ő éppen azt mondja, hogy az általános esetben a C++ megvalósítás vagy bármely más megoldás jól működik átlagosan. Lehet, hogy rosszabbul teljesít, mint egy specializált megoldás, amikor tudjuk, hogy a felső 32 bit jellemzően állandó.
Van egy második kérdésem. Mi a radikális különbség az InfluxDB-hoz képest?
Sok radikális különbség van. Ha a teljesítményt és a memóriafogyasztást nézzük, az InfluxDB a tesztekben 10-szer több memóriafogyasztást mutat a magas kardinalitású idősorok esetén, amikor sok van belőlük, például milliók. Például a VictoriaMetrics 1 GB-ot fogyaszt egymillió aktív sorra, míg az InfluxDB 10 GB-ot. Ez jelentős különbség.
A második radikális különbség az, hogy az InfluxDB-nek furcsa lekérdezési nyelvei vannak – Flux és InfluxQL. Ezek nem túl kényelmesek az idősorokkal való munkához a , amelyet a VictoriaMetrics támogat. A PromQL a Prometheus lekérdezési nyelve.
És egy másik különbség az, hogy az InfluxDB-nek kissé furcsa az adatmodellje, ahol minden egyes sorban több field tárolható eltérő címkehalmazzal. Ezeket a sorokat további táblákra osztják. Ezek a további bonyodalmak megnehezítik az ebből a database-ból való későbbi munkát. Nehezen karbantartható és érthető.
A VictoriaMetricsnél minden sokkal egyszerűbb. Ott minden idősor egy kulcs-érték párt képvisel. Az érték egy pontok halmaza – (timestamp, érték), míg a kulcs egy halmaz label=valueNincsen megosztás a fields és measurements között. Ez lehetővé teszi, hogy bármilyen adatot válassz, majd kombinálj, összeadj, kivonj, szorozz, oszd, ellentétben az InfluxDB-vel, ahol a különböző sorok közötti számítások eddig nem valósultak meg, amennyire tudom. Még ha meg is valósultak, nehézkes, rengeteg kódot kell írni.
Van egy pontosító kérdésem. Jól értettem, hogy volt egy probléma, amiről beszélt, amely miatt ez az inverz index nem fért el a memória, ezért van a particionálás?
Kezdetben megmutattam egy naiv megvalósítást az inverz indexre a standard Go map-en. Ez a megvalósítás nem alkalmas adatbázisokhoz, mert ez az inverz index nem kerül mentésre a lemezre, míg az adatbázisnak meg kell őriznie a lemezen, hogy ezek az adatok újraindítás után is elérhetőek maradjanak. Ennél a megvalósításnál az alkalmazás újraindításakor az inverz index eltűnik. És elveszíted az összes adat elérését, mert nem tudod őket megtalálni.
Üdvözlöm! Köszönöm a prezentációt! A nevem Pavel. A Wildberries cégtől jövök. Van néhány kérdésem önhöz. Az első kérdés. Ön szerint, ha más elvet választott volna az alkalmazás architektúrájának felépítésére és idő szerint particionálta volna az adatokat, talán lehetne lehetősége, hogy az adatok keresésekor metszeteket végezzen, csak azon alapulva, hogy egy particion belül vannak az adatok egy adott időszakra, azaz egy időintervallumra, és nem kellene aggódnia amiatt, hogy az ön adatai különböző módon vannak szétszórva? A második kérdés - mivel hasonló algoritmust valósít meg bitsettel és minden mással, talán megpróbálta használni a processzor utasításait? Talán kipróbálta ezeket az optimalizálásokat?
A másodikra azonnal válaszolok. Még nem jutottunk el eddig. De ha szükség lesz rá, megtesszük. Az első, mi volt a kérdés?
Két forgatókönyvet beszéltek meg. Azt mondták, hogy a másodikat választották, amely bonyolultabb megvalósítással bír. És nem részesítették előnyben az elsőt, ahol az adatok idő szerint lettek particionálva.
Igen. Az első esetben a teljes indexméret nagyobb lenne, mert minden particiónál tárolnunk kellene a duplikált adatokat azokon az időtartományokon, amelyek átfedik ezeket a particiókat. Ha az időtartományok churn rate-je alacsony, vagyis folyamatosan ugyanazokat a sorokat használják, akkor az első esetben jelentősen nagyobb diszkterületet veszítenénk a második esethez képest.
Igen, a időalapú particionálás jó megoldás. Ezt használja a Prometheus is. De a Prometheusszal kapcsolatban van egy másik hátrány. Az adatok egyesítésénél meg kell tartania a memóriában minden label és időtartomány meta-információját. Ezért, ha az egyesített adatok nagyok, a memóriafogyasztás jelentősen megnő az egyesítési folyamat során, ellentétben a VictoriaMetrics-el. A VictoriaMetrics egyesítésekor gyakorlatilag nem fogyaszt memóriát, csak néhány kilobájtot igényel, függetlenül az egyesített adatok méretétől.
Az algoritmus, amit használnak, memóriaigényes. Itt a timeseries címkéket tárolják, amelyekhez értékek tartoznak. Így ellenőrzik a páros meglétet egy adatmátrixban és egy másikban. És így megértik, hogy történt-e átfedés vagy sem. Általában az adatbázisokban kurzorokat, iterátorokat valósítanak meg, amelyek tárolják a jelenlegi állapotukat, és végigjárják a rendezett adatokon, mivel így egyszerű időbeli összetett műveleteket kapunk.
Miért nem használunk kurzorokat az adatok átfedésére?
Igen.
A LevelDB-ben vagy a mergeset-ben éppen az rendezett sorok vannak tárolva. Át tudunk menni rajtuk egy kurzorral, és megtalálni az átfedést. De miért nem használjuk? Mert ez lassú. A kurzorok azt feltételezik, hogy minden egyes sorhoz funkciót kell hívni. A funkcióhívás 5 nanosekundum. És ha 100 000 000 sor van, akkor csak a funkcióhívásra fél másodpercet költünk.
Ilyen van, igen. És az utolsó kérdésem. A kérdés talán kicsit furcsán hangzik. Miért nem számítjuk ki az összes szükséges aggregátumot és tároljuk azokat a szükséges formában, amikor az adatok beérkeznek? Miért kell hatalmas mennyiséget tárolni olyan rendszerekben, mint a VictoriaMetrics, ClickHouse stb., hogy aztán sok időt pazaroljunk rájuk?
Hoztok egy példát, hogy érthetőbb legyen. Tegyük fel, hogy hogyan működik egy kicsi játéksebességmérő? Rögzíti a megtett távolságot, és folyamatosan hozzáadja egy mértékhez, a másikhoz pedig az időt. Majd elosztja. Így kapja meg az átlagsebességet. Hasonlóképpen el lehet járni. Az összes szükséges tényt folyamatosan összegyűjteni.
Rendben, értem a kérdést. Az Ön példája életképes. Ha tudja, hogy milyen aggregátumokra van szüksége, akkor ez a legjobb megoldás. De a probléma az, hogy az emberek ezeket a metrikákat és adatokat a ClickHouse-nál tárolják, és nem tudják, hogyan fogják ezeket a jövőben aggregálni, szűrni, ezért minden nyers adatot meg kell őrizniük. De ha tudja, hogy valami átlagot kell számolnia, miért ne számolná azt, ahelyett, hogy egy rakás nyers értéket tárolna? De ez csak akkor, ha pontosan tudja, hogy mire van szüksége.
Egyébként, a időszakos sorok tárolására szolgáló adatbázisok támogatják az aggregátumok számítását. Például a Prometheus támogatja . Tehát ezt meg lehet csinálni, ha tudja, hogy milyen aggregátumokra lesz szüksége. A VictoriaMetrics-nél ez jelenleg nincs, de általában elé kerül a Prometheus, amelyben ezt a recoding szabályokban meg lehet csinálni.
Például, az előző munkámban szükség volt az események számának számlálására egy mozgó ablakban az utolsó órában. A probléma az volt, hogy egy egyedi megoldást kellett készítenem Go nyelven, tehát egy szolgáltatást az ilyen dolog számítására. Ez a szolgáltatás végül nem volt triviális, mert nehéz volt számolni. A megvalósítás egyszerű lehet, ha fix időintervallumokban kell számolni valamilyen aggregátumot. Ha azonban eseményeket szeretne számolni egy mozgó ablakban, akkor ez nem olyan egyszerű, mint amilyennek látszik. Azt hiszem, ezt a ClickHouse-ban vagy az időszakos adatbázisokban még mindig nem valósították meg, mert a megvalósítása bonyolult.
És még egy kérdés. Most az átlagolásról beszéltünk, és eszembe jutott, hogy régen létezett egy Graphite nevű dolog a Carbon háttérrel. Ez képes volt a régi adatokat ritkítani, azaz egy pontot hagyott egy percben, egy pontot egy órában stb. Alapvetően ez elég kényelmes, ha nyers adatokat akarunk, mondjuk egy hónapra, a többit pedig lehet ritkítani. De a Prometheus és a VictoriaMetrics nem támogatják ezt a funkciót. Tervezik ezt támogatni? Ha nem, akkor miért?
Köszönjük a kérdést. Felhasználóink rendszeresen felteszik ezt. Kérdezik, mikor fogjuk hozzáadni a downsampling támogatását. Itt több probléma van. Először is, minden felhasználó mást ért alatta downsampling valami sajátos: valaki egy tetszőleges pontot szeretne a megadott intervallumban, mások a maximális, minimális, átlagos értékeket keresik. Ha a rendszeredbe sok különböző rendszer ír adatokat, akkor nem lehet mindent egy kalap alá venni. Lehet, hogy minden egyes rendszerhez más downsampling szükséges. És ez nehéz a megvalósításban.
A második probléma pedig az, hogy a VictoriaMetrics, akárcsak a ClickHouse, a nagy mennyiségű nyers adatok feldolgozására van optimalizálva, így akár másodpercenként képes egy milliárd sort is átvizsgálni, ha sok mag van a rendszeredben. A VictoriaMetrics időszakos adatai esetén 50 000 000 pont másodpercenként egy magra. Ez a teljesítmény skálázható a rendelkezésre álló magok számával. Tehát ha például 20 magod van, akkor másodpercenként egy milliárd pontot tudsz átvizsgálni. Ez a VictoriaMetrics és a ClickHouse tulajdonsága csökkenti a downsampling iránti igényt.
Egy másik tulajdonsága, hogy a VictoriaMetrics hatékonyan tömöríti ezeket az adatokat. A tömörítés átlagosan 0,4 és 0,8 byte között van egy pont esetében élesben. Minden pont egy timestamp + érték. És ez átlagosan kevesebb mint egy byte-ra tömörül.
Szergej. Van egy kérdésem. Mi a minimális teljesítménynövelési idő?
Egy milliszekundum. Nemrég beszélgettünk más időszakos adatbázis-fejlesztőkkel. Náluk a minimális időintervallum egy másodperc. A Graphite-nál például szintén egy másodperc. Az OpenTSDB esetében is egy másodperc. Az InfluxDB másodperces pontossággal működik. A VictoriaMetrics pedig egy milliszekundumot használ, mert a Prometheusnál is egy milliszekundum van. A VictoriaMetrics-t eredetileg a Prometheus távoli tárolójaként fejlesztették ki. De ma már képes adatokat tárolni más rendszerekből is.
A férfi, akivel beszéltem, azt mondta, hogy náluk másodperces pontosság van — nekik ez elegendő, mert ez attól függ, milyen típusú adatokat tárolnak az időszakos adatbázisban. Ha DevOps-adatokról vagy infrastruktúrával kapcsolatos adatokkal van szó, ahol 30 másodpercenként, egy percenként gyűjtöd őket, akkor ott a másodperces pontosság elegendő, kevesebb már nem szükséges. Ha azonban ezek az adatok high frequency trading rendszerekből származnak, akkor nanosekundás pontosításra van szükség.
A millisecundum pontossága a VictoriaMetricsben mind a DevOps-esetekhez, mind pedig a legtöbb olyan esetre megfelelő, amelyet a beszédem elején említettem. Az egyetlen dolog, amire nem valószínű, hogy megfelelő lenne, az a nagy frekvenciájú kereskedési rendszerek.
Köszönöm! Még egy kérdésem van. Milyen a PromQL kompatibilitás?
Teljes visszafelé kompatibilitás. A VictoriaMetrics teljes mértékben támogatja a PromQL-t. Ezen kívül hozzáad egy olyan kiegészítő, kibővített funkciót a PromQL-hez, amelyet úgy hívnak, hogy . A kibővített funkcióval kapcsolatban van egy előadás a YouTube-on. Tavasszal a Monitoring Meetup-on beszéltem erről Szentpéterváron.
Telegram csatorna .
Csak a regisztrált felhasználók vehetnek részt a szavazáson. , kérem.
Mi akadályozza meg, hogy a VictoriaMetricsra válts hosszú távú tárolóként a Prometheus számára? (Írjatok megjegyzésben, hozzáadom a kérdőívhez))
71,4%Nem használok Prometheus5
28,6%Nem tudtam a VictoriaMetrics2-ről
7 felhasználó szavazott. 12 felhasználó tartózkodott.
Forrás: habr.com
