

Ez a történet arról szól, hogyan használjuk a konténereket a termék környezetében, különösen Kubernetes alatt. A cikk a metrikák és a naplók gyűjtésére, valamint a képek összeállítására összpontosít.
Mi az Exness pénzügyi technológiai cég vagyunk, amely online kereskedési és pénzügyi termékek fejlesztésével foglalkozik B2B és B2C területen. R&D részlegünkben sok különböző csapat van, a fejlesztőosztályban több mint 100 munkatárs dolgozik.
Mi képviseljük azt a csapatot, amely felelős a fejlesztőink által írt kódok gyűjtésének és végrehajtásának platformjáért. Különösen minket terhel a metrikák, naplók és események gyűjtése, tárolása és biztosítása az alkalmazásokból. Jelenleg körülbelül háromezer Docker-konténert üzemeltetünk a termék környezetében, támogatjuk a 50 TB méretű big data tárolónkat, és olyan architektúrás megoldásokat nyújtunk, amelyek a rendszerünk, a Kubernetes, a Rancher és különböző nyilvános felhőszolgáltatók köré épülnek.
A mi motivációnk
Mi a helyzet? Senki sem tudja megmondani. Hol a tűz? Nehéz megérteni. Mikor gyulladt ki? Megtudható, de nem azonnal.
Miért állnak meg egyes konténerek, míg mások összedőlnek? Melyik konténer a felelős ezért? Külsőre a konténerek egyformák, de belül mindegyiknek megvan a maga Neo-ja.
A fejlesztőink nagyon ügyes srácok. Jó szolgáltatásokat készítenek, amelyek nyereséget hoznak a cégnek. De előfordulnak balesetek, amikor az alkalmazásokat futtató konténerek eltérnek az úttól. Az egyik konténer túl sok CPU-t használ, a másik a hálózatot, a harmadik a bemeneti/kimeneti műveleteket, a negyedik pedig egyáltalán nem világos, hogy mit csinál a socketekkel. Mindez összeomlik, és a hajó süllyed.
Ügynökök
Annak érdekében, hogy megértsük, mi történik belül, úgy döntöttünk, hogy ügynököket állítunk fel közvetlenül a konténerekben.
Ezek az ügynökök koordináló programok, amelyek fenntartják a konténerek állapotát, hogy ne törjék meg egymást. Az ügynökök standardizáltak, és ez lehetővé teszi a konténerek karbantartásához való megközelítés standardizálását.
A mi esetünkben az ügynököknek standard formátumban kell naplókat biztosítaniuk, címkézve és throttlinggal. Emellett standardizált metrikákat is kell szolgáltatniuk, amelyek bővíthetők az üzleti alkalmazások szempontjából.
Az ügynökök alatt olyan eszközöket is értünk, amelyek hasznosak a karbantartásban és üzemeltetésben, amelyek képesek különböző orkestrációs rendszerekben működni, támogatják a különböző képeket (Debian, Alpine, Centos stb.).
Végül az ügynököknek egyszerű CI/CD-t kell támogatniuk, amely magában foglalja a Docker fájlokat. Ellenkező esetben a hajó szétesik, mert a konténerek "ferde" síneken fognak érkezni.
A cél image felépítési folyamata és struktúrája
Annak érdekében, hogy minden standardizált és kezelhető legyen, valamilyen standard felépítési folyamatot kell követni. Ezért úgy döntöttünk, hogy konténerekkel építjük a konténereket – ez egyfajta rekurzió.
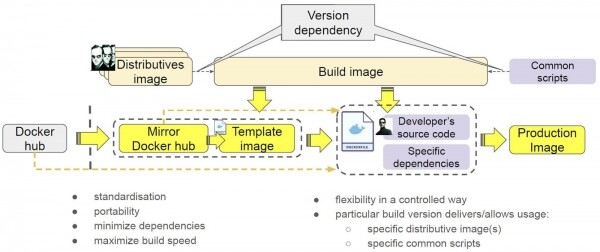
Itt a konténerek folyamatos kontúrok formájában vannak bemutatva. Egyúttal úgy döntöttünk, hogy elhelyezzük bennük a disztribúciókat, hogy az élet ne tűnjön olyan egyszerűnek. Miért tettük ezt, az alább elmondjuk.
Ennek eredményeként egy építési eszköz jött létre – egy adott verziójú konténer, amely hivatkozik egyes disztribúciók és egyes szkriptek meghatározott verzióira.
Hogyan alkalmazzuk ezt? Van egy Docker Hubunk, ahol a konténer tárolódik. Ezt szinkronizáljuk a rendszerünkbe, hogy megszabaduljunk a külső függőségektől. Így egy sárga színnel megjelölt konténert kaptunk. Készítünk egy sablont, hogy az összes szükséges disztribúciót és szkriptet telepítsük a konténerbe. Ezt követően elkészítjük a készenléti képet: a fejlesztők beleteszik a kódot és bizonyos saját függőségeiket.
Miért jó ez a megközelítés?
- Először is, teljes verzióellenőrzés a felépítési eszközök - a konténer, a szkriptek és a disztribúciók verziói tekintetében.
- Másodszor, elértük a standardizációt: azonos módon készítjük el a sablonokat, az átmeneti és a készenléti képeket.
- Harmadszor, a konténerek biztosítják számunkra a hordozhatóságot. Ma Gitlabot használunk, holnap áttérünk TeamCity-re vagy Jenkins-re, és így is el tudjuk indítani a konténereinket.
- Negyedszer, a függőségek minimalizálása. Nem véletlenül helyeztük el a konténerben a disztribúciókat, hiszen ez lehetővé teszi, hogy ne töltsük le őket minden alkalommal az Internetről.
- Ötödször, nőtt az építési sebesség – a helyi képek megléte lehetővé teszi, hogy ne pazaroljunk időt a letöltésre, mivel rendelkezünk helyi képpel.
Más szóval, elértük a kontrollálható és rugalmas felépítési folyamatot. Azonos eszközöket használunk bármilyen konténer építésére, teljes verziózás mellett.
Hogyan működik a felépítési eljárásunk?
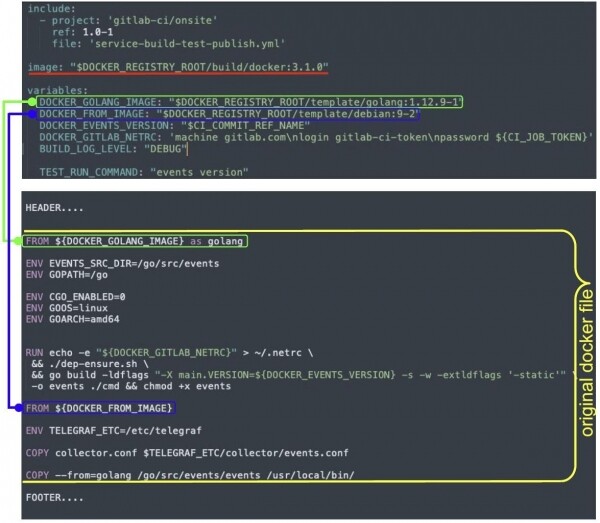
A build is initiated with a single command, the process runs in an image (highlighted in red). The developer has a Docker file (highlighted in yellow), which we render by replacing variables with values. Along the way, we add headers and footers — these are our agents.
The header adds distributions from the corresponding images. The footer installs our services, configures the workload execution, logging, and other agents, replaces the entrypoint, and so on.
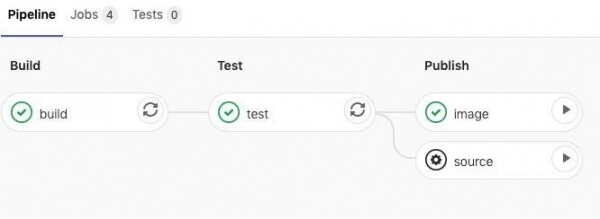
We debated for a long time whether to install a supervisor. In the end, we decided that we need one. We chose S6. The supervisor manages the container: it allows connections in case the main process fails and provides manual management of the container without recreating it. Logs and metrics are processes running inside the container. They also need to be monitored somehow, and we do this with the help of the supervisor. Finally, S6 takes care of housekeeping tasks, signal processing, and other responsibilities.
Since we are using different orchestration systems, after the build and launch, the container must understand what environment it is in and act accordingly. For example:
This allows us to create a single image and run it in different orchestration systems, taking into account the specifics of each orchestration system.
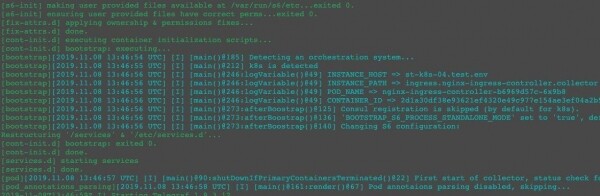
For the same container, we get different process trees in Docker and Kubernetes:
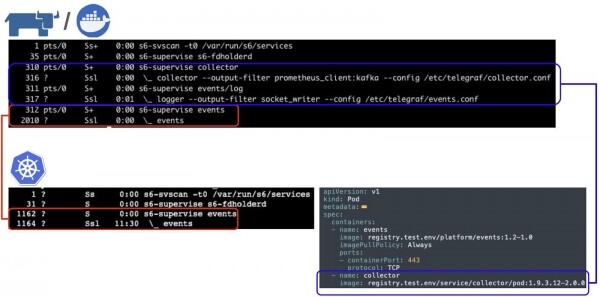
The payload runs under the S6 supervisor. Note the collector and events — these are our agents responsible for logs and metrics. They are absent in Kubernetes but present in Docker. Why?
If we look at the specification of a pod (here and later – Kubernetes pod), we will see that the events container runs in a pod that has a separate collector container performing the function of collecting metrics and logs. We can leverage Kubernetes capabilities: launching containers in the same pod, in a single process and/or network space. In fact, we can embed our agents and perform various functions. And if this same container is launched in Docker, it will retain all the same capabilities, that is, it will be able to deliver logs and metrics since the agents will be running inside.
Metrics and logs
Delivering metrics and logs is a complex task. Several aspects are associated with its solution.
Az infrastruktúrát a hasznos terhelés futtatására alakítják ki, nem pedig a logok tömeges továbbítására. Ezért ennek a folyamatnak minimális erőforrásigénnyel kell működnie a tartályok számára. Segíteni szeretnénk fejlesztőinknek: „Végy egy Docker Hub konténert, indítsd el, és mi el tudjuk juttatni a logokat.”
A második szempont a logok mennyiségének korlátozása. Ha több konténerben logmennyiség-ugrás (például egy alkalmazás folyamatosan kiírja a stack trace-t) fordul elő, az CPU, sávszélesség és a logfeldolgozó rendszer terhelését növeli, ami a gazdagép és a gazdagépen lévő többi konténer működésére is hatással van, és néha a gazdagép "összeomlásához" vezet.
A harmadik szempont, hogy a lehető legtöbb metrikagyűjtési módszert dobozból támogassuk. A fájlok olvasásától és a Prometheus-endpoint lekérdezésétől kezdve a specifikus alkalmazási protokollok használatáig.
És végül, minimalizálni kell az erőforrás-fogyasztást.
Egy Go nyelvű open-source megoldást választottunk, amely Telegraf névre hallgat. Ez egy univerzális csatlakozó, amely több mint 140 különböző bemeneti csatornát (input plugins) és 30 különböző kimeneti csatornát (output plugins) támogat. Ezen továbbfejlesztettük, és most bemutatjuk, hogyan használjuk a Kubernetes példáján.
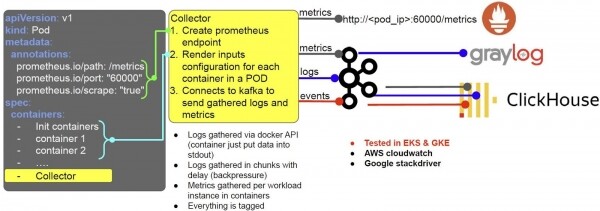
Tegyük fel, hogy a fejlesztő egy terhelést telepít, és a Kubernetes kérdést kap a pod létrehozására. Ekkor minden podhoz automatikusan létrejön egy Collector nevű konténer (mutation webhookot használunk). A Collector a mi ügynökünk. Induláskor ez a konténer beállítja magát a Prometheus és a loggyűjtő rendszer működésére.
- Ehhez pod annotációkat használ, és az azok tartalmától függően létrehoz például egy Prometheus végpontot;
- A pod specifikációja és a konténerek specifikus beállításai alapján dönti el, hogyan továbbítja a logokat.
A logokat a Docker API-n keresztül gyűjtjük: a fejlesztőknek elég a stdout vagy stderr kimenetre helyezniük őket, a Collector pedig intézkedik. A logokat chunkokban gyűjtjük, némi késleltetéssel, hogy elkerüljük a gazdagép esetleges túlterhelését.
A metrikák a konténerekben futó terhelés- (folyamat-) példányok szerint kerülnek gyűjtésre. Minden címkézve van: namespace, pod stb., majd Prometheus formátumra konvertálódik – és így gyűjthetővé válik (a logokon kívül). Emellett a logokat, metrikákat és eseményeket a Kafka rendszerbe és tovább küldjük:
- A logok a Graylogban érhetők el (vizuális elemzéshez);
- A naplókat, metrikákat és eseményeket Clickhouse-ba küldjük hosszú távú tárolásra.
Ugyanígy működik az AWS-ben is, csak a Graylogot Kafka helyett Cloudwatch-ra cseréljük. A naplókat oda küldjük, és ez nagyon kényelmes: azonnal tisztában vagyunk azzal, hogy melyik klaszterhez és konténerhez tartoznak. Ugyanez érvényes a Google Stackdriverre is. Tehát a sémánk on-premise Kafka-val, valamint felhőben is működik.
Ha nincs Kubernetesünk podokkal, a séma kicsit bonyolultabb, de ugyanazon elveken alapul.
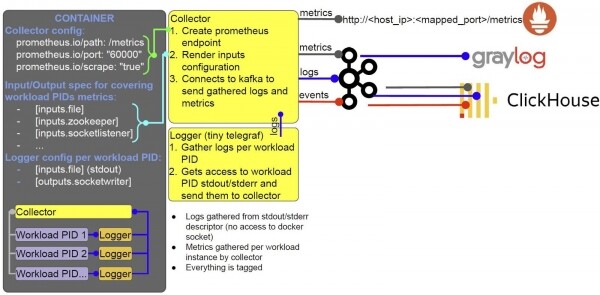
A konténeren belül ugyanazok a folyamatok futnak, amelyeket S6 segítségével orchestrálunk. Minden ugyanaz a folyamat fut egyetlen konténeren belül.
Végül
Teljes megoldást hoztunk létre a képek építésére és üzembe helyezésére, logok és metrikák gyűjtési és szállítási lehetőségekkel:
- A képek építésére standardizált megközelítést dolgoztunk ki, amely alapján CI-sablonokat fejlesztettünk;
- Az adatgyűjtő ügynökök a mi Telegraf kiterjesztéseink. Jól beváltuk őket production környezetben;
- Mutation webhookot alkalmazunk az ügynökökkel rendelkező konténerek podokba történő bevezetésére;
- Integrálódtunk a Kubernetes/Rancher ökoszisztémába;
- Képesek vagyunk ugyanazokat a konténereket futtatni különböző orchestrálási rendszerekben, és megkapni a várt eredményt;
- Teljesen dinamikus konténerkezelő konfigurációt hoztunk létre.
Társszerző: Ilya Prudnikov
Forrás: habr.com
