

Milyen elvek alapján épül fel az ideális Adatgyűjtő?
Fókusz az üzleti értéken és analitikán, a boilerplate kód hiányában. A DWH kezelése mint kódbázis: verziókezelés, véleményezés, automatikus tesztelés és CI. Moduláris, bővíthető, nyílt forráskódú és közösségi támogatás. Felhasználóbarát dokumentáció és a függőségek vizualizálása (Data Lineage).
Mindez részletesebben és a DBT szerepe a Big Data & Analytics ökoszisztémában — üdvözöljük a cikk alatt.
Mindenkinek helló
Itt Artemiy Kozyr. Több mint 5 éve dolgozom adatgyűjtőkkel, ETL/ELT építéssel foglalkozom, valamint adat-analitikát és vizualizálást végzek. Jelenleg a nál dolgozom, az OTUS-nál tanítok a kurzuson, és ma szeretnék megosztani veletek egy cikket, amelyet a új kurzus indítása előtt írtam.
Rövid áttekintés
A DBT keretrendszer mindent a T betűről szól az ELT (Extract — Transform — Load) akronímben.
Az olyan hatékony és méretezhető analitikai adatbázisok megjelenésével, mint a BigQuery, Redshift, Snowflake, elvesztette értelmét a transzformációk végrehajtása az Adatgyűjtőn kívül.
A DBT nem exportálja az adatokat a forrásokból, de óriási lehetőségeket biztosít a már betöltött adatokkal való munkához (Internal vagy External Storage).
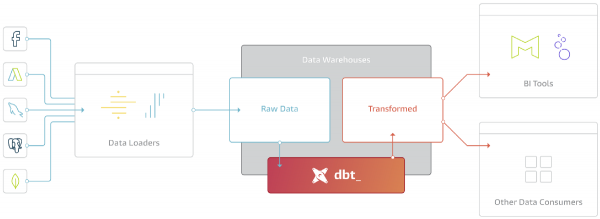
A DBT fő funkciója a kód átvétele, annak SQL-ből való lefordítása, és a parancsok végrehajtása a megfelelő sorrendben az Adatgyűjtőben.
A DBT projekt felépítése
A projekt kétféle típusból álló könyvtárakból és fájlokból áll:
- Modell (.sql) — a transzformáció egysége, amely SELECT lekérdezés formájában van megfogalmazva
- Konfigurációs fájl (.yml) — paraméterek, beállítások, tesztek, dokumentáció
Alapvető szinten a munka a következőképpen épül fel:
- A felhasználó bármilyen kényelmes IDE-ben elkészíti a modellek kódját
- CLI segítségével a modellek futtatása hívható meg, a DBT SQL-ra fordítja a modellek kódját
- A lefordított SQL-kód az Adatgyűjtőben a megadott sorrendben (grafikon) végrehajtásra kerül
Így nézhet ki a CLI-ből történő futtatás:
Minden SELECT
Ez a Data Build Tool keretrendszer bomba funkciója. Más szavakkal, a DBT absztrahálja az összes kódot, amely a lekérdezések Adatgyűjtőben való materializálásával kapcsolatos (változatok a CREATE, INSERT, UPDATE, DELETE, ALTER, GRANT parancsokból…).
Bármely modell megköveteli egy SELECT lekérdezés megírását, amely meghatározza az eredményhalmazt.
A transzformációk logikája többszintű lehet, és több más modell adatait egyesítheti. Példa egy modellre, amely az rendeléseket összegző vitrinát épít (f_orders):
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

 select * from {{ ref('stg_orders') }}

),

order_payments as (

 select * from {{ ref('order_payments') }}

),

final as (

 select
 orders.order_id,
 orders.customer_id,
 orders.order_date,
 orders.status,
 {% for payment_method in payment_methods -%}
 order_payments.{{payment_method}}_amount,
 {% endfor -%}
 order_payments.total_amount as amount
 from orders
 left join order_payments using (order_id)

)

select * from final
Mit látunk érdekeset itt?
Először is: CTE-k (Common Table Expressions) használata a kód szervezésére és megértésére, amely sok transzformációt és üzleti logikát tartalmaz.
Másodszor: A modell kódja SQL és a (sablonnyelv) keveréke.
A példában ciklus van használva for annak érdekében, hogy minden fizetési módszer esetén kiszámítsa az összeget, amelyet a setkifejezésben megadtak. Emellett a ref kapcsolatot létesít más modellekre a kódban:
- A fordítás során ref célzott hivatkozássá alakul át a táblázatra vagy nézetre a Tárolóban,
- ref és lehetővé teszi a modellek közötti függőségek gráfjának felépítését.
Ez adja a DBT-nek csaknem korlátlan lehetőségeket. A leggyakrabban használtak közül a következők: If/else utasítások — ágazzási operátorok
- For ciklusok — ciklusok
- Változók — változók
- Makró — makrók létrehozása
- Anyagiasítás: Table, View, Incremental
Az Anyagiasítási Stratégia — megközelítés, amely szerint a modell végső adatsora a Tárolóban lesz tárolva.
Alapvető megközelítésben ez a következő:
Table — fizikai táblázat a Tárolóban
- View — nézet, virtuális táblázat a Tárolóban
- Vannak ennél bonyolultabb anyagiasítási stratégiák is:
Incremental — inkrementális betöltés (nagy tény táblák); új sorok kerülnek hozzáadásra, a módosítottak frissülnek, a töröltek eltávolításra kerülnek.
- Ephemeral — a modell nem közvetlenül anyagiasodik, de CTE-ként más modellekben részt vesz.
- Bármilyen más stratégiát hozzáadhat, amelyet önállóan kialakít.
- Az anyagiasítási stratégiák mellett lehetőségek nyílnak a konkrét Tárolókra való optimalizálásra, például:
Snowflake
- : Átmeneti táblák, Összefésülési viselkedés, Tábla csoportosítás, Engedmények másolása, Biztonságos nézetekRedshift
- : Distkey, Sortkey (interleaved, compound), Késleltetett kötésű nézetekBigQuery
- : Tábla particionálás és csoportosítás, Összefésülési viselkedés, KMS titkosítás, Címkék és TagokSpark
- Spark: Fájlformátum (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
Jelenleg a következő tárolók támogatottak:
- Postgres
- : Distkey, Sortkey (interleaved, compound), Késleltetett kötésű nézetek
- : Tábla particionálás és csoportosítás, Összefésülési viselkedés, KMS titkosítás, Címkék és Tagok
- : Átmeneti táblák, Összefésülési viselkedés, Tábla csoportosítás, Engedmények másolása, Biztonságos nézetek
- Presto (részben)
- Spark (részben)
- Microsoft SQL Server (közösségi adapter)
Fejlesszük tovább a modelünket:
- Tegyük a feltöltést inkrementálissá (Incremental)
- Adja hozzá a szegmentálási és rendezési kulcsokat a Redshift-hez
-- A modell konfigurációja:
-- Inkrementális feltöltés, egyedi kulcs a rekordok frissítéséhez (unique_key)
-- Szelekciós kulcs (dist), rendezési kulcs (sort)
{{
  config(
       materialized='incremental',
       unique_key='order_id',
       dist="customer_id",
       sort="order_date"
   )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Ez a szűrő csak az inkrementális futtatásokra vonatkozik
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
A modellek függőségi gráfja
Ez a függőségi fa. Ugyanaz, mint a DAG (Directed Acyclic Graph — Irányított Aknélküli Gráf).
A DBT gráfot épít az összes projektmodell konfigurációja alapján, pontosabban a modelleken belüli ref() hivatkozások alapján más modellekre. A gráf megléte lehetővé teszi a következőket:
- A modellek megfelelő sorrendben történő futtatása
- A tárolók létrehozásának párhuzamosítása
- Tetszőleges algráf futtatása
A gráf vizualizálásának példája:
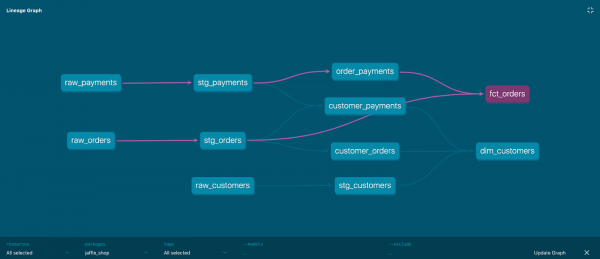
Minden csomópont a gráfban egy modell, a gráf élei a ref kifejezés által adottak.
Adatminőség és Dokumentáció
A modellek létrehozása mellett a DBT lehetőséget biztosít arra, hogy tesztelje a végső adathalmazzal kapcsolatos különböző feltevéseket (assertions), például:
- Not Null
- Unique
- Hivatkozási integritás — a hivatkozási integritás (például a customer_id a megrendelések táblában megfelel az id-nek a vásárlók táblában)
- Megfelelés a megengedett értékek listájának
Saját tesztek (custom data tests) hozzáadása is lehetséges, például a bevételi eltérés % a múlt hét, hónap mutatóihoz viszonyítva. Bármely feltevés, amely SQL lekérdezés formájában megfogalmazható, tesztté válhat.
Így a tárolókban a nem kívánt eltérések és adatbeli hibák kiszűrhetők.
A dokumentálás tekintetében a DBT olyan mechanizmusokat biztosít, amelyek lehetővé teszik a metadaták és megjegyzések hozzáadását, verziózását és terjesztését modellek és sőt attribútumok szinten is.
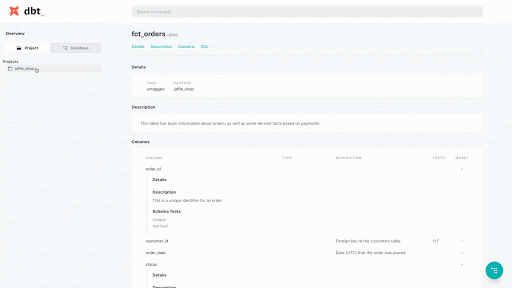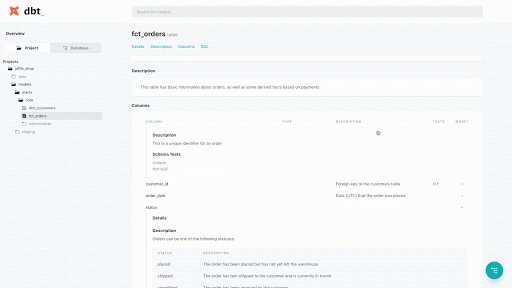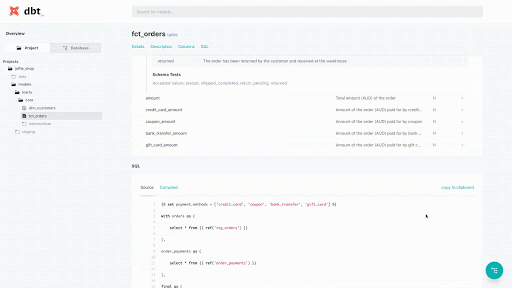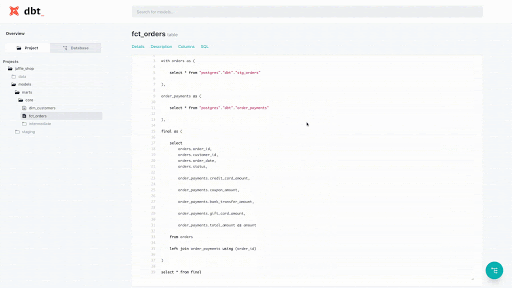
Így néz ki a tesztek és dokumentáció hozzáadása a konfigurációs fájl szintjén:
 - name: fct_orders
   description: Ez a táblázat alapvető információkat tartalmaz a megrendelésekről, valamint néhány származtatott tényt a kifizetések alapján
   columns:
     - name: order_id
       tests:
         - unique # az értékek egyediségének ellenőrzése
         - not_null # null értékek meglétének ellenőrzése
       description: Ez a megrendelés egyedi azonosítója
     - name: customer_id
       description: Külső kulcs a vevői táblához
       tests:
         - not_null
         - relationships: # hivatkozási integritás ellenőrzése
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: A megrendelés leadásának dátuma (UTC)
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # megengedett értékek ellenőrzése
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
Így néz ki ez a dokumentáció már a generált weboldalon:
Makrók és Modulok
A DBT célja nem annyira az, hogy egy SQL-scriptekből álló készlet legyen, hanem hogy lehetőséget adjon a felhasználóknak erőteljes és gazdag funkcionalitású eszközök biztosítására saját transzformációik felépítéséhez és ezen modulok terjesztéséhez.
A makrók olyan kifejezések és konstrukciók halmazai, amelyeket funkcióként hívhatunk meg a modelleken belül. A makrók lehetővé teszik az SQL újrahasznosítását modellek és projektek között a DRY (Don’t Repeat Yourself) mérnöki elv szerint.
Makró példa:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike  '%osx%' then 'osx'
 when {{ column_name }} ilike  '%android%' then 'android'
 when {{ column_name }} ilike  '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
És annak használata:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- a makró meghívása
from my_table
A DBT csomagkezelővel (packages) érkezik, amely lehetővé teszi a felhasználók számára, hogy különálló modulokat és makrókat publikáljanak és újrahasználjanak.
Ez lehetőséget jelent olyan könyvtárak letöltésére és használatára, mint például:
- : munkavégzés dátum/idő, helyettesítő kulcsok, séma tesztek, Pivot/Unpivot és mások
- Kész vitrin sablonok olyan szolgáltatásokhoz, mint például és
- Könyvtárak bizonyos Adattárakhoz, például
- — A DBT működésének naplózási modulja
A csomagok teljes listáját a következő címen találja: .
Még több lehetőség
Itt néhány más érdekes jellemzőt és megvalósítást írok le, amelyeket én és a csapatom a Data Warehouse felépítéséhez használunk. .
A futtatási környezetek szétválasztása DEV — TEST — PROD
Még egyetlen DWH klaszteren belül is (különböző sémák keretein belül). Például a következő kifejezéssel:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Ez a kód gyakorlatilag azt mondja: a környezetek számára dev, test, ci csak az utolsó 3 nap adatait vedd figyelembe, és semmi többet. Ezáltal a futás ezekben a környezetekben sokkal gyorsabb lesz, és kevesebb erőforrást igényel. A prod környezetben a szűrőfeltétel figyelmen kívül marad.
Anyagcsökkentés alternatív oszlopkódolással
A Redshift egy oszlopalapú DBMS, amely lehetővé teszi az adatok tömörítési algoritmusainak megadását minden egyes oszlop számára. Az optimális algoritmusok kiválasztása 20-50%-kal csökkentheti a lemezterületet.
A makró végrehajtja az ANALYZE COMPRESSION parancsot, létrehoz egy új táblát a javasolt oszlopkódolási algoritmusokkal, a megadott szegmentálási (dist_key) és rendezési (sort_key) kulcsokkal, áthelyezi az adatokat, és szükség esetén törli a régi másolatot.
A makró aláírása:
{{ compress_table(schema, table,
                 drop_backup=False,
                 comprows=none|Integer,
                 sort_style=none|compound|interleaved,
                 sort_keys=none|List,
                 dist_style=none|all|even,
                 dist_key=none|String) }}
Modellek futási naplózása
Minden modell futtatásához függelékeket (hooks) lehet csatolni, amelyeket a modell elkészítése előtt vagy azonnal utána hajtanak végre:
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
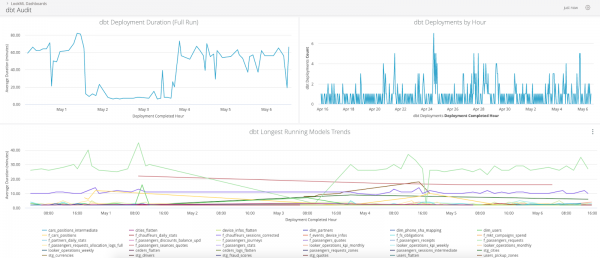
A naplózó modul lehetővé teszi, hogy minden szükséges metaadatot külön táblába rögzítsenek, amely alapján később auditálásra és problémák (bottlenecks) elemzésére kerülhet sor.
Így néz ki egy naplózott adatokat bemutató dashboard a Lookerben:
A Data Warehouse karbantartásának automatizálása
Ha bármilyen kiterjesztést használ a használt Data Warehouse funkcióval, például UDF (User Defined Functions), akkor ezeknek a funkcióknak a verziókezelése, a hozzáférések kezelése és az új verziók automatizált kiadása a DBT-ben nagyon kényelmesen végezhető.
Python nyelven UDF-et használunk a hash értékek, az e-mail címek domainjeinek kiszámításához, valamint a bitmask dekódolásához.
Egy példa makró, amely UDF-et hoz létre bármilyen futási környezetben (fejlesztés, tesztelés, termelés):
{% macro create_udf() -%}

  {% set sql %}
      CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
          RETURNS varchar
          LANGUAGE plpythonu
          STABLE
      AS $$
          import hashlib
          return hashlib.sha256(mes).hexdigest()
      $$
      ;
  {% endset %}

  {% set table = run_query(sql) %}

{%- endmacro %}
A Wheely-nél az Amazon Redshift-et használjuk, amely a PostgreSQL-en alapul. A Redshift számára fontos, hogy rendszeresen statisztikákat gyűjtsünk a táblákról és felszabadítsuk a lemezterületet — ehhez az ANALYZE és VACUUM parancsokat kell használni.
Ehhez minden éjjel végrehajtjuk a redshift_maintenance makró parancsait:
{% macro redshift_maintenance() %}

   {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

   {% for row in vacuumable_tables %}
       {% set message_prefix=loop.index ~ " of " ~ loop.length %}

       {%- set relation_to_vacuum = adapter.get_relation(
                                       database=row['table_database'],
                                       schema=row['table_schema'],
                                       identifier=row['table_name']
                                   ) -%}
       {% do run_query("commit") %}

       {% if relation_to_vacuum %}
           {% set start=modules.datetime.datetime.now() %}
           {{ dbt_utils.log_info(message_prefix ~ " Vacuuming " ~ relation_to_vacuum) }}
           {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
           {{ dbt_utils.log_info(message_prefix ~ " Analyzing " ~ relation_to_vacuum) }}
           {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
           {% set end=modules.datetime.datetime.now() %}
           {% set total_seconds = (end - start).total_seconds() | round(2)  %}
           {{ dbt_utils.log_info(message_prefix ~ " Finished " ~ relation_to_vacuum ~ " in " ~ total_seconds ~ "s") }}
       {% else %}
           {{ dbt_utils.log_info(message_prefix ~ ' Skipping relation "' ~ row.values() | join ('"."') ~ '" as it does not exist') }}
       {% endif %}

   {% endfor %}

{% endmacro %}
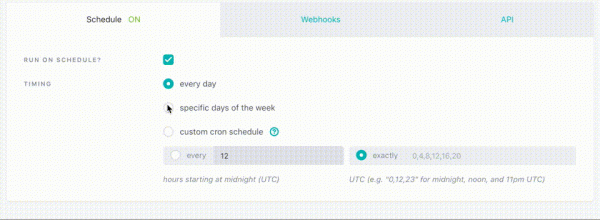
DBT Cloud
Lehetőség van a DBT használatára szolgáltatásként (Managed Service). A csomag tartalmazza:
- Web IDE a projektek és modellek fejlesztéséhez
- Feladatok konfigurálása és ütemezése
- Egyszerű és kényelmes hozzáférés a naplókhoz
- Weboldal a projekt dokumentációjával
- CI (Continuous Integration) csatlakoztatása
Zárás
A DWH készítése és használata olyan örömteli és jótékony tevékenységgé válik, mint a smoothie-k fogyasztása. A DBT Jinja-ból, felhasználói kiterjesztésekből (module), fordítóből, végrehajtóból (executor) és csomagkezelőből áll. Ezeknek az elemeknek az egyesítése egy teljes értékű munkakörnyezetet biztosít az Ön Adatnyilvántartásához. Ma már aligha létezik jobb módszer az adatok DWH-n belüli átalakításainak kezelésére.
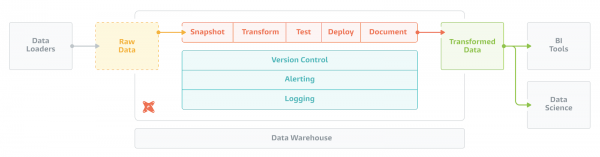
A DBT fejlesztői által követett meggyőződések a következőképpen fogalmazhatók meg:
- A kód, és nem a GUI, a legjobb absztrakció a bonyolult analitikai logika kifejezésére.
- Az adatokkal való munkának alkalmaznia kell a szoftverfejlesztés legjobb gyakorlatait.
- A legfontosabb adatmunkálati infrastruktúrát a felhasználói közösségnek kell ellenőriznie, mint nyílt forráskódú szoftvert.
- Nemcsak az elemzőeszközök, hanem a kód is egyre inkább a Nyílt Forráskódú közösség tulajdonává válik.
Ezek a fő meggyőződések olyan terméket teremtettek, amelyet ma már több mint 850 vállalat használ, és alapját képzik számos érdekes kiterjesztésnek, amely a jövőben létrejön.
Azok számára, akiket érdekel, egy felvétel érhető el az általam néhány hónappal ezelőtt az OTUS keretein belül tartott nyílt óráról — .
A DBT mellett, az OTUS Data Engineer tanfolyam keretében, én és kollégáim számos más aktuális és modern témáról tartunk órákat:
- A Nagy Adatok Alkalmazásainak Architektúrás Koncepciói.
- Gyakorlat a Sparkkal és a Spark Streaminggel.
- Adatforrások betöltési módszereinek és eszközeinek tanulmányozása.
- Elemzői bemutatók létrehozása a DWH-ban.
- NoSQL koncepciók: HBase, Cassandra, ElasticSearch.
- A megfigyelés és az orkestráció szervezésének elvei.
- Végső Projekt: összegyűjtjük az összes készséget mentorálás mellett.
Linkek:
- — Hivatalos dokumentáció.
- — A DBT egyik szerzőjének áttekintő cikk.
- — YouTube, Az OTUS nyílt óra felvétele.
- — Legközelebbi nyílt óra 2020. május 15-én.
- — OTUS.
- — Tekintet a jövőbeli adatmunkákra és analitikára.
- — Az analitika fejlődése és a Nyílt Forráskód hatása.
- — A CI felépítésének elvei DBT használatával.
- — Gyakorlat, lépésről lépésre útmutató önálló munkához.
- — Github, a tanfolyam kódja
Forrás: habr.com
