

Az írás fordítása kifejezetten a kurzus hallgatói számára készült .
— szoftverfejlesztő, a Go fanatikusa, aki szereti a komplex problémák megoldását. Jelenleg a Prometheus karbantartója és a Kubernetes SIG instrumentation társalapítója. Korábban a SoundCloud produkciós mérnöke volt, és a CoreOS monitoring csoportját irányította. Jelenleg a Google-nál dolgozik.
— infrastruktúra mérnök az Improbable-nél. Érdekli az új technológiák és a elosztott rendszerek problémái. Alacsony szintű programozási tapasztalattal rendelkezik az Intel-nél, hozzájárult a Mesoshoz, és globális SRE tapasztalattal bír az Improbable-nél. A mikroszolgáltatások világának javításán dolgozik. Három szenvedélye: Golang, open source és röplabda.
A zászlóshajónk, a SpatialOS láttán megtudhatja, hogy az Improbable számára a globális méretű, dinamikus felhőinfrastruktúrára van szükség, amely sok Kubernetes klasztert kezel. Mi voltunk az elsők, akik elkezdték használni a monitorozó rendszert . A Prometheus képes a valós idejű milliók metrikájának nyomon követésére, és egy erőteljes lekérdező nyelvet kínál, amely lehetővé teszi a szükséges információk kinyerését.
A Prometheus egyszerűsége és megbízhatósága az egyik fő előnye. Ugyanakkor, amikor elértük a bizonyos méretet, néhány hátrányba ütköztünk. E problémák megoldásához létrehoztuk — egy nyílt forráskódú projektet, amelyet az Improbable fejlesztett ki, hogy zökkenőmentesen átalakítsa a meglévő Prometheus klasztereket egyetlen monitorozó rendszerre, korlátlan történeti adataink tárolásával. A Thanos elérhető a Githubon .
Céljaink a Thanos-szal
Bizonyos méret esetén olyan problémák merülnek fel, amelyek meghaladják a vanília Prometheus lehetőségeit. Hogyan tároljunk petabájt történeti adatokat megbízhatóan és gazdaságosan? Meg lehet ezt valósítani anélkül, hogy károsítani kellene a lekérdezések válaszidejét? Hozzáférhetünk-e az összes metrikához, amelyek különböző Prometheus szervereken találhatók, egyetlen API-lekérdezéssel? Van-e mód a Prometheus HA által gyűjtött replikált adatok egyesítésére?
E kérdések megoldására hoztuk létre a Thanost. A következő szakaszokban bemutatjuk, hogyan közelítettük meg ezen problémák megoldását, és részletezzük azokat a célokat, amelyeket követni kívántunk.
Adatok lekérése több Prometheus példányból (globális lekérdezés)
A Prometheus funkcionális megközelítést kínál a shardinghoz. Még egyetlen Prometheus-szerver is elegendő skálázhatóságot biztosít ahhoz, hogy a felhasználókat megszabadítsa a horizontális sharding bonyodalmaitól a felhasználás szinte minden formájában.
Bár ez egy kiváló telepítési modell, gyakran szükséges hozzáférni az adatokhoz különböző Prometheus szervereken keresztül egyetlen API vagy UI — globális nézet — által. Természetesen lehetőség van arra, hogy több kérést jelenítsünk meg egy Grafana panelen, de minden kérést csak egy Prometheus szerveren lehet végrehajtani. Másrészről, a Thanos segítségével kérdéseket és aggregálhatjuk az adatokat több Prometheus szerverről, mivel mindegyikük egy végpontból elérhető.
Korábban, a globális nézet eléréséhez az Improbable-nál a Prometheus példányainkat több szintű struktúrában szerveztük. . Ez azt jelentette, hogy létrehoztunk egy meta-prometheus szervert, amely az „levél” szerverek mindegyikéről gyűjti a metrikák egy részét.
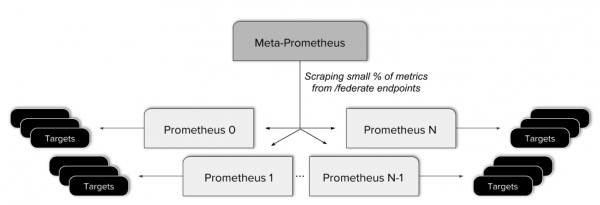
Ez a megközelítés problémássá vált. Bonyolultabb konfigurációt, egy potenciális hibapont hozzáadását és bonyolult irányelvek alkalmazását eredményezte, hogy a szövetséges végpontra csak a szükséges adatokat biztosítsuk. Ezenkívül az ilyen típusú föderáció nem biztosít valódi globális nézetet, mivel nem minden adat érhető el egyetlen API-kérésből.
Ez szorosan összefügg a magas rendelkezésre állású (high-availability, HA) Prometheus szervereken gyűjtött adatok egységes bemutatásával. A Prometheus HA-modell függetlenül gyűjti az adatokat kétszer, ami annyira egyszerű, hogy nem lehetne egyszerűbb. Azonban sokkal kényelmesebb lenne egyesíteni és deduplikálni a két áramlás közös bemutatását.
Természetesen szükség van a magas rendelkezésre állású Prometheus szerverekre. Az Improbable-nál nagyon komolyan vesszük az adatok percenkénti monitorozását, de egyetlen Prometheus példány a klaszterben egyetlen hibapontot jelent. Bármilyen konfigurációs hiba vagy hardverhiba potenciálisan fontos adatok elvesztéséhez vezethet. Még egy egyszerű telepítés is kis megszakításokhoz vezethet a metrikák gyűjtésében, mivel a újraindítás jelentősen tovább tarthat, mint a lehúzási intervallum.
Megbízható történelmi adatok tárolása
A megfizethető, gyors és tartós metrikatárolás az álmunk (az álmunk sok Prometheus felhasználóval osztozik). Az Improbable-nál arra kényszerültünk, hogy a metrikák tárolási idejét kilenc napra állítsuk be (Prometheus 1.8 esetén). Ez nyilvánvaló korlátozásokat jelent arra vonatkozóan, hogy milyen messze nézhetünk vissza.
A Prometheus 2.0 ebben a tekintetben javult, mivel a time series-ek száma már nem befolyásolja a szerver általános teljesítményét (lásd: ). Ennek ellenére a Prometheus az adatokat helyi lemezen tárolja. Bár a nagy hatékonyságú adatkompresszió jelentősen csökkentheti a helyi SSD használatát, végső soron még mindig van egy határ a megőrizhető történeti adatok mennyiségére.
Továbbá, az Improbable-nál figyelmet fordítunk a megbízhatóságra, az egyszerűségre és a költségekre. A nagy helyi lemezek nehezebben kezelhetőek és menthetőek. Drágábbak, és több eszközt igényelnek a biztonsági mentéshez, ami túlzott bonyolultságot eredményez.
Leewételezés
Amint elkezdtünk dolgozni a történeti adatokkal, rájöttünk, hogy alapvető nehézségek merülnek fel az O-nagyokkal, amelyek miatt a lekérdezések egyre lassabbá válnak, ha hetekkel, hónapokkal és évekkel dolgozunk.
A probléma standard megoldása a (downsampling) — a jel mintavételi frekvenciájának csökkentése. A mintavételi frekvencia csökkentésével "lekicsinyíthetjük" az időtartományt, és megőrizhetjük a régi minták számát, ami által a lekérdezések gyorsaságát megőrizhetjük.
A régi adatok leewételezése elkerülhetetlen követelmény minden hosszú távú tárolási megoldás esetén, és túlmutat a klasszikus Prometheus-on.
További célok
A Thanos projekt egyik elsődleges célja a zökkenőmentes integráció bármilyen meglévő Prometheus telepítéssel. A második cél a könnyű üzemeltetés volt minimális belépési akadályokkal. Bármilyen függőséget könnyen ki kell tudni elégíteni, akár kis, akár nagy felhasználók számára, ami minimális alapköltséget is jelent.
A Thanos architektúrája
Miután az előző részben felsoroltuk a céljainkat, nézzük meg, hogyan oldja meg a Thanos ezeket a problémákat.
Globális nézet
Ahhoz, hogy global view-t kaphassunk a meglévő Prometheus példányok fölött, egy olyan belépési pontot kell létrehoznunk, amely összeköti az összes szervert. Ezt a Thanos komponens végzi. . Ez minden Prometheus szerver mellett települ, és mint proxy működik, szolgáltatva a helyi Prometheus adatokat a gRPC Store API interfészen keresztül, amely lehetővé teszi az időszámadatok lekérését címkék és időintervallum alapján.
A másik oldalon van egy horizontálisan skálázható, állapotmentes Querier komponens, amely kicsivel többet tesz, mint egyszerűen válaszolni a PromQL lekérdezésekre a standard Prometheus HTTP API-n keresztül. A Querier, Sidecar és más Thanos komponensek közötti kommunikáció a .
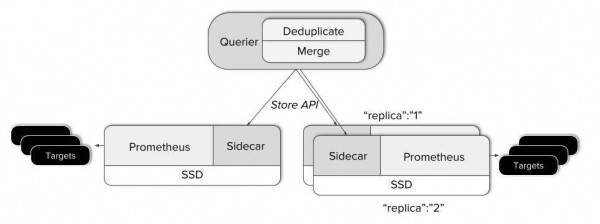
- A Querier, amikor lekérdezést kap, csatlakozik a megfelelő Store API szerverhez, azaz a Sidecar-okhoz, és lekéri az időszámadatokat a megfelelő Prometheus szerverekről.
- Ezután egyesíti a válaszokat, és végrehajtja a PromQL lekérdezést. A Querier képes egyesíteni a nem átfedő adatokat és az HA Prometheus szerverekről származó duplikált adatokat is.
Ez megoldja a rejtvényünk fő részét – az adatok egyesítése a szigetelt Prometheus szerverekről egy egységes nézetbe. Valójában a Thanos csak ezért a lehetőségért használható. Nincs szükség bármilyen módosításra a meglévő Prometheus szervereken!
Korlátlan tárolási idő!
De előbb-utóbb szeretnénk megőrizni azokat az adatokat, amelyek meghaladják a Prometheus szokásos tárolási idejét. A történeti adatok tárolására objektumtárolót választottunk. Ez széles körben elérhető bármely felhőben, valamint a helyi adatközpontokban, és nagyon költséghatékony. Továbbá, szinte bármely objektumtároló jól ismert S3 API-n keresztül érhető el.
A Prometheus körülbelül kétóránként írja az adatokat a memóriából lemezre. Az adatblokkok mindent tartalmaznak egy rögzített időintervallumra vonatkozóan, és megváltoztathatatlanok. Ez nagyon praktikus, mert a Thanos Sidecar egyszerűen meg tudja nézni a Prometheus adatainak könyvtárát, és ahogy új blokkok jelennek meg, azokat betölti az objektumtároló vödrökbe.
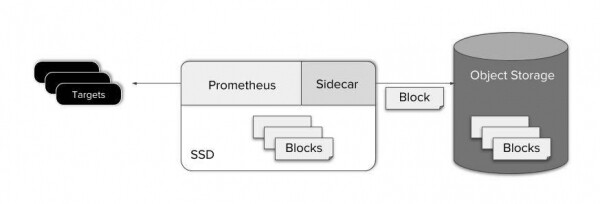
A lemezre írás utáni azonnali feltöltés az objektumtárolóba szintén lehetővé teszi a „scraper” (Prometheus és Thanos Sidecar) egyszerűsítését. Ez megkönnyíti a rendszer karbantartását, költségeit és tervezését.
Ahogy látható, az adatok biztonsági mentése rendkívül egyszerűen megvalósítható. De mi a helyzet az objektumtároló adataihoz való lekérdezéssel?
A Thanos Store komponensként működik, mint proxy az objektumtárolóból származó adatok megszerzéséhez. Hasonlóan a Thanos Sidecar-hoz, részt vesz a gossip klaszterben és megvalósítja a Store API-t. Így a meglévő Querier-ek számára Sidecarként működik, mint egy további forrás a time series adatok számára - semmilyen külön beállításra nincs szükség.
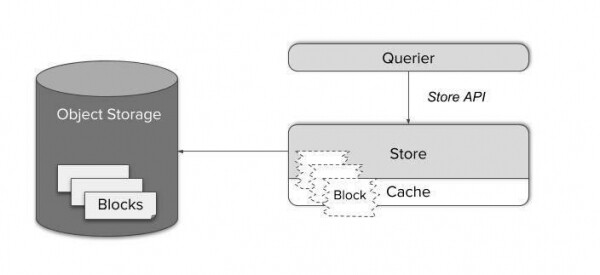
A time series adatok blokkjai több nagy fájlból állnak. Az igény szerinti betöltésük meglehetősen hatékonytalan lenne, míg a helyi cache-elés hatalmas memóriát és lemezterületet igényelne.
Ehelyett a Store Gateway tudja, hogyan kezelje a Prometheus tárolási formát. Az intelligens lekérdezéstervező és csak a szükséges index részek cache-elésével lehetővé vált a bonyolult lekérdezések minimalizálása a minimum HTTP-kérések számának csökkentésével az objektumtároló fájlokhoz. Ennek eredményeként a kérések száma négy-hat nagyságrenddel csökkenthető, és az úgynevezett válaszidő általában nehezen megkülönböztethető a helyi SSD adataihoz való kérések válaszidejétől.
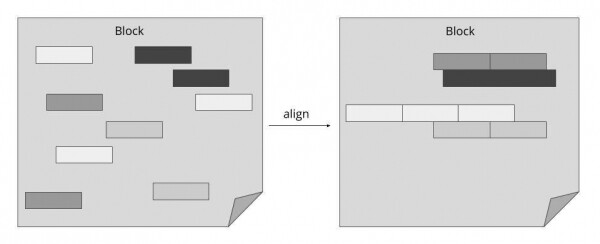
A fenti diagram szerint a Thanos Querier jelentősen csökkenti egy objektumtárolóba irányuló adatlekérdezés költségeit a Prometheus tárolási formátumának használatával és a kapcsolódó adatok közel elhelyezésével. E megközelítés alkalmazásával sok egyedi lekérdezés egy minimális mennyiségű bulk műveletbe egyesíthető.
Tömörítés és lecsökkentés
Miután egy új time series adatblokk sikeresen betöltődött az objektumtárolóba, történeti adatként tekintjük, amelyek azonnal elérhetők a Store Gateway-en keresztül.
Azonban egy idő után az egy forrásból (Prometheus, Sidecar) származó blokkok felhalmozódnak, és már nem használják ki teljes mértékben az indexelés potenciálját. Ennek a problémának a megoldására bevezettünk egy másik komponenst, amelyet Compactor-nak nevezünk. Ez egyszerűen alkalmazza a Prometheus helyi tömörítési mechanizmusát a történeti adatokra az objektumtárolóban, és egyszerű időszakos batch feladatként futtatható.
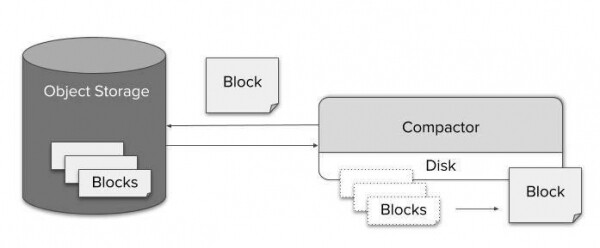
A hatékony tömörítésnek köszönhetően a tárolási lekérdezés hosszú időn keresztül nem jelent problémát az adatok mérete szempontjából. Azonban a milliárd érték kibővítésének és a lekérdezési feldolgozó átjárásának potenciális költsége elkerülhetetlenül a lekérdezés végrehajtási idejének drámai növekedéséhez vezet. Másrészt, mivel minden képpont esetében több száz adatpont van, lehetetlenné válik az adatok teljes felbontásban történő vizualizálása. Így a downsampling nemcsak lehetséges, hanem nem vezet észlelhető pontosságvesztéshez.
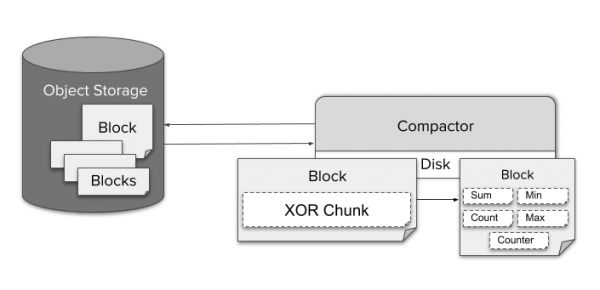
A Compactor folyamatosan aggregálja az adatokat öt perc és egy óra felbontásban a downsampling során. Minden egyes nyers fragmentumhoz, amelyet TSDB XOR tömörítéssel kódoltak, különböző típusú aggregált adatokat tárolnak, mint például min, max vagy sum egy blokkra. Ez lehetővé teszi a Querier számára, hogy automatikusan válassza ki a megfelelő aggregátumot az adott PromQL lekérdezéshez.
A csökkentett pontosságú adatok használatához a felhasználónak nincs szüksége külön konfigurációra. A Querier automatikusan vált a különböző felbontások és nyers adatok között, ahogy a felhasználó növeli vagy csökkenti a méretet. Opcióként a felhasználó közvetlenül is kezelheti ezt a ”step” paraméteren keresztül a lekérdezésben.
Mivel az egy GB tárolási költsége alacsony, a Thanos alapértelmezés szerint megőrzi az eredeti adatokat, az öt perces és egy órás felbontású adatokat. Nincs szükség az eredeti adatok törlésére.
Rögzítési szabályok
Még a Thanos esetében is a rögzítési szabályok jelentős részét képezik a monitoring stacknek. Csökkentik a lekérdezések bonyolultságát, késlekedését és költségét. Ezen kívül a felhasználók számára is kényelmesek, hogy aggregált adatokat kapjanak a metrikák alapján. A Thanos a vanília Prometheus példányok alapján működik, így teljesen elfogadható a rögzítési szabályok és figyelmeztetési szabályok tárolása a meglévő Prometheus szerveren. Azonban bizonyos esetekben ez nem elegendő:
- Globális figyelmeztetés és szabály (például értesítés, amikor a szolgáltatás nem működik több mint két a három klaszterből).
- Szabály az adatokra a helyi tárolón kívül.
- A cél, hogy minden szabályt és figyelmeztetést egy helyen tároljunk.
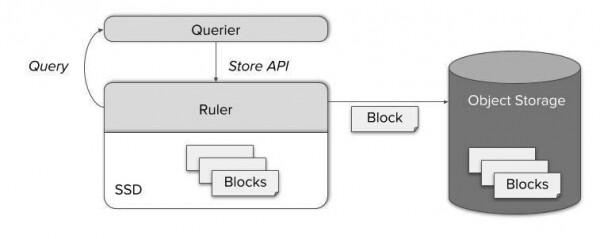
Mindezekre a Thanos tartalmaz egy külön komponenst, amelyet Ruler-nek hívnak, és amely a Thanos Queries segítségével számítja ki a szabályokat és riasztásokat. A jól ismert StoreAPI biztosításával a Query csomópont hozzáférhet a legfrissebb, kiszámított metrikákhoz. Később ezek az objektumtárolóban is elmentésre kerülnek, és a Store Gateway-en keresztül elérhetők lesznek.
A Thanos ereje
A Thanos eléggé rugalmas ahhoz, hogy az igényeidhez igazítsd. Ez különösen hasznos a sima Prometheus-ra való migrációkor. Nézzük gyorsan egy egyszerű példán keresztül, amit a Thanos komponensekről megtanultunk. Így lehet átkonvertálni a vanília Prometheust egy „korlátlan metrikák tárolásának” világába:
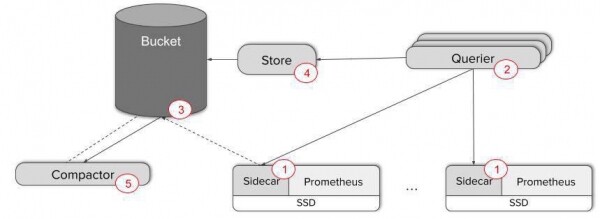
- Add hozzá a Thanos Sidecar-t a Prometheus szervereidhez – például közvetlenül a Kubernetes pod mellett.
- Telepíts több Thanos Querier replikát az adatok megtekintésének lehetőségéért. Ezen a ponton könnyen beállítható a gossip a Scraper és a Querier között. Az interakciók ellenőrzéséhez használd a ‘thanos_cluster_members’ metrikát.
E két lépés elegendő a globális nézet és a sima deduplikáció biztosításához a potenciális HA-replikákból származó Prometheus adatokra! Csak csatlakoztasd a dashboardjaidat a Querier HTTP végpontjához, vagy használd közvetlenül a Thanos UI-t.
Ha azonban metrikák biztonsági mentésére és hosszú távú tárolására van szükséged, akkor három további lépést is meg kell tenned:
- Hozz létre egy AWS S3 vagy GCS tárolót. Állítsd be a Sidecar-t, hogy másolja az adatokat ezeken a tárolókon. Most minimalizálhatod a helyi adatgyűjtést.
- Telepítsd a Store Gateway-t, és csatlakoztasd a meglévő gossip klaszterhez. Most már küldhetsz lekérdezéseket a biztonsági mentett adatokra!
- Telepítsd a Compactor-t, hogy javítsd a lekérdezések hatékonyságát hosszú időintervallumok esetén, a tömörítés és lefelé mintavételezés segítségével.
Ha többet szeretnél megtudni, ne habozz, nézd meg a és !
Öt lépés alatt megbízható megfigyelési rendszert alakítottunk ki Prometheusból globális nézettel, korlátlan tárolási idővel és potenciálisan magas rendelkezésre állású metrikákkal.
Pull request: szükségünk van rád!
a kezdetektől fogva nyílt forráskódú projekt volt. A Prometheus-szal való zökkenőmentes integráció és a Thanos csak egy részének használatának lehetősége nagyszerű választássá teszi a megfigyelő rendszer skálázását anélkül, hogy túl sok erőfeszítést igényelne.
Mindig örömmel fogadjuk a GitHub Pull Requesteket és a hibajelentéseket. Ugyanakkor ne habozzon kapcsolatba lépni velünk a GitHub Issues-on vagy a Slack-en keresztül., ha van kérdése vagy visszajelzése, vagy szeretné megosztani tapasztalatait! Ha tetszik, amit az Improbable-nél csinálunk, ne habozzon kapcsolatba lépni velünk — !
Forrás: habr.com
