

A elosztott rendszerek működtetése nehézkes lehet, mivel sok változó, dinamikus elem található bennük, és mindennek jól kell működnie a rendszer funkcionalitásának fenntartásához. Ha az egyik elem hibát jelez, a rendszernek automatikusan észlelnie, elkerülnie és javítania kell azt. Ebben a „Kubernetes Legjobb Gyakorlatok” sorozatban megtanuljuk, hogyan állíthatjuk be a Readiness és Liveness teszteket a Kubernetes klaszter életképességének ellenőrzésére.
Az Egészségügyi Ellenőrzés (Health Check) egy egyszerű módja annak, hogy a rendszer tudja, működik-e az ön alkalmazásának példánya. Ha az alkalmazás példánya nem működik, más szolgáltatásoknak nem szabad hozzáférniük, vagy kérdéseket küldeniük neki. Ehelyett a kérdést egy másik, már futó vagy később elinduló alkalmazás példányhoz kell irányítani. Emellett a rendszernek vissza kell adnia az alkalmazásának elveszett működőképességét.
Alapértelmezés szerint a Kubernetes akkor kezdi el forgalmat küldeni a podhoz, amikor az összes konténer elindult a podon belül, és újraindítja a konténereket, amikor azok hibásan leállnak. Kezdetben ez a rendszer alapértelmezett viselkedése megfelelő lehet, azonban a működésének megbízhatóságát növelheti az egyedi egészségügyi ellenőrzések alkalmazásával.
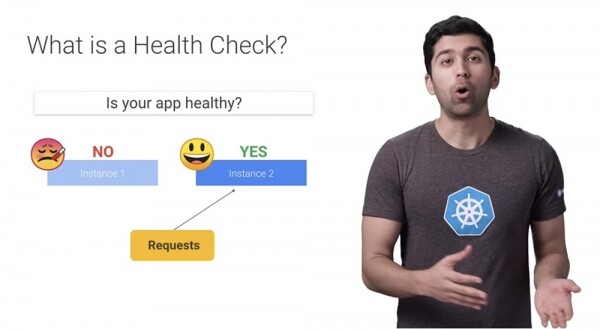
Szerencsére a Kubernetes ezt eléggé egyszerűvé teszi, így nincs mentség az ilyen ellenőrzések figyelmen kívül hagyására. A Kubernetes kétféle Egészségügyi Ellenőrzést biztosít, és fontos megérteni minden egyes típus alkalmazásának különbségeit.
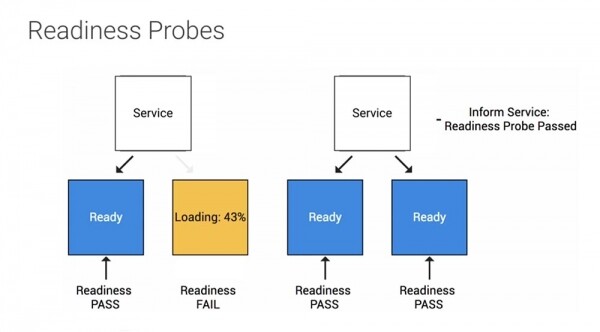
A Readiness teszt azzal a céllal készült, hogy tájékoztassa a Kubernetest az ön alkalmazásának forgalomszolgálatra való készségéről. Mielőtt a szolgáltatás engedélyezné a forgalom továbbítását a podba, a Kubernetesnek meg kell győződnie a Readiness teszt sikerességéről. Ha a Readiness teszt nem sikerül, a Kubernetes abbahagyja a forgalom küldését a podba, amíg a teszt sikeresen le nem zajlik.
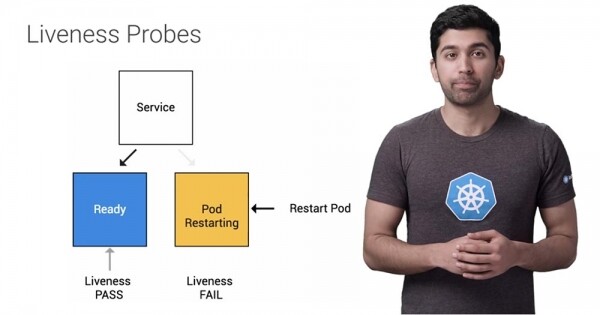
A Liveness teszt tájékoztatja a Kubernetest arról, hogy az ön alkalmazása él-e vagy sem. Az első esetben a Kubernetes békén hagyja, a másodikban eltávolítja a halott podot, és egy újra cseréli.
Képzeljünk el egy forgatókönyvet, ahol az alkalmazásának "felfűtése" és elindítása 1 percet vesz igénybe. A szolgáltatása nem fog működni, amíg az alkalmazás teljesen be nem töltődik és el nem indul, bár a munkafolyamat már elkezdődött. Ezenkívül problémákkal fog szembesülni, ha meg akarja növelni a telepítés méretét több példányra, mivel ezeknek a példányoknak nem szabad forgalmat kapniuk, amíg teljesen nem állnak készen. Alapértelmezés szerint azonban a Kubernetes azonnal elkezdi a forgalom irányítását, amint a folyamatok elindultak a konténerben.
A Readiness, azaz az alkalmazás készségének tesztjének használatakor a Kubernetes megvárja, amíg az alkalmazás teljesen elindul, és csak ezután engedi, hogy a szolgáltatás forgalmat küldjön az új példányra.
Képzeljünk el egy másik forgatókönyvet, ahol az alkalmazás hosszú ideig leáll és nem szolgálja ki a kéréseket. Mivel a folyamat továbbra is fut, alapértelmezés szerint a Kubernetes úgy fogja tekinteni, hogy minden rendben van, és továbbra is kéréseket küld a nem működő podra. Azonban a Liveness használatával a Kubernetes észlelné, hogy az alkalmazás többé nem szolgálja ki a kéréseket, és alapértelmezés szerint újraindítja a nem működő podot.
Nézzük meg, mivel teszteljük a készséget és a életképességet. Három módszer létezik a tesztelésre - HTTP, Command és TCP. Bármelyiket használhatja az ellenőrzéshez. A leggyakoribb felhasználói tesztmódszer a HTTP probe.
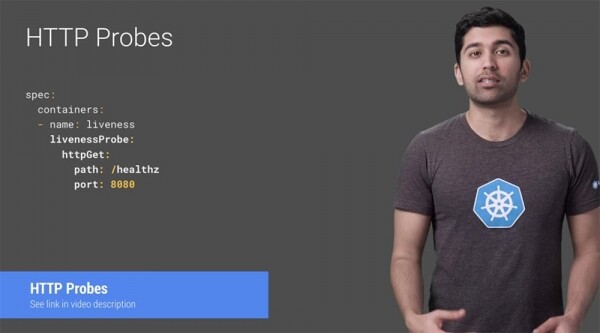
Még ha az alkalmazása nem is HTTP-szerver, akkor is létrehozhat egy könnyűsúlyú HTTP-szervert az alkalmazás belsejében, hogy interakcióba lépjen a Liveness teszttel. Ezt követően a Kubernetes elkezdi pingelni a podot, és ha a HTTP válasz 200 vagy 300 ms között van, az azt jelenti, hogy a pod "egészséges". Ellenkező esetben az egység "nem egészségesként" lesz megjelölve.
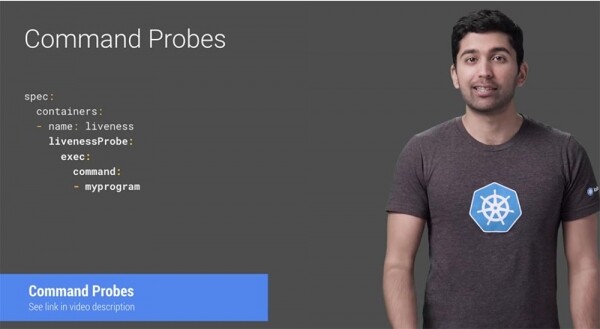
A Command segítségével végzett tesztek során a Kubernetes egy parancsot futtat a konténerén belül. Ha a parancs 0 exit kóddal tér vissza, a konténer "egészséges" lesz megjelölve, különben, ha a visszatérési állapot 1 és 255 között van, a konténer "betegként" lesz megjelölve. Ez a tesztelési módszer hasznos, ha nem tud vagy nem akar HTTP-szervet futtatni, de képes egy olyan parancsot futtatni, amely ellenőrzi az alkalmazása "egészségét".
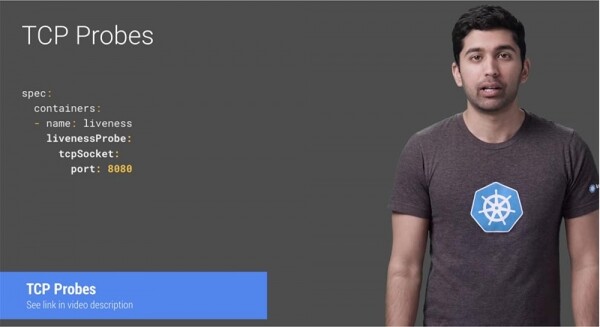
Az utolsó ellenőrzési mechanizmus a TCP-teszt. A Kubernetes megpróbál TCP-kapcsolatot létesíteni a megadott porton. Ha ez sikerül, a konténert egészségesnek, ha nem, életképtelennek tekintik. Ez a módszer hasznos lehet, ha olyan forgatókönyvet használ, ahol a HTTP-kérések tesztelése vagy parancsok végrehajtása nem működik jól. Például a TCP-alapú ellenőrzések fő szolgáltatásai a gRPC vagy az FTP lesznek.
A tesztek többféleképpen beállíthatók, különböző paraméterekkel. Megadhatja, hogy milyen gyakran kell őket végrehajtani, mik a siker- és hibaküszöbértékek, és mennyi ideig kell válaszokat várni. A tesztek Readiness és Liveness dokumentációjában részletesebb információ található. Azonban van egy nagyon fontos szempont a Liveness teszt beállításában - az initialDelaySeconds kezdeti késleltetés. Ahogy említettem, a teszt sikertelensége a modul újraindításához vezet. Ezért biztosítania kell, hogy a tesztelés ne kezdődjön el, amíg az alkalmazás nem áll készen a működésre, különben ciklikusan újraindulni kezd. Azt javaslom, hogy a P99 indítási időt vagy az alkalmazás bufferből mért átlagos indítási idejét használja. Ne felejtse el ezt az értéket módosítani, ahogy az alkalmazás indítási ideje egyre gyorsabbá vagy lassabbá válik.
A legtöbb szakember megerősíti, hogy a Health Check kötelező ellenőrzés bármely elosztott rendszer esetében, és a Kubernetes sem kivétel. A szolgáltatások «egészségének» ellenőrzése biztosítja a Kubernetes megbízható és hiba nélküli működését, és a felhasználók számára nem jelent semmiféle terhet.
A folytatás hamarosan érkezik...
Egy kis reklám 🙂
Köszönjük, hogy velünk maradtál. Tetszenek a cikkeink? Szeretnél több érdekes anyagot látni? Támogass minket, és rendelés leadásával vagy ismerősöknek ajánlással segíts nekünk. , Egyedülálló alternatívája az entry-level szervereknek, amelyet Önnek találtunk ki: (elérhetők RAID1 és RAID10 opciók, akár 24 magig és 40GB DDR4-ig).
Dell R730xd kétszer olcsóbban a Tier IV Equinix adatközpontban Amszterdamban? Csak nálunk Hollandiában! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — 99 dollártól! Olvasd el ezt
Forrás: habr.com
