

Helló, nemrég egy érdekes feladatot kaptam, hogy beállítsak egy tárolót nagy mennyiségű blokkos eszközök mentésére.
Minden héten elvégezzük az összes virtuális gép biztonsági mentését a felhőnkben, így képesnek kell lennünk ezer biztonsági másolat kezelésére, és ezt a lehető leggyorsabban és a leghatékonyabban kell megtennünk.
Sajnos a szabványos konfigurációk RAID5, RAID6 ebben az esetben nem alkalmasak, mert a helyreállítási folyamat olyan nagy lemezek esetén, mint a mieink, kínosan hosszú lesz, és valószínűleg sosem ér véget.
Nézzük meg, milyen alternatívák vannak:
— A RAID5, RAID6 analógja, de testreszabható paritásszinttel. Ezenkívül a mentés nem blokk alapú, hanem minden egyes objektumra vonatkozik. A legegyszerűbb módja az erasure coding kipróbálásának az, hogy telepítjük a .
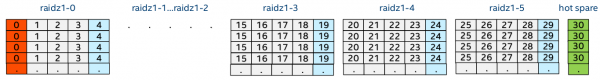
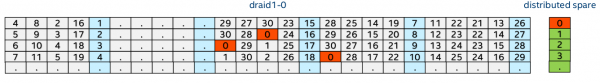
— ez jelenleg még nem megvalósított ZFS-funkció. A RAIDZ-hez képest a DRAID elosztott paritásblokkot használ, és a helyreállítás során az összes lemezt aktiválja a tömbből, így jobban ellenáll a lemezhibáknak, és gyorsabban helyreáll a hiba után.
Tisztában vagyok egy szerverrel Fujitsu Primergy RX300 S7 Intel Xeon CPU E5-2650L 0 @ 1.80GHz processzorral , kilenc DDR3 RAM-modullalSamsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9) , egy lemezkiosztóvalSupermicro SuperChassis 847E26-RJBOD1 , csatlakoztatvaDual LSI SAS2X36 Expander és 45 lemezzel Seagage ST6000NM0115-1YZ110 6TB hogy mindegyik. Mielőtt bármit eldöntenék, először alaposan tesztelni kell mindent.
Ehhez felkészültem és különféle konfigurációk tesztelését végeztem. Ehhez a minio-t használtam, amely S3 háttérként működött, és különböző módokban futtattam különböző számú célállomással.
Főként a minio erasure coding esete, a szoftveres RAID-hez hasonlítva, ugyanazzal a lemezkészlettel és paritásos lemezekkel volt tesztelve, ezek: RAID6, RAIDZ2 és DRAID2.
A tájékoztatás kedvéért: amikor a minio-t egyetlen céllal indítja el, akkor a minio S3 átjáró módban működik, lehetővé téve a helyi fájlrendszer S3 tárolásként történő megjelenítését. Ha azonban a minio-t több cél meghatározásával indítja, automatikusan aktiválódik az Erasure Coding mód, amely a cél állomások között elosztja az adatokat, biztosítva a hibátlanságot.
Információként: amikor a minio-t csak egy céllal indítja el, akkor a minio S3-híd üzemmódba lép, és a helyi fájlrendszerét S3-tárhelyként szolgáltatja. Ha azonban a minio-t több céllal indítja el, akkor automatikusan bekapcsol a Erasure Coding mód, amely elosztja az adatokat a célszerverek között az adott redundancia biztosítása érdekében.
Alapértelmezetten a Minio 16 lemezes csoportokra osztja a célokat, ahol minden csoporthoz 2 paritás tartozik. Ezért egyszerre két lemez is meghibásodhat adatvesztés nélkül.
A teljesítmény teszteléséhez 16 darab 6 TB-os lemezt használtam, és kis 1 MB-os objektumokat írtam rájuk, ami maximálisan pontosan tükrözte a jövőbeli terhelésünket, mivel minden modern biztonsági mentési eszköz blokkra osztja az adatokat több megabájt méretben, és így írja őket.
A benchmark elvégzéséhez az s3bench segédprogramot használtuk, amelyet egy távoli szerveren futtattunk, és tízezernyi ilyen objektumot küldött a Miniohoz száz szálban. Ezután ugyanilyen módon próbáltuk visszahívni őket.
A benchmark eredményeit az alábbi táblázat tartalmazza:
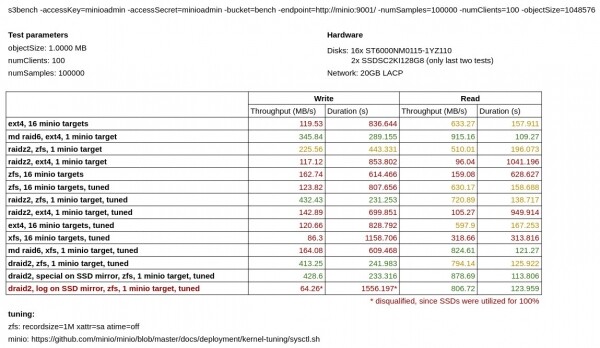
Ahogy látjuk, a Minio saját erasure coding üzemmódban jelentősen rosszabb írási teljesítményt nyújt, mint a Minio, amelyet szoftveres RAID6, RAIDZ2 és DRAID2 felett futtatnak ugyanabban a konfigurációban.
Külön megkértek Az első tesztek során az Mdadm fölényben volt a ZFS-sel szemben, de később
gmelikov xattr=sa atime=off recordsize=1M
és ezután a ZFS-tesztjeim lényegesen jobbak lettek.Azt is észrevehetjük, hogy a DRAID nem ad különösebb előnyt a RAIDZ-hez képest, de elméletileg sokkal biztonságosabb kellene legyen.
Az utolsó két tesztem során megpróbáltam a metaadatokat (special) és a ZIL-t (log) SSD tükörbe helyezni. De a metaadatok kihelyezése nem hozott különösebb sebességelőnyt, míg a ZIL kihelyezésénél a
SSDSC2KI128G8 Végül úgy döntöttem, hogy a DRAID használatánál maradok, és a bétastátusza ellenére ez a leggyorsabb és leghatékonyabb megoldás a tárolásra az esetünkhöz.
Egyszerű DRAID2-t hoztam létre három csoporttal és két elosztott tartalékkal:
Jól van, a tárolással mindent tisztáztunk, most nézzük, hogy mivel fogunk biztonsági menteni. Itt három megoldásról szeretnék beszélni, amelyeket sikerült kipróbálnom:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Benji Backup
a Backy2-nek. , a blokkszintű eszközök biztonsági mentésére spezializált megoldás, szoros integrációban van a Ceph-el. Képes a snapshotok közötti diff-eket lekérni és azokból inkrementális biztonsági mentést létrehozni. Támogatja a tárolás számos backend-jét, beleértve a helyi és az S3 rendszereket is. Külön adatbázist igényel a deduplikációs hash-tábla tárolásához. Hátránya: Python nyelven íródott, a CLI kicsit nem mindig reagál gyorsan.
a Backy2-nek. , régóta ismert és bevált eszköz az adatok biztonsági mentésére, amely képes az adatok biztonsági mentésére és jól deduplikálja azokat. Képes a biztonsági másolatokat helyben vagy távoli szerverre másolni SCP-n keresztül. Blokkszintű eszközöket is képes biztonsági másolatba venni, ha az alábbi flag-gel indítják: --special, hátránya: a biztonsági másolat létrehozásakor a repository teljesen le van zárva, ezért minden virtuális géphez ajánlott külön repository-t létrehozni, ami nem jelent problémát, mivel nagyon könnyen létrehozható.
— aktívan fejlődő projekt, Go nyelven íródott, eléggé gyors és támogatja a tárolás számos backend-jét, beleértve a helyi tárolást, SCP-t, S3-at és sok egyebet. Külön megemlíteném, hogy van egy speciálisan létrehozott a restic számára, amely lehetővé teszi a tárolás leggyorsabb exportálását távoli használatra. Az összes fent említett közül nekem ez tetszett a legjobban. Képes stdin-ből biztonsági másolatot készíteni. Szembetűnő hátrányai szinte nincsenek, de van néhány sajátossága:
Először is, megpróbáltam használni közös repository-módban minden virtuális géphez (mint a Benji), és ez egész jól működött, de a helyreállítási műveletek meglehetősen hosszú időt vettek igénybe, mivel minden helyreállítás előtt a restic megpróbálja elolvasni az összes biztonsági másolat metadataját. Ezt a problémát könnyedén megoldottuk, mint a borg esetében, azzal, hogy minden virtuális géphez külön repository-t hozzunk létre. Ez a megközelítés szintén nagyon hatékony volt a biztonsági másolatok kezelésére. A különálló repository-knak lehet külön jelszava az adatokhoz való hozzáféréshez, és bátran elkerülhetjük, hogy a globális repo valahogy tönkremenjen. Új repository-kat szintén olyan egyszerűen lehet létrehozni, mint a Borg Backup esetében.
Minden esetben a deduplikáció csak a backup korábbi verziójára vonatkozik, a korábbi backup az adott backup elérési útja alapján határozható meg, ezért ha különböző objektumokat ment a stdin-ből egy közös tárolóba, ne felejtse el megadni az opciót.
--stdin-filename, vagy minden alkalommal kifejezetten megadni az opciót.--parent.
Másodszor, az stdout-ra való visszaállítás jelentősen több időt vesz igénybe, mint a fájlrendszerre való visszaállítás a párhuzamossága miatt. A jövőben tervezik a backupok szorosabb támogatását blokk alapú eszközök számára.
Harmadszor, jelenleg javasolt használni a , mivel a 0.9.6 verzió bugja miatt hosszú ideig tart a nagy fájlok visszaállítása.
A backup hatékonyságának és a másolás/visszaállítás sebességének tesztelésére létrehoztam egy külön tárolót, és próbáltam menteni egy kis virtuális gép (21 GB) képet. Két backupot végeztem a változatlan eredeti felhasználásával, az említett megoldások mindegyikével, hogy ellenőrizzem, mennyivel gyorsabban/lassabban másolják a deduplikált adatokat.
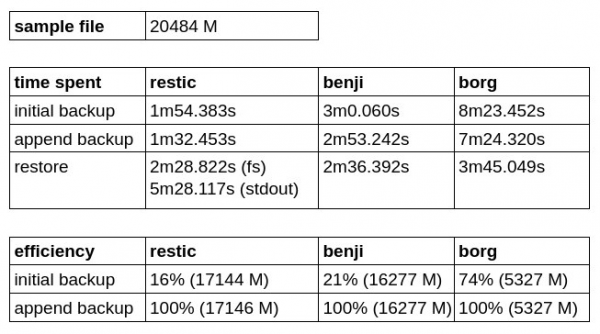
Ahogy észlelhetjük, a Borg Backup a legjobb kezdő backup hatékonysággal rendelkezik, de lemarad a másolás és a visszaállítás sebességében.
A Restic gyorsabbnak bizonyult, mint a Benji Backup, de hosszabb ideig tart a stdout-ra való visszaállítás, és sajnos még nem tud közvetlenül blokk alapú eszközre írni.
Mindent mérlegelve úgy döntöttem, hogy megállok a restic a rest-server megoldásnál, mint a legkényelmesebb és legígéretesebb backup megoldás.
Ebben a screencastban láthatja, hogy a 10 gigabites csatorna teljesen ki van használva, miközben több párhuzamosan futó backup művelet zajlik. Érdemes megjegyezni, hogy a lemezek kihasználtsága nem emelkedik 30% fölé.
A kapott megoldással több mint elégedett vagyok!
Forrás: habr.com
