

Helló mindenkinek! Nagyszerű híreink vannak, júniusban az OTUS újra elindítja a kurzust , ezért hagyományosan megosztjuk veletek az hasznos anyagokat.
Ha még soha nem találkoztál ezzel a mikroszolgáltatásos koncepcióval kontextus nélkül, akkor jogosan érezheted, hogy kissé furcsa. Az alkalmazás darabokra bontása, amelyeket hálózat köt össze, feltétlenül a megbízhatósági megoldások bonyolultságát jelenti egy elosztott rendszerben.
Bár ez a megközelítés sok független szolgáltatásra bontható, a végső cél messze túlmutat azon, hogy ezek a szolgáltatások különböző gépeken működjenek. Itt a világ környezetével való kölcsönhatásról van szó, ami szintén elosztott természetű. Nem technikai értelemben, hanem inkább olyan ökoszisztémaként, amely sok emberből, csapatból, programból áll, s mindegyik résznek valamilyen módon el kell végeznie a feladatát.
A vállalatok például elosztott rendszerek sorozataként működnek, amelyek együttesen hozzájárulnak valamilyen cél eléréséhez. Évtizedeken át figyelmen kívül hagytuk ezt a tényt, miközben a fájlokat FTP-n keresztül továbbítottuk vagy céges integrációs eszközöket használtunk, miközben a saját elkülönült céljainkra összpontosítottunk. De a szolgáltatások megjelenésével minden megváltozott. A szolgáltatások segítettek rálátni a kölcsönösen függő programok világára, amelyek együtt dolgoznak. Ahhoz azonban, hogy sikeresen működjünk, fel kell ismernünk és meg kell tervezzük két lényegesen különböző világot: a külső világot, ahol több más szolgáltatás ökoszisztémájában élünk, és a saját belső világunkat, ahol egymagunk uralkodunk.
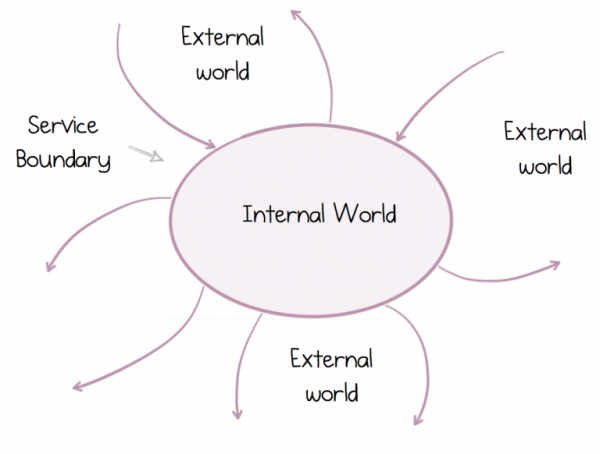
Ez az elosztott világ eltér attól, amelyben felnőttünk és amelyhez hozzászoktunk. A hagyományos monolitikus architektúra építési elvei nem állják meg a helyüket. Ezért a megfelelő megértés, hogy az ilyen rendszerek nem csak egy szép vázlat elkészítése a fehér táblán vagy egy ígéretes koncepció bizonyítása. Arról van szó, hogy egy ilyen rendszer sikeresen működjön hosszú távon. Szerencsére a szolgáltatások már régóta léteznek, bár különböző formákban. még mindig relevánsak, még Docker, Kubernetes fűszerezéssel és egy kicsit hipster szakállal megbolondítva is.
Ma tehát megnézzük, hogyan változtak a szabályok, miért kell újragondolnunk a szolgáltatásaink és az általuk egymásnak továbbított adatok megközelítését, és miért van szükségünk egy teljesen új eszközkészletre ehhez.
Az enkapszuláció nem mindig barátod.
A mikroszolgáltatások függetlenül működhetnek egymástól. Ez a tulajdonság adja nekik a legnagyobb értéket. Ez a tulajdonság teszi lehetővé, hogy a szolgáltatások skálázhatóak és növekedők legyenek. Nemcsak abban az értelemben, hogy kvadrillió felhasználóra vagy petabájt adatra nagymértékben skálázhatóak (bár ebben is segíthetnek), hanem abban az értelemben is, hogy az emberek tekintetében skálázhatóak, mivel a csapatok és szervezetek folyamatosan növekednek.
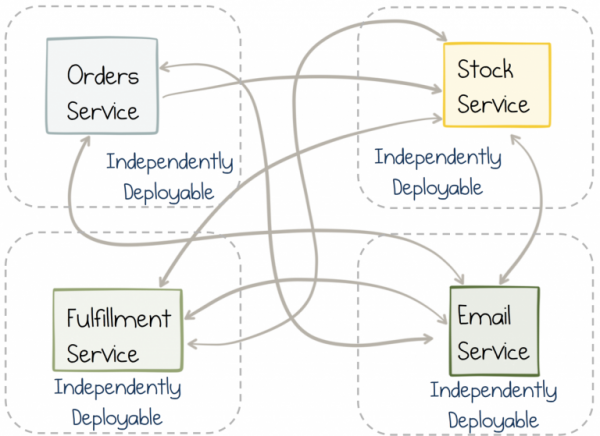
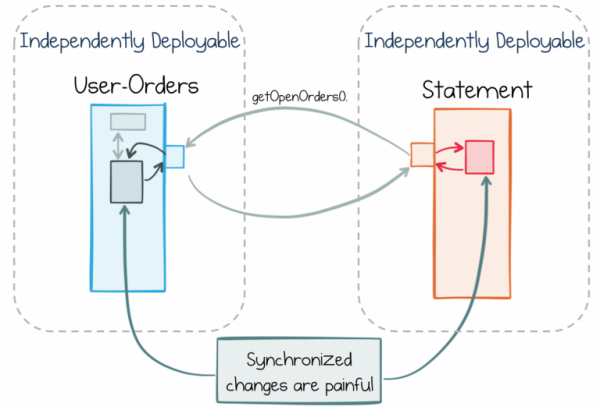
Azonban a függetlenség egy kettős élű kard. A szolgáltatás önmagában könnyedén és zavartalanul működhet. De ha a szolgáltatáson belül van egy funkció, amely megköveteli egy másik szolgáltatás igénybevételét, végül mindkét szolgáltatásban szinte egyszerre kell változtatásokat végrehajtanunk. Egy monolitban ezt könnyen megteheted: egyszerűen végrehajtasz egy módosítást és publikálod, azonban független szolgáltatások szinkronizálásakor sokkal több probléma merül fel. A csapatok közötti koordináció és a kiadási ciklusok rontják a rugalmasságot.
A standard megközelítés keretein belül a bosszantó átfedő változásokat próbálják elkerülni azáltal, hogy világosan elválasztják a funkciót a szolgáltatások között. Egy egységes belépési szolgáltatás itt jó példa lehet. Egy jól meghatározott szerepe van, amely megkülönbözteti más szolgáltatásoktól. Ez a világos megkülönböztetés azt jelenti, hogy a gyorsan változó követelmények világában a körülötte lévő szolgáltatásokhoz képest az egységes belépési szolgáltatás valószínűleg nem fog változni. Harmonikus, szigorúan korlátozott kontextusban létezik.
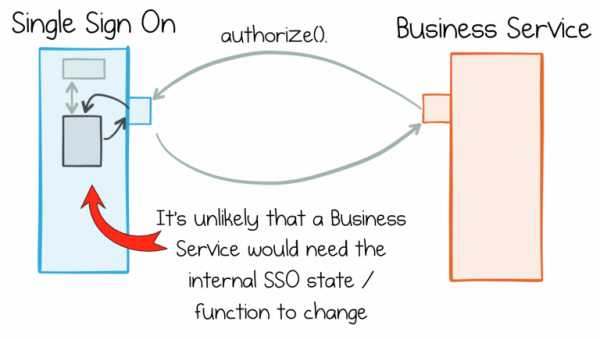
A probléma abban rejlik, hogy a valóságban az üzleti szolgáltatások nem tudják folyamatosan fenntartani a világos szereposztást. Például az üzleti szolgáltatások nagyobb mértékben dolgoznak azokkal az adatokkal, amelyek más, hasonló szolgáltatásoktól származnak. Ha online kiskereskedelemmel foglalkozik, akkor a rendelési folyam, a termékkatalógus vagy a felhasználói információk feldolgozása számos szolgáltatásának követelménye lesz. Minden egyes szolgáltatásnak szüksége lesz hozzáférésre ezekhez az adatokhoz.
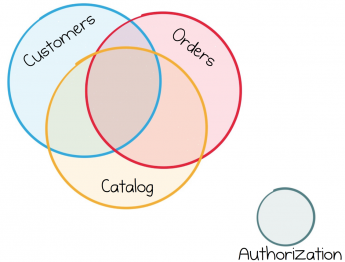
A legtöbb üzleti szolgáltatás ugyanazt az adatfolyamot használja, ezért a működésük elkerülhetetlenül összefonódik.
Így eljutottunk egy fontos ponthoz, amiről érdemes beszélni. Míg a szolgáltatások jól működnek az elkülönített infrastruktúra komponensei számára, a legtöbb üzleti szolgáltatás szorosabban összefonódik.
Az adatok dichotómiája
A szolgáltatásközpontú megközelítések talán már léteznek, azonban még mindig kevés információ áll rendelkezésre arról, hogyan lehet nagyméretű adatokat megosztani a szolgáltatások között.
A fő probléma az, hogy az adatok és a szolgáltatások elválaszthatatlanok. Egyrészt az elkapszulázás arra ösztönöz minket, hogy elrejtsük az adatokat, lehetővé téve ezzel, hogy a szolgáltatások elkülönülhessenek egymástól, és így elősegíthessék a növekedésüket és további módosításaikat. Másrészt szabadon meg kell osztanunk és rendelkezésünkre kell álljon a közös adatok felett, mint bármilyen más adathalmazon. Arról van szó, hogy azonnal elkezdhessük a munkát, olyan szabadsággal, mint bármely más információs rendszerben.
Az információs rendszerek azonban alig kapcsolódnak az elkapszulázáshoz. Valójában éppen ellenkezőleg. Az adatbázisok mindent megtesznek, hogy hozzáférést biztosítsanak a tárolt adatokhoz. Erőteljes deklaratív interfésszel rendelkeznek, amely lehetővé teszi az adatok átalakítását a szükséges módon. Ez a funkció fontos a előzetes kutatás során, de nem a folyamatosan növekvő szolgáltatás összetettségének kezelésére.
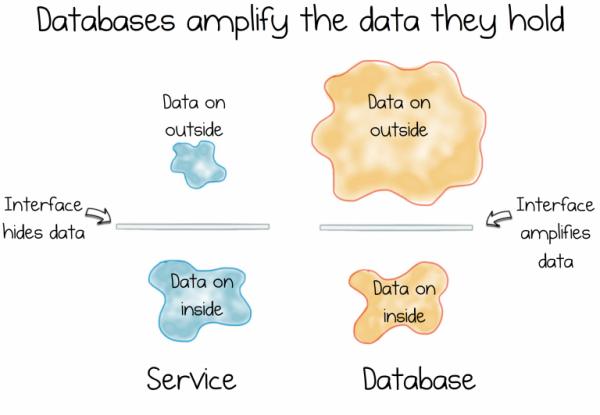
És itt felmerül a dilemma. Az ellentmondás. A dichotómia. Hiszen az információs rendszerek az adatok szolgáltatásáról szólnak, míg a szolgáltatások a rejtésről.
E két erő alapvető. Ezek képezik a munkánk nagy részének alapját, folyamatosan küzdve a fejlődésért a rendszerünkben.
Ahogy a szolgáltatási rendszerek fejlődnek és változnak, különböző megnyilvánulásait látjuk az adathasznot díkharter szerinti következményeinek. Vagy a szolgáltatás interfésze nőni fog, szélesebb funkcionalitást kínálva, és egyre inkább olyan lesz, mint egy csodás, házi készítésű adatbázis, vagy csalódás ér bennünket, és valamilyen módot valósítunk meg, hogy tömegesen adatcsoportokat vonjunk le vagy mozgassunk szolgáltatásról szolgáltatásra.
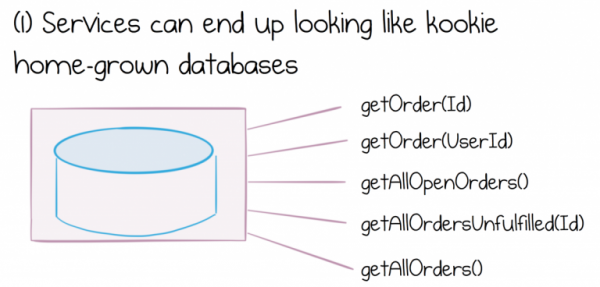
Amit pedig az a dolog létrehozása jelent, ami úgy néz ki, mint egy csodás, házi készítésű adatbázis, az egy sor problémához vezet. Nem fogunk belemenni abba, hogy miért veszélyes a shared database, csak annyit mondunk, hogy jelentős költséges mérnöki és üzemeltetési okoz egy olyan cég számára, amely megpróbálja azt használni.
Ráadásul az adatmennyiségek fokozzák a szolgáltatási határok problémáit. Minél több közös adat található a szolgáltatásban, annál bonyolultabbá válik a felhasználói felület, és annál nehezebb lesz az adatcsoportok összekapcsolása különböző szolgáltatásokból.
Az alternatív megközelítések az adatcsoportok kinyerésére és mozgatására szintén magukban hordozzák a problémáikat. Az e problémához szokásos megközelítés a teljes adatcsoport kinyerését és tárolását jelenti, majd annak lokális tárolását minden felhasználó szolgáltatásban.
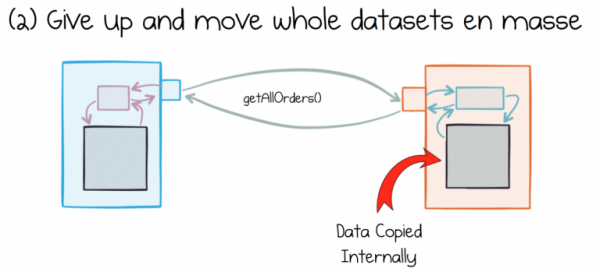
A probléma az, hogy a különböző szolgáltatások eltérően értelmezik azokat az adatokat, amelyeket felhasználnak. Ezek az adatok mindig a közelben vannak. Megváltoznak és lokálisan dolgozzák fel őket. Elég gyorsan már semmilyen közük sincs a forráshoz.
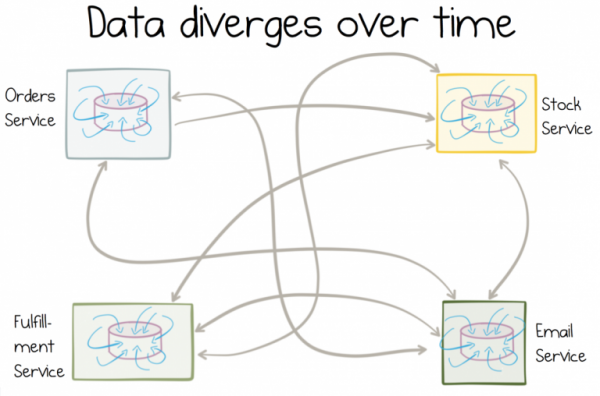
Minél inkább változékonyak a másolatok, annál inkább eltérnek az adatok az idő múlásával.
A legrosszabb az, hogy ezeket az adatokat visszamenőlegesen nehéz javítani ( itt valóban segítségünkre lehet). Valójában néhány nehezen megoldható technológiai probléma, amellyel a vállalkozások szembesülnek, az eltérő adatokból ered, amelyek alkalmazásról alkalmazásra szaporodnak.
Ahhoz, hogy megoldást találjunk erre a közös adatok problémájára, másképp kell gondolkodnunk. Ezeknek első osztályú objektumokká kell válniuk az általunk épített architektúrákban. Ezeket az adatokat „külsőnek” nevezik, és ez nagyon fontos jellemző. Szükségünk van kapszulázásra, hogy ne tárjuk fel a szolgáltatás belső felépítését, de meg kell könnyítenünk a szolgáltatások számára a megosztott adatokhoz való hozzáférést, hogy megfelelően elláthassák feladataikat.
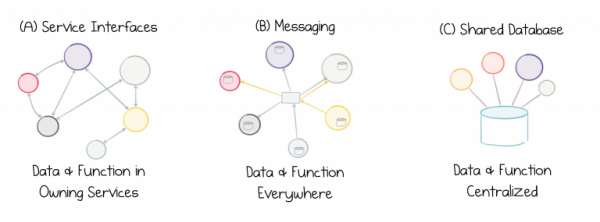
A probléma az, hogy ma már egyik megközelítés sem aktuális, mivel sem a szolgáltatások interfészei, sem az üzenetváltás, sem a Shared Database nem kínál jó megoldást a külső adatok kezelésére. A szolgáltatások interfészei nem alkalmasak adatok cseréjére bármilyen mértékben. Az üzenetváltás adatokat mozgat, de nem tárolja történetüket, így idővel az adatok károsodnak. A Shared Databases túlzottan egyetlen pontra összpontosítanak, ami hátráltatja a fejlődést. Így elkerülhetetlenül egy adataink érvénytelenségi ciklusába ragadunk.
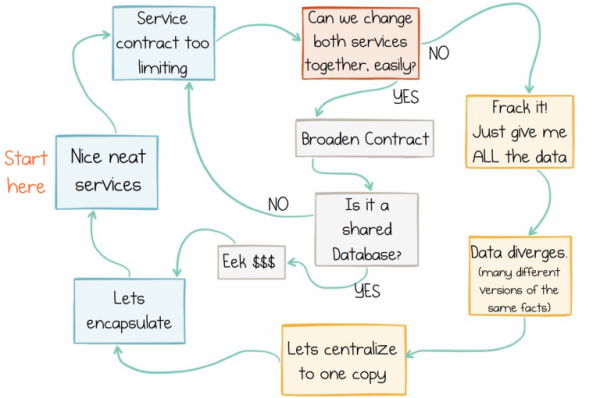
Adataink érvénytelenségi ciklus
Áramlások: decentralizált megközelítés az adatok és szolgáltatások számára
Ideálisan meg kell változtatnunk a megközelítést arra, hogyan működnek a szolgáltatások a közös adatokkal. Jelenleg bármely megközelítés szembesül a fent említett dikotómiával, mivel nincs varázsipar, amellyel gazdagon meghintázhatnánk, és eltüntethetnénk ezt a problémát. Azonban újra tudjuk gondolni a problémát, és kompromisszumra juthatunk.
Ez a kompromisszum bizonyos fokú központosítást feltételez. Kihasználhatjuk a decentralizált naplómechanizmust, mivel ez megbízható, skálázható áramlásokat biztosít. Most arra van szükség, hogy a szolgáltatások csatlakozhassanak és e közös áramlásokkal dolgozhassanak, azonban el akarjuk kerülni a bonyolult központosított God Service-eket, amelyek ilyen feldolgozást valósítanak meg. Ezért a legjobb megoldás, ha a folyamatos feldolgozást minden szolgáltatás-fogyasztóba beépítjük. Így a szolgáltatások képesek lesznek összekapcsolni az adatcsoportokat különböző forrásokból, és azokat úgy használni, ahogyan szükségük van rá.
Az egyik módja ennek a megközelítésnek a megvalósítására egy streamelési platform használata. Számos lehetőség létezik, de ma kifejezetten a Kafka-ról fogunk beszélni, mivel a Stateful Stream Processing használata hatékony megoldást kínál a felvetett problémára.
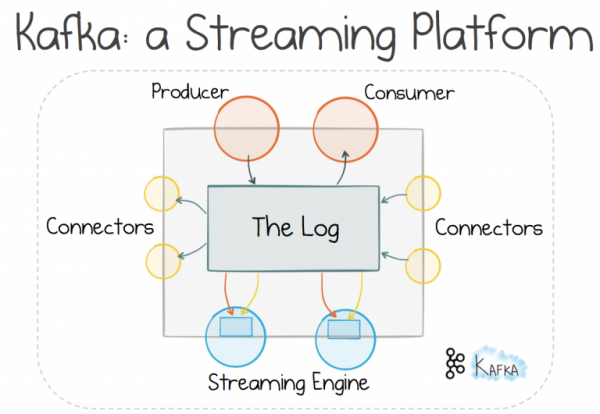
A decentralizált naplózás mechanizmusának használata lehetővé teszi számunkra, hogy a kitaposott ösvényen haladjunk, és üzenetváltást alkalmazzunk a munkavégzéshez. . Úgy tartják, hogy ez a megközelítés jobb skálázást és elválasztást biztosít, mint a „kérés-válasz” mechanizmus, mivel a folyamat irányítását a fogadó, nem pedig a küldő kapja. Azonban mindent meg kell fizetni ebben az életben, és ehhez szüksége lesz egy brókerre. De a nagy rendszerek esetében ez a kompromisszum megéri (amire a tipikus webalkalmazásai nem mondhatják el).
Ha a elosztott naplózásért a bróker felel, nem pedig a hagyományos üzenetküldő rendszer, akkor kihasználhatjuk a további funkciókat. A szállítást szinte ugyanúgy lineárisan lehet skálázni, mint az elosztott fájlrendszert. Az adatok elég hosszú ideig tárolhatók a naplókban, így nemcsak üzenetváltás, hanem információtárolás is rendelkezésre áll. Skálázható tároló anélkül, hogy félni kellene a változtatható közös állapottól.
Ezután használhatjuk az állapotmegőrző stream feldolgozás mechanizmusát az adatbázis deklaratív eszközeinek hozzáadására a fogyasztó szolgáltatásokhoz. Ez egy nagyon fontos gondolat. Amíg az adatok a közös áramlatokban maradnak, amelyekhez minden szolgáltatás hozzáférhet, a szolgáltatás által végzett egyesítés és feldolgozás privát. Ezek egy szigorúan korlátozott kontextuson belül izoláltak.
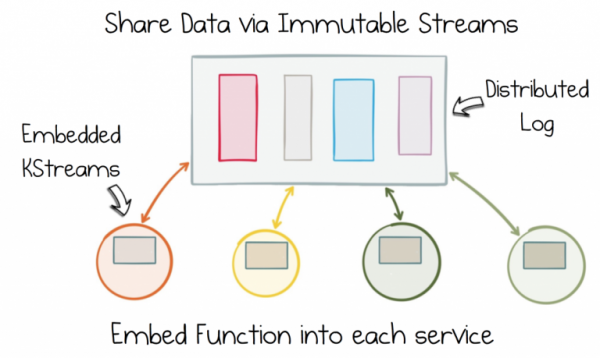
Szabaduljon meg az adatt dichotómiájától az immutábilis állapotfolyamok elválasztásával. Ezután adja hozzá ezt a funkciót minden szolgáltatáshoz az állapotmegőrző Stream Feldolgozás segítségével.
Így ha a szolgáltatásának rendelésekkel, termékkatalógussal, raktárral kell foglalkoznia, teljes hozzáférése lesz: csak ön döntheti el, hogy mely adatokat vonja össze, hol dolgozza fel őket, és hogyan kell változniuk az idő múlásával. Bár az adatok közösek, a velük való munka teljesen decentralizált. Minden szolgáltatáson belül zajlik, egy olyan világban, ahol minden az ön szabályai szerint történik.
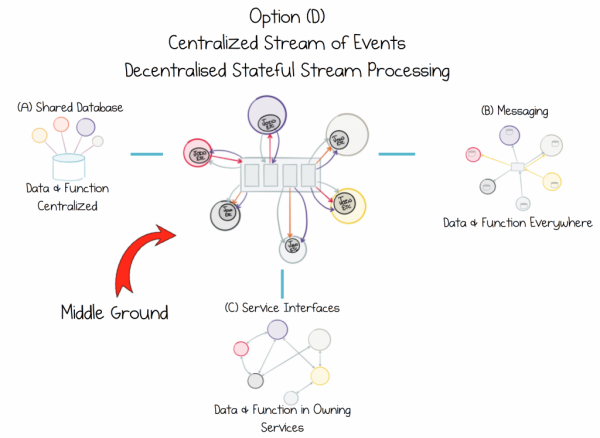
Ossza meg az adatokat úgy, hogy azok integritása ne sérüljön. Inkapszulálja a funkciót, ne pedig az forrást, minden szükséges szolgáltatásban.
Előfordul, hogy az adatokat tömegesen kell áthelyezni. Néha a szolgáltatásnak szüksége van egy helyi történeti adathalmazra a választott adatbázis-motorban. A lényeg az, hogy garantálható, hogy szükség esetén a másolat visszaállítható a forrásból a megosztott naplózási mechanizmus segítségével. A Kafka csatlakozói remekül teljesítik ezt a feladatot.
Tehát a ma tárgyalt megközelítésnek több előnye is van:
- Az adatok közös folyamatok formájában kerülnek felhasználásra, amelyek hosszú ideig tárolhatók a naplókban, és a közös adatokkal való munka mechanizmusa minden egyes kontextusba be van építve, lehetővé téve a szolgáltatások gyors és egyszerű működését. Ilyen módon kiegyensúlyozható az adatok dichotómiája.
- A különböző szolgáltatásokból érkező adatok könnyen egyesíthetők halmazokká. Ezáltal egyszerűsödik a közös adatokkal való interakció, és megszűnik a szükségesség a helyi adathalmazok támogatására az adatbázisban.
- A Stateful Stream Processing csupán az adatokat tárolja, míg az igazság forrása a közös naplók maradnak, így az adatok időbeli sérülésének problémája nem áll annyira élesen.
- A szolgáltatások alapvetően az adatok által vezéreltek, tehát a folyamatosan növekvő adatmennyiségek ellenére a szolgáltatások még mindig gyorsan reagálhatnak az üzleti eseményekre.
- A skálázhatósági problémák a brókerre hárulnak, nem a szolgáltatásokra. Így jelentősen csökken a szolgáltatások írásának bonyolultsága, mivel nem szükséges a skálázhatósággal foglalkozni.
- Új szolgáltatások hozzáadása nem igényli a régi szolgáltatások megváltoztatását, így az új szolgáltatások csatlakoztatása könnyebbé válik.
Ahogy látja, ez több mint egyszerű REST. Olyan eszközkészletet kaptunk, amely lehetővé teszi a közös adatok decentralizált kezelését.
A mai cikkben messze nem minden szempont került bemutatásra. Még mindig meg kell határoznunk, hogyan egyensúlyozhatunk a "kérés-válasz" paradigma és az eseményalapú paradigma között. De ezzel legközelebb foglalkozunk. Vannak témák, amelyeket jobban meg kell ismerni, például hogy miért olyan jó a Stateful Stream Processing. Erről fogunk beszélni a harmadik cikkben. Ezen kívül léteznek más erőteljes konstrukciók is, amelyeket igénybe vehetünk, ha élünk velük, például, . Ezzel megváltozik a játékszabály a disztribúciós üzleti rendszerek számára, mivel ez a konstrukció tranzakciós garanciákat biztosít a skálázható formában. Erről fog szólni a negyedik cikk. Végül pedig gyorsan át kell néznünk a megvalósítás részleteit.
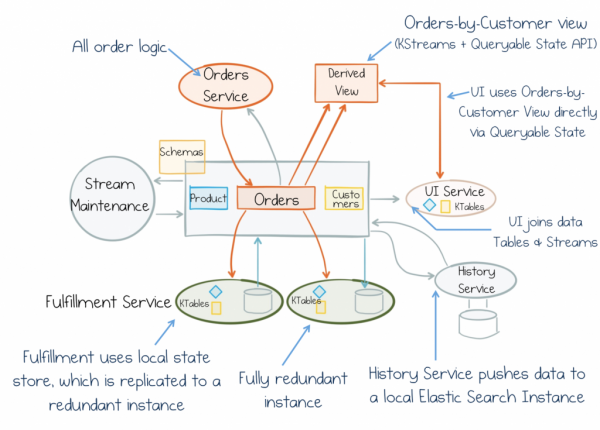
De először is jegyezd meg a következőt: az adatok dikhotómiája az a hatalom, amellyel találkozunk üzleti szolgáltatások létrehozásakor. Ezt szem előtt kell tartanunk. A kulcs az, hogy mindent fejjel lefelé fordítsunk, és kezdjük el az összes adatot első osztályú objektumokként számítani. A Stateful Stream Processing egyedülálló kompromisszumot biztosít ehhez. Elkerüli a központosított „Isten komponenseket”, amelyek gátolják a fejlődést. Továbbá biztosítja az operatív, skálázható és hibamentes adatfolyam-kezelő csövek működését, és azokat minden szolgáltatáshoz hozzáadja. Így a közös tudatáramra összpontosíthatunk, amelyhez bármely szolgáltatás csatlakozhat és dolgozhat az adataival. Így a szolgáltatások skálázhatóbbá, helyettesíthetőbbé és autonómabbá válnak. Ezért nemcsak jól mutatnak a táblázatokon és a hipotézisek ellenőrzésekor, hanem évtizedekig működnek és fejlődnek is.
Forrás: habr.com
