

Idén tavasszal már megvitattuk néhány bevezető témát, például és . A másodikban még meg is ígéztük, hogy folytatjuk a különböző többlemezes topológiák teljesítményének vizsgálatát ZFS alatt. Ez a következő generációs fájlrendszer, amely éppen most terjed el az egész világon: a tól .
Nos, ma a legjobb nap a ZFS megismerésére, kíváncsi olvasók. Csak tudjátok, hogy a fejlesztő OpenZFS-től, Matt Arens-től származó szerény becslés szerint „ez valóban bonyolult.”
De mielőtt eljutnánk a számokhoz – és azok jönni fognak, ígérem – a nyolclemezes ZFS konfigurációk összes lehetőségéről, beszéljünk arról, hogyan hogyan tárolja egyáltalán a ZFS az adatokat a lemezen.
Zpool, vdev és device
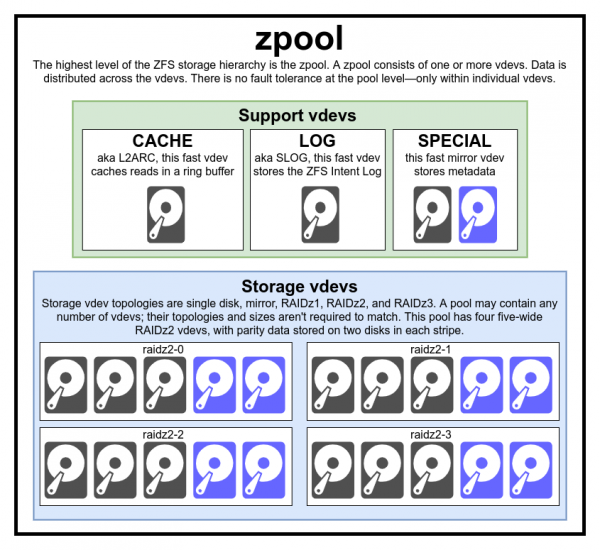
Ez a diagram egy teljes pool-ról tartalmaz három segéd vdev-et, mindegyik osztályból egyet és négyet RAIDz2 számára
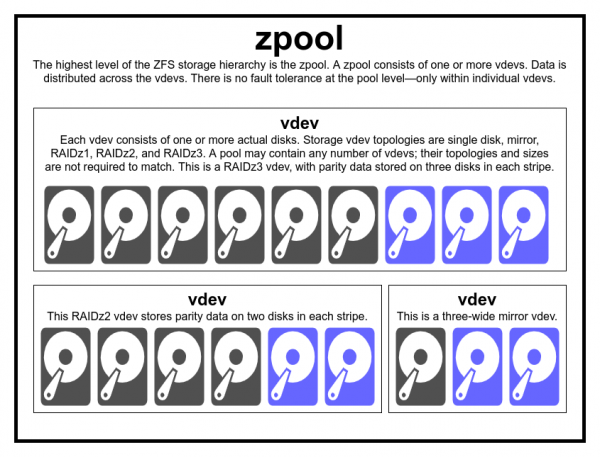
Általában nincs ok arra, hogy egy pool-t eltérő típusú és méretű vdev-ekből építsünk – de ha szeretnéd, semmi sem akadályoz meg benne.
Ahhoz, hogy valóban megértsük a ZFS fájlrendszert, alaposan meg kell vizsgálnunk annak tényleges struktúráját. Először is, a ZFS egyesíti a hagyományos kötetkezelési és fájlrendszeri szinteket. Másodszor, tranzakciós másolást alkalmaz írás közben. Ezek a jellemzők azt jelentik, hogy a rendszer szerkezetileg nagyon eltér a szokásos fájlrendszerektől és RAID tömböktől. Az első alapvető építőkövek a megértéshez: ez a tárolópul (zpool), a virtuális eszköz (vdev) és a valódi eszköz (device).
zpool
A tárolópul (zpool) a ZFS legfelső szerkezete. Minden pool tartalmaz egy vagy több virtuális eszközt. Ezek viszont egy vagy több valódi eszközt (device) tartalmaznak. A virtuális pool-ok önálló blokkok. Egy fizikai számítógép tartalmazhat két vagy több külön pool-t, de mindegyik teljesen független a többitől. A pool-ok nem oszthatnak meg virtuális eszközöket.
A ZFS redundancia a virtuális eszközök szintjén található, nem pedig a pool-ok szintjén. A pool-ok szintjén egyáltalán nincs redundancia – ha bármelyik vdev vagy speciális vdev elveszik, akkor vele együtt elveszik az egész pool is.
A modern storage pool can survive the loss of cache or a virtual device log—although it may lose a small amount of dirty data if it loses the vdev log during a power outage or system crash.
There is a common misconception that ZFS data stripes are written across the entire pool. This is incorrect. The zpool is not just a fun RAID0; it is rather more complex. with a complex, variable distribution mechanism.
For the most part, writes are distributed among the available virtual devices based on the free space available, so theoretically they will fill up simultaneously. In later versions of ZFS, current utilization of the vdev is taken into account—if one virtual device is significantly more loaded than another (for example, due to read workload), it will be temporarily skipped for writing despite the highest free space ratio.
The utilization detection mechanism embedded in modern ZFS write distribution methods can reduce latency and increase throughput during unusually high load periods—but it does not provide a blank check for inadvertently mixing slow HDDs and fast SSDs in one pool. Such an unbalanced pool will still operate at the speed of the slowest device, as if it were entirely composed of such devices. vdev
Each storage pool consists of one or more virtual devices (virtual device, vdev). Each vdev, in turn, includes one or more physical devices. Most virtual devices are used for simple data storage, but there are several auxiliary classes of vdev, including CACHE, LOG, and SPECIAL. Each of these vdev types can have one of five topologies: single device, RAIDz1, RAIDz2, RAIDz3, or mirror.
A modern storage pool can survive the loss of cache or a virtual device log—although it may lose a small amount of dirty data if it loses the vdev log during a power outage or system crash.
A RAIDz1, RAIDz2 és RAIDz3 a RAID párhuzamos (diagonális) paritás speciális változatai, amit a régi időkben emlegettek. A 1, 2 és 3 arra utal, hány paritás blokk van kijelölve minden adathalmazon. A paritás nincs különálló lemezeken, hanem a RAIDz virtuális eszközök félig egyenletesen osztja el a lemezek között. A RAIDz tömb annyi lemezt tud elveszíteni, amennyi paritás blokkja van; ha még egyet elveszít, tönkremegy és magával viszi a tároló medencét.
Tükör virtuális eszközökben (mirror vdev) minden blokk minden eszközön tárolva van. Habár a legelterjedtebb a dupla tükör (two-wide), a tükörben bármennyi eszköz lehet — nagyobb telepítésekben a beolvasási teljesítmény és az hibahatékonyság növelésére gyakran alkalmaznak hármas tükröket. A tükör vdev bármely hiba esetén túlél, amíg legalább egy eszköz működik a vdev-ben.
Az egyes vdev-ek lényegében veszélyesek. Ez a virtuális eszköz nem bír el egy hibát sem — és ha tárolóként vagy különleges vdev-ként használják, akkor hibája az egész medence megsemmisüléséhez vezet. Itt nagyon, nagyon óvatosnak kell lenni.
A CACHE, LOG és SPECIAL virtuális eszközök bármelyik fent említett topológia szerint létrehozhatók — de ne feledje, hogy a SPECIAL virtuális eszköz elvesztése a medence elvesztését jelenti, így erősen ajánlott a redundáns topológia.
eszköz
Valószínűleg ez a legkönnyebben érthető kifejezés a ZFS-ben — ez szó szerint egy véletlen hozzáférésű blokk eszköz. Ne feledje, hogy a virtuális eszközök különböző eszközökből állnak, míg a medence virtuális eszközökből készül.
A lemezek — mágneses vagy szilárdtest — a legelterjedtebb blokk eszközök, amelyeket a vdev építőköveiként használnak. Azonban bármilyen eszköz, amely a /dev könyvtárban megtalálható, megfelelhet — tehát teljes hardver RAID tömbök is használhatók külön eszközként.
A nyers fájl az egyik legfontosabb alternatív blokk eszköz, amiből vdev építhető. Tesztmedencékből származik — ez egy nagyon kényelmes módja a medence parancsainak tesztelésére és annak ellenőrzésére, hogy mennyi hely áll rendelkezésre a medencébe vagy a virtuális eszközbe az adott topológiában.
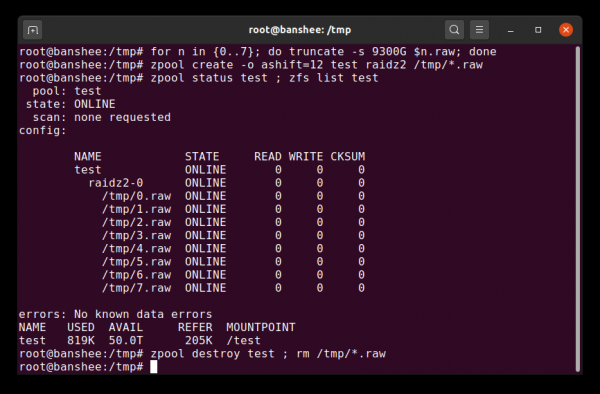
Több másodperc alatt létrehozhat egy tesztpultot töredezett fájlokkal – de ne felejtse el később eltávolítani az összes pultot és annak alkotóelemeit.
Tegyük fel, hogy nyolc lemezre szeretne kiszolgálót telepíteni, és 10 TB (~9300 GiB) lemezeket tervez használni – de nem biztos abban, hogy melyik topológia felel meg legjobban az igényeinek. A fenti példában néhány másodperc alatt építünk fel egy tesztpultot töredezett fájlokkal – és most már tudjuk, hogy a nyolc 10 TB-os lemezből álló RAIDz2 vdev 50 TiB hasznos kapacitást biztosít.
Egy másik különleges eszközosztály a SPARE (tartalék). A hot-swap eszközök, ellentétben a normál eszközökkel, az egész pulthoz tartoznak, nem egy virtuális eszközhöz. Ha egy vdev a pultban meghibásodik, és a tartalék eszköz csatlakozik a pulthoz és elérhető, akkor automatikusan csatlakozik a sérült vdevhez.
A sérült vdevhez való csatlakozás után a tartalék eszköz elkezdi megkapni azokat a másolatokat vagy rekonstrukciókat, amelyeknek az eltűnt eszközön kell lenniük. A hagyományos RAID-ben ez helyreállításnak (rebuilding) nevezik, a ZFS-ben pedig a "többlet helyreállításának" (resilvering).
Fontos megjegyezni, hogy a tartalék eszközök nem helyettesítik véglegesen a meghibásodott eszközöket. Ez csupán ideiglenes helyettesítés a vdev degradációjának csökkentésére. Miután az adminisztrátor kicseréli a meghibásodott vdev eszközt, a többlet helyreállítása ennek a tartós eszköznek a keresztül történik, a SPARE leválik a vdev-ről és visszatér a tartalék munkához az egész pult számára.
Adatkészletek, blokkok és szektorok
A következő építőelemek, amelyeket meg kell értenünk a ZFS-en végzett utazásunk során, nem annyira a hardverhez, hanem inkább arra vonatkoznak, hogyan vannak szervezve és tárolva maguk az adatok. Itt néhány szintet kihagyunk – mint például a metaslab – hogy elkerüljük a részletek túlhágását, megőrizve az általános szerkezet megértését.
Adatkészlet (dataset)
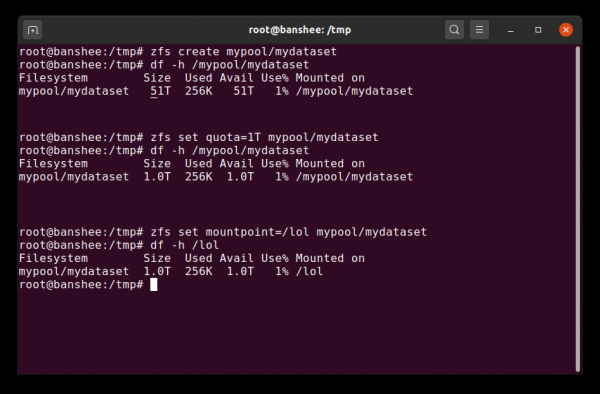
Amikor először létrehozzuk az adatkészletet, az összes elérhető pultterületet megjeleníti. Ezután beállítjuk a kvótát – és megváltoztatjuk a csatolási pontot. Varázslat!
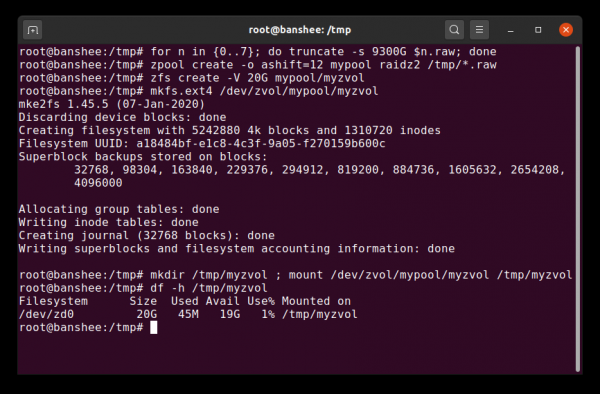
A Zvol nagyrészt csak egy adatkészlet, amely mentes a fájlrendszer rétegétől, amelyet itt egy teljesen normális ext4 fájlrendszerrel helyettesítünk.
A ZFS dataset is roughly analogous to a standard mounted file system. Like a regular file system, at first glance, it seems like 'just another folder.' However, just like regular mounted file systems, each ZFS dataset has its own set of underlying properties.
First and foremost, a dataset can have an assigned quota. If you set zfs set quota=100G poolname/datasetname, you will not be able to write to the mounted folder /poolname/datasetname more than 100 GiB.
Did you notice the presence—and absence—of slashes at the beginning of each line? Each dataset has its own place in both the ZFS hierarchy and the system mount hierarchy. There is no leading slash in the ZFS hierarchy—you begin with the pool name and then the path from one dataset to the next. For example, pool/parent/child for a dataset named child under the parent dataset parent in a pool with a creative name pool.
By default, the mount point of the dataset will be equivalent to its name in the ZFS hierarchy, with a leading slash—the pool named pool will be mounted as /pool, the dataset parent is mounted at /pool/parent, and the child dataset child is mounted at /pool/parent/child. However, the system mount point of the dataset can be changed.
If we specify zfs set mountpoint=/lol pool/parent/child, the dataset pool/parent/child will be mounted in the system as /lol.
In addition to datasets, we must mention volumes (zvols). A volume is roughly analogous to a dataset, except it does not actually have a file system—it is simply a block device. For example, you can create zvol a névvel mypool/myzvol, then format it with the ext4 file system and then mount this file system—now you have an ext4 file system but with all the safety features of ZFS! This may seem silly on one machine, but makes much more sense as a backend when exporting an iSCSI device.
Egységek
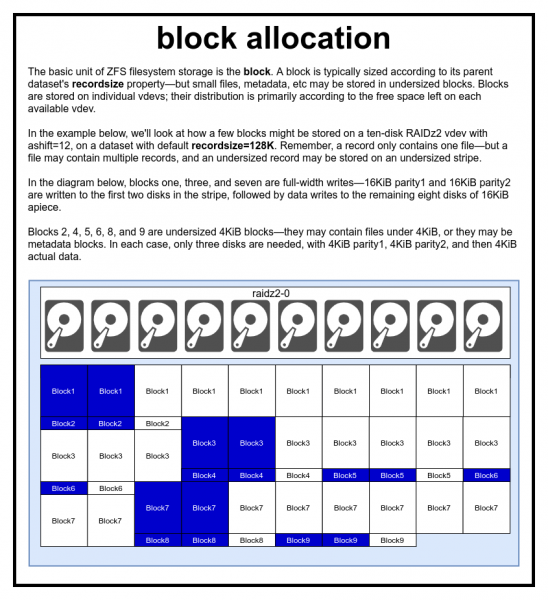
A file is represented by one or more blocks. Each block is stored on one virtual device. The block size is typically equal to the parameter recordsize, but can be reduced to 2^ashift, if it contains metadata or a small file.
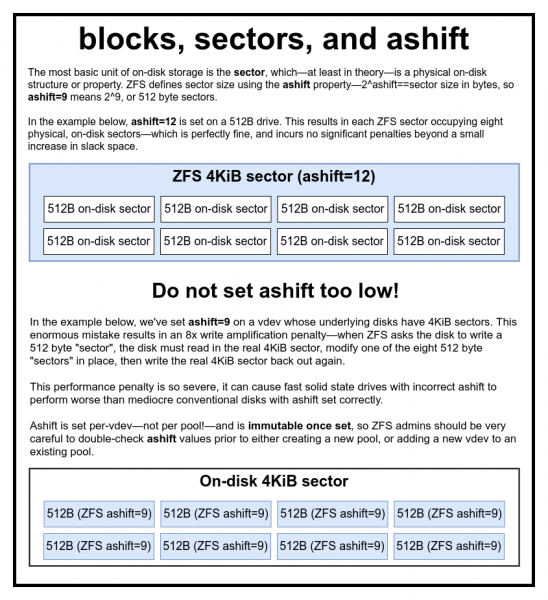
We are indeed not joking about the huge performance penalties if you set ashift too small. valóban не шутим по поводу огромного ущерба производительности, если установить слишком маленький ashift
A ZFS pool stores all data, including metadata, in blocks. The maximum block size for each dataset is defined by the property recordsize (record size). The record size can be changed, but this will not affect the size or location of any blocks that have already been written to the dataset—it only applies to new blocks as they are written.
Unless otherwise specified, the current default record size is 128 KiB. This is somewhat of a trade-off, where the performance will not be ideal but not terrible in most cases. Recordsize can be set to any value from 4K to 1M (with additional settings recordsize it can be set even larger, but this is rarely a good idea).
Any block references data from only one file—you cannot fit two different files into one block. Each file is made up of one or more blocks, depending on the size. If the file size is less than the record size, it will be stored in a smaller block—for example, a block with a 2 KiB file will occupy only one 4 KiB sector on the disk.
If the file is large enough and requires multiple blocks, then all records with that file will have a size recordsize —including the last record, the main part of which may turn out to be .
Zvols do not have the property recordsize —instead, they have an equivalent property volblocksize..
Sectors
The last, most basic building block is the sector. This is the smallest physical unit that can be written or read from the underlying device. For decades, most disks used 512-byte sectors. Recently, most disks are set to 4 KiB sectors, and in some cases—especially SSDs—8 KiB sectors or even larger.
ZFS has a property that allows you to manually set the sector size. This property ashift. It's somewhat confusing that ashift is a power of two. For example, ashift=9 indicates a sector size of 2^9, or 512 bytes.
A ZFS a műveletek során részletes információt kér a működési rendszertől minden egyes blokkeszközről, amikor az új vdev-re kerül hozzáadásra, és elméletileg automatikusan helyesen állítja be az ashift értékét ezen információk alapján. Sajnos sok meghajtó hazudik a szektor méretéről, hogy megőrizze a Windows XP-vel való kompatibilitást (amely nem volt képes megérteni a különböző szektor méreteket).
Ezért a ZFS rendszergazdáinak erősen ajánlott tudniuk eszközeik valódi szektor méretét és kézzel beállítani ashift. Ha az ashift túl kicsi, az rendkívüli mértékben megnöveli az írási/olvasási műveletek számát. Így például egy 512 bájtos "szektor" írása egy valós 4 KiB szektorba azt jelenti, hogy először az első "szektort" kell írni, majd olvasni egy 4 KiB szektort, módosítani azt a második 512 bájtos "szektorral", majd vissza kell írni az új 4 KiB szektorba, és így tovább minden írásnál.
A valós világban ez a büntetés súlyosan érinti a Samsung EVO SSD-ket, amelyekre kell, hogy érvényes legyen ashift=13, de ezek az SSD-k hazudnak a szektor méretükről, ezért alapértelmezés szerint be van állítva ashift=9. Ha a tapasztalt rendszergazda nem módosítja ezt a beállítást, akkor ez az SSD lassabban fog működni, mint a hagyományos mágneses HDD.
Összehasonlításképpen, a túl nagy méret esetén ashift gyakorlatilag nincs büntetés. Valódi teljesítménycsökkenés nincs, és a kihasználatlan terület végtelenül kicsi (vagy nulla, ha tömörítés be van kapcsolva). Ezért erősen javasoljuk, hogy még azoknak a meghajtóknak is, amelyek valóban 512 bájtos szektorokat használnak, állítsák be ashift=12 vagy akár ashift=13, hogy magabiztosan tekintsenek a jövőbe.
A ashift az egyes virtuális eszközök vdev-re van beállítva, nem pedig a tárolóra, ahogy sokan tévesen gondolják — és a beállítás után nem változtatható meg. Ha véletlenül hibát vét a új vdev tárolóra történő hozzáadása során, akkor véglegesen fertőzte el ezt a tárolót egy alacsony teljesítményű eszközzel, és általában nincs más megoldás, mint megsemmisíteni a tárolót, és minden újra kezdeni. Még a vdev törlése sem ment meg a hibás beállítástól.Írás közben másoló mechanizmus ashift Ha egy szokásos fájlrendszernek újra kell írnia az adatokat — módosítja minden blokkot, ahol az megtalálható. ashift!
Механизм копирования при записи
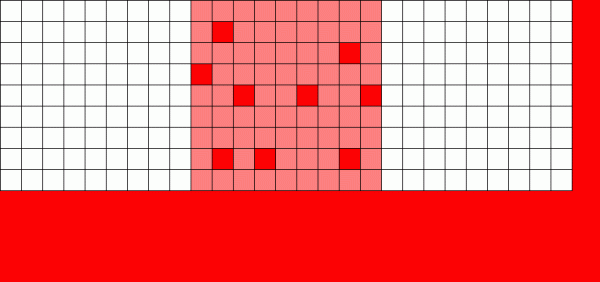
Если обычной файловой системе нужно перезаписать данные — она изменяет каждый блок там, где он находится
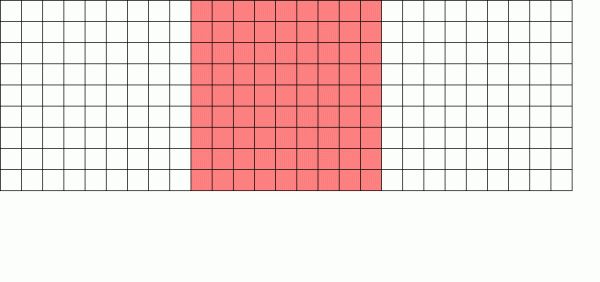
A fájlrendszer írás közbeni másolása új verziót ír a blokkra, majd feloldja a régi verziót.
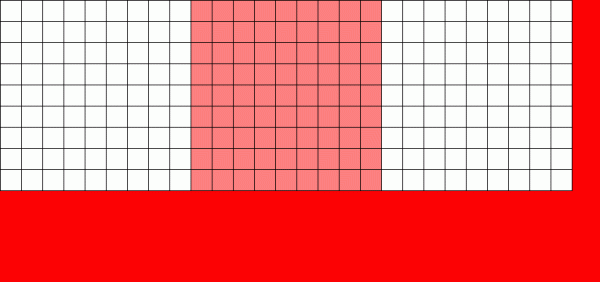
Absztrakt értelemben, ha figyelmen kívül hagyjuk a blokkok valódi fizikai elhelyezkedését, adataink "kométája" leegyszerűsödik "adatféreggé", amely balról jobbra mozog a rendelkezésre álló térképén.
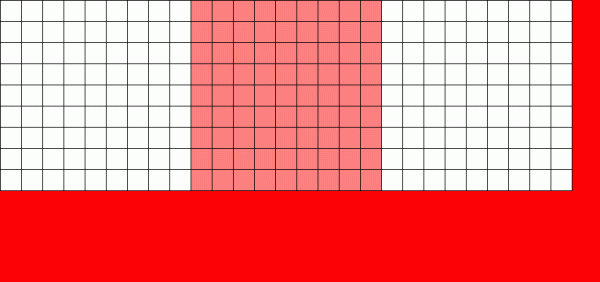
Most jó képet kaphatunk arról, hogyan működnek az írás közbeni pillanatképek – minden blokk több pillanatképhez is tartozhat, és megmarad, amíg az összes kapcsolódó pillanatképet el nem távolítják.
Az írás közbeni másolás mechanizmusa (Copy on Write, CoW) a ZFS csodálatos rendszerének alapvető alapja. Az alapötlet egyszerű – ha megkérdezi a hagyományos fájlrendszert, hogy módosítson egy fájlt, ez pontosan azt teszi, amit kér. Ha azonban írás közbeni másolásra kér egy fájlrendszert, ő azt mondja: 'rendben' – de hazudik Önnek.
Ehelyett az írás közbeni másolással dolgozó fájlrendszer új verziót ír a módosított blokkhoz, majd frissíti a fájl metadatáját, hogy megszakítsa a kapcsolatot a régi blokkal, és összekapcsolja a legújabb végrehajtott blokkra.
A régi blokk leválasztása és az új összekapcsolása egyetlen műveletként valósul meg, ezért azt nem lehet megszakítani – ha áramtalanítja, miután ez megtörtént, új verziója lesz a fájlnak, ha pedig korábban, akkor a régi verziót kapja meg. Mindkét esetben nem kerül konfliktus a fájlrendszeren belül.
A ZFS írás közbeni másolása nemcsak a fájlrendszeren, hanem a lemezkezelés szintjén is zajlik. Ez azt jelenti, hogy a ZFS nem szenved a "zsugorodási rés"-től () – ez egy olyan jelenség, amikor a sáv csak részlegesen íródik, mielőtt a rendszer összeomlik, és a tömb megsérül a rendszer újraindítása után. Itt a sáv atomikusan íródik, a vdev mindig következetes, és .
ZIL: a ZFS szándéknaplója
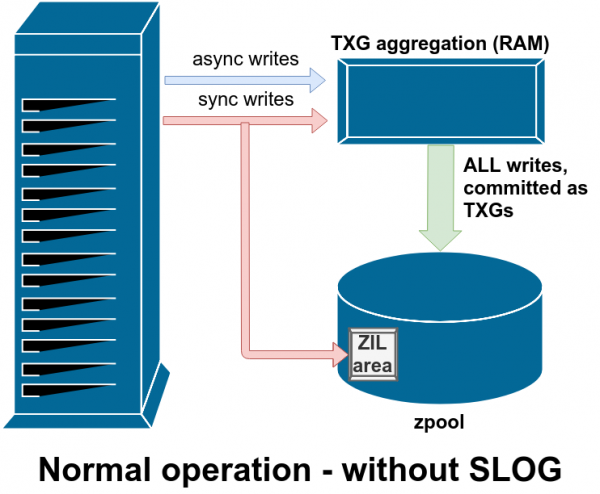
A ZFS rendszer a szinkron írásokat külön módon kezeli – ideiglenesen, de azonnal megőrzi azokat a ZIL-be, mielőtt később végleg bejegyezné azokat az aszinkron írásokkal együtt.
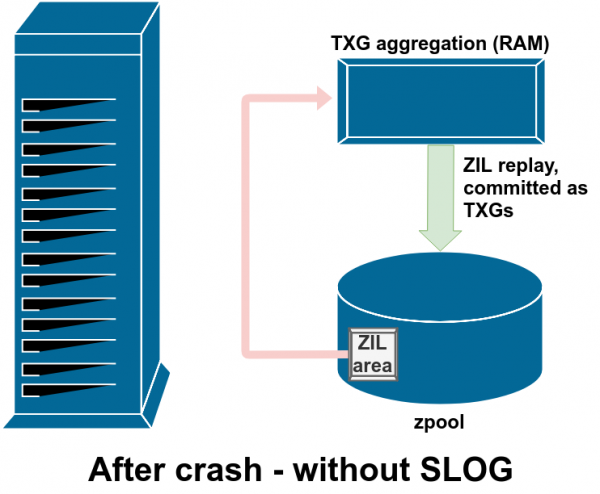
Általában a ZIL-en írt adatokat soha többé nem olvassák vissza. De ez lehetséges rendszerhiba után.
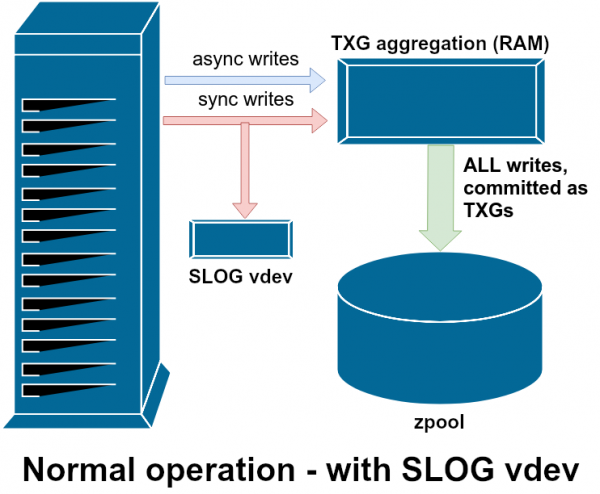
A SLOG, vagyis másodlagos LOG-eszköz, egy speciális - és lehetőleg nagyon gyors - vdev, ahol a ZIL külön gyűjthető a fő tárolótól.
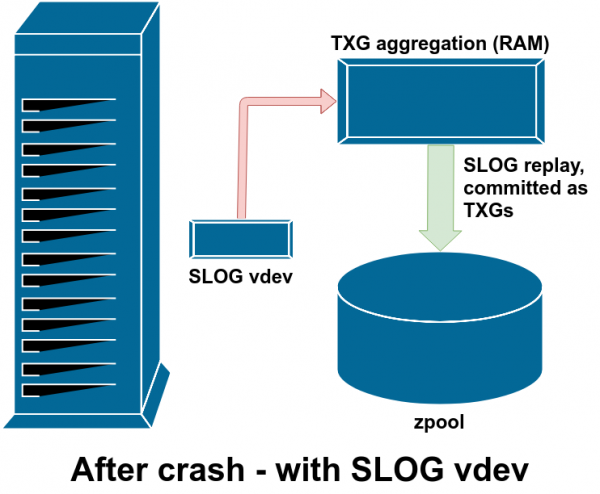
Hiba után az összes piszkos adat a ZIL-ben visszaállításra kerül - ebben az esetben a ZIL a SLOG-on van, így pontosan onnan történik a visszaállítás.
Két fő kategóriája van a felírási műveleteknek - szinkron (sync) és aszinkron (async). A legtöbb munkaterhelés esetén a felírási műveletek túlnyomó többsége aszinkron - a fájlrendszer lehetővé teszi azok aggregálását és csomagokba való kiadását, csökkentve a töredezettséget és jelentősen növelve a sávszélességet.
A szinkron felírások teljesen más kérdés. Amikor egy alkalmazás szinkron felírást kér, azt mondja a fájlrendszernek: "Ezt rögzítened kell az energiát nem igénylő memóriában, és addig nem csinálhatok semmi mást". Ezért a szinkron felírásokat azonnal rögzíteni kell a lemezen - és ha ez növeli a töredezettséget vagy csökkenti a sávszélességet, akkor az így van. most azonnalA ZFS eltérően kezeli a szinkron felírásokat, mint a szokásos fájlrendszerek - ahelyett, hogy azonnal a normál tárolóba írná őket, a ZFS egy speciális tárolási területen rögzíti őket, amely a ZFS Szándéknapló (ZFS Intent Log, vagy ZIL) néven ismert. A trükk az, hogy ezek a felírások
a memóriában maradnak, aggregálva a normál aszinkron felírási kérelmekkel, hogy később a tárolóra normális TXG-ként (tranzakciócsoportok, Transaction Groups) leírhatók legyenek. szintén Normál működés esetén a ZIL folyamatosan íródik és soha nem olvassák vissza. Amikor néhány pillanaton belül a ZIL-ből származó felírások a fő tárolóban normális TXG-ként kerülnek rögzítésre a memóriából, a ZIL-től eltávolítják őket. Az egyetlen alkalom, amikor valamit olvasnak a ZIL-ből, az a medence importálásakor történik.
Ha ZFS hiba lép fel - operációs rendszer hiba vagy áramszünet - amikor a ZIL-ben adatok találhatók, ezek az adatok a következő medence importálásakor (például a vészhelyzeti rendszer újraindításakor) olvasásra kerülnek. Minden, ami a ZIL-ben van, olvasásra kerül, csoportosítva TXG-ké, rögzítve a fő tárolóban, majd eltávolítva a ZIL-ből az importálás folyamatában.
Если происходит сбой ZFS — сбой операционной системы или отключение питания — когда в ZIL есть данные, эти данные будут считаны во время следующего импорта пула (например, при перезапуске аварийной системы). Всё, что находится в ZIL, будет считано, объединено в группы TXG, зафиксировано в основном хранилище, а затем отсоединено от ZIL в процессе импорта.
Az vdev segédosztályok egyikét LOG-nak vagy SLOG-nak hívják, a másodlagos LOG-eszközt. Ennek a feladata egy külön vdev biztosítása a pool számára, amely lehetőleg sokkal gyorsabb, és rendkívül magas írási ellenállással bír, a ZIL tárolására, ahelyett, hogy a ZIL-t a fő vdev tárolná. A ZIL ugyanúgy viselkedik, függetlenül a tárolás helyétől, de ha a vdev LOG-jának rendkívül magas az írási teljesítménye, akkor a szinkron írások gyorsabban fognak történni.
A vdev LOG hozzáadása a poolhoz semmilyen módon nem tudja javítani az aszinkron írás teljesítményét - még akkor is, ha minden írást kényszerítetten végrehajtasz a ZIL-en, a zfs set sync=always, akkor is a fő tárolóhoz a TXG-ben, ugyanolyan módon és ugyanabban a tempóban fognak kötődni, mint napló nélkül. Az egyetlen közvetlen teljesítménynövekedés a szinkron írás késése (mivel a nagyobb naplósebesség felgyorsítja a műveletek végrehajtását. sync).
Azonban egy olyan környezetben, amely már sok szinkron írást igényel, a vdev LOG közvetett módon felgyorsíthatja az aszinkron írást és a gyorsítótár nélküli olvasást. A ZIL írásainak egy külön vdev LOG-ba való kiadása kevesebb versenyt jelent a fő tároló IOPS-jáért, ami bizonyos mértékig növeli minden olvasási és írási művelet teljesítményét.
Fényképek
A másolás írása mechanizmusa szintén szükséges alapja az atomikus ZFS pillanatfelvételeknek és az inkrementális aszinkron replikációnak. Egy aktív fájlrendszerben egy mutatófa található, amely az aktuális adatokkal rendelkező összes írást jelöli - amikor pillanatfelvételt készítesz, csupán ennek a mutatófának a másolatát készíted el.
Amikor egy aktív fájlrendszerben egy írást felülírnak, a ZFS először az új blokk verzióját az nem használt térségbe írja. Ezután leválasztja a blokk régi verzióját az aktuális fájlrendszerről. De ha egy pillanatfelvétel hivatkozik a régi blokkra, az változatlan marad. A régi blokk ténylegesen nem lesz helyreállítva szabad térként, amíg az összes olyan pillanatfelvétel, amely hivatkozik erre a blokkra, el nem pusztul!
Replikáció
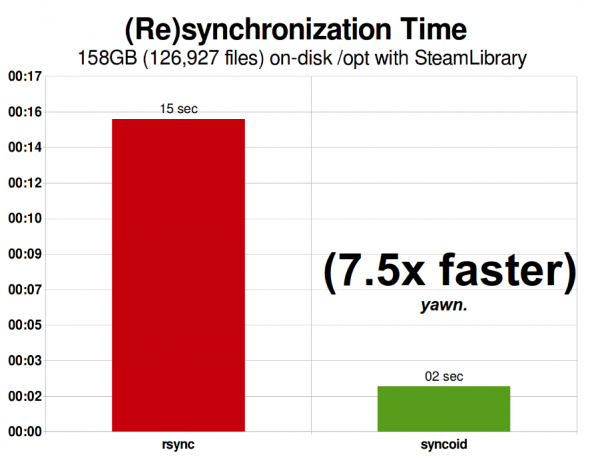
A Steam könyvtáram 2015-ben 158 GiB helyet foglalt el, és 126 927 fájlt tartalmazott. Ez elég közel áll a rsync optimális helyzetéhez - a ZFS hálózaton való replikálása "csupán" 750%-kal volt gyorsabb.
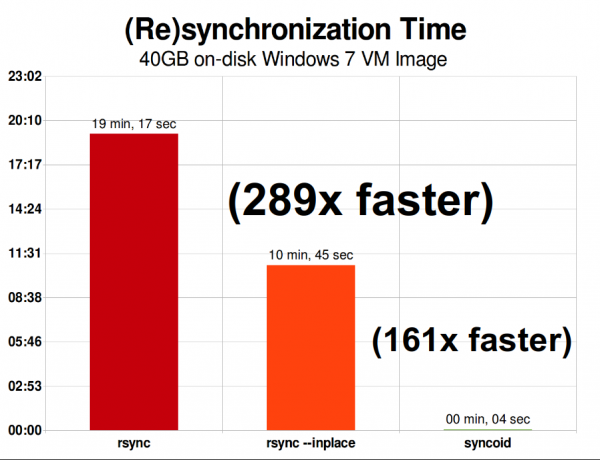
A 40-gigabyte image file replication of a Windows 7 virtual machine in the same network is a completely different story. ZFS replication occurs 289 times faster than rsync—or 'only' 161 times faster if you're savvy enough to call rsync with the --inplace flag.
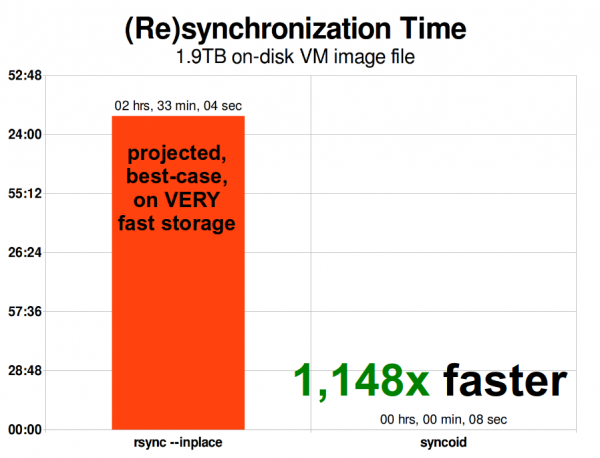
When the virtual machine image scales, rsync's problems scale with it. A size of 1.9 TiB isn't too large for a modern virtual machine image—but it's large enough for ZFS replication to be 1148 times faster than rsync, even with the rsync --inplace argument.
Once you understand how snapshots work, it won't be difficult to grasp the essence of replication. Since a snapshot is just a tree of pointers to records, it follows that if we create a zfs send snapshot, we are also sending this tree and all associated records. When we transmit this zfs send be. zfs receive to the target object, it records both the actual block content and the tree of pointers referencing the blocks into the target dataset.
It gets even more interesting on the second zfs send. Now we have two systems, each containing poolname/datasetname@1, and you take a new snapshot poolname/datasetname@2. So in the source pool, you have datasetname@1 és datasetname@2, while in the target pool, there is only the first snapshot for now. datasetname@1.
Since we have a common snapshot between the source and target, we can perform an datasetname@1incremental on top of it. When we tell the system zfs send zfs send -i poolname/datasetname@1 poolname/datasetname@2 , it compares the two pointer trees. Any pointers that exist only in, obviously point to new blocks—so we will need the content of those blocks. @2On the remote system, handling the incremental
is just as simple. First, we write all new records included in the stream send , and then we add pointers to these blocks. Voila, we have sendin the new system! @2 Asynchronous incremental ZFS replication is a huge improvement over earlier non-snapshot-based methods like rsync. In both cases, only changed data is transmitted—but rsync must first
read all data from both sides to check the checksum and compare it. In contrast, ZFS replication reads nothing but pointer trees—and any blocks that are not represented in the common snapshot. elolvasható с диска все данные с обеих сторон, чтобы проверить сумму и сравнить её. В отличие от этого, репликация ZFS не считывает ничего, кроме деревьев указателей — и любых блоков, которые не представлены в общем снапшоте.
Beépített tömörítés
A felírási másolási mechanizmus szintén egyszerűsíti a beépített tömörítési rendszert. Hagyományos fájlrendszerekben a tömörítés problémás — a módosított adatok régi és új verziója ugyanabban a területen található.
Ha megnézünk egy adatereklyét egy fájl közepén, amely a 0x00000000-ból induló megabájt nullákból áll — ezt könnyen tömöríthetjük egy lemezen található szektorra. De mi történik, ha ezt a megabájt nullát nem tömöríthető adatokra, például JPEG-re vagy pszeudóvéletlenszerű zajra cseréljük? Hirtelen ennek a megabájt adatonak nem egy, hanem 256 szektorra lesz szüksége 4 KiB-onként, ugyanakkor ezen a területen csak egy szektor van fenntartva a lemezen.
A ZFS-nek nincs ilyen problémája, mivel a módosított bejegyzések mindig felhasználatlan területre íródnak — az eredeti blokk csak egy 4 KiB-os szektort foglal el, az új bejegyzés pedig 256-ot, de ez nem probléma — a fájl "közepéből" nemrég módosított szakasz felhasználatlan területre kerülne, függetlenül attól, hogy megváltozott-e a mérete vagy sem, tehát ez a ZFS számára teljesen normális helyzet.
A ZFS beépített tömörítése alapértelmezés szerint ki van kapcsolva, és a rendszer cserélhető algoritmusokat kínál — ezek közül jelenleg az LZ4, gzip (1-9), LZJB és ZLE áll rendelkezésre.
- LZ4 — egy folyamatos algoritmus, amely rendkívül gyors tömörítést és dekompresszálást kínál, valamint teljesítménynövekedést a legtöbb felhasználási esetben — még viszonylag lassú CPU-ken is.
- GZIP — egy tiszteletreméltó algoritmus, amelyet minden Unix-rendszer felhasználója ismer és szeret. A tömörítési szintek 1-9 között valósítható meg, a tömörítés mértéke és a CPU-használat növekszik a 9-es szint közelében. Az algoritmus jól alkalmazható minden szöveges (vagy más rendkívül tömöríthető) felhasználásra, de egyébként gyakran problémákat okozhat a CPU-val — használja óvatosan, különösen magasabb szinteken.
- LZJB — az eredeti algoritmus a ZFS-ben. Elavult, és már nem kellene használnunk, az LZ4 minden szempontból felülmúlja.
- ZLE — nulla szintű kódolás, Zero Level Encoding. Ez alapvetően nem érinti a normális adatokat, de tömöríti a nagy nullasorozatokat. Hasznos a teljesen nem tömöríthető adathalmazok esetében (például JPEG, MP4 vagy más már tömörített formátumok), mivel figyelmen kívül hagyja a nem tömöríthető adatokat, de tömöríti a felhasználatlan teret a végső rekordokban.
Az LZ4 tömörítést szinte minden használati esethez ajánljuk; a nem tömöríthető adatokkal való találkozáskor a teljesítmény büntetése nagyon kicsi, míg növekedés a tipikus adatok esetén a teljesítmény jelentős. A virtuális gép képének másolása egy új Windows operációs rendszer telepítéshez (frissen telepített OS, még semmilyen adat nincs benne) a compression=lz4 27%-kal gyorsabb volt, mint a compression=none, in .
ARC – adaptív csere cache
A ZFS az egyetlen ismert modern fájlrendszer, amely saját olvasási gyorsítótárazási mechanizmusát használja, és nem támaszkodik az operációs rendszer lapkészletére a nemrégiben olvasott blokkok memóriában való tárolásához.
Bár a saját cache nem mentes a problémáktól – a ZFS nem tud olyan gyorsan reagálni az új memóriaallokációs igényekre, mint a kernel, így egy új memória allokációs kérés meghiúsulhat, ha a RAM-ot jelenleg az ARC foglalja el. De van jó indok a saját cache használatára, legalábbis jelenleg. malloc() Minden ismert modern OS, beleértve a MacOS-t, Windows-t, Linux-t és BSD-t, az oldalgyorsítótár megvalósításához LRU (Least Recently Used) algoritmust használ. Ez egy primitív algoritmus, amely minden olvasás után "felhozza" a gyorsítótárazott blokkot "a sor elejére", és a szükség szerint "lejjebb tolja" a blokkokat "a sor végére", hogy új cache hibákat (blokkokat, amelyeket a lemezről kellett volna olvasni, nem a gyorsítótárból) hozzá tudjon adni.
Általában az algoritmus jól működik, de a nagy munkahalmakkal rendelkező rendszerekben az LRU könnyen kényszerít blokk törlésekhez vezethet — a gyakran szükséges blokkok kiszorításához, hogy helyet szabadítson fel a blokkok számára, amelyeket már soha többé nem olvasnak a gyorsítótárból.
ARC
— sokkal kevésbé naiv algoritmus, amelyet „súlyozott” cache-ként lehet felfogni. Minden egyes cache-elt blokk olvasásakor egy kicsit „nehézsé” válik, és nehezebb kiszorítani — és még a kiszorítás után is a blokk nyomon követett egy adott időtartamra. A kiszorított blokk, amelyet aztán vissza kell olvasni a cache-be, szintén „nehézsé” válik.
Mindez végül egy sokkal magasabb találati arányú cache-t eredményez (hit ratio) — a cache-ben végzett találatok (cache-ből olvasva) és a hiányok (lemezről olvasva) arányáról van szó. Ez rendkívül fontos statisztika — a cache találatok feldolgozása jóval gyorsabb, a cache hiányok is gyorsabban kezelhetőek, mivel minél több cache találat van, annál kevesebb párhuzamos kérés történik a lemezre, és annál kisebb a késleltetés a megmaradt hiányok számára, amelyeket lemezről kell kezelni.
Zárás
Miután megvizsgáltuk a ZFS alapvető szemantikáját — hogyan működik a másolás írás közben, és az adattároló medencék, virtuális eszközök, blokkok, szektorok és fájlok közötti kapcsolatok — készen állunk arra, hogy a valós teljesítményt valós számokkal vitassuk meg.
A következő részben a tükrözött vdev-ek és a RAIDz tényleges teljesítményét, egymáshoz viszonyítva, valamint a vizsgált hagyományos Linux RAID-topológiákkal való összehasonlításukat tárgyaljuk. .
Először csak az alapokat akartuk megvizsgálni — magukat a ZFS topológiákat — de azután annyi készen állunk arra, hogy a ZFS finomhangolásáról és fejlettebb beállításairól beszéljünk, beleértve az L2ARC, SLOG és Special Allocation segéd vdev típusok használatát.
Forrás: habr.com
