

Ilya Kosmodemyansky 2015-ös előadásának "Linux optimalizálás a PostgreSQL teljesítményének javításához"
Megjegyzés: Felhívom a figyelmet, hogy ez az előadás 2015 novemberéből származik — több mint 4 év telt el, és sok minden megváltozott. Az előadásban tárgyalt 9.4-es verzió már nem támogatott. Az elmúlt 4 évben 5 új PostgreSQL kiadás jelent meg, és 15 új Linux kernel verzió. Ha ezeket a részeket átírnánk, akkor végül másik előadás születne. De itt a PostgreSQL-hez kapcsolódó Linux alapvető optimalizálásáról lesz szó, ami még mindig aktuális.
Az én nevem Ilya Kosmodemyansky. A PostgreSQL-Consulting cégnél dolgozom. Most egy kicsit arról fogok beszélni, hogy mit kell tenni a Linuxzal az adatbázisok általában, és a PostgreSQL esetén különösen, mert az alapelvek meglehetősen hasonlóak.
Miről fog szólni a beszélgetés? Ha kapcsolatban állsz a PostgreSQL-lal, akkor bizonyos mértékben UNIX rendszergazdának kell lenned. Mit is jelent ez? Ha összehasonlítjuk az Oracle-t és a PostgreSQL-t, akkor az Oracle esetében a DBA rendszergazda a feladatok 80%-át, míg Linux rendszergazda a 20%-át képviseli.
A PostgreSQL esetében a helyzet kicsit bonyolultabb. A PostgreSQL-hez sokkal jobban kell érteni, hogyan működik a Linux. Közben pedig egy kicsit lépést kell tartani a fejlődéssel, mert az utóbbi időben eléggé felgyorsultak a frissítések. Új kernel verziók jelennek meg, új funkciók lépnek életbe, a teljesítmény javul, és így tovább.
Miért beszélünk a Linuxról? Nem azért, mert a Linux Piter konferencián vagyunk, hanem mert a modern körülmények között az egyik legjobban alkalmazható operációs rendszer adatbázisok, különösen a PostgreSQL üzemeltetésére a Linux. A FreeBSD sajnos furcsa irányba fejlődik. Ez teljesítménybeli és sok más szempontból is problémákat okozhat. A PostgreSQL teljesítménye Windows alatt teljesen külön téma, ami abba ütközik, hogy a Windowsnak nincs olyan megosztott memóriája, mint a UNIX-nak, pedig a PostgreSQL teljes mértékben erre épít, mivel többszálú rendszer.
És az olyan egzotikus rendszerek, mint a Solaris, szerintem kevesebb embert érdekelnek, úgyhogy folytassuk.
A modern Linux disztribúcióknak több mint 1 000 syctl paramétere van, attól függően, hogyan van összeállítva a kernel. Emellett, ha megnézzük a különböző beállításokat, rengeteg módon lehet valamit finomhangolni. Vannak fájlrendszer paraméterek, hogyan kell csatolni őket. Ha kérdések merülnek fel arról, hogyan lehet elindítani: mit kell beállítani a BIOS-ban, hogyan kell konfigurálni a hardvereket, stb.
Ez egy nagyon nagy téma, amiről napokig lehetne beszélni, nem pedig egy rövid előadás keretein belül, de most a fontos dolgokra összpontosítok, hogy miként kerülhetjük el azokat a buktatókat, amelyek garantáltan megakadályozzák, hogy jól kihasználjuk az adatbázist Linux alatt, ha ezeket nem javítjuk. Ezen kívül lényeges, hogy sok paraméter alapértelmezés szerint nincsenek olyan beállításokra állítva, amelyek helyesek az adatbázishoz. Tehát alapértelmezetten rosszul fog működni, vagy egyáltalán nem fog működni.
Milyen hagyományos hangolási célok vannak Linux alatt? Úgy gondolom, hogy mivel mindannyian Linux adminisztrálásával foglalkoznak, nem szükséges különösebben magyarázni, hogy mik is azok a célok.
Lehet hangolni:
- CPU.
- Memória.
- Tárolás.
- Egyéb. Erről a végén beszélünk egy kicsit. Még például olyan paraméterek, mint az energiafogyasztási politika is nagyon kiszámíthatatlan és nem a legkellemesebb módon befolyásolhatják a teljesítményt.
Mi a specifikációja a PostgreSQL-nek és az adatbázisoknak általában? A probléma az, hogy nem lehet csak egyetlen apró részt hangolni és megnézni, hogy a teljesítményünk jelentősen javult.
Igen, vannak ilyen apró részek, de az adatbázis egy bonyolult dolog. Minden erőforrással interakcióba lép, ami a szerver rendelkezésére áll, és inkább a maximális interakcióra törekszik. Ha megnézzük az Oracle modern ajánlásait arról, hogyan használjuk a hoszt operációs rendszert, az olyan lesz, mint a vicc a mongol űrhajósról – etessük meg a kutyát, és ne foglalkozzunk semmivel. Adjuk meg az adatbázisnak az összes erőforrást, az adatbázis majd mindent megold.
Alapvetően a PostgreSQL esetében hasonló a helyzet. A különbség az, hogy az adatbázis nem mindig tudja önállóan elvenni az összes erőforrást, tehát néhány dolgot Linux szinten magunknak kell kezelni.
A fő ötlet az, hogy nem szabad egyetlen célt kiválasztani és elkezdeni azt hangolni, például a memóriát, a CPU-t vagy hasonlókat, hanem elemezni kell a munkaterhelést, és megpróbálni a lehető legjobban javítani a teljesítményen, hogy a adatbázisunkon keresztül a lehető leghatékonyabban haladjon át az a terhelés, amit a jó programozóink nekünk létrehoztak, beleértve a felhasználóinkat is.
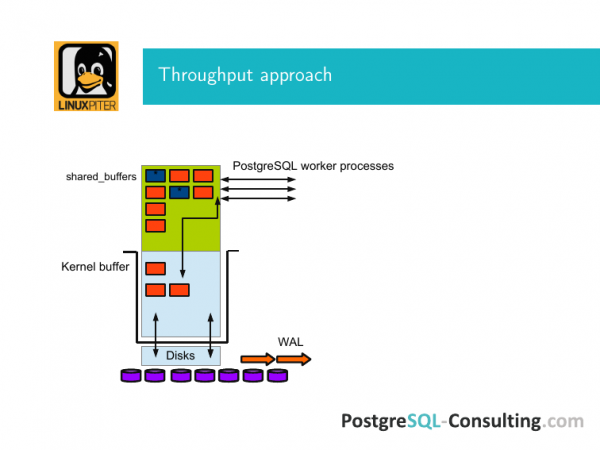
Itt van egy kép, amely magyarázatot ad arra, hogy mi ez. Van egy Linux operációs rendszerű buffer, van megosztott memória és van megosztott buffer a PostgreSQL-ben. A PostgreSQL, ellentétben az Oracle-lal, közvetlenül csak a kernel bufferen keresztül működik, tehát ahhoz, hogy egy oldal a lemezről bekerüljön a megosztott memóriájába, át kell kerülnie a kernel bufferen, és ugyanígy vissza.
E rendszer alatt találhatóak a lemezek. Én ezt úgy ábrázoltam, mint lemezek. Valójában ott lehet RAID vezérlő stb.
És ez a bemenet-kimenet valamilyen módon ezen keresztül történik.
A PostgreSQL egy klasszikus adatbázis. Ott belül oldalak találhatóak. És minden bemenet-kimenet az oldalakon keresztül történik. Az oldalakat emeljük be a memóriába. Ha semmi nem történt, csak olvastuk őket, akkor fokozatosan elmerülnek a cache-ben, a megosztott bufferekből, és visszakerülnek a lemezre.
Ha valahol cseréltünk valamit, akkor az egész oldalunk piszkosnak minősül. Én ezeket itt kék színnel jelöltem. És ez azt jelenti, hogy ezt az oldalt szinkronizálni kell a blokktárolóval. Tehát amikor piszkosra csináltuk, írtunk a WAL-be. És valamikor elérkezett egy pillanat, amelyet checkpoint-nak hívunk. És ebbe a naplóba bekerült az információ arról, hogy ez megtörtént. És ez azt jelenti, hogy minden piszkos oldal, ami abban a pillanatban volt a megosztott bufferekben, szinkronizálódott a tárolólemezre az fsync-en keresztül a kernel buffer segítségével.
Mire is van ez szükség? Ha megszűnik az áramellátás, akkor nem kapunk olyan helyzetet, hogy minden adat elveszett. A tartós memória, amiről nekünk beszéltek, egyelőre az adatbázisok elméletében – ez a fényes jövő, amely felé törekszünk és amely nekünk tetszik, de egyelőre még 20 évnyi hátrányban élnek. És természetesen mindezt figyelni kell.
A maximális átbocsátási kapacitás maximalizálásának feladata az, hogy minden egyes lépést úgy hangoljunk be, hogy ez mind gyorsan menjen ide-oda. A megosztott memória főleg az oldal cache. A PostgreSQL-ben küldtünk egy select lekérdezést, ami ott van, az adatokat kiolvastuk a lemezről. Ezek bekerültek a megosztott bufferekbe. Ennek megfelelően, hogy ez jobban működjön, sok memóriának kell lennie.
Ahhoz, hogy minden jól és gyorsan működjön, helyesen kell beállítania az operációs rendszert minden lépésben. És kiegyensúlyozott hardvert kell választania, mert ha valahol egyensúlyhiány van, akkor lehet, hogy nagyon sok memóriája lesz, de az nem megfelelő sebességgel fog működni.
És áttekintjük ezeket a pontokat.
Ahhoz, hogy ezek az oldalak gyorsabban utazhassanak oda-vissza, a következőket kell elérni:
- Először is, hatékonyabban kell dolgozni a memóriával.
- Másodszor, ennek a váltásnak is hatékonyabbnak kell lennie, amikor az oldalak a memóriából a lemezre kerülnek.
- Harmadszor, jó lemezekre van szükség.
Ha 512 GB RAM-ja van a(z) szerveren és mindez végül egy SATA merevlemezre érkezik, mindenféle cache nélkül, akkor az egész adatbázis szerver nemcsak úgy néz ki, mint egy tök, hanem egy SATA interfészes tök lesz. Közvetlenül tapasztalni fogja ezt. És semmi sem mentheti meg önt.
A memóriával kapcsolatos első ponttal kapcsolatban három dolog van, ami nagyon megnehezítheti az életet.
Az első a NUMA. A NUMA egy olyan dolog, amelyet a teljesítmény javítása érdekében hoztak létre. A workload függvényében különböző dolgokat lehet optimalizálni. Jelenlegi formájában nem túl kedvező azokhoz az alkalmazásokhoz, mint például a nagy mértékben page cache-t használó adatbázisok.
Két szóban. Hogyan értsük meg, hogy a NUMA-val valami nincs rendben? Valamilyen kellemetlen zajt hall, hirtelen egyik CPU túlterheltnek bizonyul. Eközben elemzi a kérdéseket a PostgreSQL-ben, és látja, hogy ott semmi hasonló nincs. Ezeknek a kérdéseknek nem szabad ennyire intenzíven CPU-t fogyasztaniuk. Ezt sokáig lehet figyelni. Jobb az elejétől fogva a megfelelő ajánlást követni, hogy hogyan kell beállítani a NUMA-t a PostgreSQL-hez.
Mi is történik valójában? A NUMA – Non-Uniform Memory Access. Mi az értelme? Van egy CPU-ja, mellette helyileg lévő memóriával. És ez a memória interconnects más CPU-k memóriáját is lehívhatja.
Ha futtatja a(z) numactl --hardware, akkor egy nagy leírás fog megjelenni. Többek között ott lesz egy distances mező. Lesznek számok – 10-20, valami ilyesmi. Ezek a számok nem mások, mint a távoli memória eléréséhez szükséges hopszámok, hogy azt helyben használhassa. Alapvetően jó ötlet. Ez jelentősen javítja a teljesítményt bizonyos terhelések során.
Most képzelje el, hogy van egy CPU, amely először megpróbálja használni a helyi memóriáját, majd próbál más memóriát behúzni interconnecten keresztül valamihez. És erre a CPU-ra jut el az összes page cache PostgreSQL – mind, ami ott van, néhány gigabyte. Mindig a legrosszabb esetet kapja, mert a CPU-n közvetlenül ezen a memóriamodulon általában kevés memória van. És minden memória, ami szolgáltatva van, ezeken az interconnecteken keresztül megy. Ez lassú és szomorú helyzet. És a processzor, amely ezt a csomópontot kezeli, folyamatosan túlterhelt. És a memória hozzáférési ideje – rossz, lassú. Ez az a helyzet, amit nem szeretne, ha adatbázisként használja ezt az egészet.
Ezért a megfelelőbb megoldás, hogy az operációs rendszer Linux egyáltalán ne tudja, hogy mi történik odabent. Hogy úgy hivatkozzon a memóriára, ahogy szeretne.
Miért van ez így? Úgy tűnne, hogy ennek éppen ellenkezőleg kellene lennie. Ennek egy egyszerű oka van, hogy sok memóriára van szükségünk a page cache-hez – tíz-, száz gigabyte.
És ha mindezt kiemeltük és megcachingoltuk az adatainkat ott, akkor a cache használatából származó nyereség jelentősen nagyobb lesz, mint a memória ilyen okos kezelése. Így tehát nem összehasonlítható nyereséget érünk el azzal, hogy hatékonyabban bánunk a memóriával NUMA használatával.
Ezért két megközelítés van itt jelenleg, amíg a világos jövő el nem érkezik, és az adatbázis nem képes önállóan megérteni, hogy melyik CPU-n fut és honnan kellene valamit behúznia.
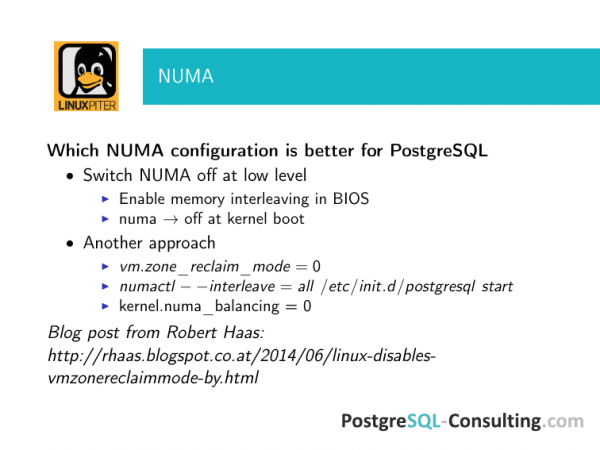
Ezért a helyes megközelítés az, hogy teljesen letiltjuk a NUMA-t, például újraindításkor. A legtöbb esetben a nyereségek olyan rendkívüliek, hogy fel sem merül a kérdés, mi a jobb.
Van egy másik lehetőség. Ezt gyakrabban használjuk, mint az elsőt, mert amikor ügyfél érkezik a támogatásra, az számára a szerver újraindítása hatalmas dolog. Ott az üzlete működik. A NUMA-val kapcsolatos problémákba ütköznek. Ezért igyekszünk kevésbé invazív módon letiltani, mint az újraindítás, de itt figyelmesen ellenőrizze, hogy valóban letiltódott. Mert a tapasztalatok azt mutatják, hogy a PostgreSQL szülőprocessz számára a NUMA letiltása jó, de egyáltalán nem biztos, hogy ez működni fog. Ellenőrizni és figyelni kell, hogy valóban letiltódott.
Van egy jó poszt Robert Haasról. Ő az egyik PostgreSQL fejlesztője. Az alapvető szoftverelemek egyik kulcsfejlesztője. Ha átnézzük ennek a posztnak a linkjeit, több színes történet is olvasható arról, hogy a NUMA hogyan nehezítette meg az emberek életét. Nézze meg, tanulmányozza a rendszergazdák számára készült ellenőrzőlistát, amely tartalmazza a szerveren beállítandó dolgokat, hogy az adatbázisunk jól működjön. Ezeket a beállításokat meg kell jegyezni és ellenőrizni, mert különben nem fogják jól végezni a dolgukat.
Felhívom a figyelmet, hogy ez minden beállítást érint, amiről beszélni fogok. De általában az adatbázisokat master-slave módban állítják össze a magas rendelkezésre állás érdekében. Ne felejtse el ezeket a beállításokat a slave-re is átvinni, mert egy szép napon baleset történhet, és át kell kapcsolnia a slave-re, ami ezután masterré válik.
Baleseti helyzetben, amikor minden nagyon rosszul megy, a telefon folyamatosan csörög, és a főnök nagy bottal rohan be, nem lesz ideje gondolkodni az ellenőrzésről. Az eredmények nagyon szomorúak lehetnek.
A következő pont a huge pages. A huge pages külön tesztelése nehézkes, és nincs is sok értelme, bár vannak benchmarkok, amelyek képesek erre. Ezek könnyen fellelhetők.
Mi az értelme? Van egy nem túl drága szervere, amelynek sok a RAM-ja, például több mint 30 GB. A huge pages nincs használatban. Ez azt jelenti, hogy egyértelműen van overhead a memóriahasználatban. És ez az overhead nem éppen kellemes.
Miért van ez így? Mi történik? Az operációs rendszer apró darabokban osztja ki a memóriát. Ez kényelmes, így alakult ki történelmileg. Ha belemerülünk a részletekbe, az operációs rendszernek le kell fordítania a virtuális címeket fizikai címekre. Ez a folyamat nem a legegyszerűbb, ezért az operációs rendszer a művelet eredményét a Translation Lookaside Buffer (TLB) tárolja.
Mivel a TLB egy cache, ebben a helyzetben minden olyan probléma felmerül, amely a cache-re jellemző. Először is, ha nagyon sok RAM-je van, és mindegyik kicsi darabokban van kiosztva, a buffer nagyon nagy lesz. Ha a cache nagy, akkor nehezebb benne keresni. Az overhead jelentős, és önállóan is foglal helyet, azaz a RAM nem megfelelően használt részeit fogyasztja. Ez az első dolog.
Kettő – minél nagyobb a gyorsítótár ilyen helyzetben, annál valószínűbb, hogy cache hiányok fognak előfordulni. A gyorsítótár hatékonysága gyorsan csökken a méretének növekedésével. Ezért az operációs rendszerekben kitaláltak egy egyszerű megközelítést. A Linuxban ezt régóta használják. A FreeBSD-ben nemrégiben került bevezetésre. De mi a Linuxról beszélünk. Ez a huge pages.
Itt meg kell jegyezni, hogy a huge pages, mint ötlet, eredetileg olyan közösségek által került előtérbe, mint az Oracle és az IBM, tehát az adatbázis-gyártók nagyban gondolkodtak azon, hogy ez hasznos lesz, többek között az adatbázisok számára is.
Hogyan kapcsoljuk ezt össze a PostgreSQL-lel? Először is, a Linux kernelben engedélyezve kell, hogy legyenek a huge pages.
Másodszor, ezeknek egyértelműen meg kell lennie adva a sysctl paraméter révén – mennyi van belőlük. A számok egy régi szerverből származnak. Meg tudja becsülni, mennyit használt sharied buffers-ból, hogy a huge pages beleférjenek.
Ha az egész szerver át van adva a PostgreSQL-nek, akkor egy jó kiindulási pont lehet, hogy a RAM 25%-át a shared buffer-eknek adja, vagy 75%-ot, ha biztos benne, hogy ebbe a 75%-ba az adatbázisa pontosan belefér. Ez az első kiindulási pont. És számolja ki, ha 256 GB RAM-ja van, akkor megfelelően 64 GB-ot fog kapni shared buffer-ekből. Számolja ki egy kicsit tartalékkal - mennyire kell ezt a számot beállítani.
A 9.2-es verzió előtt (ha nem tévedek, a 8.2-es verziótól kezdve) egy külső könyvtárral összeférhetővé lehetett tenni a PostgreSQL-t a huge pages-szel. Ezt mindig el kell végezni. Először is, a kernelnek megfelelően kell tudnia kiosztani a huge pages-t. Másodszor, az alkalmazásnak, amelyikkel ezeket használják,képesnek kell lennie rendelkeznie velük. Csak úgy nem fog tudni élni velük. Mivel a PostgreSQL a system 5 stílusában osztotta el a memóriát, ezt a libhugetlbfs segítségével lehetett megoldani – ez a könyvtár teljes neve.
A 9.3-ban javították a PostgreSQL teljesítményét a memóriakezelés terén, és elhagyták az 5-ös rendszer memóriatallózási módszerét. Mindenki nagyon örült, mert különben, ha megpróbálnád futtatni a két PostgreSQL példányt egy gépen, azt mondaná, hogy nincs elég megosztott memóriám. És azt mondja, javítani kell a sysctl-t. És ott olyan sysctl van, hogy még újra kell indítani meg bla-bla. Szóval mindenki örült. De a mmap memóriaallokáció megbicsaklotta a nagy oldalak használatát. Ügyfeleink többsége nagy megosztott puffereket használ. és határozottan javasoltuk, hogy ne váltsanak 9.3-ra, mert ott a túlfejlesztés jó százalékos arányban kezdett megjelenni.
De a közösség felhívta erre a problémára a figyelmet, és a 9.4-ben nagyon jól átdolgozták ezt a folyamatot. A 9.4-ben megjelent egy új paraméter a postgresql.conf fájlban, amivel bekapcsolhatod a try-t, on-t vagy off-ot.
A try a legbiztonságosabb paraméter. PostgreSQL indításakor, amikor a megosztott memóriát címzi, próbálja megszerezni az ebből a nagy oldalakból való memóriát. És ha nem sikerül, akkor visszavált a normál allokációra. Ha FreeBSD vagy Solaris van, akkor beállíthatod a try-t, ez mindig biztonságos.
Ha on, akkor csak nem indul el, ha nem tudta megszerezni a nagy oldalakból. Ez már – kinek mi a szívéhez közel áll. De ha try van beállítva, ellenőrizd, hogy valóban azt kaptad, aminek kell, mert ott sok a hibázási lehetőség. Jelenleg ez a funkció csak Linuxon működik.
Még egy kis megjegyzés, mielőtt továbbmennénk. A transparent huge pages nem a PostgreSQL-ról szól ezidáig. Nem tud a normális módon élni velük. ÉS a transparent huge pages mellett, amikor nagy megosztott memóriára van szükség, az előnyök csak nagyon nagy mennyiségek esetén jelennek meg. Ha terabájt memória van nálad, akkor ez számíthat. Ha hétköznapi alkalmazásokról beszélünk, amikor 32, 64, 128, 256 GB memória van a gépen, akkor a sima nagy oldalak rendben vannak, a transparentet pedig csak kikapcsoljuk.
És az utolsó dolog a memóriával kapcsolatban, közvetlenül nem kapcsolódik a throughput-hoz; nagyon meg tudja nehezíteni az életedet. Az egész áteresztőképesség nagyon megsínyli, ha a szerver folyamatosan swap-el.
Ez elég kellemetlen lesz számos szempontból. A fő probléma pedig abban rejlik, hogy a modern magok viselkedése kissé eltér a régebbi Linux magoktól. Ez egy olyan dolog, ami meglehetősen kellemetlen, mert amikor a swap használatáról beszélünk, az OOM-killer érkezése nem időben történik. Az OOM-killer, ami nem érkezett időben és leállította a PostgreSQL-t, nem éppen kellemes. Erről mindenki tudni fog, tehát az utolsó felhasználóig mindenki értesül róla.
Mi történik? Sok RAM van, minden jól működik. De valamiért a szerver a swap-ban leáll és ez lassítja a működését. Úgy tűnik, hogy sok memória van, de ez mégis megtörténik.
Korábban azt javasoltuk, hogy állítsuk a vm.swappiness-t nullára, azaz kapcsoljuk ki a swap-ot. Korábban úgy tűnt, hogy a 32 GB RAM és a megfelelő megosztott pufferek hatalmas mennyiség. A swap alapvető célja, hogy legyen egy hely, ahová el lehet dobni egy kernel leállásakor a memóriát. Ez azonban már nem igazán teljesítette a funkcióját. A kérdés az, hogy mit kezdjünk ezzel a kernellel? Már nem világos, hogy valójában miért van szükség swap-ra, főleg ilyen méretben.
De a modernebb, azaz harmadik verziós magok esetében a viselkedés megváltozott. Ha a swap-ot nullára állítod, azaz kikapcsolod, akkor előbb vagy utóbb, még ha van is némi RAM a rendszerben, megérkezik az OOM-killer, hogy megölje a legintenzívebb erőforrás-használókat. Mert úgy fogja számítani, hogy ilyen terhelés mellett még maradt egy kis memória és ki fogunk ugrani, tehát nem a rendszerfolyamatot öli meg, hanem valami kevésbé fontosat. Ez a kevésbé fontos felhasználó általában a megosztott memória intenzív fogyasztója, nevezetesen a postmaster. Ezután már örülni lehet, ha nem kell visszaállítani az adatbázist.
Ezért most az alapértelmezett beállítás, amennyire emlékszem, a legtöbb disztribúcióban körülbelül 6, azaz hogy mikor kezdjük el használni a swap-ot a megmaradt memória függvényében. Jelenleg azt javasoljuk, hogy állítsuk a vm.swappiness-t 1-re, mert ez gyakorlatilag kikapcsolja, de nem okoz olyan hatásokat, mint az váratlanul érkező OOM-killer és az összes többi dolog leállítása.
Mi a következő lépés? Amikor az adatbázisok teljesítményéről beszélünk, és fokozatosan elérkezünk a lemezekhez, mindenki a fejét fogja. Az igazság az, hogy a lemez lassú, míg a memória gyors, mindenkinek ismerős. Mindenki tudja, hogy az adatbázisokban problémák merülnek fel a lemezes teljesítménnyel.
A PostgreSQL teljesítménye szempontjából a fő probléma a checkpointok csúcsainál nem a lemez lassúságából adódik. Inkább abból, hogy a memória és a lemez kapacitása nincs egyensúlyban. Ez különböző helyeken előfordulhat. A PostgreSQL nem megfelelően van beállítva, az operációs rendszer nincs megfelelően konfigurálva, a hardver nem megfelelő, és a hardver is rosszul van kiválasztva. Ez a probléma csak akkor nem merül fel, ha minden úgy történik, ahogy kell: vagy nincs terhelés, vagy a beállítások és a hardver jól vannak kiválasztva.
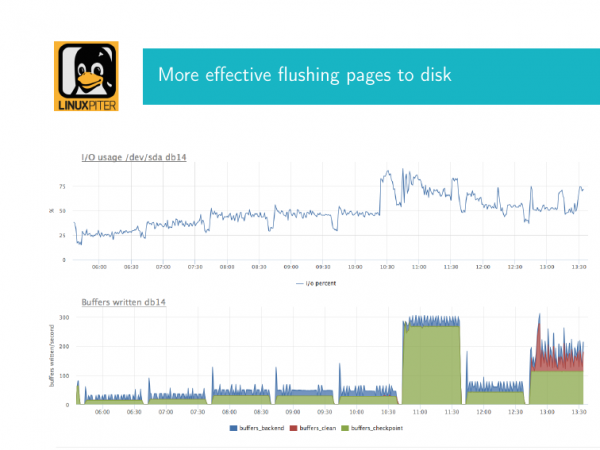
Mi ez és hogyan néz ki? Általában akik PostgreSQL-lel dolgoznak, többször is belefutnak ebbe. Megmagyarázom. Ahogy már említettem, a PostgreSQL időnként végrehajtja a checkpointokat, hogy a megosztott memóriában lévő szennyezett lapokat lementse a lemezre. Ha nagy mennyiségű megosztott memóriánk van, akkor a checkpoint intenzíven hat a lemezre, mert a lapokat fsync segítségével írja le. Ezek a kernel pufferbe érkeznek, és az fsync segítségével íródnak a lemezekre. Ha ennek a mennyisége nagy, akkor kellemetlen hatást tapasztalhatunk, nevezetesen, hogy a lemezek kihasználtsága nagyon magas.
Itt van két képem. Most megmagyarázom, mit jelent ez. Ezek időben korrelált grafikonok. Az első grafikon a lemez kihasználtságát mutatja. Itt majdnem 90%-ra emelkedik ebben az időpontban. Ha az adatbázisa fizikailag lemezekkel rendelkezik, és a RAID-vezérlő lemez kihasználtsága 90% körül van, akkor rossz hírek vannak. Ez azt jelenti, hogy hamarosan elérjük a 100%-ot, és a bemenet-kimenet megáll.
Ha van lemezmeghajtó-rendszere, akkor ott egy kicsit más történet van. Ez attól függ, hogyan van beállítva, milyen rendszer és így tovább.
Egy párhuzamos grafikon van konfigurálva a belső Postgres nézetből, amely megmutatja, hogyan zajlik a checkpoint. Zöld színnel van feltüntetve, hogy az adott checkpoint során mennyi buffer, azaz piszkos oldal érkezett a szinkronizációhoz. Ez a legfontosabb, amit tudni érdemes. Látjuk, hogy sok oldal érkezett, és egy ponton elértük a határt, azaz írtunk-írtunk, a lemezes rendszer nyilvánvalóan nagyon elfoglalt volt. A checkpoint jelentősen hat a lemezre. Ideális esetben a helyzet inkább így nézne ki, azaz kevesebb írás történt volna. A beállításainkkal ezt megjavíthatjuk, hogy a jövőben így legyen. Azaz az kihasználás alacsony, de valahol írunk.
Mit kell tenni a probléma megoldásához? Ha leállt az IO az adatbázis alatt, akkor ez azt jelenti, hogy minden felhasználónak, aki végrehajtja a lekérdezéseit, várakoznia kell.
Ha a Linux szempontjából vizsgáljuk, ha jó hardvert választott, helyesen állította be, és normálisan konfigurálta a PostgreSQL-t, hogy ritkábban végezzen checkpointokat, és azokat szétszórja az időben, akkor a Debian alapértelmezett paramétereivel találkozik. A legtöbb Linux disztribúció esetében ez a kép: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Mit jelent ez? A 2.6 verziótól kezdve megjelent egy démon, amely a törlésért felelős. A Pdglush, attól függően, hogy ki mit használ, amely a piszkos oldalak háttérből történő törlésével foglalkozik, és akkor törli, amikor már mindenáron törölni kell a piszkos oldalakat, amikor a háttérben történő törlés már nem segít.
Mikor lép életbe a háttér? Amikor a szerver teljes memóriájának 10%-a piszkos oldalakkal van elfoglalva a kernel bufferben, akkor egy speciális háttérbeli törlési funkció lép működésbe. Miért háttérbeli? Mert paraméterként meghatározza, hogy hány oldalt kell törölni. Például N oldalt töröl, majd egy időre alszik. Aztán újra megjelenik és töröl még néhány oldalt.
Ez egy rendkívül egyszerű történet. Olyan ez, mint egy medencével, ahol az egyik csőből folyik be a víz, a másik csőből pedig távozik. A checkpoint megérkezett, és ha csak kevés piszkos oldalt küldött el törlésre, akkor fokozatosan a kernel bufferből a pgflush ügyesen elszivárog belőle.
Ha ezek a piszkos oldalak továbbra is felhalmozódnak, akkor elérhetik a 20%-ot, és ekkor az operációs rendszer prioritása az, hogy a lemezekre írja ezeket, mert ha megszakad az áramellátás, minden rosszul fog végződni. Ezen adatok elveszteségéről van szó, például.
Mi a trükk? A trükk abban rejlik, hogy ezek a paraméterek a mai világban 20 és 10 % az egész gép memória mennyiségéből, teljes mértékben megdöbbentő a bármely tárolórendszer átviteli kapacitása szempontjából.
Képzelje el, hogy 128 GB RAM-ja van. 12,8 GB jut el a tárolórendszeréhez. És bármilyen gyorsítótár is van ott, bármilyen tömb, nem fogják elviselni azt az mennyiséget.
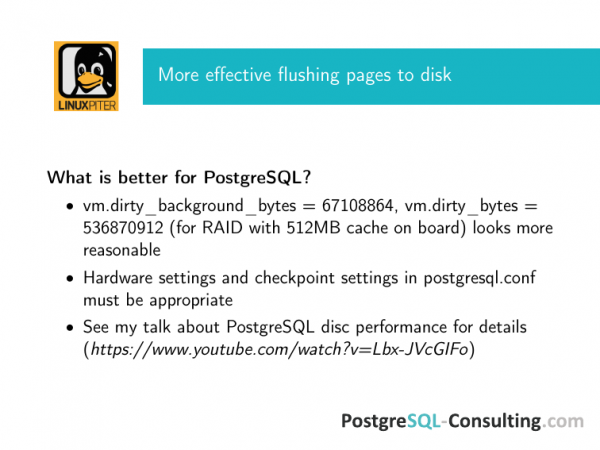
Ezért mi azt ajánljuk, hogy ezek a számok az ön RAID vezérlőjének lehetőségei szerint legyenek beállítva. Itt rögtön egy ajánlásom van egy olyan vezérlőhöz, amelynél 512 MB a gyorsítótár.
Mindez nagyon egyszerűen számítható. A vm.dirty_background-ot byte-ban lehet beállítani. Ezek a beállítások felülírják az előző kettőt. Vagy alapértelmezett arány, vagy azok, amelyek byte-ban vannak, ha aktívak, akkor csak azok fognak működni. De mivel én DBA tanácsadó vagyok és különféle ügyfelekkel dolgozom, próbálok elővigyázatos lenni, és ezért, ha byte-ban, akkor csak byte-ban. Senki nem garantálta, hogy egy kedves admin nem ad hozzá memóriát a szerverhez, nem indítja újra, és a szám ugyanaz marad. Csak ezeket a számokat úgy kalkulálja, hogy biztos legyen benne, hogy minden belefér.
Mi történik, ha nem fér bele? Írtam, hogy bármely flushing hatékonyan megáll, de valójában ez egy közhely. Az operációs rendszernek nagy problémája van – sok piszkos oldala van, ezért hatékonyan az ügyfelei által generált IO áll meg, tehát amikor egy sql lekérdezést küld az alkalmazás, várakozik. Bármilyen bemenet-kimenet e felé – a legnagyobb prioritással, mert az adatbázis foglalt checkpointokkal. És hogy mikor fejezi be, az teljesen bizonytalan. És amikor elérte a nem háttér, nem háttér flushing-ot, ami azt jelenti, hogy minden IO ezzel van elfoglalva. És amíg be nem fejeződik, nem tud semmit csinálni.
Itt van még két fontos szempont, amelyek túllépnek ezen a jelentésen. Ezeknek a beállításoknak meg kell felelniük a postgresql.conf beállításainak, tehát a checkpointok beállításainak. És a tárolórendszere megfelelően legyen beállítva. Ha RAID cache van, akkor ahhoz akkumulátor is kell. Az emberek akkumulátor nélküli, jó cache-el rendelkező RAID-et vásárolnak. Ha SSD van RAID-ben, akkor azokat szerver SSD-ként kell használni, és kondenzátorokkal kell rendelkezniük. Itt egy részletes ellenőrzőlista található. Ezen a linken van a jelentésem arról, hogyan kell beállítani a PostgreSQL lemez teljesítményét. Az összes ellenőrzőlista ott található.
Mi az, ami még jobban megnehezítheti az életet? Két viszonylag új paraméter. Ezek különböző alkalmazásokban alapértelmezés szerint be vannak kapcsolva. Ha helytelenül vannak beállítva, akkor legalább annyira megnehezíthetik az életet.
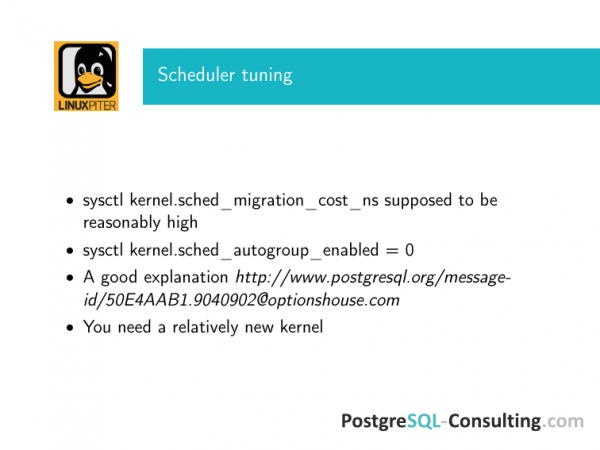
Két viszonylag új dolog van. Ezek már a harmadik kernelben megjelentek. Ezek a sched_migration_cost nano- másodpercben és a sched_autogroup_enabled, ami alapértelmezés szerint 1.
És hogyan rontják el az életet? Mi az a sched_migration_cost? A Linux ütemező képes a folyamatokat egyik CPU-ról a másikra migrálni. A PostgreSQL, amely végrehajtja a lekérdezéseket, számára a másik CPU-ra való migráció teljesen érthetetlen. Egy adatbázis számára ez nagyon rossz. Ezért ésszerű politikának tekinthető, hogy a migration_cost-ot egy nagy értékre állítjuk, legalább néhány ezer nano- másodpercre.
Mit jelent ez az ütemező számára? Azt fogja számítani, hogy ez idő alatt ez a folyamat még mindig aktív. Tehát, ha van egy hosszú tranzakció, amely valami hosszú ideig tart, az ütemező ezt meg fogja érteni. Azt fogja hinni, hogy amíg ez az időtartam le nem jár, addig ezt a folyamatot nem szükséges migrálni. Ha a folyamat közben valamit csinál, akkor nem fog migrálni, nyugodtan befejezi a munkáját azon a CPU-n, amelyet kijelöltek neki. Az eredmény pedig kiváló.
A másik pont az autogroup. Van egy jó ötlet specifikus munkaterhelésekhez, amelyek nem vonatkoznak a modern adatbázisokra – a folyamatok csoportosítása aszerint, hogy melyik virtuális terminálról indították őket. Ez hasznos bizonyos feladatokhoz. Gyakorlatilag a PostgreSQL egy többprocesszoros rendszer preforkkal, amely egy terminálból indul. Önnek van egy lock writer, checkpoint, és minden kliens kérés egy ütemezőre, egy CPU-ra csoportosul. Ott fognak barátságosan várakozni, amíg felszabadul, hogy akadályozzák egymást, és hogy tovább foglalják azt. Ez a történet teljesen felesleges ilyen terhelés esetén, ezért ezt ki kell kapcsolni.
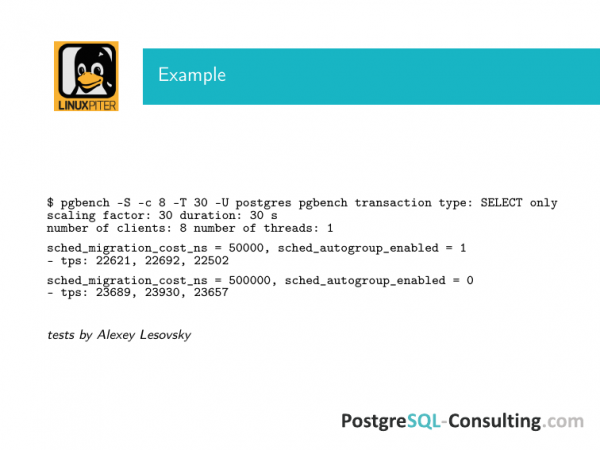
A kollégám, Alekszej Leszovszkij, tesztelt egy egyszerű pgbench-t, ahol tízszeresére növelte a migration_cost-ot és kikapcsolta az autogroupot. A gyenge hardveren a különbség közel 10% volt.. Van egy megbeszélés a PostgreSQL levelezőlistáján, ahol az emberek bemutatják az eredményeket, hogy ilyen módosítások hogyan befolyásolták a lekérdezés sebességét. 50%-kal.. Ilyen történetekből elég sok van.
Végül a teljesítménymegtakarítási politikáról. Jó, hogy most a Linux használható laptopon. Azt mondják, jól fogja fogyasztani az akkut. De váratlanul kiderül, hogy ez a szerveren is előfordulhat.
Sőt, ha bérel szervereket egy hostingtól, akkor a „kedves” hosztoló cégek, nem törődnek azzal, hogy jobb teljesítménye legyen. Az ő feladatuk, hogy a hardverük maximálisan hatékonyan hasznosuljon. Ezért alapértelmezés szerint bekapcsolhatják az energia megtakarító módot az operációs rendszerben.
Ha olyan szervert használ, amelynek intenzív terhelése van az adatbázissal, akkor a választása az acpi_cpufreq + performance. Még az ondemand is már problémákat okoz.
Az Intel_pstate már egy kicsit másik meghajtó. Jelenleg ezt részesítik előnyben, mivel újabb és jobban működik.
Így a governor csak teljesítmény. Az ondemand, powersave és minden egyéb – nem önnek való.
Az explain analyze PostgreSQL eredményei néhány nagyságrenddel eltérhetnek, ha bekapcsolja a powersave-t, mert a CPU teljesen kiszámíthatatlan módon ütemeződik az adatbázis alatt.
Ezek a dolgok alapértelmezés szerint be lehetnek kapcsolva. Figyelmesen nézze meg – nem kapcsolták-e be alapértelmezettként. Ez valóban nagy probléma lehet.
A végén szeretném megköszönni a DBA csapatunknak, a PosgreSQL-Consultingnak, különösen Makszim Boguknak és Alekszej Leszovszkijnak, akik nap mint nap tapasztalatokat szereznek ezen a területen. Az ügyfeleink számára igyekszünk mindent megtenni, hogy a lehető legjobban működjön számukra. Ez olyan, mint a légi közlekedés biztonsági előírásai. Minden le van írva a legrosszabb tapasztalatok alapján. Minden egyes csavar egy problémás eset során került elő. Örömmel osztom meg ezeket veletek.
Kérdések:
Köszönöm! Ha például egy cég szeretne megtakarítani és egy szerveren helyezné el az adatbázist és az alkalmazás logikát, vagy ha a cég a mikroszolgáltatás-architektúrák divatos tendenciáját követi, ahol a PostgreSQL konténerben fut. Mi az ötlet? A sysctl globálisan hat minden magra. Nem hallottam arról, hogy a sysctl virtualizálva lenne, hogy külön-külön működjön a konténeren belül. Csak cgroup van, és ott csak részleges ellenőrzés van. Hogyan élhetünk ezzel? Vagy ha teljesítményre vágyik, akkor futtassa a PostgreSQL-t egy külön fizikai szerveren és optimalizálja azt?
Háromféleképpen válaszoltunk a kérdésére. Ha nem egy olyan fizikai szerverről van szó, amelyet optimalizálni lehet, akkor nyugodjon meg, ezek a beállítások nélküli működés is jól fog alakulni. Ha olyan terhelés adódik, amely megköveteli ezeket a beállításokat, akkor hamarabb eljut egy fizikai szerverhez, mint ezekhez a beállításokhoz.
Mi a probléma? Ha ez egy virtuális gép, akkor valószínűleg sok problémája lesz, például a legtöbb virtuális gép általában inkonzisztens lemezkéslekedéssel küzd. Még ha a lemezátvitel jó is, egy hibás bevitel-kimenet tranzakció, amely nem sokat befolyásol az átlagos átvitel sebességén, erősen megviselheti az adatbázist, különösen egy checkpoint vagy WAL írás közben. Ezt észre fogja venni, mielőtt még belefutna a problémákba.
Ha az NGINX ugyanazon a szerveren fut, akkor ugyanez a probléma fogja érni. Harcolni fog a közös memóriáért. És nem fog eljutni azokhoz a problémákhoz, amelyeket itt leírtunk.
De a másik oldalról nézve, ezek közül néhány paraméter így is releváns lesz számodra. Például a sysctl segítségével állítsd be a dirty_ratio-t, hogy ne legyen olyan eszeveszett – ez minden esetben segít. Így vagy úgy, kapcsolatban leszel a lemezzel. És ez nem a megfelelő schéma szerint fog zajlani. Ezek egyáltalán nem az alapértelmezett paraméterek, amelyeket bemutattam. És egyébként ezeket jobb megváltoztatni.
A NUMA-val problémák merülhetnek fel. A VmWare például jól működik NUMA-val, pontosan ellenkező beállításokkal. Itt választani kell – fém szerver vagy nem fém szerver.
Kérdésem van az Amazon AWS-hez kapcsolódóan. Van ott előre beállított image. Az egyik Amazon RDS névre hallgat. Vannak ott valamilyen testreszabott beállítások az operációs rendszerükhöz?
Vannak beállítások, de ezek más beállítások. Itt az operációs rendszert úgy állítjuk be, ahogy az adatbázis használni fogja ezt az egész dolgot. Ott vannak paraméterek, amelyek meghatározzák, hová menjünk most, egyfajta shaping. Tehát annyi erőforrásra van szükségünk, és ezeket most ki fogjuk használni. Ezt követően az Amazon RDS ezekhez az erőforrásokhoz kapcsolódik, és ott a teljesítmény csökken. Vannak különböző történetek, ahogy az emberek elkezdik ezt manipulálni. Néha még sikeresen is. De ennek nincs köze az operációs rendszer beállításaihoz. Ez gyakorlatilag a felhő hackelése. Ez egy másik történet.
Miért nem hatékonyak a Transparent huge pages a Huge TLB-vel összehasonlítva?
Nem hatékonyak. Ezt sokféleképpen el lehet magyarázni. De a tény az, hogy egyszerűen nem adnak hatást. Mi a helyzet a PostgreSQL-lel? Induláskor nagy mennyiségű megosztott memóriát allokál. Az, hogy a Transparent vagy nem transparent – teljesen lényegtelen. Az a tény, hogy a kezdéskor allokálódnak, mindent megmagyaráz. Ha nagyon sok memória van és újra kell struktúrálni a shared_memory szegmenst, akkor a Transparent huge pages releváns lesz. A PostgreSQL esetében egyszerűen induláskor hatalmas részt allokál, és ennyi, nem történik ott semmi különös. Persze használható, de van esély arra, hogy megmarad a curruption shared_memory, amikor újraallokál valamit. A PostgreSQL viszont erről nem tud.
Forrás: habr.com
