

Hogyan érezné magát, ha egy szép nyári napon az adatközpont, ahol az ön berendezései találhatók, így nézne ki?
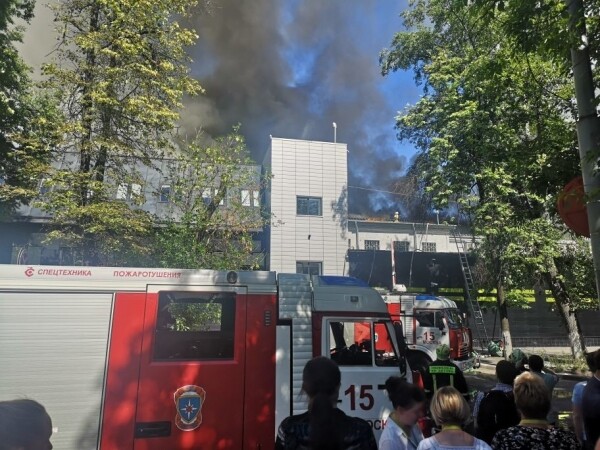
Helló mindenkinek! A nevem Dmitrij Samsonov, vezető rendszergazdaként dolgozom a "" cégnél. A fényképen az egyik négy adatközpontunk látható, ahol a projektünket szolgáló berendezések találhatók. Ezek mögött a falak mögött körülbelül 4000 különböző eszköz van: szerverek, adattároló rendszerek, hálózati berendezések stb. — majdnem a teljes berendezésünk egyharmada.
A szerverek többsége Linux-alapú. Van néhány tucat Windows szerverünk (MS SQL) is — ez a hagyatékunk, amelyről az évek során fokozatosan lemondunk.
Tehát 2019. június 5-én, 14:35-kor az egyik adatközpontunk mérnökei tűzriadót jelentettek.
Tagadás
14:45. A füsttel kapcsolatos kisebb incidensek az adatközpontokban gyakrabban fordulnak elő, mint gondolnánk. A termek belső mutatói normálisak voltak, ezért az első reakciónk viszonylag nyugodt volt: megtiltottuk a produkcióval kapcsolatos munkákat, azaz minden konfigurációs változást, új verziók kiadását stb., kivéve a javítással kapcsolatos munkákat.
Harag
Próbált már valaha tűzoltóktól megtudni, hogy pontosan hol történt a tűz a tetőn, vagy megpróbált felmenni a lángoló tetőre, hogy felmérje a helyzetet? Mekkora a bizalom az öt emberen keresztül megszerzett információban?
14:50. Információ érkezett, hogy a tűz közelít a hűtőrendszerhez. De eljut-e? A szolgálatban lévő rendszergazda külső forgalmat irányít az adatközpont frontjairól.
Jelenleg minden szolgáltatásunk frontját három adatközpontban tükrözzük, DNS szintű terheléselosztást használunk, ami lehetővé teszi, hogy egy adatközpont címét eltávolítsuk a DNS-ből, így megóvva a felhasználókat a potenciális problémáktól a szolgáltatások elérésében. Abban az esetben, ha az adatközpontban már történt probléma, automatikusan ki kerül a rotációból. További részleteket itt olvashat:
A tűz eddig ránk nézve semmilyen hatással nem volt — sem a felhasználók, sem a berendezések nem szenvedtek. Ez baleset? Az első szakasz a "Baleseti cselekvési terv" dokumentumban meghatározza a "baleset" fogalmát, és a szakasz így zárul:
«Ha kétségek merülnek fel, hogy baleset vagy sem, akkor ez baleset!»
14:53. Katasztrófa koordinátor kijelölése.
A koordinátor az a személy, aki figyelemmel kíséri a kommunikációt minden résztvevő között, értékeli a katasztrófa mértékét, alkalmazza a "Katasztrófa Akciótervet", bevonja a szükséges személyzetet, ellenőrzi a helyreállítás befejezését, és ami a legfontosabb, delegálja a feladatokat. Más szavakkal, ő az, aki irányítja a katasztrófa felszámolásának egész folyamatát.
Ajánlat
15:01. Elkezdjük kikapcsolni a szervereket, amelyek nincsenek összekapcsolva a produkcióval.
15:03. Helyesen kapcsoljuk ki az összes fenntartott szolgáltatást.
Ide tartoznak nemcsak a frontok (amelyekre a felhasználók már nem látogatnak el ekkor) és azok kiegészítő szolgáltatásai (üzleti logika, cache-ek stb.), hanem a különböző adatbázisok is, amelyek replikációs faktora 2 vagy több (, , , stb.).
15:06. Információ érkezett, hogy tűz fenyeget egy adatközpont egyik termét. Ebben a teremben nincs felszerelésünk, de az, hogy a tűz átterjedhet a tetőről a termekre, jelentősen megváltoztatja a helyzetet.
(Később kiderült, hogy fizikai fenyegetés nem volt a teremben, mivel az hermetikusan el van szigetelve a tetőtől. A fenyegetés csak a terem hűtőrendszerére vonatkozott.)
15:07. Engedélyezzük a parancsok végrehajtását a szervereken gyorsított ütemben, további ellenőrzések nélkül ().
15:08. A terem hőmérséklete normál határokon belül van.
15:12. Hőmérséklet-emelkedés észlelve a termekben.
15:13. Az adatközpontban lévő szerverek több mint fele ki van kapcsolva. Folytatjuk.
15:16. Döntés született az összes felszerelés kikapcsolásáról.
15:21. Elkezdjük az áramellátást kikapcsolni a stateless szervereken, az alkalmazás és az operációs rendszer megfelelő leállítása nélkül.
15:23. Csoportot jelölünk ki az MS SQL feladatokért (kevés van belőlük, a szolgáltatásoktól való függőségük nem nagy, de a működőképesség helyreállítási folyamata hosszabb időt vesz igénybe, és bonyolultabb, mint például a Cassandra esetében).
Depresszió
15:25. Információ érkezett négy terem áramellátásának kikapcsolásáról a 16-ból (6, 7, 8, 9 számú). A 7-es és 8-as termekben a mi felszerelésünk található. Még két termünkről (1-es és 3-as számú) nincs információnk.
Ritkán, amikor tűzesetek vannak, az áramellátást azonnal kikapcsolják, de ebben az esetben, a tűzoltók és az adatközpont technikai személyzetének koordinált munkájának köszönhetően, nem mindenhol és nem azonnal, hanem szükség szerint kapcsolták ki.
(Később kiderült, hogy a 8-as és 9-es termek áramellátása nem lett lekapcsolva.)
15:28. Kezdjük el a MS SQL adatbázisok helyreállítását más adatközpontokból készült biztonsági mentésekből.
Mennyi időt fog ez igénybe venni? Elég lesz a sávszélesség az egész útvonalon?
15:37. Néhány hálózati szakasz lekapcsolásra került.
A menedzsment és a produkciós hálózat fizikailag elszigetelt egymástól. Ha a produkciós hálózat elérhető, akkor be tud lépni a szerverre, le tudja állítani az alkalmazást és kikapcsolhatja az operációs rendszert. Ha ez nem elérhető, akkor az IPMI-én keresztül be tud lépni, le tudja állítani az alkalmazást és kikapcsolhatja az OS-t. Ha egyik hálózat sincs elérhető, akkor semmit sem tud tenni. „Köszönöm, kapitány!”, - gondolhatja.
„És egyébként is, túl sok a zűrzavar”, - gondolhatja Ön is.
Az a helyzet, hogy a szerverek még tűz nélkül is hatalmas mennyiségű hőt termelnek. Pontosabban, amikor van hűtés, akkor hőt termelnek, amikor pedig nincs, akkor pokoli forróságot generálnak, ami a legjobb esetben megolvaszt néhány berendezést és lekapcsolja a többit, a legrosszabb esetben... tüzet okoz a teremben, ami majdnem garantáltan mindent megsemmisít.
15:39. Problémát észlelünk a conf adatbázissal.
A conf adatbázis a nevét viselő szolgáltatás háttéralkalmazása, amelyet minden produkciós alkalmazás a beállítások valós idejű módosítására használ. E nélkül az adatbázis nélkül nem tudjuk irányítani a portál működését, de a portál maga ettől függetlenül működhet.
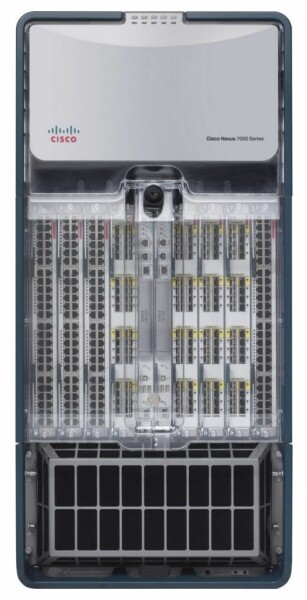
15:41. A Core hálózati berendezéseken lévő hőmérséklet-érzékelők a megengedett határértékhez közeli értékeket rögzítenek. Ez egy doboz, amely egy teljes állványt foglal el és biztosítja az összes hálózat működését az adatközponton belül.
15:42. Az issue tracker és a wiki nem elérhető, átkapcsolunk standby módba.
Ez nem produkció, de vészhelyzet esetén bármely tudásbázis elérhetősége kritikus lehet.
15:50. Az egyik monitoring rendszer kiemelkedett.
Több van belőlük, és különböző szolgáltatások működésének ellenőrzéséért felelnek. Néhányuk az egyes adatközpontok belső autonóm működésére van beállítva (azaz csak a saját adatközpontjukat monitorozzák), míg mások elosztott összetevőkből állnak, amelyek átmeneti módon elviselik az adatközpontok bármelyikének elvesztését.
Ebben az esetben nem működött , amely master-standby módban működik. Átkapcsoltunk standby módra.
Elfogadás
15:51. Az IPMI-n keresztül minden szervert kikapcsoltunk helyes befejezés nélkül, kivéve a MS SQL-t.
Készen áll arra, hogy szükség esetén tömegesen kezelje a szervereket IPMI-n keresztül?
Elérkezett a pillanat, amikor a felszerelés megmentése az adatközpontban ezen a szakaszon befejeződött. Minden, amit lehetett, megtettünk. Néhány kolléga pihenhet.
16:13. Információ érkezett arról, hogy a tetőn megrepedtek a hűtőcsövek — ez késlelteti az adatközpont üzembe helyezését a tűz elhárítása után.
16:19. A datacenter műszaki személyzetétől kapott adatok szerint megállt a hőmérséklet emelkedése a termekben.
17:10. Visszaállítottuk a conf adatbázis működését. Most módosíthatjuk az alkalmazások beállításaikat.
Miért olyan fontos ez, ha minden hibamentesen működik még egy adatközpont nélkül is?
Először is, nem minden része rendszernek hibamentes. Vannak különböző másodlagos szolgáltatások, amelyek még nem bírják jól az adatközpont leállását, és léteznek master-standby üzemmódban lévő adatbázisok. A beállítások kezelési lehetősége lehetővé teszi, hogy minden szükséges intézkedést megtegyünk, hogy még összetett körülmények között is minimalizáljuk a baleset következményeinek hatását a felhasználókra.
Másodszor, világossá vált, hogy az adatközpont működése a következő órákban teljesen nem áll helyre, ezért intézkedéseket kellett hozni, hogy a replikák hosszú távú elérhetetlensége ne okozzon további kellemetlenségeket, mint például a lemezek túlterhelődése a fennmaradó adatközpontokban.
17:29. Pizza idő! Nálunk emberek dolgoznak, nem robotok.
Rehabilitáció
18:02. A 8-as (miénk), 9-es, 10-es és 11-es termekben stabilizálódott a hőmérséklet. Az egyik olyan teremben, amely még mindig ki van kapcsolva (7-es), a mi felszerelésünk található, és ott a hőmérséklet továbbra is emelkedik.
18:31. Engedélyt kaptunk a 1-es és 3-as termek felszerelésének üzembe helyezésére — ezeket a termeket nem érintette a tűz.
Jelenleg a 1-es, 3-as és 8-as termek szervereinek üzembe helyezése zajlik, a legkritikusabbakkal kezdve. Minden elindított szolgáltatás működésének ellenőrzése folyamatban van. A 7-es termével továbbra is problémák vannak.
18:44. Az adatközpont technikai személyzete felfedezte, hogy a 7-es teremben (ahol csak a mi felszerelésünk van) sok szerver nincs kikapcsolva. Adataink szerint 26 szerver maradt bekapcsolva. A második ellenőrzés után 58 szervert találunk.
20:18. Az adatközpont technikai személyzete levegőt fúj a klíma nélküli teremben mobil légcsatornákon keresztül, amelyek a folyosókon keresztül vannak elhelyezve.
23:08. Az első adminot hazaengedtük. Valakinek aludnia kell éjjel, hogy holnap folytathassuk a munkát. Ezután még néhány adminisztrátort és fejlesztőt is elengedünk.
02:56. Elindítottunk mindent, amit csak lehetett. Nagy ellenőrzést végzünk minden szolgáltatáson automatizált tesztekkel.
03:02. Az utolsó, 7. terem klímatizálása helyreállt.
03:36. A frontokat a DNS-be rotáltuk a datacenterben. Ettől a pillanattól kezdve megkezdi a felhasználói forgalom érkezését.
A csapat nagy részét hazaküldjük adminisztrátorokból. De néhány embert itt hagyunk.
Kis GYIK:
K: Mi történt 18:31 és 02:56 között?
V: Az "Irányelvek vészhelyzet esetén" szerint elindítjuk az összes szolgáltatást, kezdve a legfontosabbakkal. A koordinátor a csevegésben kiadja a szolgáltatást a szabad adminisztrátornak, aki ellenőrzi, hogy elindultak-e az operációs rendszerek és az alkalmazás, nincsenek hibák, és a mutatók rendben vannak-e. A folyamat befejeztével értesíti a csevegést, hogy szabad, és új szolgáltatást kap a koordinátortól.
A folyamatot az elromlott hardver is lassítja. Még ha az operációs rendszerek leállítása és a szerverek kikapcsolása helyesen is történt, egyes szerverek nem térnek vissza a váratlanul meghibásodott lemezek, memória vagy chassik miatt. Áramkimaradás esetén a hibák aránya nő.
K: Miért nem lehet egyszerre mindent elindítani, majd javítani azt, ami a megfigyelés során felmerül?
V: Minden lépést fokozatosan kell végrehajtani, mert a szolgáltatások között függőségek vannak. Azt is azonnal ellenőrizni kell, nem várva meg a monitorozást — mert a problémákat jobb azonnal megoldani, nem várni, hogy súlyosabbá váljanak.
7:40. Az utolsó admin (koordinátor) elment aludni. Az első nap munkája befejeződött.
8:09. Az első fejlesztők, mérnökök a datacenterekben és adminisztrátorok (beleértve az új koordinátort) megkezdték a helyreállítási munkálatokat.
09:37. Megkezdtük a 7-es terem (utolsó) felemelését.
Párhuzamosan folytatjuk a helyreállítást azokon a területeken, amelyeket nem fejeztünk be más termekben: lemezek/memória/szerverek cseréje, a monitorozás során "égető" problémák javítása, a szerepek visszacsatolása a master-standby sémákban és egyéb apróságok, amelyekből azonban elég sok van.
17:08. Minden normál munka engedélyezve van a produkción.
21:45. A második napi munkák befejeződtek.
09:45. Ma péntek van. A monitoringban továbbra is sok apró probléma van. Közeledik a hétvége, mindenki pihenni szeretne. Továbbra is tömegesen javítunk mindent, amit csak lehet. Az adminisztratív feladatok, amelyeket el lehetett halasztani, el lettek halasztva. Az új koordinátor.
15:40. Hirtelen újraindult a hálózati eszközök Core felének stackje egy MÁS adatközpontban. Kiiktattuk a frontokat a kockázatok minimalizálása érdekében. A felhasználók számára nincs hatása. Később kiderült, hogy ez egy hibás chasís volt. A koordinátor azonnal a két hiba javításán dolgozik.
17:17. A másik adatközpont hálózati működése helyreállt, minden ellenőrizve. Az adatközpont visszakerült a rotációba.
18:29. A harmadik napon elvégzett munkák, valamint az általános helyreállítás baleset után befejeződtek.
Utószó
2013.04.04. , "Odnoklassniki" — három napon keresztül a portál teljesen vagy részben elérhetetlen volt. Ez idő alatt több mint 100 ember különböző városokból, különböző cégekből (még egyszer köszönjük!), távolról és közvetlenül az adatközpontokban, manuálisan és automatikusan több ezer szervert javított.
Levontuk a következtetéseket. Annak érdekében, hogy hasonló ne fordulhasson elő, széleskörű munkát végeztünk és továbbra is folytatunk.
Mik a főbb különbségek a jelenlegi baleset és a 404 között?
- Megjelent a "Baleseti cselekvési terv". Negyedévente gyakorlatokat tartunk — szimulálunk egy baleseti helyzetet, amelyet a rendszergazdák csoportjának (mindegyikük felváltva) meg kell szüntetnie a "Baleseti cselekvési terv" használatával. A vezető rendszergazdák felváltva gyakorolják a koordinátor szerepét.
- Negyedévente teszt üzemmódban izoláljuk az adatközpontokat (mindegyik felváltva) LAN és WAN hálózaton, ami lehetővé teszi a szűk keresztmetszetek időben történő azonosítását.
- Kevesebb hibás lemez, mert megszigorítottuk a normákat: kevesebb üzemidő, szigorúbb küszöbértékek az S.M.A.R.T.-hoz.
- Teljesen lemondtunk a BerkeleyDB-ről — egy régi és instabil adatbázisról, amely hosszú időt igényelt a szerver újraindítása utáni helyreállításhoz.
- Csökkentettük az MS SQL szerverek számát, és csökkentettük a fennmaradóktól való függőséget.
- Megjelent a saját , ahová már két éve aktívan migráljuk az összes szolgáltatást. A felhő jelentősen leegyszerűsíti az alkalmazáskezelés teljes ciklusát, és egy baleset esetén olyan egyedi eszközöket ad, mint:
- Egy kattintással leállíthatja az összes alkalmazást;
- Egyszerű migráció az alkalmazások számára a meghibásodott szerverekről;
- Automatikus prioritás szerinti (szolgáltatások sorrendje) indítása az egész adatközpontnak.
A cikkben leírt esemény a 404-es óta a legnagyobb baleset volt. Természetesen nem minden ment simán. Például amikor az elégett adatközpont elérhetetlenné vált, egy másik adatközpontban egy meghajtó hibásodott meg az egyik szerveren, így csak a Cassandra klaszter három másolatából egy maradt elérhető, emiatt 4,2% mobilalkalmazás-felhasználó nem tudott bejelentkezni. Ezzel párhuzamosan a már bejelentkezett felhasználók továbbra is tudtak dolgozni. Összesen több mint 30 problémát azonosítottak a baleset következtében – a banális hibáktól kezdve a szolgáltatások architektúrájának hiányosságaiig.
De a legfontosabb különbség a mostani baleset és a 404-es között az, hogy miközben a tűz következményeit kezeltük, a felhasználók továbbra is üzeneteket küldtek és videohívásokat folytattak , játszottak, zenét hallgattak, ajándékokat adtak egymásnak, videókat, sorozatokat és TV-csatornákat néztek , valamint élő közvetítéseket tartottak .
Hogyan zajlanak nálatok a balesetek?
Forrás: habr.com
