

Aloha, emberek! Oleg Anastasyev vagyok, az Odnoklassznika platform csapatában dolgozom. Rajtam kívül rengeteg hardver is dolgozik az Odnoklassznikaiban. Négy adatközpontunk van, amelyek körülbelül 500 állványt tartalmaznak, több mint 8000 szerverrel. Egy idő után rájöttünk, hogy az új kezelőrendszer bevezetése lehetővé teszi a berendezések hatékonyabb kihasználását, a hozzáférések kezelésének megkönnyítését, a számítási erőforrások automatizált (újra)elosztását, az új szolgáltatások gyorsabb indítását és a nagyobb incidensekre való gyorsabb reagálást.
Mi lett ennek az eredménye?
Rajtam és a rengeteg hardveren kívül más emberek is dolgoznak ezen a hardveren: mérnökök, akik közvetlenül az adatközpontokban találhatók; hálózati szakemberek, akik a hálózati eszközöket konfigurálják; adminisztrátorok, vagyis SRE-k, akik biztosítják az infrastruktúra hibamentességét; és fejlesztői csapatok, akik közül mindegyik felelős a portál egy részének funkcióiért. Az általuk készített szoftver valahogy így működik:
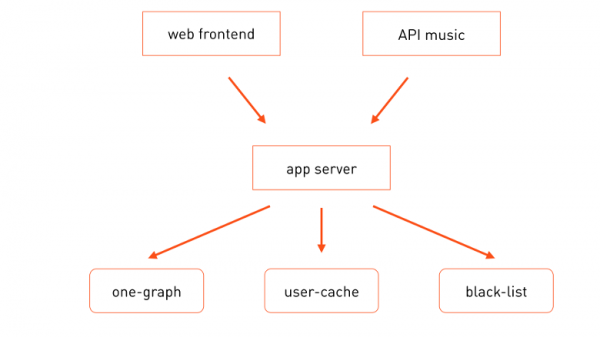
A felhasználók kérései érkeznek a főportál frontendjeire , valamint másokra is, például a zenei API frontendre. Az üzleti logika feldolgozásához hívják az alkalmazásszervert, amely a kérés feldolgozása során hívja a szükséges specializált mikroszolgáltatásokat — one-graph (a társadalmi kapcsolatok grafikája), user-cache (felhasználói profilok cache) stb.
Ezek közül minden szolgáltatás számos gépen fut, és mindegyiknek vannak felelős fejlesztői, akik a modulok működéséért, üzemeltetéséért és technológiai fejlődéséért felelnek. Mindezeket a szolgáltatásokat fizikai szervereken indítjuk, és egészen nemrégig pontosan egy feladat futott minden egyes szerveren, azaz a szerverek speciálisak voltak egy konkrét feladatra.
Miért van ez így? Ennek a megközelítésnek több előnye volt:
- Megkönnyíti a tömeges kezelést. Tegyük fel, hogy a feladat bizonyos könyvtárakat vagy beállításokat igényel. Akkor a szerver pontosan egy meghatározott csoportra lesz hozzárendelve, leírják a cfengine politikát ennek a csoportnak (vagy már leírva van), és ezt a konfigurációt központosítva és automatikusan telepítik az összes ehhez a csoporthoz tartozó szerverre.
- Egyszerűsíti a diagnosztikát. Tegyük fel, hogy egy megnövekedett CPU terhelést vizsgálsz, és rájössz, hogy ezt a terhelést csak az a feladat generálhatta, amelyik ezen a fizikai processzoron fut. A hibás keresése nagyon gyorsan véget ér.
- Egyszerűsíti monitorozás. Ha valami nincs rendben a szerverrel, a monitor értesít erről, és pontosan tudod, ki a hibás.
A több replikából álló szolgáltatásnak számos szervert osztanak ki – egyet mindegyikre. Ekkor a számítási erőforrás a szolgáltatás számára nagyon egyszerűen kiosztható: annyi erőforrást használhat a szolgáltatás, ahány szervere van. A 'szimpla' itt nem azt jelenti, hogy könnyű használni, hanem hogy a források elosztása manuálisan történik.
Ez a megközelítés lehetővé tette számunkra, hogy specializált hardverkoncepciókat alkossunk a szerveren futó feladatra. Ha a feladat nagy mennyiségű adatot tárol, akkor 4U-szervert használunk, egy 38 lemezes házzal. Ha a feladat tisztán számítási jellegű, akkor olcsóbb 1U-szervert vásárolhatunk. Ez hatékony a számítási erőforrások szempontjából. Ezen megközelítés lehetővé teszi, hogy a gépek számát négy részre csökkentsük, amikor a terhelés egy barátságos közösségi hálózathoz hasonló.
Ez a számítási erőforrások hatékony használata gazdasági hatékonyságot is kell, hogy biztosítson, ha abból indulunk ki, hogy a legdrágább a szerver. Hosszú ideig a hardver volt a legdrágább, és sok energiát fektettünk a költségek csökkentésébe, olyan algoritmusok kidolgozásával, amelyek a megbízhatóság csökkentésére irányultak. Ma pedig már eljutottunk arra a szintre, ahol a szerver ára már nem döntő. Ha nem számítjuk a legfrissebb egzotikát, akkor a szerverek konkrét konfigurációja a rackben nem számít. Most egy másik probléma merült fel – a szerver által elfoglalt hely ára a adatközpontban, azaz a rackben.
Miután rájöttünk, hogy ez igaz, úgy döntöttünk, hogy kiszámoljuk, mennyire hatékonyan használjuk a rackeket.
A legjobban teljesítő szerver árát vettük alapul, amely gazdaságilag indokolt, és kiszámoltuk, hány ilyen szervert tudunk elhelyezni a rackekben, hány feladatot tudnánk rajtuk futtatni az „egy szerver = egy feladat” régi modell alapján, és hogy ezek a feladatok mennyire tudnák kihasználni a berendezést. A számítások elkeserítettek minket. Kiderült, hogy a rackek kihasználtsága körülbelül 11 %. A következtetés egyértelmű: növelnünk kell az adatközpontok kihasználtságát. Az egyszerű megoldásnak tűnik: egy szerveren több feladatot kell futtatni egyszerre. De itt kezdődnek a nehézségek.
A tömeges konfiguráció drámaian bonyolódik — most már lehetetlenné válik, hogy egy szerverhez egyetlen csoportot rendeljünk. Hiszen most egy szerveren több csapat különböző feladatainak futása lehetséges. Ezenkívül a konfiguráció eltérő alkalmazások számára ütközhet. A diagnosztika is bonyolultabbá válik: ha megnövekedett processzor- vagy lemezhasználatot látsz a szerveren, nem tudod, hogy melyik feladat okozza a problémát.
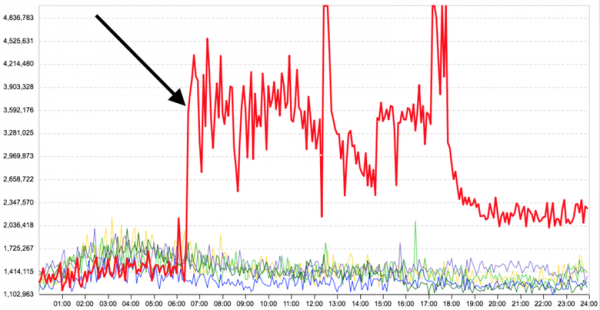
De a legfontosabb, hogy a feladatok között, amelyek egy gépen futnak, nincs elkülönítés. Például a grafikon az átlagos válaszidőről egy szerver feladathoz, mielőtt és miután egy másik, az elsőhöz nem kapcsolódó számítási alkalmazás indult el ugyanazon a szerveren — a fő feladat válaszideje jelentősen megnövekedett.
Nyilvánvaló, hogy a feladatokat vagy konténerekben, vagy virtuális gépekben kell futtatni. Mivel szinte minden feladatunk egyetlen operációs rendszer (Linux) alatt fut, vagy arra van optimalizálva, nem szükséges sok különböző operációs rendszer támogatása. Ezért a virtualizációra nincs szükség, mert a többletköltségek miatt kevésbé hatékony mint a konténerizálás.
A Docker containers implementation for running tasks directly on servers is a good candidate: filesystem images effectively solve problems with conflicting configurations. The ability to compose images from multiple layers allows us to significantly reduce the amount of data required for their deployment on infrastructure, isolating common parts into separate base layers. This way, the base (and largest) layers can be quickly cached across the infrastructure, and only small layers will need to be transferred for delivering various types of applications and versions.
Additionally, the ready-made registry and image tagging in Docker provide us with ready primitives for versioning and delivering code to production.
Docker, like any other similar technology, provides us with a certain level of container isolation out of the box. For example, memory isolation—each container is allocated a memory usage limit of the machine, which it cannot exceed. Container CPU usage can also be isolated. For us, however, the standard isolation was insufficient. More on that below.
Directly running containers on servers is just part of the challenge. Another aspect is placing containers on servers. We need to understand which container can be placed on which server. This is not a simple task, as containers need to be deployed as densely as possible on servers without compromising their performance. Such placement can also be complex from a fault tolerance perspective. Often we want to place replicas of the same service in different racks or even different data center halls so that in the event of a rack or hall failure, we do not lose all replicas of the service at once.
Distributing containers manually is not an option when you have 8,000 servers and 8,000 to 16,000 containers.
Moreover, we wanted to give developers more autonomy in resource allocation so they could place their services in production without administrator assistance. At the same time, we wanted to maintain control to ensure that a secondary service does not consume all the resources of our data centers.
It is clear that we need a management layer that would handle this automatically.
Itt vagyunk egy egyszerű és érthető képpel, amelyet minden építész imád: három négyzet.
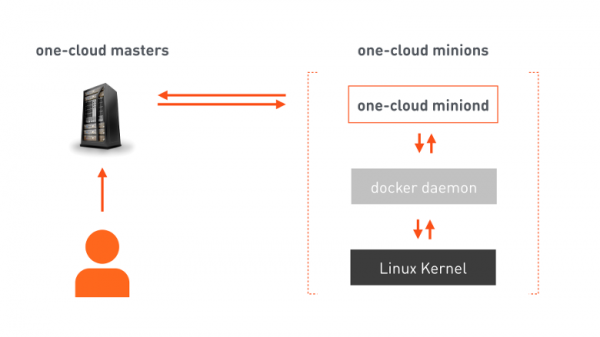
one-cloud mester — hibamentes klaszter, amely a felhő orchestrációjáért felel. A fejlesztő egy manifesztet küld a mesternek, amely tartalmazza az összes szükséges információt a szolgáltatás elhelyezéséhez. A mester ennek alapján parancsokat ad a kiválasztott minionoknak (gépek, amelyek a konténerek indítására szolgálnak). A minionokon található ügynök megkapja a parancsot, adja a saját Docker parancsait, és a Docker konfigurálja a Linux kernelt a megfelelő konténer indításához. A parancsok végrehajtása mellett az ügynök folyamatosan tájékoztatja a mestert a minion gép állapotának, valamint az azon futó konténerek állapotának változásairól.
Erőforrások elosztása
Most nézzük meg egy bonyolultabb erőforrásel распределение a sok minion számára.
A one-cloud-ban az számítási forrás:
- A CPU számítási teljesítménye, amelyet egy konkrét feladat igényel.
- A feladat számára elérhető memória mennyisége.
- Hálózati forgalom. Minden minionnak van egy konkrét hálózati interfésze, amelynek korlátozott sávszélessége van, ezért nem lehet a feladatokat úgy elosztani, hogy ne vegyük figyelembe az általuk átadott adatmennyiséget.
- Lemezek. Nyilvánvaló, hogy a feladat adataihoz szükséges hely mellett a lemez típust is kijelölünk: HDD vagy SSD. A lemezek véges számú kérést tudnak kiszolgálni másodpercenként — IOPS. Ezért a feladatok számára, amelyek több IOPS-t generálnak, mint amit egy lemez el tud látni, 'spindleket' is ki kell osztanunk — azaz olyan lemezes eszközöket, amelyeket kifejezetten a feladatra kell fenntartani.
Tehát egy szolgáltatás, például a user-cache számára az igényelt erőforrásokat így rögzíthetjük: 400 processzormag, 2,5 TB memória, 50 Gb/s forgalom mindkét irányba, 6 TB HDD-n, amely 100 spindlén található. Vagy a számunkra megszokott formában így:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
A user-cache szolgáltatás erőforrásai csak a production infrastruktúrában elérhető összes erőforrás egy részét fogyasztják. Ezért fontos biztosítani, hogy hirtelen, akár üzemeltetői hiba miatt, a user-cache ne fogyasszon el több erőforrást, mint amennyit kapott. Vagyis limitálnunk kell az erőforrásokat. De mivel kötnénk a kvótát?
Térjünk vissza a jelentősen leegyszerűsített komponens-interakciós sémánkhoz, és rajzoljuk át több részletességgel — így:
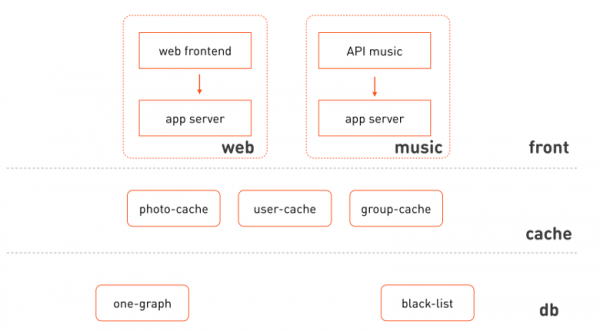
Ami szembetűnő:
- A webfrontend és a zene ugyanannak az alkalmazásservernek az elkülönített klasztereiben működik.
- Különböző logikai rétegeket különíthetünk el, amelyekhez ezek a klaszterek tartoznak: frontendek, cache-ek, adattároló és kezelő réteg.
- A frontend nem homogén, ezek különböző funkcionális alrendszerek.
- A cache-eket is el lehet osztani a rendszeren belül, amelynek az adatait cache-elik.
Újra rajzoljuk a képet:
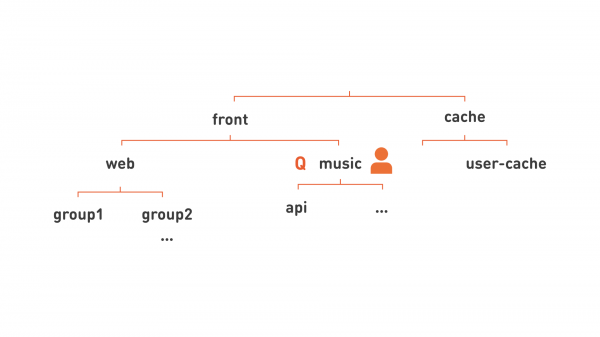
Hoppá! Hierarchiát látunk! Ez azt jelenti, hogy erőforrásokat nagyobb egységekben oszthatunk el: jelöljük ki a hierarchia csomópontjára a felelős fejlesztőt, amely a funkcionális alrendszerhez kapcsolódik (mint a képen a «music»), és ehhez a hierarchia szinthez hozzárendelhetjük a kvótát. Ez a hierarchia rugalmasabb szervezést is lehetővé tesz a szolgáltatások kezelésének megkönnyítésére. Például az összes webkiszolgálót, mivel ez egy nagyon nagy csoportosítás, több kisebb csoportra osztjuk, amelyeket a képen group1, group2 néven jelöltünk meg.
A felesleges vonalak eltávolításával minden csomópontunkat laposabb formában rögzíthetjük: group1.web.front, api.music.front, user-cache.cache.
Így jutunk el a „hierarchikus sor” fogalmához. Ennek neve van, mint például „group1.web.front”. Erőforrás kvótát és felhasználói jogokat rendelünk hozzá. A DevOps szakembernek jogokat adunk a szolgáltatás sorba állítására, és ez a munkatárs bármit indíthat a sorban, míg az OpsDev munkatársnak adminisztrátori jogai vannak, így már tudja kezelni a sort, embereket kijelölni, ezeknek jogokat adni, stb. A sorban indított szolgáltatások a sor kvótáján belül fognak teljesülni. Ha a sor számítási kvótája nem elegendő az összes szolgáltatás egyidejű futtatásához, akkor ezek egymás után fognak végrehajtásra kerülni, ezáltal saját sort alkotva.
Nézzük meg részletesebben a szolgáltatásokat. Minden szolgáltatásnak van egy teljes neve, amely mindig magában foglalja a sor nevét. Így a webfrontend szolgáltatás neve ok-web.group1.web.front. A kapcsolódó alkalmazásserver szolgáltatás neve pedig ok-app.group1.web.front. Minden szolgáltatásnak van egy manifestje, amely tartalmaz minden szükséges információt a konkrét gépeken való elhelyezéshez: mennyi erőforrást igényel ez a feladat, milyen konfiguráció szükséges hozzá, hány példányra van szükség, a szolgáltatás hibakezelési tulajdonságai. És a szolgáltatás gépeken való elhelyezése után megjelennek a példányai. Ezeket is egyértelműen az példány számával és a szolgáltatás nevével nevezik meg: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, ...
Ez nagyon kényelmes: csak a futó konténer nevére nézve sok mindent azonnal kideríthetünk.
Most ismerkedjünk meg azzal, hogy ezek a példányok valójában mit is hajtanak végre: a feladatokkal.
Feladatok izolációs osztályai
Minden feladat az OK-ban (és valószínűleg mindenhol máshol is) csoportokra osztható:
- Rövid késleltetésű feladatok — prod. Az ilyen feladatok és szolgáltatások esetében a válasz késése (latency) nagyon fontos, hogy a rendszer mennyire gyorsan tudja feldolgozni az egyes kéréseket. Példák ilyen feladatokra: webfrontek, gyorsítótárak, alkalmazás szerverek, OLTP tárolók stb.
- Számítási feladatok — batch. Itt nem számít minden egyes kérés feldolgozási sebessége; fontos, hogy az adott (nagy) időintervallumban hány összes számítást végez el ez a feladat (throughput). Ilyenek bármilyen MapReduce, Hadoop, gépi tanulás, statisztika feladat.
- Háttérfeladatok — idle. Az ilyen feladatok esetében sem a latency, sem a throughput nem túl fontos. Ide tartoznak különféle tesztek, migrációk, átszámítások, adatok konvertálása egyik formátumból a másikba. Egyfelől hasonlítanak a számítási feladatokra, másfelől pedig nem nagyon érdekel minket, hogy milyen gyorsan fejeződnek be.
Nézzük meg, hogyan fogyasztják az ilyen feladatok az erőforrásokat, például a központi feldolgozóegység (CPU) erőforrásait.
Rövid késleltetésű feladatok. Egy ilyen feladat CPU-felhasználásának mintája ehhez hasonló lesz:
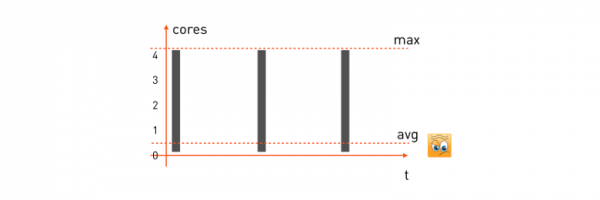
A felhasználótól érkezik egy kérés, a feladat elkezdi használni az összes elérhető CPU magot, feldolgoz, visszatér egy válasz, várja a következő kérdést, és áll. Érkezik a következő kérés — újra veszi az összes elérhető erőforrást, feldolgoz, vár a következőre.
A minimális késleltetés biztosításához ennek a feladatnak maximum a felhasználásához kell igazodnunk, és a szükséges magok számát elő kell rezerválnunk a minyonhoz (gépre, amely végrehajtja a feladatot). Így a feladatunkra vonatkozó reserválási képlet a következőképpen alakul:
alloc: cpu = 4 (max)Ha van egy 16 magos minion gépünk, akkor pontosan négy ilyen feladatot lehet elhelyezni rajta. Külön kiemeljük, hogy az ilyen feladatok átlagos processzorhasználata gyakran nagyon alacsony — ami nyilvánvaló, hiszen a feladat jelentős részét azzal tölti, hogy a kérésre vár, és nem csinál semmit.
Számítási feladatok. Nekik a mintázatuk egy kicsit más lesz:
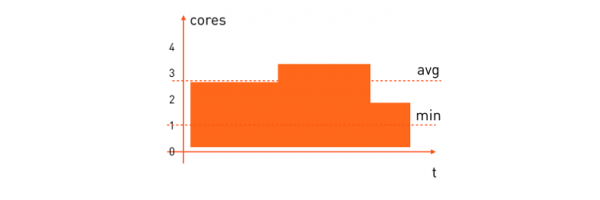
Az ilyen feladatok átlagos erőforrás-felhasználása viszonylag magas. Gyakran azt akarjuk, hogy a számítási feladat egy meghatározott időn belül teljesüljön, ezért elő kell foglalni a minimális számú processzort, amely szükséges ahhoz, hogy a számítás egy elfogadható időn belül befejeződjön. Az előfoglalási képletük így néz ki:
alloc: cpu = [1,*)"Kérlek, helyezd el a minionon, ahol van legalább egy szabad mag, a többivel meg mindent elfoglalhat".
Itt már sokkal jobban kihasználható a teljesítmény, mint a rövid késleltetésű feladatoknál. De a nyereség sokkal nagyobb lesz, ha a két feladat típust egy gépen egyesítjük, és a forrásaikat folyamatosan osztjuk el. Amikor a rövid késleltetésű feladat processzort igényel — azt azonnal megkapja, ha pedig a forrásokra már nincs szükség — átkerülnek a számítási feladathoz, azaz valahogy így:
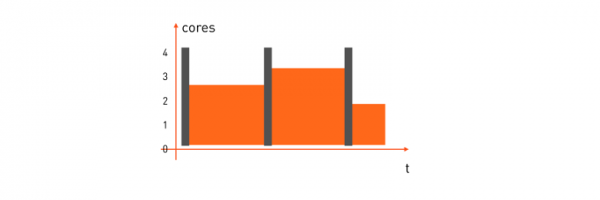
De hogyan csináljuk ezt?
Először is nézzük meg a prod-t és annak alloc: cpu = 4. Négy magot kell előfoglalnunk. A Docker run esetében ezt kétféleképpen lehet megtenni:
- A következő opcióval
--cpuset=1-4, azaz négy meghatározott magot kiadni a feladatnak a gépen. - Használja a
--cpuquota=400_000 --cpuperiod=100_000, a processzoridő kvótáját, azaz megadni, hogy valós időben a feladat legfeljebb 400 ms processzoridőt használ el 100 ms-onként. Ugyanazt a négy magot kapjuk.
De melyik módszer lesz alkalmas?
A cpuset looks quite attractive. The task has four dedicated cores, which means the processor caches will operate at maximum efficiency. There is a downside to this: we would have to take on the task of distributing computations across the underutilized cores of the machine instead of the OS, which is quite a non-trivial task, especially if we try to place batch tasks on such a machine. Tests have shown that the quota option is better suited here: it gives the operating system more freedom to choose a core for executing the task at the moment and CPU time is distributed more efficiently.
Let's figure out how to reserve the minimum number of cores in docker. The quota for batch tasks is no longer applicable because there is no need to limit the maximum; it's enough to guarantee a minimum. And here the option fits well. docker run --cpushares.
We agreed that if the batch requires a guarantee of at least one core, we specify --cpushares=1024, and if at least two cores are needed, we specify --cpushares=2048. CPU shares do not interfere with CPU time allocation as long as there is enough time. Thus, if prod is not currently using all four of its cores—nothing limits batch tasks, and they can use additional CPU time. However, in the situation of CPU scarcity, if prod has consumed all four of its cores and hit the quota—the remaining CPU time will be distributed proportionally to cpushares, i.e., in the situation with three free cores, one will be allocated to the task with 1024 cpushares, while the other two will go to the task with 2048 cpushares.
But using quota and shares is not enough. We need to ensure that tasks with short latency receive priority over batch tasks when allocating CPU time. Without such prioritization, the batch task will consume all CPU time at the moment it is needed by prod. In Docker run, there are no options for prioritizing containers, but CPU scheduler policies in Linux come to the rescue. Detailed information about them can be read , but in this article, we'll briefly cover them:
- SCHED_OTHER
By default, all ordinary user processes on a Linux machine receive this. - SCHED_BATCH
Erőforrás-igényes folyamatokhoz készült. Amikor egy feladatot elhelyezünk a processzorban, úgynevezett aktiválási büntetést vezetünk be: egy ilyen feladat kisebb valószínűséggel kap processzorfunkciót, ha azt éppen egy SCHED_OTHER feladat használja. - SCHED_IDLE
Olyan háttérfolyamat, amelynek rendkívül alacsony prioritása van, még a nice –19-nél is alacsonyabb. Használjuk a nyílt forráskódú könyvtárunkat. , hogy a szükséges politikát a konténer indításakor a
one.nio.os.Proc.sched_setscheduler(pid, Proc.SCHED_IDLE)De még ha nem is programozik Java nyelven, ugyanezt megteheti a chrt parancs segítségével:
chrt -i 0 $pidMindent összegezve, az elszigeteltségi szinteinket egy táblázatba foglaljuk össze a világosabb áttekintés érdekében:
Izolációs osztály
Példa alloc
Docker futtatási opciók
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Ha a chrt parancsot a konténerből végzi, szüksége lehet a sys_nice jogosultságra, mivel alapértelmezés szerint a Docker ezt a jogosultságot megszünteti a konténer indításakor.
De a feladatok nemcsak processzort, hanem forgalmat is fogyasztanak, ami a hálózati feladat késleltetésére még nagyobb hatással van, mint a processzor erőforrásainak helytelen elosztása. Így természetesen olyan képet szeretnénk kapni a forgalomról is. Azaz amikor a prod-feladat adatcsomagokat küld a hálózatra, max sebességet kvótázunk (képlet alloc: lan=[*,500mbps) ), amely mellett a prod ezt megteheti. A batch számára viszont csak a minimális átviteli sebességet garantáljuk, de a maximálisat nem korlátozzuk (képlet alloc: lan=[10Mbps,*) ) Itt a prod forgalom prioritást élvez a batch-feladatokkal szemben.
Itt a Dockernek nincsenek olyan primitív elemei, amelyeket felhasználhatnánk. De segítségünkre jön a . A kívánt eredményt a segítségével értük el. Ezzel két forgalmi osztályt választunk ki: a magas prioritású prod-ot és az alacsony prioritású batch/idle-t. Ennek eredményeként a kimenő forgalom konfigurációja a következőképpen alakul:
itt 1:0 — a «gyökér qdisc» hsfc diszciplínáján; 1:1 — a hsfc alosztály egy általános sávszélesség-korlátozással, amely 8 Gbit/s, amely alá tartoznak az összes konténer alosztályai; 1:2 — a hsfc alosztály, amely közös a batch és idle feladatok számára „dinamikus” korlátozással, amiről lentebb lesz szó. A többi hsfc alosztály a jelenleg futó prod konténerekre van fenntartva a korlátozásaikkal, amelyek megfelelnek a manifesztjeiknek, — 450 és 400 Mbit/s. Minden hsfc osztály qdisc sort kap fq vagy fq_codel alapján, a linux kernel verziójától függően, a csomagveszteségek elkerülése érdekében a forgalomcsúcsok során.
A tc diszciplínák általában csak a kimenő forgalom priorizálására szolgálnak. De mi a bejövő forgalmat is priorizálni akarjuk — hiszen bármely batch feladat egyszerűen kidobhatja az összes bejövő csatornát, például egy nagy adatcsomag beérkezésekor a map&reduce számára. Ehhez modulra van szükségünk, , amely virtuális ifbX interfészt hoz létre minden hálózati interfészhez, és átirányítja a bejövő forgalmat az interfészről a kimenő forgalomra az ifbX-en. Ezt követően az ifbX-re ugyanazok a diszciplínák alkalmazandók a kimenő forgalom ellenőrzésére, amelyek konfigurációja a hsfc esetében nagyon hasonló lesz:
Kísérleteink során megállapítottuk, hogy a legjobb hsfc teljesítmény akkor érhető el, ha a 1:2 osztályba tartozó, nem prioritásos batch/idle forgalmat a minion gépeken legfeljebb egy bizonyos szabad sávszélességig korlátozzuk. Ellenkező esetben a nem prioritásos forgalom túlzottan befolyásolja a prod feladatok késleltetését. A szabad sávszélesség aktuális nagyságát a miniond másodpercenként határozza meg, az összes prod feladat átlagos forgalomfogyasztásának mérésével  és levonva azt a hálózati interfész sávszélességéből,
 kis tartalékkal, azaz.

A sávok függetlenül kerülnek meghatározásra a bejövő és kimenő forgalomra. Ennek megfelelően az új értékek szerint a miniond újrakonfigurálja a 1:2 nem prioritásos osztály korlátait.
Így megvalósítottuk mindhárom izolációs osztályt: prod, batch és idle. Ezek az osztályok jelentős hatással vannak a feladatok teljesítményére. Ezért úgy döntöttünk, hogy ezt a tulajdonságot a hierarchia tetejére helyezzük, hogy a hierarchikus sorra nézve azonnal világos legyen, hogy mivel állunk szemben:
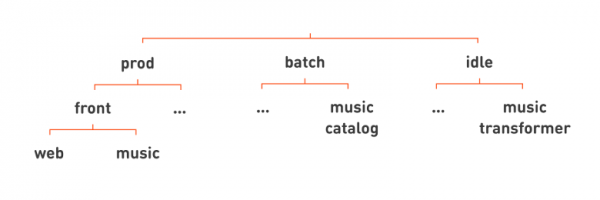
Mindannyian ismerősek vagyunk szolgáltatás szeretne hozzáférni egy és zene a frontok ekkor a hierarchián belül a prod alá kerülnek. Például a batch alá helyezzük a szolgáltatást, zenei katalógus, amely időről időre összeállítja a dalok katalógusát az „Osztálytársak” -ban feltöltött mp3 fájlok készletéből. Az idle szolgáltatások példájául szolgálhat zene transzformátor, amely normalizálja a zene hangerőszintjét.
Ismét eltávolítva a felesleges sorokat, le tudjuk írni a szolgáltatásaink nevét laposabban, hozzáfűzve a feladatizolációs osztályt a szolgáltatás teljes nevének végéhez: web.front.prod, catalog.music.batch, transformer.music.idle.
Most, hogy ránézünk a szolgáltatás nevére, nemcsak azt értjük meg, milyen funkciót lát el, hanem a szigetelési osztályát is, így a kritikalitását stb.
Minden nagyszerű, de van egy keserű igazság. Teljesen izolálni a feladatokat, amelyek egy gépen futnak, lehetetlen.
Amit elértünk: ha a batch intenzíven fogyasztja a a fő DB példányhoz processzor erőforrásait, akkor a beépített CPU ütemező a Linuxban nagyon jól végzi a dolgát, és a hatása a prod-feladatra gyakorlatilag elhanyagolható. De ha ez a batch-feladat aktívan dolgozni kezd a memóriával, akkor a kölcsönös hatás már megjelenik. Ez azért van, mert a prod-feladat 'kiüríti' a processzor memória cache-ét — ennek eredményeként a cache-ben növekednek a hibaütközések, és a processzor lassabban dolgozza fel a prod-feladatot. Egy ilyen batch-feladat akár 10%-kal is megnövelheti a tipikus prod-konténerünkhöz szükséges késleltetést.
A forgalom izolálása még nehezebb, mivel a modern hálózati kártyáknak belső csomag-sorba állításuk van. Ha egy csomag a batch-feladatból elsőként jut be az ilyen sorba, az elsőként is kerül továbbításra a kábelen, és ezen nem tudunk változtatni.
Ráadásul eddig csak a TCP-forgalom prioritizálásának feladatát sikerült megoldanunk: UDP esetében a hsfc megközelítés nem működik. Még a TCP-forgalom esetében is, ha a batch-feladat sok forgalmat generál, ez is körülbelül 10%-os késleltetést okoz a prod-feladatra.
Hibatűrés
A one-cloud fejlesztés egyik célja az Osztálytársak megbízhatóságának javítása volt. Ezért most szeretném részletesebben megvizsgálni a lehetséges hiba- és baleseti forgatókönyveket. Kezdjük egy egyszerű forgatókönyvvel — egy konténer leállásával.
A konténer önmagában többféleképpen is meghibásodhat. Ez lehet valamiféle kísérlet, hiba vagy probléma a manifestben, ami miatt a prod-feladat több erőforrást kezd el fogyasztani, mint ami a manifestben szerepel. Volt olyan esetünk, amikor egy fejlesztő egy bonyolult algoritmust valósított meg, sokszor átdolgozta, és annyira túlbonyolította, hogy végül a feladat meglehetősen nem trivialisan ciklusba került. Mivel a prod-feladat magasabb prioritású, mint az összes többi a hasonló minionokon, elkezdte felhasználni az összes elérhető CPU-erőforrást. Ebben a helyzetben az elszigetelés segített, pontosabban a CPU-időre vonatkozó kvóta. Ha a feladatnak kvótája van kijelölve, a feladat nem fogyaszt többet. Ennek eredményeként a batch- és egyéb prod-feladatok, amelyek ugyanazon a gépen futottak, nem vettek észre semmit.
A második lehetséges probléma a konténer leállása. Itt a restart politikák segítenek nekünk, mindenki ismeri őket, a Docker pedig nagyszerűen kezeli. Gyakorlatilag minden prod-feladatnak állandó restart politikája van. Néha az on_failure-t használjuk batch-feladatoknál vagy a prod-konténerek hibakeresésekor.
Mi a teendő, ha egy egész minion nem elérhető?
Nyilvánvaló, hogy indítsunk konténert egy másik gépen. Az érdekes itt az, hogy mi történik a konténerhez rendelt IP-címmel (címekkel).
Kijelölhetünk a konténereknek olyan IP-címeket, mint a minion gépeké, ahol ezek a konténerek futnak. Ekkor, amikor egy konténert egy másik gépen indítunk, az IP-címe megváltozik, és minden kliensnek meg kell értenie, hogy a konténer átköltözött, most egy másik címre kell menniük, ami külön szolgáltatást igényel, a Service Discovery-t.
A Service Discovery kényelmes. A piacon sokféle megoldás létezik különböző megbízhatósági szintekkel a szolgáltatások nyilvántartásának megszervezésére. Gyakran az ilyen megoldásokban megvalósítják a terheléselosztó logikáját, tárolnak kiegészítő konfigurációt KV-tároló formájában stb.
Azonban szeretnénk elkerülni egy külön nyilvántartás bevezetésének szükségességét, mert ez egy kritikus rendszert jelentene, amelyet minden szolgáltatás használ a termelésben. Ezért ez potenciális meghibásodási pont, és nagyon megbízható megoldást kell választani vagy kifejleszteni, ami nyilvánvalóan nagyon nehéz, időigényes és költséges.
És még egy nagy hiányosság: ahhoz, hogy a régi infrastruktúránk együttműködjön az újjal, teljesen át kellene írni az összes feladatot valamilyen Service Discovery rendszert használva. A munka nagyon sok, helyenként gyakorlatilag lehetetlen, amikor alacsony szintű eszközökről van szó, amelyek az OS magasszintjén vagy közvetlenül a hardverrel működnek. E funkció megvalósítása bevett megoldásminták segítségével, mint például helyenként további terhelést, helyenként pedig a működtetés bonyolultabbá válását és további hibalehetőségeket jelentene. Nem akartuk bonyolítani a helyzetet, ezért úgy döntöttünk, hogy a Service Discovery használatát opcionálissá tesszük.
A one-cloud-ban az IP követi a konténert, azaz minden feladat példánynak saját IP-címe van. Ez a cím „statikus”: minden példány számára rögzítésre kerül a szolgáltatás első felhőbe küldésekor. Ha a szolgáltatás élete során különböző számú példányt futtatott, akkor végül annyi IP-cím lesz hozzá rendelve, ahány példány a maximum volt.
Ezek a címek később nem változnak: egyszeri hozzárendelés után folyamatosan fennmaradnak a szolgáltatás élete során a production környezetben. Az IP-címek a konténerek után követik a hálózatban. Ha a konténert egy másik minyonra helyezik át, akkor a cím is átkerül vele.
Így a szolgáltatás neve és az IP-címek listájának párosítása nagyon ritkán változik. Ha újra megnézzük a szolgáltatás példányneveit, amelyeket a cikk elején említettünk (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), akkor észrevehetjük, hogy ezek hasonlítanak a DNS-ben használt FQDN-re. Így van, a szolgáltatás példányainak nevét az IP-címükön való megjelenítéshez DNS protokollt használunk. Ráadásul ez a DNS visszaadja az összes konténer minden lefoglalt IP-címét — mind az aktív, mind a leállított konténerekét (tegyük fel, hogy három replikát használunk, de öt cím van lefoglalva — mind az öt vissza lesz adva). Az ügyfelek, miután megkapták ezt az információt, megpróbálnak kapcsolatot létesíteni az összes öt replikával — és így határozzák meg, hogy melyek működnek. Ez a hozzáférhetőség meghatározása sokkal megbízhatóbb, mivel nem érint sem a DNS, sem a Szolgáltatás Felfedezés, tehát nincsenek nehezen megoldható problémák az információk aktualitásának és e rendszerek hibamentességének biztosításával. Sőt, a kritikus szolgáltatásokban, amelyektől az egész portál működése függ, akár a DNS-t is teljesen kihagyhatjuk, és egyszerűen az IP-címeket beleírhatjuk a konfigurációba.
Az IP-k konténerekkel való átvitelének megvalósítása nem triviális — és a működését egy következő példán mutatjuk be:
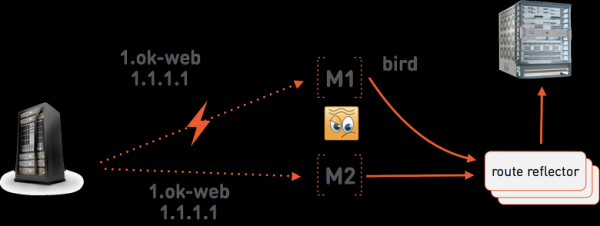
Tegyük fel, hogy a one-cloud mester utasítja M1 minyóot, hogy indítsa el 1.ok-web.group1.web.front.prod az 1.1.1.1. címmel. A minyón fut , amely ezt a címet bejelenti a speciális szervereknek . Az utóbbiak BGP session-t fenntartanak a hálózati berendezéssel, amelyhez a 1.1.1.1 címről az M1-hez vezető útvonalat közvetítik. Az M1 már Linux eszközökkel irányítja a csomagokat a konténer belsejébe. Három route reflector server van, mivel ez a one-cloud infrastuktúra nagyon kritikus része — nélkülük a hálózat nem működik one-cloudban. Ezeket különböző állványokban helyezzük el, lehetőleg a adatközpont különböző termében, hogy csökkentsük annak valószínűségét, hogy mindhárom egyszerre meghibásodjon.
Most feltételezzük, hogy a kapcsolat a one-cloud mester és az M1 minyó között megszakadt. A one-cloud mester most azzal a feltételezéssel fog cselekedni, hogy az M1 teljesen hibás. Tehát utasítja az M2 minyóot, hogy indítsa el web.group1.web.front.prod ugyanazzal a 1.1.1.1 címzettel. Most két ellentmondásos útvonalunk van a hálózatban az 1.1.1.1-hez: M1-en és M2-n. Az ilyen konfliktusok feloldásához Multi Exit Discriminatort használunk, amely a BGP bejelentésben van megadva. Ez egy szám, amely megmutatja a bejelentett útvonal súlyát. A ellentmondásos útvonalak közül a kisebb MED értékkel rendelkező lesz a kiválasztott. A master one-cloud a MED-et az IP-címek integrált részének tekinti. Először az IP-cím megfelelően nagy MED-el = 1 000 000 kerül bejegyzésre. Azonban ha az konténer sürgős átkonfigurálására van szükség, a master csökkenti a MED-et, így M2 már megkapja a parancsot, hogy jelentse be az 1.1.1.1 címet MED = 999 999 értékkel. Az M1-en működő példány ezalatt kapcsolat nélkül marad, és a további sorsa nem érdekel minket egészen addig, amíg a kapcsolat vissza nem áll a master-rel, amikor is leállításra kerül, mint régi dublikon.
Hibák
A adatközpontok összes irányító rendszere általában jól kezeli a kisebb hibákat. A konténer kiesése gyakorlatilag normális bármilyen helyzetben.
Nézzük meg, hogyan kezeljük a hibát, például amikor áramkimaradás történik egy vagy több adatközponti teremben.
Mit jelent a hiba az adatközpont irányító rendszeré számára? Először is, ez egy tömeges, egyidejű leállás, ahol sok gép munkája megszakad, és az irányító rendszernek egyszerre kell nagyon sok konténert migrálnia. De ha a hiba nagyon széleskörű, előfordulhat, hogy az összes feladat nem tud átkonfigurálódni más minyonokra, mert az adatközpont erőforrás-capacitása 100% alá csökken.
Gyakran a hibák együtt járnak az irányító réteg leállásával is. Ez történhet az ő berendezéseik meghibásodása miatt, de gyakrabban azért, mert a hibákat nem tesztelik, és az irányító réteg magától is leáll a megnövekedett terhelés miatt.
Mit lehet kezdeni mindezzel?
A tömeges migrációk azt jelentik, hogy az infrastruktúrában sok tevékenység, migráció és elhelyezés jelenik meg. Minden migrációnak szüksége van egy kis időre a konténerek képeinek szállításához és kibővítéséhez a minyonokhoz, konténerek elindításához és inicializálásához stb. Ezért célszerű, hogy a fontosabb feladatok előbb induljanak el, mint a kevésbé fontosak.
Nézzük át újból a jól ismert szolgáltatási hierarchiánkat, és próbáljuk meg megállapítani, hogy mely feladatokat szeretnénk először végrehajtani.
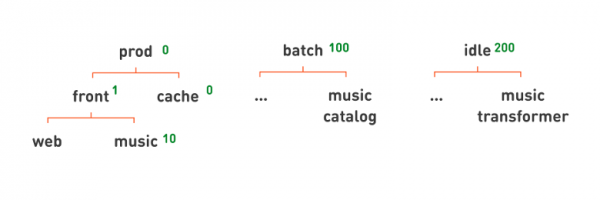
Természetesen ezek azok a folyamatok, amelyek közvetlenül részt vesznek a felhasználói kérések feldolgozásában, azaz a prod. Ezt jelezzük azzal, hogy a telepítési prioritás – egy szám, amely hozzárendelhető egy sorhoz. Ha egy sor prioritása magasabb, a szolgáltatásai elsőbbséget kapnak.
A prod-nál magasabb prioritásokat állítunk be, 0; a batch-nál kissé alacsonyabbakat, 100; az idle-nál pedig még alacsonyabbakat, 200. A prioritások hierarchikusan alkalmazandók. Minden feladat, amely a hierarchiában alacsonyabb helyen áll, a megfelelő prioritással rendelkezik. Ha azt akarjuk, hogy a cache-ek a frontendek előtt induljanak a prod-on belül, a cache-nek 0 prioritást, a frontend al-sorozatnak pedig 1 prioritást adunk. Ha például azt akarjuk, hogy a frontendek közül a fő portál induljon el elsőként, míg a zenei frontend csak később, a másodiknak alacsonyabb prioritást adhatunk – 10.
A következő probléma az erőforrások hiánya. Tehát, sok berendezés meghibásodott, egész termek a datacenterben, és annyi szolgáltatást indítottunk, hogy most már mindenkinek nem jut elegendő erőforrás. Meg kell határoznunk, mely feladatokat kell feláldoznunk, hogy a fő kritikus szolgáltatások működjenek.
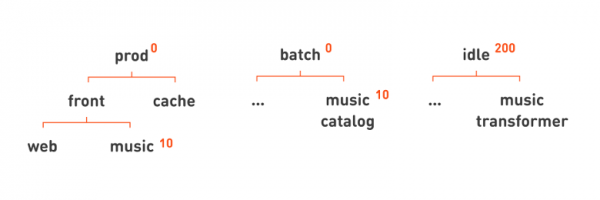
A telepítési prioritással ellentétben nem tudunk minden batch-feladatot önkényesen feláldozni, néhányuk fontos a portal működéséhez. Ezért külön kiemeltük a kiszorítási prioritást a feladat számára. A telepítés során egy magasabb prioritású feladat kiszoríthatja, azaz leállíthatja az alacsonyabb prioritású feladatot, ha nincs több szabad minion. Ebben az esetben a alacsony prioritású feladat valószínűleg ugyanolyan elhelyezetlen marad, azaz nem lesz megfelelő minion elegendő szabad erőforrással.
A hierarchiánkban nagyon egyszerű meghatározni egy olyan kiszorítási prioritást, hogy a prod- és batch-feladatok kiszorítsák vagy leállítsák az idle-feladatokat, de ne egymást, úgy, hogy az idle prioritását 200-ra állítjuk. Ahogyan a telepítési prioritás esetében is, a hierarchiánkat használhatjuk arra, hogy bonyolultabb szabályokat leírjunk. Például jelezhetjük, hogy a zenei funkciókkal áldozunk fel, ha nem elég a forrásunk a fő webportálhoz, a megfelelő csomópontok prioritását alacsonyabbra állítva: 10.
Teljes datacenter balesetek
Miért hibásodhat meg az egész datacenter? Természeti csapás. Volt egy remek poszt, hogyan A létező problémák közé tartozik, hogy egy alkalommal egy hajléktalan a csatornában felgyújtotta az optikát, és az adatközpont teljesen elvesztette a kapcsolatot a többi helyszínnel. A meghibásodás oka lehet az emberi tényező is: a kezelő olyan parancsot adhat ki, amely miatt az egész adatközpont összeomlik. Ez nagyobb hibák miatt is bekövetkezhet. Összességében az adatközpontok leállása nem ritka jelenség. Nálunk ez pár havonta előfordul.
És ezt tesszük, hogy senki ne posztoljon #okživí a Twitterre.
Az első stratégia az izoláció. Minden one-cloud példány elkülönített és csak egy adatközpont gépeit tudja kezelni. Tehát, ha egy felhő meghibásodik hibák vagy a kezelő téves parancsa miatt, az csak egy adatközpont elvesztését jelenti. Felkészültünk erre: van egy tartalékpolitika, amely alapján az alkalmazás és az adatok replikái minden adatközpontban találhatók. Hibatűrő adatbázisokat használunk, és időszakosan teszteljük a meghibásodásokat.
Mivel ma négy adatközpontunk van, tehát négy különálló, teljesen elkülönített one-cloud példányunk is létezik.
Ez a megközelítés nemcsak a fizikai meghibásodásokkal szemben véd, hanem a kezelő hibáival szemben is.
Mit lehet még tenni az emberi tényezővel? Amikor a kezelő furcsa vagy potenciálisan veszélyes parancsot ad a felhőnek, hirtelen kérheti, hogy oldjon meg egy kis feladatot, hogy ellenőrizze, mennyire jól gondolkodott. Például, ha valamilyen tömeges leállítás történik, vagy csak furcsa parancs — replikák számának csökkentése vagy a képkép neve megváltoztatása, nem csak a verziószám a új manifestben.
Összegzés
A one-cloud megkülönböztető jellemzői:
- Hierarchikus és áttekinthető szolgáltatás- és konténernevezési séma,, amely lehetővé teszi, hogy nagyon gyorsan megtudjuk, miről van szó, miről szól, hogyan működik, és ki felel érte.
- Saját prod és batch feladatok összevonásának technikájátalkalmazzuk a minionokon, hogy növeljük a gépek közötti hatékonyságot. cpuset helyett CPU kvótákat, részesedéseket, CPU ütemezési politikákat és Linux QoS-t használunk.
- Teljesen izolálni a gépen futó konténereket nem sikerült, de kölcsönhatásuk 20%-on belül marad.
- A szolgáltatások hierarchiájának megszervezése segít az automatizált vészhelyzeti eltávolításban helyezési és kiütési prioritások által..
GYIK
Miért nem használtunk kész megoldást.
- A különböző feladatizolációs osztályok eltérő logikát igényelnek a minionok elhelyezéséhez. Míg a prod feladatok egyszerű erőforrás-örökléssel helyezhetők el, a batch és idle feladatokat a gépek minionjainak valós erőforrás-kihozatala alapján kell elhelyezni.
- Az olyan erőforrások figyelembevételének szükségessége, mint:
- hálózati sávszélesség;
- lemezek típusa és "spindlek."
- A szolgáltatások prioritásának meghatározása a vészhelyzetek felszámolásakor, a csapatok erőforrásokkal kapcsolatos jogai és kvótái, amit hierarchikus sorokkal oldunk meg a one-cloudban.
- Az emberi nevek használata a konténerekhez a vészhelyzetekre és incidensekre való reakcióidő csökkentése érdekében.
- A Service Discovery egyidejű, általános bevezetésének lehetetlensége; a fémes hoszton elhelyezett feladatokkal való hosszú együttélés szükségessége — amit a konténerek mögötti "statikus" IP-címek megoldanak, és mint következmény, a nagy hálózati infrastruktúrával való egyedi integráció szükségessége.
Mindezek a funkciók jelentős átalakításokat igényelnének a meglévő megoldásokban, és a munka mennyiségét értékelve rájöttünk, hogy saját megoldásunkat hasonló erőfeszítésekkel tudjuk kifejleszteni. De a saját megoldásunk sokkal könnyebben működtethető és fejleszthető lesz - nincs benne felesleges absztrakció, amely a számunkra szükségtelen funkciókat támogatja.
Akik az utolsó sorokat olvassák - köszönjük a türelmüket és figyelmüket!
Forrás: habr.com
