

A 2015-ös Alexey Lesovsky előadás "Deep dive into PostgreSQL belső statisztikák" című előadásának értelmezése
Az előadó nyilatkozata: Megjegyzem, hogy ez az előadás 2015 novemberében készült — több mint 4 év eltelt, és sok idő telt el. Az előadásban tárgyalt 9.4-es verzió már nem támogatott. Az eltelt 4 év alatt 5 új kiadás történt, amelyek rengeteg újdonságot, fejlesztést és változást hoztak a statisztikák terén, és egyes anyagok elavulttá váltak. A felülvizsgálat során igyekeztem megjelölni ezeket a helyeket, hogy ne vezesselek tévedésbe, olvasó. Viszont nem írtam át ezeket a részeket, mert túl sok van belőlük, és végül egészen más előadás születne.
A PostgreSQL adatbázis-kezelő rendszer (DBMS) egy hatalmas mechanizmus, amely számos alrendszerből áll. Ezeknek a szigorúan összehangolt munkája közvetlenül befolyásolja a DBMS teljesítményét. Működés közben gyűjtik a statisztikákat és az információkat a komponensek munkájáról, ami lehetővé teszi a PostgreSQL hatékonyságának értékelését és a teljesítmény javítására tett intézkedések meghozatalát. Azonban rengeteg információ áll rendelkezésre, és ez meglehetősen leegyszerűsített formában van bemutatva. Ennek az információnak a feldolgozása és értelmezése olykor nem trivialitás, és az eszközök és utilitások "zooja" még a tapasztalt DBA-t is megzavarhatja.
Jó napot! A nevem Alexey. Ahogy Ilja említette, a PostgreSQL statisztikájáról fogok beszélni.
A PostgreSQL aktivitási statisztikája. A PostgreSQL-nek kétféle statisztikája van. Az aktivitási statisztika, amiről szó lesz, és a lekérdezéstervező statisztikája az adatok eloszlásáról. Kifejezetten az aktivitási statisztikáról fogok beszélni, amely lehetővé teszi számunkra a teljesítmény értékelését és javítását.
Elmondom, hogyan használhatjuk hatékonyan a statisztikát a különféle problémák megoldására, amelyek felmerülhetnek nálatok.
Mi nem lesz az előadásban? Az előadásban nem fogom érinteni a lekérdezéstervező statisztikáját, mivel ez egy külön téma, amely külön előadás tárgya arról, hogyan tárolják az adatokat az adatbázisban, és arról, hogy a lekérdezéstervező hogyan nyeri el az adatok minőségi és mennyiségi jellemzőit.
És nem lesznek eszközök áttekintése, nem fogom összehasonlítani az egyik terméket a másikkal. Semmiféle reklám nem lesz. Ezt hagyjuk el.
Szeretném megmutatni, hogy a statisztika használata hasznos. Szükség van rá. Használni nem félelmetes. Mindössze egy egyszerű SQL-re és alapvető SQL-ismeretekre lesz szükségünk.
És beszéljünk arról, hogy milyen statisztikát válasszunk a problémák megoldásához.
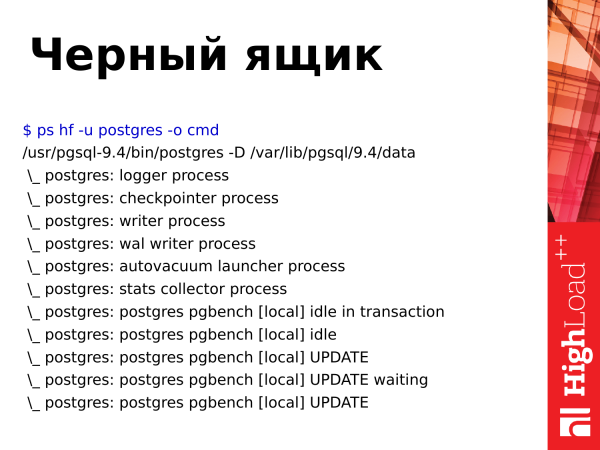
Ha megnézzük a PostgreSQL-t, és a műveletkezelő rendszerben futtatjuk a folyamatok megtekintésére szolgáló parancsot, akkor egy "fekete dobozt" fogunk látni. Látni fogunk valamilyen folyamatokat, amelyek valamit csinálnak, és a nevük alapján hozzávetőlegesen elképzelhetjük, mit is csinálnak. De tulajdonképpen ez egy fekete doboz, belenézni nem tudunk.
Megnézhetjük a processzor terheltségét top, megvizsgálhatjuk a memória kihasználtságát valamilyen rendszereszközökkel, de belenézni a PostgreSQL-be nem tudunk. Ehhez más eszközökre van szükségünk.
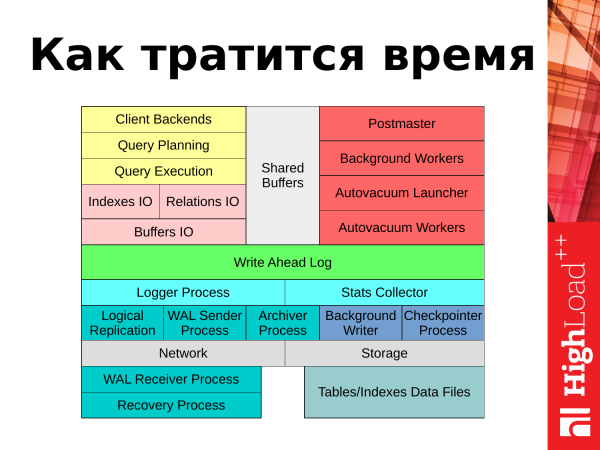
Folytatva, elmondom, hogy hová tűnik el az idő. Ha így képzeljük el a PostgreSQL-t, akkor válaszolhatunk arra, hogy hová tűnik el az idő. Két dologról van szó: ez a kliensalkalmazásoktól érkező kérdések feldolgozása és a háttérfeladatok, amelyeket a PostgreSQL végez a működése érdekében.
Ha a bal felső sarokból kezdjük vizsgálni, nyomon követhetjük, hogyan dolgozzák fel a klienskéréseket. A kérés az alkalmazástól érkezik, és a további munka érdekében egy kliens session nyílik. A kérés átkerül a tervezőbe. A tervező felépíti a kérés tervét. Továbbítja a végrehajtásra. Valamilyen blokkbeolvasás történik az adatokkal, amelyek táblákhoz és indexekhez kapcsolódnak. A szükséges adatokat a lemezekről a memóriába olvassák a "megosztott pufferek" speciális területén. A kérés eredményei, ha frissítések, törlések, a tranzakciós naplóban a WAL-ban rögzítődnek. Néhány statisztikai információ a naplóba vagy a statisztika gyűjtőbe kerül. A kérés eredményét visszaadják a kliensnek. Ezután a kliens újra megismételheti az egész folyamatot egy új kéréssel.
Mi a helyzet a háttérfeladatokkal és a háttérfolyamatokkal? Van néhány folyamatunk, amelyek biztosítják a működést és fenntartják az adatbázist a normál munkamenetben. Ezeket a folyamatokat szintén érinteni fogom a beszámolómban: ezek az autovacuum, a checkpointer, a replikációval kapcsolatos folyamatok, a háttéríró. Mindegyikről szó esik a beszámoló során.
Milyen problémák vannak a statisztikával?
- Sok információ van. A PostgreSQL 9.4 109 metrikát kínál az statisztikai adatok megtekintésére. Azonban, ha az adatbázisban sok táblázat, séma, vagy adatbázis található, akkor ezt a sok metrikát meg kell szorozni a megfelelő táblázatok, adatbázisok számával. Tehát az információ mennyisége még nagyobbá válik, és könnyű elveszni benne.
- A következő probléma az, hogy a statisztika számlálókkal van bemutatva. Ha megnézzük ezt a statisztikát, folyamatosan növekvő számlálókat látunk. És ha a statisztika visszaállítása óta nagyon sok idő telt el, milliárdos értékeket fogunk látni. Ezek viszont semmit sem mondanak nekünk.
- Nincs történet. Ha történt egy hiba, és valami 15-30 perccel ezelőtt leállt, nem tudunk visszatekinteni a statisztikára, hogy mit mutatott az előző 15-30 percben. Ez probléma.
- A PostgreSQL beépített eszközének hiánya probléma. A magfejlesztők nem kínálnak semmilyen használható eszközt. Nincs semmi ilyesmi. Csak a statisztikát adják az adatbázisban. Használja, kérjen le tőle, amit szeretne.
- Mivel nincs beépített eszköz a PostgreSQL-ben, ez egy másik problémahoz vezet. Sok külső eszköz van. Minden vállalat, amely rendelkezik némi képességgel, próbál valamilyen programot írni. Ennek eredményeként a közösségben rengeteg eszköz található, amelyeket a statisztikával való munkához használhatunk. Az egyes eszközök különböző lehetőségeket kínálnak; az egyikben van egy lehetőség, a másikban pedig nincs, esetleg vannak új lehetőségeik. Így szükség van két-három-négy eszközre, amelyek átfedik egymást és különböző funkciókat kínálnak. Ez nagyon kellemetlen.
Mire következtethetünk ebből? Fontos, hogy közvetlenül lehessen a statisztikát begyűjteni, hogy ne függjünk programoktól, vagy magunk számára javítsuk ezeket a programokat: adjunk hozzá néhány funkciót, hogy előnyre tegyünk szert.
Alapvető SQL tudásra van szükség. Ahhoz, hogy adatokat kapjunk a statisztikából, SQL lekérdezéseket kell készíteni, azaz tudni kell, hogyan állítsunk össze select, join lekérdezéseket.
A statisztika több dolgot kínál nekünk. Ezeket kategóriákra lehet osztani.
- Az első kategória az események, amelyek az adatbázisban történnek. Ez akkor fordul elő, amikor az adatbázisban valamilyen esemény zajlik: kérés, adatbázistáblához való hozzáférés, autovákuum, kötelezvények; ezek mind események. A megfelelő eseményekhez tartozó számlálók növekednek. Daarom nyomon követhetjük ezeket az eseményeket.
- A második kategória az objektumok tulajdonságai, mint például a táblák, adatbázisok. Ezeknek vannak tulajdonságaik. Például a táblák mérete. Nyomon követhetjük a táblák és indexek növekedését. Megnézhetjük a dinamika változásait is.
- A harmadik kategória az esemény végrehajtásához szükséges idő. A kérés egy esemény. Ennek van egy konkrét időtartama. Itt indult el, itt végződött. Nyomon tudjuk követni. Vagy a lemezről való blokkolás olvasási vagy írási ideje. Az ilyen dolgokat is nyomon követjük.
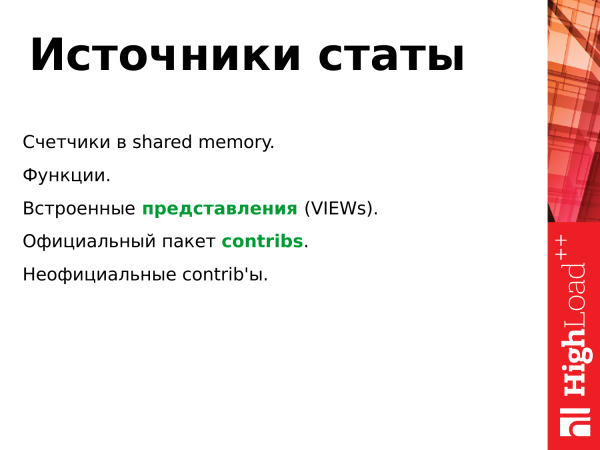
A statisztikák forrásai a következőképpen jelennek meg:
- A megosztott memóriában (shared buffers) van egy szegmens a statisztikai adatok elhelyezésére, amely tartalmazza azokat a számlálókat is, amelyek folyamatosan növekednek, amikor események vagy bármilyen esemény a bázis működése során felmerül.
- Ezek a számlálók nem elérhetők a felhasználók számára, és még az adminisztrátorok számára sem. Ezek alacsony szintű elemek. Ahhoz, hogy elérjük őket, a PostgreSQL SQL függvények formájában biztosít egy interfészt. Kérdéseket (select) használva ezeken a függvényeken keresztül néhány metrikát (vagy metrikák halmazát) kaphatunk.
- Azonban ezeknek a függvényeknek a használata nem mindig kényelmes, ezért a függvények az nézetek (VIEWs) alapjául szolgálnak. Ezek virtuális táblák, amelyek statisztikát nyújtanak egy adott alrendszerhez vagy az adatbázisban található események halmazához.
- Ezek a beépített nézetek (VIEWs) a felhasználó számára az statisztika kezelésének fő interfésze. Alapértelmezetten elérhetők bármilyen további konfiguráció nélkül, azonnal használhatók, információkat vonhatunk le belőlük. Továbbá léteznek official contrib csomagok is. Telepítheti a postgresql-contrib csomagot (például postgresql94-contrib), betöltheti a szükséges modult a konfigurációba, megadhatja a paramétereket, újraindíthatja a PostgreSQL-t, és használhatja. (Megjegyzés. A disztribúciótól függően az utolsó verziókban a contrib csomag a fő csomag része.).
- Vannak nem hivatalos contrib-ok is. Ezek nem tartoznak a PostgreSQL alapértelmezett telepítéséhez. Vagy le kell fordítani őket, vagy könyvtárként kell telepíteni. A lehetőségek a fejlesztő kreativitásától függően változatosak.
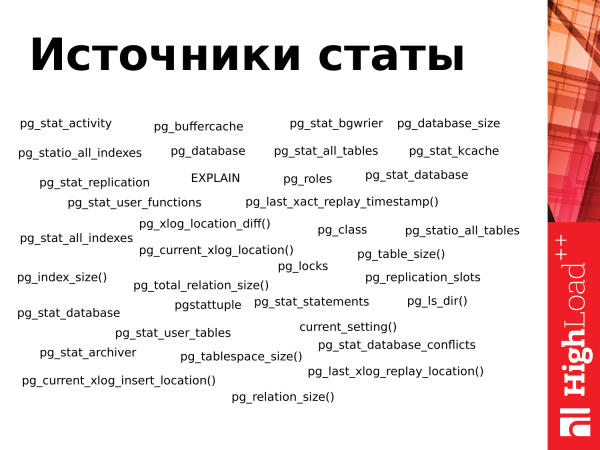
Ezen a dián látható az összes megjelenítés (VIEW) és egyes funkciók, amelyek elérhetőek a PostgreSQL 9.4-ben. Ahogy látjuk, nagyon sok van belőlük. Könnyű összezavarodni, ha először találkozunk ezzel.
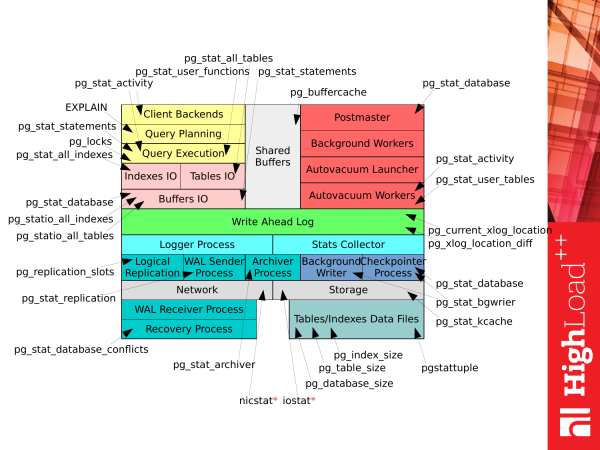
Azonban, ha megnézzük az előző képet Hogyan telik az idő a PostgreSQL-ből és összevetjük ezzel a listával, akkor egy ilyen képet kapunk. Minden egyes megjelenítést (VIEW) vagy funkciót különböző célokra használhatunk a megfelelő statisztikák megszerzésére, amikor a PostgreSQL működik. Így már információkat nyerhetünk a rendszer működéséről.
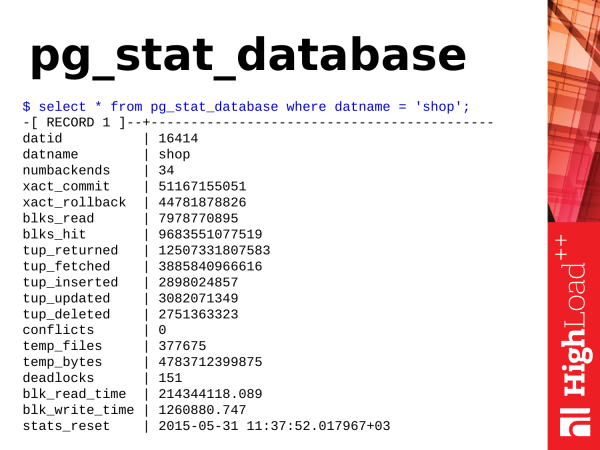
Az első, amit megvizsgálunk, az a pg_stat_database. Ahogy látjuk, ez egy megjelenítés. Rengeteg információ található benne. A legkülönfélébb információk. Nagyon hasznos tudást ad nekünk, hogy mi történik az adatbázisban.
Mit tudunk hasznosítani innen? Kezdjük a legegyszerűbb dolgokkal.
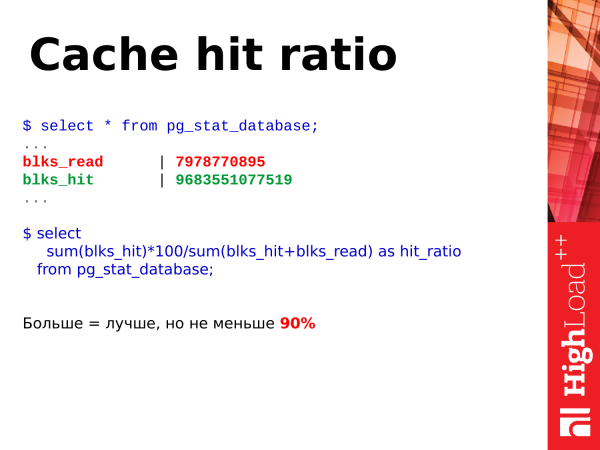
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Az első, amit megnézhetünk – ez a cache-beesési arány. A cache-beesési arány egy hasznos mutató. Megmutatja, hogy a megosztott pufferből hány adatot használnak fel, és mennyi olvasódik lemezről.
Nyilvánvaló, hogy minél nagyobb a cache-beesésünk, annál jobb. Ezt a mutatót százalékban értékeljük. Például, ha a cache-beesési arány meghaladja a 90 %-ot, akkor ez jó. Ha 90 % alá csökken, az azt jelenti, hogy a memória nem elegendő a „forró” adatok memóriaalapú tárolásához. Ahhoz, hogy ezeket az adatokat felhasználhassuk, a PostgreSQL kénytelen a lemezhez fordulni, ami lassabb, mint amikor az adatok a memóriából olvasódnak. Ekkor már gondolkodni kell a memória növelésén: vagy a megosztott puffert kell növelni, vagy a RAM-ot kell bővíteni.
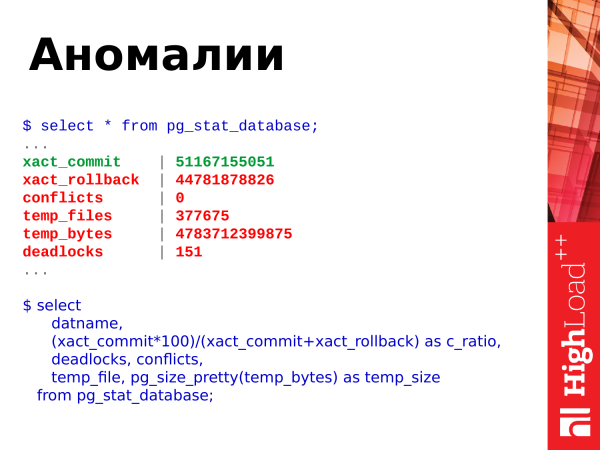
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Mit lehet még megfigyelni ebben a megjelenítésben? Megnézhetjük az adatbázisban zajló anomáliákat. Mi látható itt? Itt vannak commitok, rollbackek, ideiglenes fájlok létrehozása, azok mérete, deadlockok és konfliktusok.
Ezt a lekérdezést használhatjuk. Ez az SQL eléggé egyszerű. Nézhetjük ezeket az adatokat nálunk.
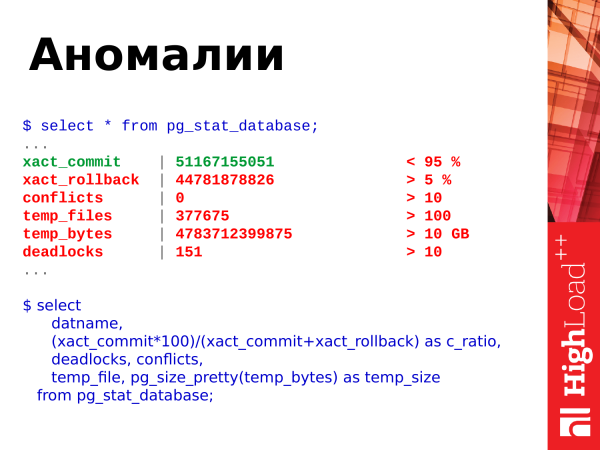
Itt vannak a határértékek is. A commits és rollbacks arányát nézzük. A commits a tranzakció sikeres megerősítése. A rollbacks pedig a visszagörgetés, azaz a tranzakció végrehajtott valamilyen munkát, terhelte az adatbázist, valamit számolt, majd hiba történt, és a tranzakció eredményeit elvetik. Azaz a folyamatosan növekvő rollbacks száma rossz. Ezt valahogyan el kell kerülni, és a kódot javítani kell, hogy ilyen ne történjen.
A konfliktusok a replikációval kapcsolatosak. Ezeket is el kell kerülni. Ha vannak olyan lekérdezései, amelyek a replikán futnak, és konfliktusok lépnek fel, akkor ezeket a konfliktusokat elemezni kell, megnézni, mi történik. A részletek a naplóban találhatóak. A konfliktusos helyzeteket meg kell szüntetni, hogy az alkalmazás lekérdezései hibamentesen működjenek.
A holtpontok szintén rossz helyzetet jelentenek. Amikor a lekérdezések erőforrásokért küzdenek, az egyik lekérdezés egy erőforráshoz fordul és lezárja, a másik lekérdezés a második erőforráshoz fordul és szintén lezárja, majd mindkét lekérdezés a másik erőforráshoz fordul és várakozásba kerül, amíg a szomszéd fel nem oldja a zárolást. Ez is problémás helyzet. Ezeket a problémákat az alkalmazások újraírásával és az erőforrásokhoz való hozzáférés sorosításával kell megoldani. Ha látja, hogy a holtpontok folyamatosan növekednek, akkor meg kell nézni a részleteket a naplóban, elemezni a felmerülő helyzeteket és megnézni, mi a probléma.
A dobozok (temp_files) is rossz dolog. Amikor a felhasználói lekérdezésnek nincs elég memóriája az operatív, ideiglenes adatok tárolásához, akkor fájlt hoz létre a lemezen. És minden műveletet, amit a memóriában ideiglenes pufferként végezhetne, már a lemezen hajt végre. Ez lassú. Ez növeli a lekérdezés végrehajtási idejét. Az ügyfél, aki lekérdezést küldött a PostgreSQL-nek, kicsit később kap választ. Ha minden műveletet a memóriában hajtanak végre, a Postgres sokkal gyorsabban válaszol, és az ügyfél kevesebbet várakozik.
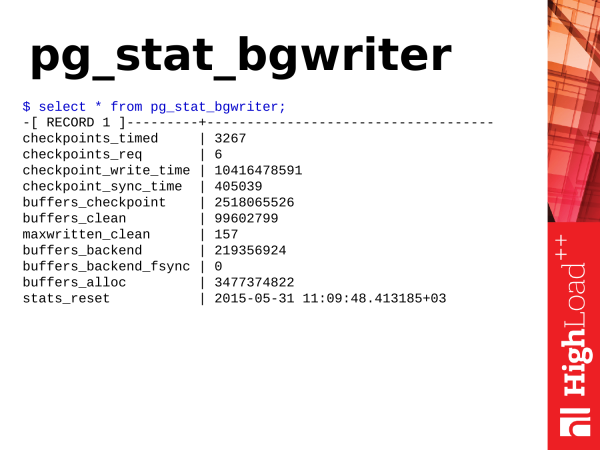
A pg_stat_bgwriter egy nézet, amely a PostgreSQL két háttérszolgáltatásának működését írja le: ez a ellenőrzőpont (checkpointer) és háttéríró (background writer).
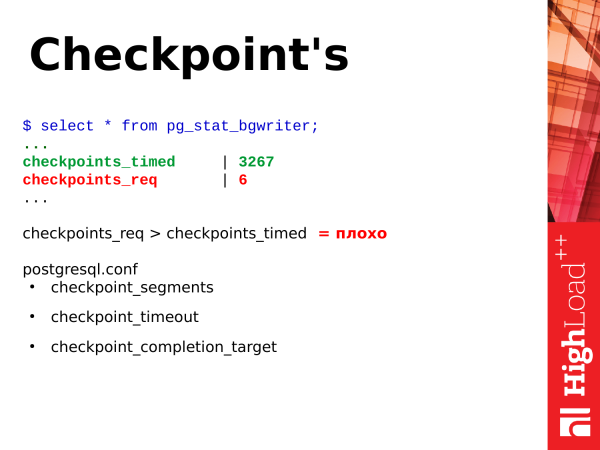
Először nézzük meg az ellenőrzőpontokat, az úgynevezett ellenőrzőpontok (checkpoints). Mi az ellenőrzési pontok? Az ellenőrzési pont egy olyan pozíció a tranzakciós naplóban, amely arról tájékoztat, hogy az összes, a naplóban rögzített adatváltoztatás sikeresen szinkronizálva lett a lemezen lévő adatokkal. A folyamat, a munkaterheléstől és a beállításoktól függően, hosszú időt vehet igénybe, és alapvetően a koszos oldalak szinkronizálásáról szól a megosztott pufferekben a lemezen lévő adatfájlokkal. Mire van ez szükség? Ha a PostgreSQL folyamatosan a lemezekhez fordulna, és minden egyes híváskor adatokat olvasna és írna, az nagyon lassú lenne. Ezért a PostgreSQL egy memóriaterületet hoz létre, amelynek mérete a konfigurációs paraméterektől függ. A Postgres itt helyezi el a működő adatokat, amelyek később feldolgozásra vagy lekérdezések kiadására kerülnek. Az adatok megváltoztatása esetén azok módosulnak. Két verzió adatot kapunk. Az egyik a memóriában van, a másik a lemezen. Ezeket az adatokat időről időre szinkronizálni kell. A memóriában módosított adatokat a lemezre kell szinkronizálnunk. Ehhez szükséges az ellenőrzési pont.
Az ellenőrzési pont a megosztott puffereken halad át, megjelöli a koszos oldalakat, mint amelyekre szükség van az ellenőrzési pontra. Ezután elindít egy második áthaladást a megosztott puffereken. Azokat az oldalakat, amelyeket már megjelöltek, szinkronizálja. Így a szinkronizálás már a lemezzel történik.
Kétféle ellenőrzési pont létezik. Az egyik ellenőrzési pont időkorlát alapján történik. Ez az ellenőrzési pont hasznos és jó – checkpoint_timed. És vannak a szükség szerinti ellenőrzési pontok – checkpoint required. Ilyen ellenőrzési pont akkor történik, amikor nagyon nagy mennyiségű adatot rögzítünk. Nagyon sok tranzakciós naplót írtunk. A PostgreSQL úgy értékeli, hogy ezt minél gyorsabban szinkronizálnia kell, létrehozni egy ellenőrzési pontot és tovább élni.
És ha megnézted a statisztikát, pg_stat_bgwriter és láttad, hogy a checkpoint_req sokkal magasabb, mint a checkpoint_timed, akkor ez rossz. Miért rossz? Ez azt jelenti, hogy a PostgreSQL folyamatos stresszelésben van, amikor az adatokat a lemezre kell írnia. Az időkorlátos ellenőrzési pont kevésbé stresszes, és belső ütemterv szerint történik, és időben elnyújtott. A PostgreSQL képes szüneteket tartani a működésében, and nem terheli a lemezes rendszert. Ez a PostgreSQL számára előnyös. Azok a lekérdezések, amelyek az ellenőrzési pont alatt futnak, nem fognak stresszelni amiatt, hogy a lemezes rendszer foglalt.
És a checkpoint beállításához három paraméter létezik:
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
Ezek segítségével szabályozható a checkpointok működése. De nem szeretném hosszasan tárgyalni őket. A hatásuk már egy külön téma.
Figyelem: A jelentésben tárgyalt 9.4-es verzió már elavult. A modern PostgreSQL verziókban a checkpoint_segments paramétert a következő paraméterek helyettesítik: min_wal_size és max_wal_size.
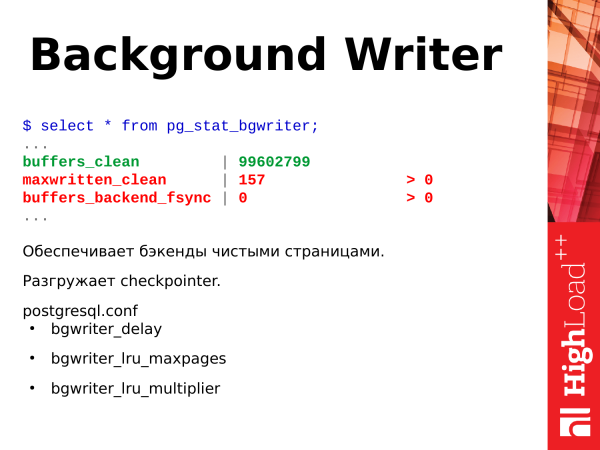
A következő alrendszer a háttéríró — háttéríró (background writer)Mit csinál? Folyamatosan, végtelen ciklusban dolgozik. Átvizsgálja a shared buffers lapjait, és a koszos lapokat, amiket talál, a lemezre íródnak. Így segít a checkpointernek, hogy kevesebb munkát végezzen a checkpointok végrehajtása során.
Mire van még szüksége? Biztosítja a tiszta lapok szükségletét a shared buffersben, ha esetleg, egyszerre nagy mennyiségben szükség lenne rájuk az adatok elhelyezéséhez. Tegyük fel, hogy olyan helyzet állt elő, amikor egy lekérdezés végrehajtásához tiszta lapokra van szükség, és azok már a shared buffersben vannak. A PostgreSQL backend egyszerűen csak felhasználja őket, nem kell semmit tisztítania. De ha véletlenül nincsenek ilyen lapok, a backend leállítja a munkát, és elkezd keresni lapokat, hogy azokat a lemezre írja és felhasználja a saját szükségleteihez – ami negatívan hat a jelenleg futó lekérdezés időtartamára. Ha látja, hogy a maxwritten_clean paramétere magas, az azt jelenti, hogy a háttéríró nem végzi el jól a feladatát, és növelni kell a bgwriter_lru_maxpages, hogy egy ciklusban több munkát tudjon végezni, több lapot tisztíthasson.
Egy másik nagyon hasznos mutató pedig a buffers_backend_fsync. A back-endek nem hajtanak végre fsync-et, mert ez lassú. Átadják az fsync-et a checkpointernek a IO stack-en. A checkpointernek van saját várólistája, időnként fsync-et kezel és a memóriában lévő lapokat szinkronizálja a lemezen található fájlokkal. Ha a checkpointer várólistája hosszú és tele van, akkor a backendnek magának kell fsync-et végrehajtania, ami lelassítja a backend működését,így a kliens később kap választ, mint amennyire képes lenne. Ha látja, hogy ez az érték nagyobb, mint nulla, akkor ez már probléma, és figyelmet kell fordítani a háttéríró beállításaira, és értékelni kell a lemezalrendszer teljesítményét.
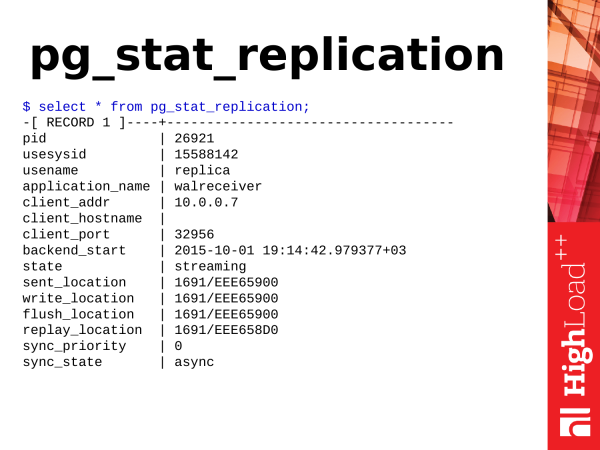
Figyelem: _A következő szöveg a replikációhoz kapcsolódó statisztikai nézetekről szól. A funkciók és nézetek neveinek nagy része a Postgres 10-ben lett átnevezve. Az átnevezések lényege a következőre redukálódik: xlog Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata wal és location Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata a funkciók/nézetek neveiben stb. Külön példa, hogy a pg_xlog_location_diff() függvény át lett nevezve pg_wal_lsn_diff()-ra. Itt is sok minden van. De nekünk csak a location-nel kapcsolatos elemekre lesz szükségünk.._
Ha látjuk, hogy az összes érték egyenlő, akkor ez a tökéletes eset, és a replikáció nem késik el a főadatbázistól.
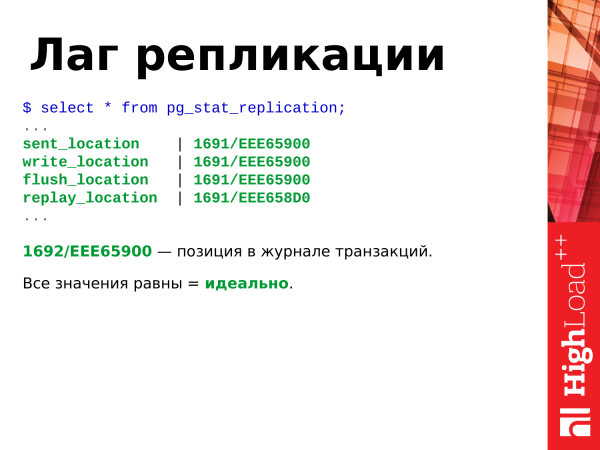
Ez a hexadecimális pozíció a tranzakciós naplóban található pozíció. Folyamatosan növekszik, ha a bázison van valamilyen aktivitás: beszúrások, törlések stb.
mennyi xlog lett rögzítve byte-ban $ select pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000'); replikációs késés byte-ban $ select client_addr, pg_xlog_location_diff(pg_current_xlog_location(), replay_location) fog a pg_stat_replication; replikációs késés másodpercben $ select extract(epoch from now() - pg_last_xact_replay_timestamp());
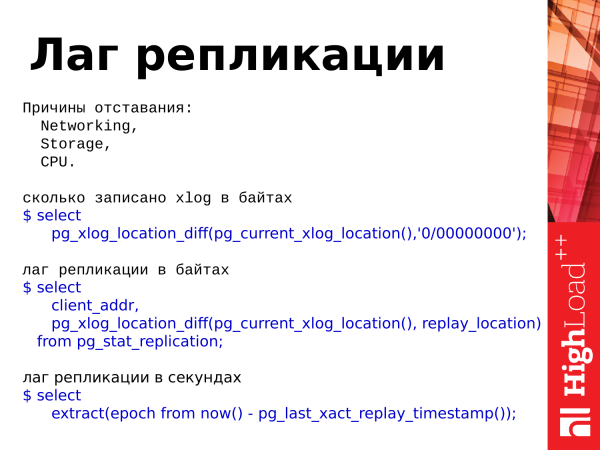
Ha ezek a dolgok eltérnek, akkor valamilyen késés létezik. A késés azt jelenti, hogy a replikáció lemarad a főadatbázistól, azaz az adatok eltérnek a szerverek között.Három oka van a lemaradásnak:
Ez a lemezes alrendszer nem bír a fájlok szinkronizálási írásával.
- Ez lehetőségeket jelenthet a hálózati hibákra, vagy a hálózat túlterheltségére, amikor az adatok nem érik el időben a replikát, és ezért nem tudja reprodukálni azokat.
- És a processzor. A processzor – ez nagyon ritka eset. Én ilyet csak kétszer vagy háromszor láttam, de ez is lehetséges.
- Íme három kérdés, amelyek lehetővé teszik számunkra, hogy használjuk a statisztikát. Meg tudjuk becsülni, mennyi lett rögzítve a tranzakciós naplóban. Van egy ilyen funkció:
pg_xlog_location_diff és meg tudjuk becsülni a replikáció késését byte-ban és másodpercekben. Ezt is ennek a nézetnek (VIEW) az értékét használjuk. _A pg_xlog_location
Megjegyzés: diff() függvény helyett használhatjuk a kivonási operátort, és kivonhatjuk az egyik location-t a másiktól. Ez kényelmes.A másodperces késéssel van egy dolog. Ha a főadatbázison nincs aktivitás, és a tranzakció 15 perccel ezelőtt történt, és nincs aktivitás, ha pedig a replikán megnézzük ezt a késést, akkor egy 15 perces késést fogunk látni. Ezt érdemes észben tartani. Ez zavarba ejthet, amikor megnézzük ezt a késést.
Van egy dolog a másodpercekben mért késleltetéssel kapcsolatban. Ha a mesterállomáson nincs aktivitás, a tranzakció körülbelül 15 perccel ezelőtt történt, és nincs semmilyen aktivitás, és ha a replikán megnézzük ezt a késleltetést, akkor 15 perces késleltetést fogunk látni. Ezt érdemes észben tartani. Ez zavarba ejtő lehet, amikor ránézel erre a késleltetésre.
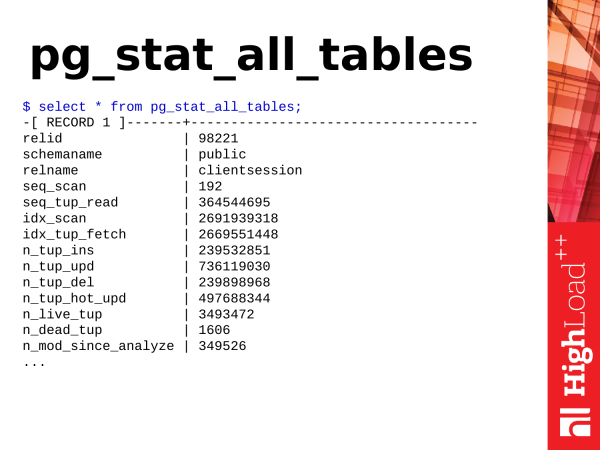
A pg_stat_all_tables – another useful view. It shows statistics for tables. When we have tables in our database and there is some activity or certain actions, we can retrieve that information from this view.
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
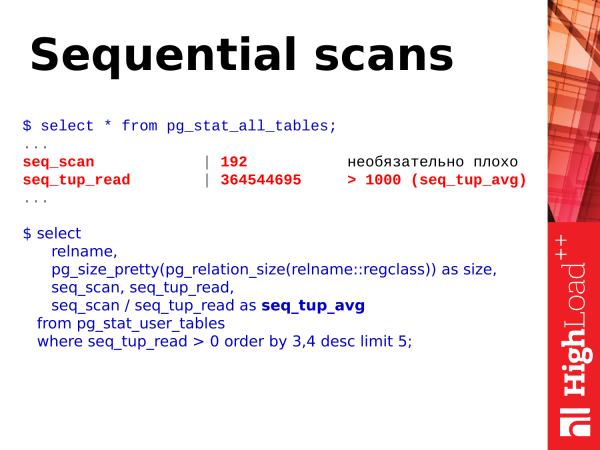
The first thing we can look at is the sequential scans for a table. The number itself after these scans is not necessarily bad and does not indicate that we need to take action immediately.
However, there is a second metric – seq_tup_read. This is the number of rows returned as a result of the sequential scan. If the average number exceeds 1,000, 10,000, 50,000, 100,000, then this is an indicator that you may need to create an index somewhere so that accesses happen via the index, or you may need to optimize the queries that use such sequential scans to avoid this.
A simple example – suppose a query with a large OFFSET and LIMIT is being executed. For example, scanning 100,000 rows in the table and then taking 50,000 necessary rows, while the previously scanned rows are discarded. This is also a bad case. Such queries need to be optimized. Here is a simple SQL query that can help you view and assess the obtained figures.
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
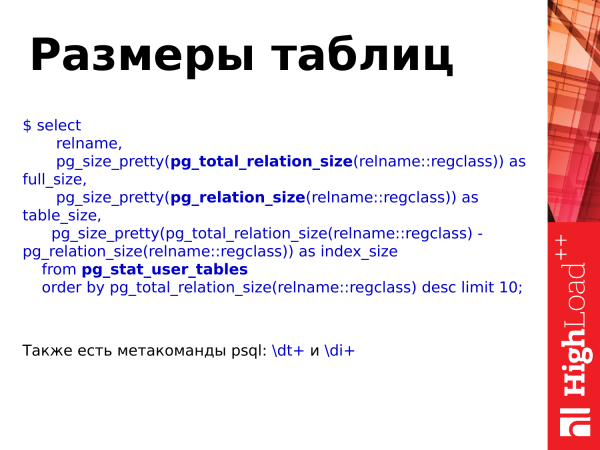
Table sizes can also be obtained using this table and through additional functions. pg_total_relation_size(), pg_relation_size().
In general, there are meta-commands dt és di, which can be used in PSQL to also view the sizes of tables and indexes.
However, using functions helps us look at table sizes considering indexes or excluding indexes, and then make some assessments based on the growth of the database, i.e., how it is growing, at what intensity, and then draw conclusions about optimizing sizes.
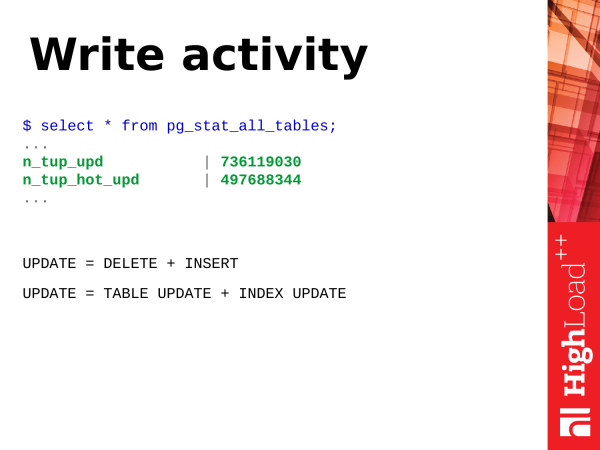
Write activity. What is a write operation? Let's consider the operation. UPDATE – a sorok frissítése a táblázatban. Alapvetően az update két művelet (vagy akár még több). Ez az új verzió beszúrása és a régi verzió elavultként való megjelölése. Később jön az automatikus vákuum, ami eltávolítja ezeket az elavult verziókat, és a helyet újrahasználhatóként jelöli meg.
Ezen kívül az update nemcsak a táblázat frissítése. Ez egyúttal az indexek frissítése is. Ha sok index van a táblázaton, akkor az update során az összes olyan indexet, amelyben a lekérdezés által frissített mezők szerepelnek, szintén frissíteni kell. Ezekben az indexekben szintén elavult verziók lesznek, amelyeket el kell távolítani.
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
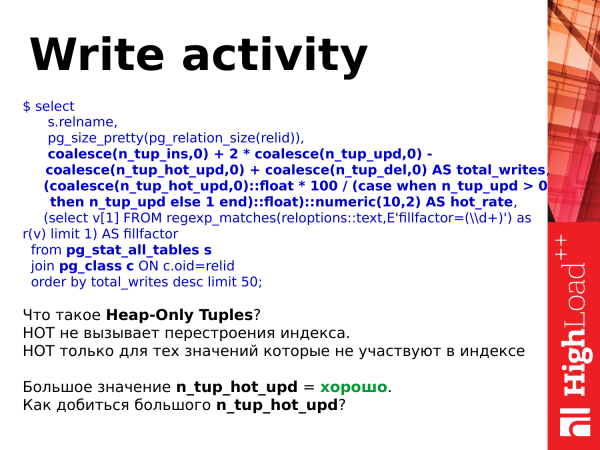
És a dizájnja miatt az UPDATE nehéz művelet. De könnyebbé tehető. Van hot updates. Ezek a PostgreSQL 8.3 verziójában jelentek meg. Mi ez? Ez egy könnyűsúlyú frissítés, amely nem okoz indexátalakítást. Vagyis frissítettük a rekordot, de a csak a táblázathoz tartozó oldal rekordja frissült, míg az indexek továbbra is ugyanarra a rekordre mutatnak az oldalon. Itt egy érdekes logika működik, amikor a vákuum befut, akkor ezeket a láncokat hot újraépíti, és minden működik anélkül, hogy az indexeket frissíteni kellene, és az erőforrások felhasználása is csökken.
És amikor a n_tup_hot_upd nagy, akkor ez nagyon jó. Ez azt jelenti, hogy a könnyű súlyú frissítések dominálnak, és az erőforrások számára ez olcsóbb, és minden nagyszerű.
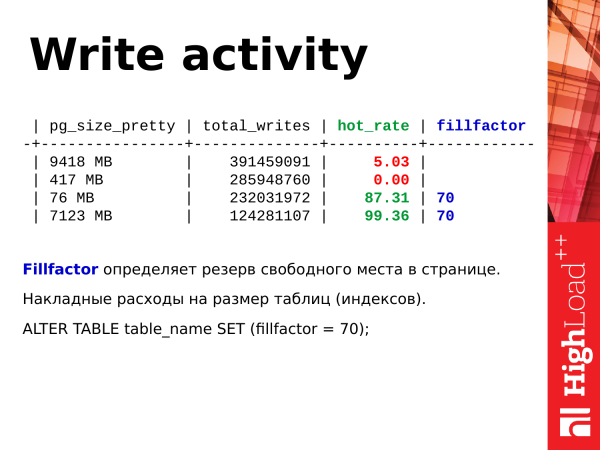
ALTER TABLE table_name SET (fillfactor = 70);Hogyan növeljük meg a hot updateok számát? Használhatjuk a fillfactor-t. Ez meghatározza a szabad hely méretét, amelyet a táblázatban az INSERT-ekkel történő feltöltés során fenntartanak. Amikor a táblázatba beírások érkeznek, akkor teljesen kitöltik az oldalt, nem hagyva üres helyet benne. Aztán egy új oldal kerül kijelölésre. Ismét adatok töltődnek be. Ez az alapértelmezett viselkedés, fillfactor = 100 %.
A fillfactor értékét 70%-ra állíthatjuk. Ez azt jelenti, hogy amikor bejegyzéseket adunk hozzá, új oldal jön létre, de csak az oldal 70%-a töltődik ki. Így 30% marad tartalékban. Amikor frissíteni szükséges, nagy valószínűséggel a meglévő oldalon történik, és az új sor verziója ugyanoda kerül. Így hot_update készül. Ez megkönnyíti az adatok rögzítését a táblákon.
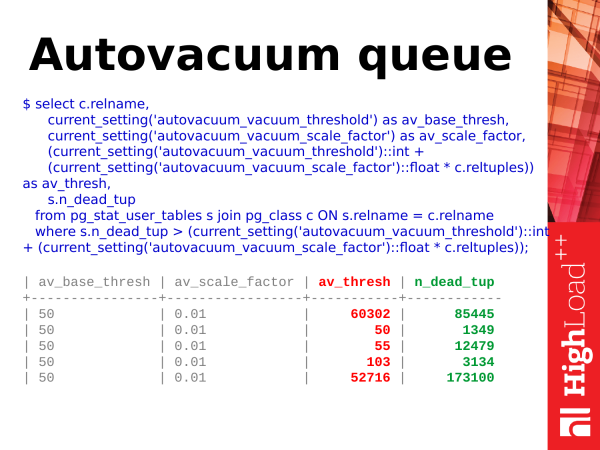
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
Az autovákum sor. Az autovákum egy olyan alrendszer, amelyről a PostgreSQL statisztikákban nagyon keveset tudunk. A pg_stat_activity táblákban csak annyit láthatunk, hány vákum fut éppen. Azonban nagyon nehéz megérteni, hány tábla van sorban.
Megjegyzés: _A PostgreSQL 10-es verziójától kezdődően jelentősen javult a vákum nyomon követésének helyzete — megjelent a pg_stat_progress nézet.vákum, amely jelentősen megkönnyíti az autovákum megfigyelését.
Használhatunk egy egyszerűsített lekérdezést. Megnézhetjük, mikor fog jönni a vákum. De hogyan és mikor kell elindítani a vákumot? Ezek az elavult sorok, amikről korábban beszéltem. A frissítés történt, az új sor verziója beszúródott. Megjelent az elavult sor verziója. A táblában pg_stat_user_tables van egy ilyen paraméter n_dead_tup. Ez mutatja a "halott" sorok számát. Amint a halott sorok száma meghaladja a megadott küszöböt, az autovákum eljön a táblához.
És hogyan számítják ki ezt a küszöböt? Ez egy jól meghatározott százalékos arány az összes sor számához képest a táblában. Van egy paraméter autovacuum_vacuum_scale_factor. Ez határozza meg a százalékos arányt. Tegyük fel, 10% + egy alap küszöb 50 sorral. Mi történik? Amikor a halott sorok száma meghaladja a "10% + 50"-et az összes sor számához képest a táblában, akkor az autovákumra helyezzük a táblát.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
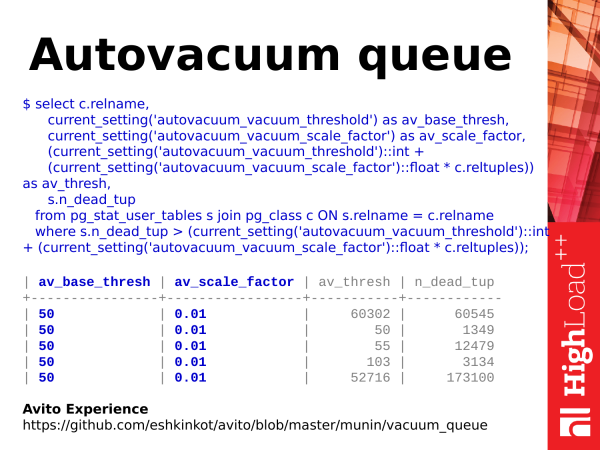
Viszont van egy kis megjegyzés. Az alap küszöbök a av_base_thresh és és az av_scale_factor paraméterekhez tartoznak. ezeket egyénileg lehet meghatározni. Így tehát a küszöb nem globális, hanem egyedi a táblázathoz. Ezért a kiszámításhoz trükköket és fortélyokat kell használni. Ha érdekli, megnézheti kollégáink tapasztalatait az Avito-nál (a dián található link érvénytelen és a szövegben frissítve van).
Írtak a , amely figyelembe veszi ezeket a dolgokat. Ott egy kétoldalas terjedelem található. De helyesen számol, és egész hatékonyan lehetővé teszi, hogy értékeljük, hol van sok vákuum szükség a táblázatokhoz, és hol van kevés.
Mit tehetünk ezzel? Ha nagy a sor, és az automatikus vákuum nem birkózik meg, akkor növelhetjük a vákuum munkásainak számát, vagy egyszerűen agresszívebbé tehetjük a vákuumot, hogy hamarabb triggereljék, és kis darabokban kezelje a táblázatot. Így a sor csökkenni fog. — Főleg itt figyelni kell a lemezek terhelésére, mivel a vákuum nem ingyenes dolog, bár az SSD/NVMe eszközök megjelenésével a probléma kevésbé észlelhetővé vált.
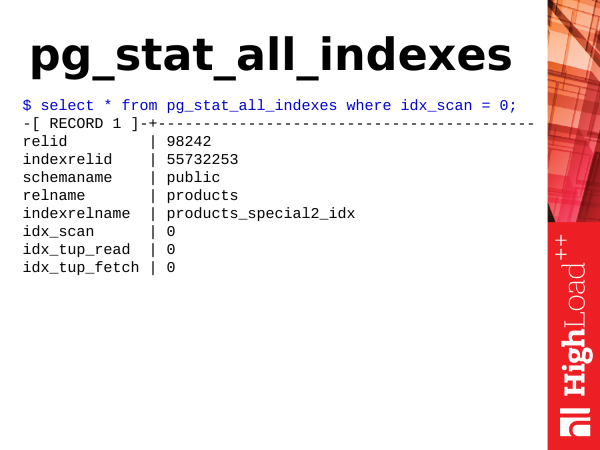
Pg_stat_all_indexes – ez a mutatókról szóló statisztika. Kicsi. Ezen keresztül információt kaphatunk a mutatók használatáról. Például meg tudjuk határozni, hogy mely mutatók feleslegesek számunkra.
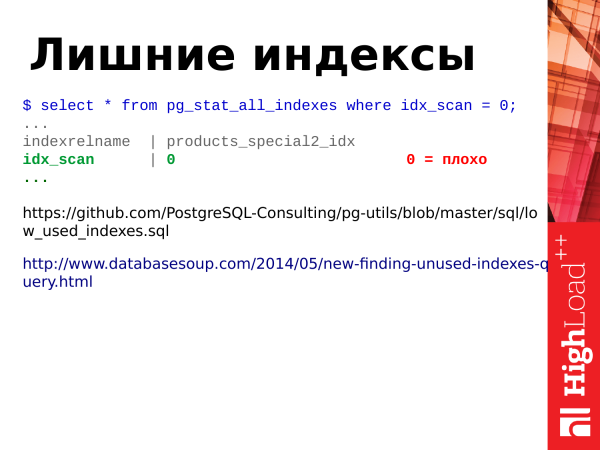
Ahogy már mondtam, update – nemcsak a táblák frissítése, hanem a mutatók frissítése is. Ennek megfelelően, ha a táblán sok mutató van, akkor a sorok frissítésekor a mutatott mezők indexeit is frissíteni kell, és ha vannak használaton kívüli mutatók, amelyekre nincs indexkeresés, akkor azok nekünk tehertételt képeznek. És ezt meg kell szabadulnunk. Ehhez szükségünk van egy mezőre idx_scan. Egyszerűen megnézzük az indexkeresések számát. Ha az indexeknek nulla keresésük van relatív hosszú statisztikai tárolási idő alatt (legalább 2-3 hét), akkor valószínűleg rossz mutatókról van szó, amelyektől meg kell szabadulnunk.
Megjegyzés: A használaton kívüli mutatók keresésekor a klaszterek streaming replikációs esetében ellenőrizni kell az összes klasztercsomópontot, mert a statisztika nem globális, és ha a mutató nem használatos a master-en, akkor a replikákon használható (ha ott terhelés van).
Két hivatkozás:
Ezek fejlettebb példa lekérdezések arról, hogyan lehet keresni a használaton kívüli mutatókat.
A második hivatkozás egy meglehetősen érdekes kérdés. Nagyon nem triviális logika rejlik benne. Javaslom, hogy nézze meg.
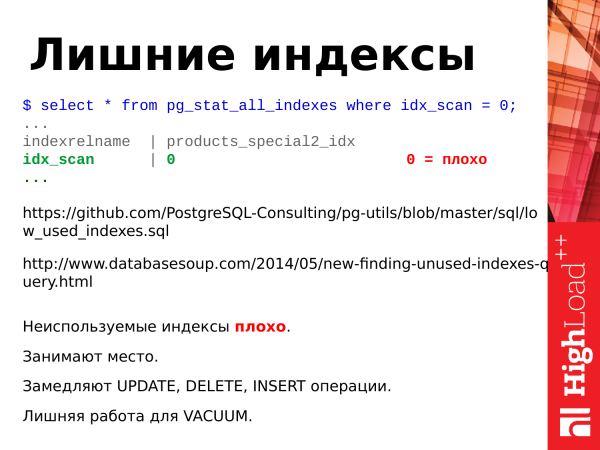
Mit érdemes még összegezni az indexekkel kapcsolatban?
A fel nem használt indexek nem jók.
Helyet foglalnak el.
Lassítják a frissítési műveleteket.
Felesleges munka a vákuumban.
Ha eltávolítjuk a fel nem használt indexeket, csak jót teszünk az adatbázisnak.
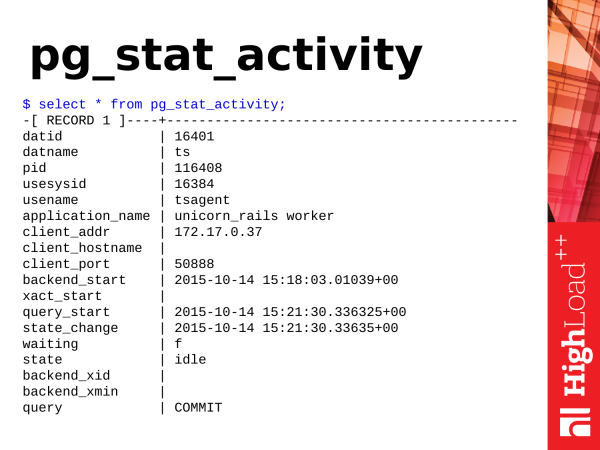
A következő bemutató - ez pg_stat_activity. Ez a segédprogram analógja A folyamatok listájának megjelenítése., csak PostgreSQL-ben. Ha A folyamatok listájának megjelenítése.az ‘top’ paranccsal nézed a rendszerfolyamatokat, akkor pg_stat_activity megmutatja a PostgreSQL-en belüli aktivitást.
Mit hasznosíthatunk innen?
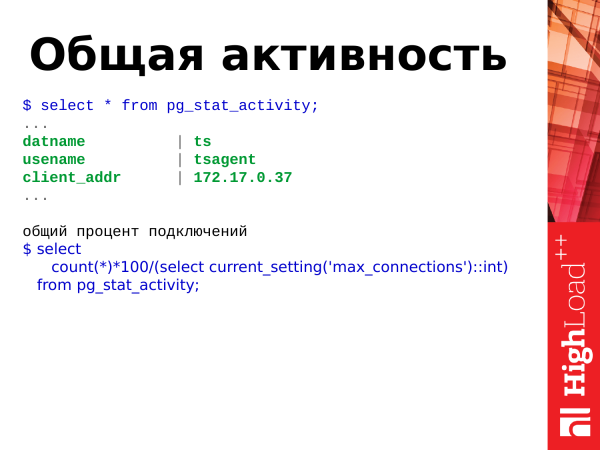
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Megnézhetjük az általános aktivitást, hogy mi történik az adatbázisban. Új telepítést is végrehajthatunk. Ott mindent szétszórtunk, új kapcsolatok nem fogadhatók, hibák ömlenek az alkalmazásba.
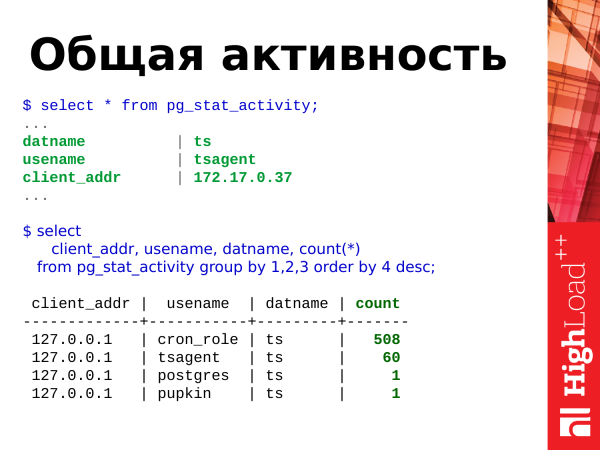
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Végrehajthatunk egy ilyen lekérdezést, és megnézhetjük a kapcsolatok általános arányát a maximális kapcsolatok számához képest, és megnézhetjük, ki foglalja el a legtöbb kapcsolatot. Az adott példánkban látjuk, hogy a felhasználó cron_role 508 kapcsolatot nyitott. Valami történt vele. Foglalkozni kell vele, és valószínű, hogy ez valamilyen rendellenes kapcsolatszám.
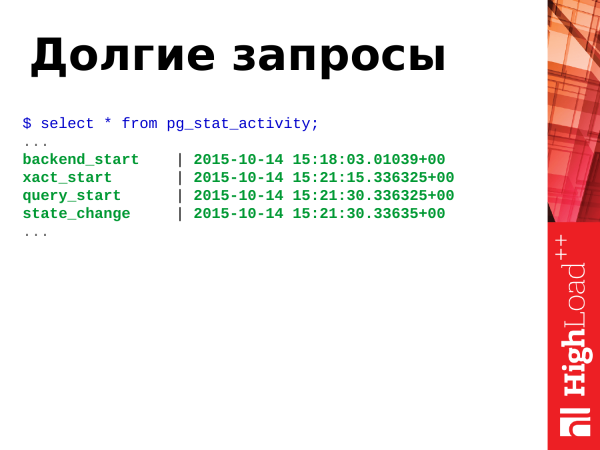
Ha OLTP terhelésünk van, a lekérdezéseknek gyorsan kell futniuk, nagyon gyorsan, és nem lenne szabad hosszú lekérdezéseknek lennie. Ha azonban hosszú lekérdezések lépnek fel, akkor rövid távon nincs semmi ijesztő, de hosszú távon a hosszú lekérdezések ártanak az adatbázisnak, növelik a táblák bloat hatását, amikor a táblák fragmentálódtak. A bloat és a hosszú lekérdezések eltávolítása szükséges.
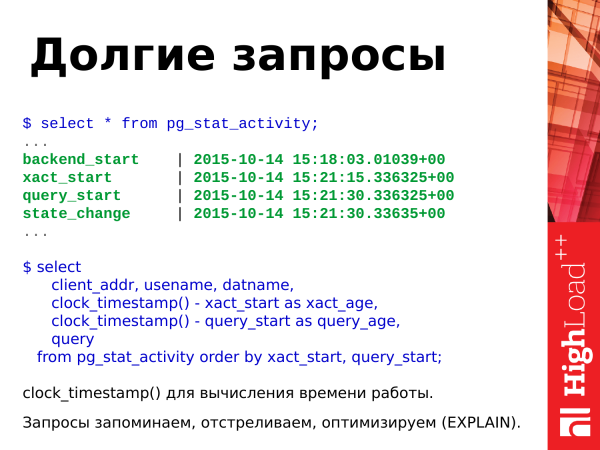
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Figyeljen: ezzel a lekérdezéssel meghatározhatjuk a hosszú lekérdezéseket és tranzakciókat. Az clock_timestamp() függvényt használjuk a futási idő meghatározására. A hosszú lekérdezéseket, amelyeket találtunk, megjegyezhetjük, végrehajthatjuk explain, megnézhetjük a terveket, és valahogy optimalizálhatjuk őket. A jelenlegi hosszú lekérdezéseket megszüntetjük, és folytatjuk az életünket.
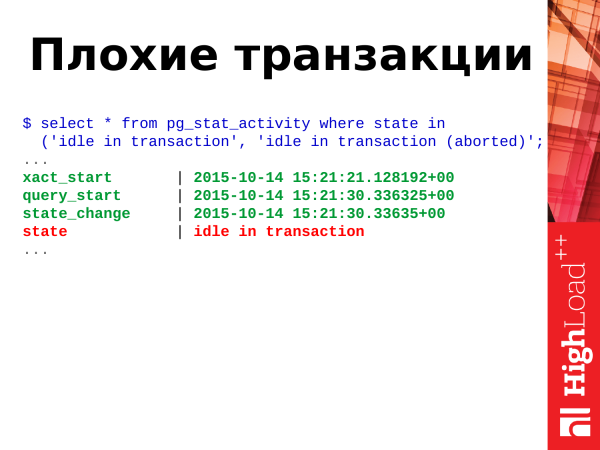
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
A rossz tranzakciók az idle in transaction és az idle in transaction (aborted) állapotú tranzakciók.
Mit jelent ez? A tranzakcióknak több állapota van. Ezen állapotok bármikor felvehetők. Az állapotok meghatározásához van egy mező state ebben a nézetben. Ezt használjuk az állapot meghatározására.
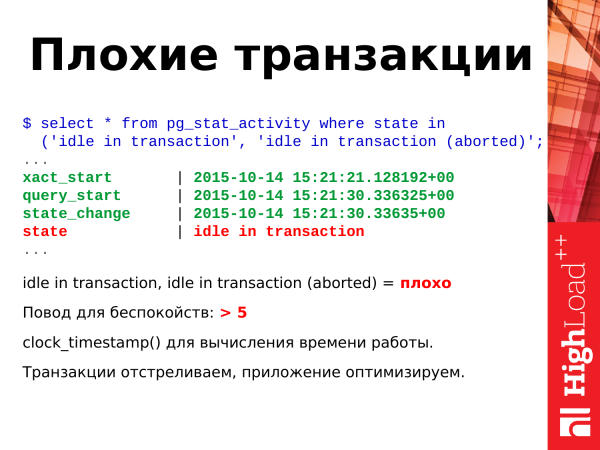
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Ahogy már említettem, ezek a két állapot idle in transaction és idle in transaction (aborted) – rossz. Mi ez? Amikor az alkalmazás megnyitott egy tranzakciót, végrehajtott néhány műveletet, majd elment a saját dolgára. A tranzakció nyitva maradt. Fennmarad, nem történik benne semmi, foglalja a kapcsolatot, blokkolja a módosított sorokat, és potenciálisan még más táblák bloat-ját is növelheti a Postgres tranzakciós motorjának architektúrája miatt. Az ilyen tranzakcióktól is megszabadulunk, mert ezek általában ártalmasak, bármely helyzetben.
Ha azt látja, hogy ezek száma a direktóriában meghaladja az 5-10-20-at, akkor már érdemes aggodalmaskodni, és kezdeni valamit velük.
Itt az időszámítás során is használunk clock_timestamp(). A tranzakciókat megszabadítjuk, az alkalmazást optimalizáljuk.
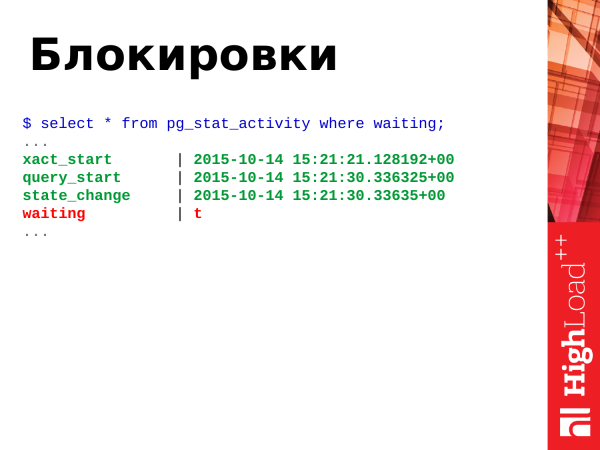
Mint már említettem, a blokkolások – ez amikor két vagy több tranzakció harcol egy vagy több erőforrásért. Erre van egy mezőnk waiting logikai értékkel igaz vagy hamis.
True – ez azt jelenti, hogy a folyamat várakozik, valamit tenni kell. Amikor a folyamat várakozik, akkor a kliens, aki elindította ezt a folyamatot, szintén vár. A kliens a böngészőben ül és szintén várakozik.
Figyelem: _A Postgres 9.6 verziótól kezdve a mező waiting eltávolítva, és helyette két informatívabb mező lett hozzáadva wait_event_type és wait_event._
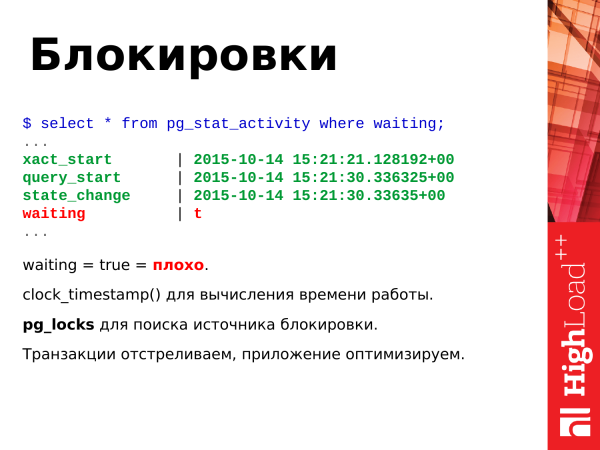
Mit tegyünk? Ha hosszú ideig true-t lát, akkor az ilyen lekérdezésekre meg kell szabadulni. Egyszerűen megszabadítjuk ezeket a tranzakciókat. A fejlesztőknek írunk, hogy valahogyan optimalizálni kell, hogy ne legyen erőforrásokért való versengés. Aztán a fejlesztők optimalizálják az alkalmazást, hogy ez ne fordulhasson elő.
És a végső, de potenciálisan nem végzetes eset – ez a deadlock-ok kialakulása. Két tranzakció frissítette a két erőforrást, majd újra hivatkoznak rájuk, már a ellentétes erőforrásokra. A PostgreSQL ilyenkor automatikusan megszünteti a tranzakciót, hogy a másik folytathassa a munkát. Ez egy zsákutca, amit nem lehet önállóan kezelni. Ezért a PostgreSQL kénytelen szélsőséges intézkedéseket hozni.
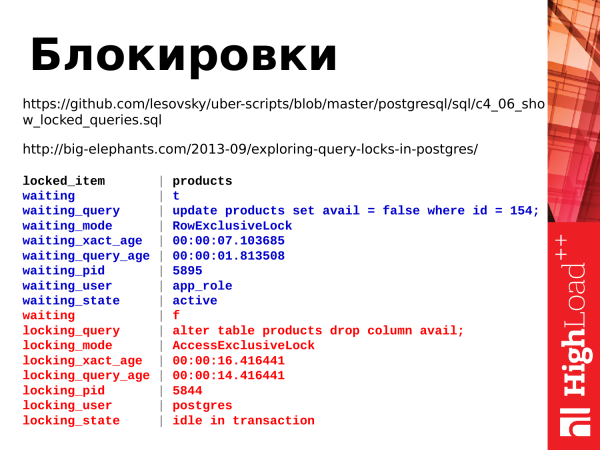
Íme, két lekérdezés, amelyek lehetővé teszik a blokkolások nyomon követését. A 'pg_locks' nézetet használjuk. pg_locks, amely lehetővé teszi a nehéz lekérdezések követését.
Az első hivatkozás a lekérdezés szövege. Ez meglehetősen hosszú.
A második hivatkozás egy cikk a blokkokról. Érdemes elolvasni, nagyon érdekes.
Tehát mit látunk? Két lekérdezést látunk. Az egyik tranzakció ALTER TABLE – ez egy blokkoló tranzakció. Elindult, de nem fejeződött be, és az alkalmazás, amely ezt a tranzakciót elindította, máshol foglalkozik más dolgokkal. A másik lekérdezés – frissítés. Várja, hogy befejeződjön az alter table, hogy folytathassa a munkáját.
Így tudjuk kideríteni, ki blokkolta ki a másikat, és mivel tudunk továbblépni.
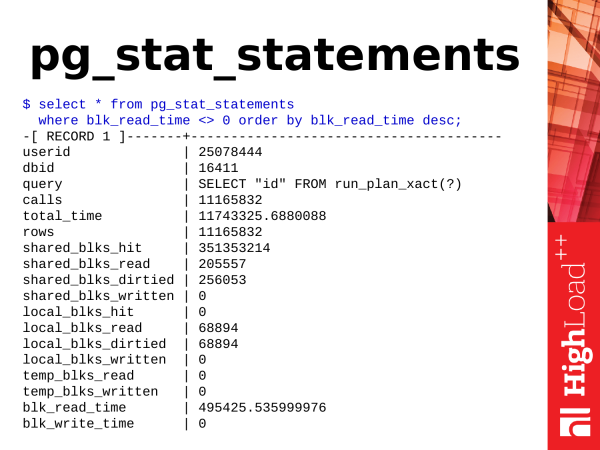
A következő modul – ez a pg_stat_statements. Ahogy már mondtam, ez egy modul. Ahhoz, hogy használhassuk, be kell töltenünk a könyvtárát a konfigurációba, újra kell indítanunk a PostgreSQL-t, telepítenünk a modult (egy parancs segítségével), és utána új nézetünk lesz.
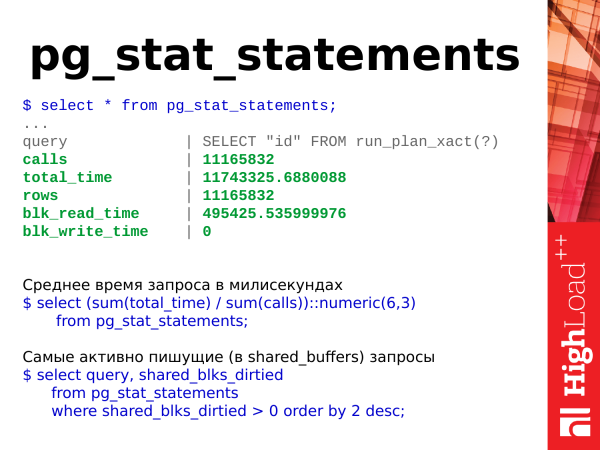
A lekérdezés átlagos ideje milliszekundumban
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

A legaktívabb írási lekérdezések (a shared_buffers-ben)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Mit tudunk ebből kinyerni? Ha az egyszerű dolgokról beszélünk, meg tudjuk nézni a lekérdezés végrehajtásának átlagos idejét. Ha az idő nő, akkor a PostgreSQL lassan reagál, és lépéseket kell tennünk.
Meg tudjuk nézni a legaktívabb írási tranzakciókat az adatbázisban, amelyek módosítják az adatokat a shared_buffers-ben. Megnézhetjük, ki módosítja vagy törli az adatokat.
Egyszerűen különböző statisztikákat is megvizsgálhatunk ezekről a lekérdezésekről.
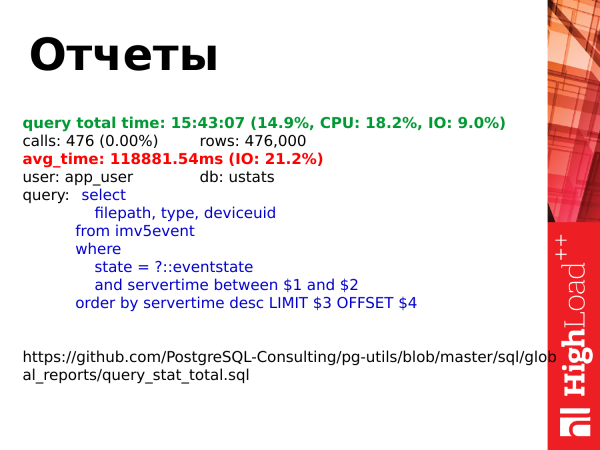
Mi pg_stat_statements felhasználjuk a jelentések elkészítéséhez. Naponta egyszer töröljük a statisztikát. Gyűjtjük őket. A statisztika következő törlése előtt jelentést készítünk. Itt a jelentés hivatkozása. Megtekintheti.
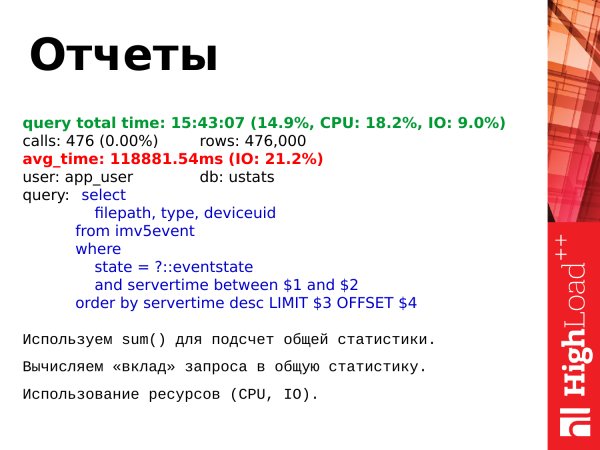
Mit csinálunk? Összesítjük a statisztikát az összes lekérdezésről. Ezután minden lekérdezés esetében kiszámítjuk az egyéni hozzájárulását az összesített statisztikához.
Mit nézhetünk meg? Megnézhetjük a hasonló típusú lekérdezések összesített végrehajtási idejét a többi lekérdezés hátterében. Megnézhetjük a CPU és I/O erőforrások felhasználását a teljes képhez viszonyítva. És már optimalizálhatjuk ezeket a lekérdezéseket. E jelentés alapján összeállítjuk a legfontosabb lekérdezéseket, és így már kapunk támpontot, hogy mit optimalizáljunk.
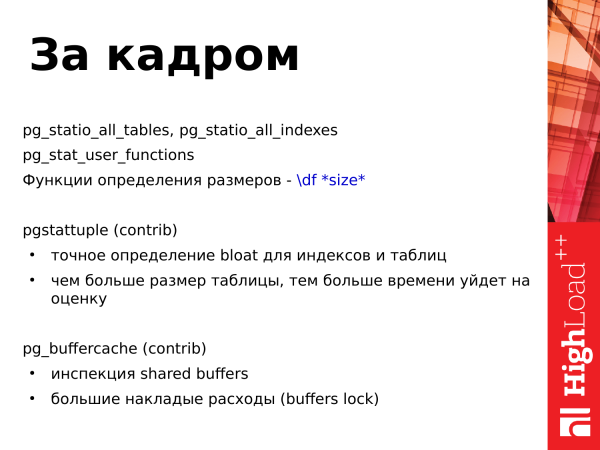
Mi maradt a háttérben? Még néhány bemutató maradt, amelyeket nem tárgyaltam, mert az idő korlátozott.
Van pgstattuple – ez is egy további modul a standard contribs csomagból. Lehetővé teszi a bloat táblák, az úgynevezett táblázat-fragmentáció értékelését. Ha a fragmentáció nagy, akkor el kell távolítani, különféle eszközöket kell használni. A funkció pgstattuple lassan működik. Minél több tábla van, annál tovább fog tartani.
A következő contrib – ez a pg_buffercache. Lehetővé teszi a megosztott pufferek ellenőrzését: mennyire intenzíven és mely táblákhoz használják a pufferlapokat. Egyszerűen lehetőséget ad a megosztott pufferekbe való bepillantásra, és értékelheti, mi történik ott.
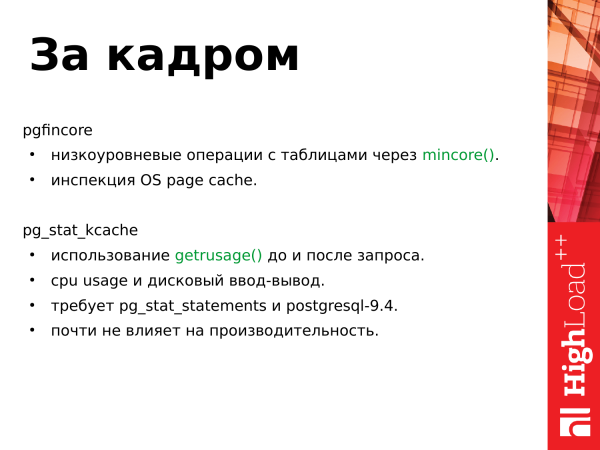
A következő modul – ez a pgfincore. Ez alacsony szintű műveleteket tesz lehetővé a táblákkal a rendszerhíváson keresztül mincore(), azaz lehetővé teszi a tábla betöltését a megosztott pufferekbe, vagy annak kiürítését. Ezenkívül lehetőséget ad a rendszer operációs rendszerek lapcache-ának ellenőrzésére, azaz megnézheti, hogy egy tábla mennyi helyet foglal el a lap cache-ben és a megosztott pufferekben, és értékelheti a tábla terheltségét.
A következő modul – pg_stat_kcache. Ez szintén használja a rendszerhívást getrusage(). A lekérdezés végrehajtása előtt és után hajtja végre. A kapott statisztikában lehetőséget ad arra, hogy értékelje, mennyi időt töltött el a lekérdezés a lemezes bemenetre és kimenetre, azaz a fájlrendszerrel végzett műveletekre, és nézi a processzorhasználatot. Azonban a modul fiatal (khm-khm), és működéséhez PostgreSQL 9.4 és pg_stat_statements szükséges, amiről korábban beszéltem.
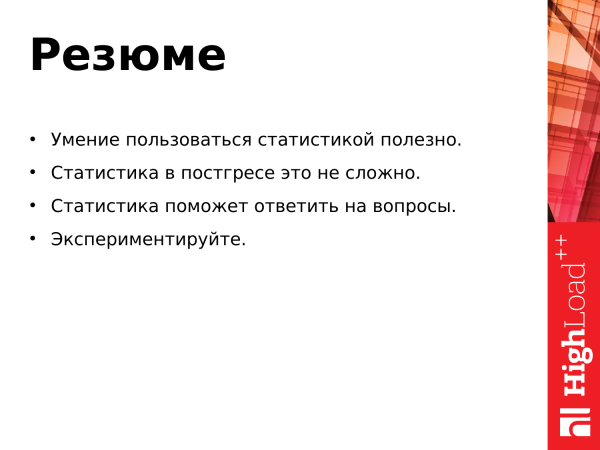
A statisztika használata hasznos. Nincs szüksége külső programokra. Ön is belekukucskálhat, megnézheti, tehet valamit, végrehajthatja.
A statisztikát könnyű használni, ez csak sima SQL. Összegyűjtötte a lekérdezést, elkészítette, elküldte, megnézte.
A statisztika segít válaszolni a kérdésekre. Ha kérdései merülnek fel, akkor a statisztikához fordul – nézze, vonja le a következtetéseket, elemezze az eredményeket.
És kísérletezzen. Sok lekérdezés van, sok adat. Mindig lehet optimalizálni egy meglévő lekérdezést. Készíthet saját verziót a lekérdezésből, amely jobban megfelel Önnek, mint az eredeti, és használhatja azt.
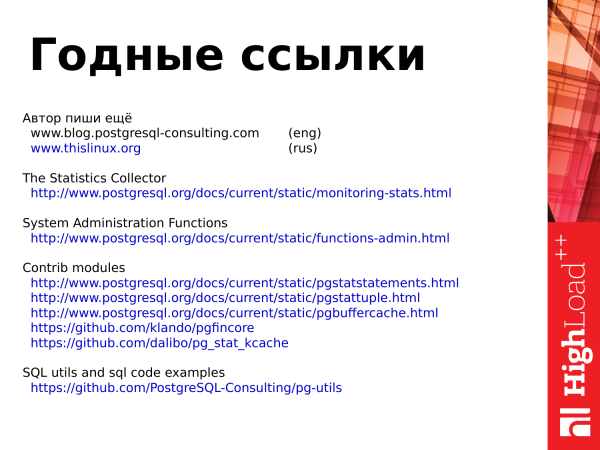
Hivatkozások
Értékes linkek, amelyek az artikelben találhatók, amelynek anyagairól beszéltek a jelentésben.
A szerző még írjon
(eng)
A statisztika gyűjtő
Rendszergazdai funkciók
Contrib modulok
SQL eszközök és SQL kódpéldák
Mindenkinek köszönöm a figyelmet!
Forrás: habr.com
