

2019 őszén az iOS csapatánál a Mail.ru felhőben egy régóta várt esemény történt. Az alkalmazás perszisztens állapotának tárolásához alapadatbázisként egy mobil világban meglehetősen egzotikus megoldást választottunk. (LMDB). Az alábbiakban részletesen bemutatjuk, négy részben. Először beszéljünk a választás hátteréről, ami nem volt egyszerű és nehezen meghozható. Ezután áttérünk az LMDB architektúráját képező három alapelvre: a memóriába térképezett fájlokra, a B+-fára és a copy-on-write megközelítésre, amely a tranzakciós és többszörös verziók megvalósítását szolgálja. Végül a gyakorlati rész következik, ahol megvizsgáljuk, hogyan tervezhetjük és valósíthatjuk meg az alacsony szintű key-value API-ra építve az adatbázis séma több táblával, beleértve az indexet is.
Tartalom
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. A bevezetés motivációja
2015 körül aggódni kezdtünk azzal, hogy milyen gyakran fagy le az alkalmazásunk felülete. Nem csak így, azóta is érkeztek panaszkodások, hogy néha az alkalmazás nem reagál a felhasználói interakciókra: a gombok nem reagálnak, a listák nem görgethetők, stb. A mérésekkel kapcsolatos mechanika a AvitoTech-nél folyik, itt csak a számadatokat közlöm. A mérések eredményei hidegzuhanyként értek minket. Kiderült, hogy a fagyásokkal kapcsolatos problémák sokkal gyakoribbak, mint bármilyen más probléma. Mielőtt ezt észleltük, a fő technikai minőségi mutató a crash free volt, de utána a fókusz
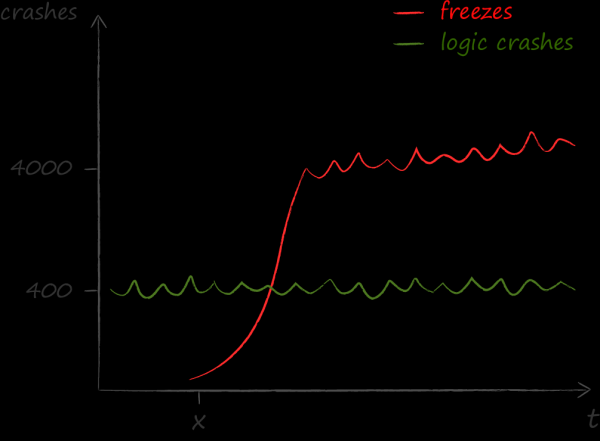
elmozdult Egy fagyásokat nyomon követő dashboardot építettünk ki
és elvégeztük a minőségi és a közösségi Twitteren és a közösségi Twitteren és . A jelen elbeszélés keretein belül szeretném kiemelni azokat a megoldási aspektusokat, amelyek befolyásolták az adatbázis választását.
A rendszer szervezésének aktor modellje azt feltételezi, hogy a párhuzamosság a második lényegévé válik. A modell objektumai szívesen átlépik a szálak határait. Ezt nem időnként és néhány helyen teszik, hanem gyakorlatilag folyamatosan és mindenhol.
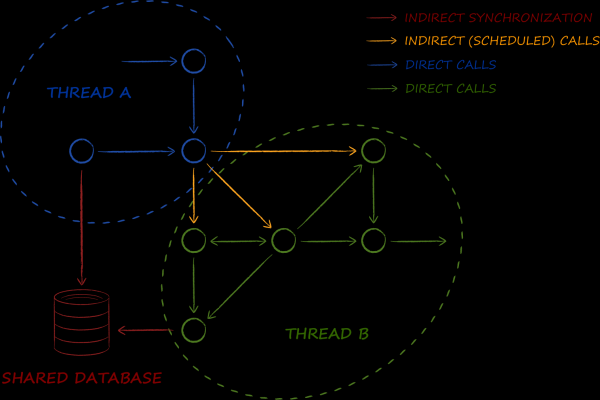
Az adatbázis az egyik sarokköve a bemutatott sémának. Fő feladata a makropattern megvalósítása. . Ha a vállalati világban ennek segítségével szervezik a szolgáltatások közötti adattárcsázást, akkor az aktor architektúra esetében az adatok a szálak között. Így olyan adatbázisra volt szükségünk, amely működése párhuzamos környezetben még a legkisebb nehézséget sem okoz. Ez konkrétan azt jelenti, hogy az onnan származó objektumoknak minimum szálbiztosnak, ideálisan pedig immutable-nak kell lenniük. Mint tudjuk, az utóbbiakat egyidejűleg fel lehet használni több szálból, anélkül hogy bármiféle zárolásra lenne szükség, ami kedvezően hat a teljesítményre.
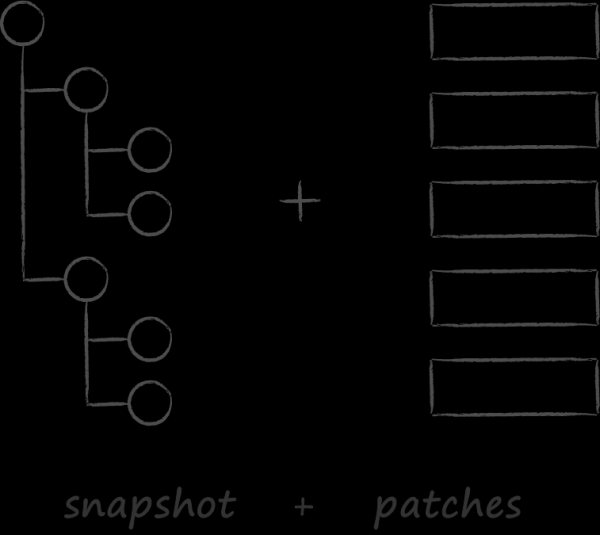 A második jelentős tényező, amely befolyásolta az adatbázis választását, a mi felhő API-nk volt. Ez a git-ben rögzített szinkronizálási megközelítés ihlette. Ahogy ő is, úgy mi is a , amely a felhőkliensek számára több mint megfelelően tűnik. Feltételezve volt, hogy csak egyszer töltik le a felhő teljes állapotát, majd a szinkronizálás a túlnyomó többség esetében a változások lefelé történő telepítésével fog történni. Sajnos ez a lehetőség még mindig csak elméleti szinten létezik, és a gyakorlatban a kliensek nem tanulták meg a patch-ek kezelését. Ennek számos objektív oka van, amelyeket nem szeretnénk részletezni az ismertető elkerülése érdekében. Jelenleg azonban sokkal érdekesebbek az oktató jellegű tanulságok arról, hogy mi történik, amikor az API azt mondja, hogy „A”, de a felhasználó nem mondja, hogy „B”.
Tehát, ha elképzeled a git-et, amely pull parancs végrehajtásakor ahelyett, hogy a helyi snapshot-ra patch-eket alkalmazna, inkább az teljes állapotot hasonlítja össze a kiszolgáló teljes állapotával, akkor pontos elképzelést kapsz arról, hogyan történik a szinkronizálás a felhőalapú kliensekben. Nem nehéz kitalálni, hogy ennek megvalósításához két DOM-fát kell allokálni a memóriában, amely meta-információt tartalmaz minden kiszolgáló és helyi fájlról. Így ha a felhasználó 500 ezer fájlt tárol a felhőben, akkor a szinkronizálásához két fát kell újraalkotni és elpusztítani 1 millió csomóponttal. És minden csomópont egy aggregát, amely grafikonban tartalmaz alobjektumokat. Ebben a fényben az profilozás eredménye várható volt. Kiderült, hogy még a merge algoritmikája nélkül is önmagában a rengeteg apró objektum létrehozásának és megsemmisítésének eljárása is sokba kerül. A helyzetet súlyosbítja, hogy az alapvető szinkronizációs művelet sok felhasználói forgatókönyvben szerepel. Így rögzítjük a második fontos kritériumot az adatbázis kiválasztásánál — a CRUD műveletek dinamikus objektumalokáció nélküli megvalósításának lehetőségét.
A többi követelmény hagyományosabb, és a teljes listája a következőképpen néz ki.
- Szálbiztonság.
- Többprocesszusság. Ennek célja, hogy ugyanazt az adatbázis- példányt használjuk a szinkronizálásra, nemcsak a szálak között, hanem a fő alkalmazás és az iOS kiterjesztések között is.
- A tárolt entitások immutable objektumokként való reprezentálásának lehetősége.
- A CRUD műveletek keretében a dinamikus allokációk hiánya.
- Az alapvető tulajdonságok tranzakciós támogatása : atomaritás, konzisztencia, elszigeteltség és megbízhatóság.
- Sebesség a legnépszerűbb esetekben.
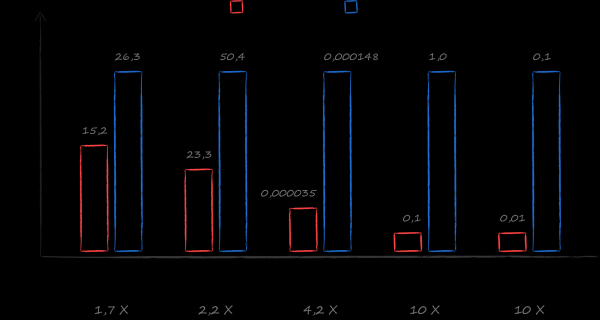
Jó választás volt és marad a SQLite e követelményekkel. Az alternatívák tanulmányozása során azonban egyik könyv belekerült a kezembe, . Vezetése alatt készült el egy benchmark, amely különböző adatbázisok teljesítményét hasonlította össze valós felhőalapú szcenáriókban. Az eredmény felülmúlta a legmerészebb várakozásokat. A legnépszerűbb forgatókönyvekben — a rendezett fájlok teljes listájának lekérdezése és a megadott könyvtárhoz tartozó rendezett fájlok teljes listája — az LMDB tízszer gyorsabb volt, mint az SQLite. A választás nyilvánvalóvá vált.
2. Az LMDB pozicionálása
Az LMDB egy nagyon kicsi könyvtár (mindössze 10K sor), amely a legalsó alaprétegét valósítja meg az adatbázisoknak — a tárolást.
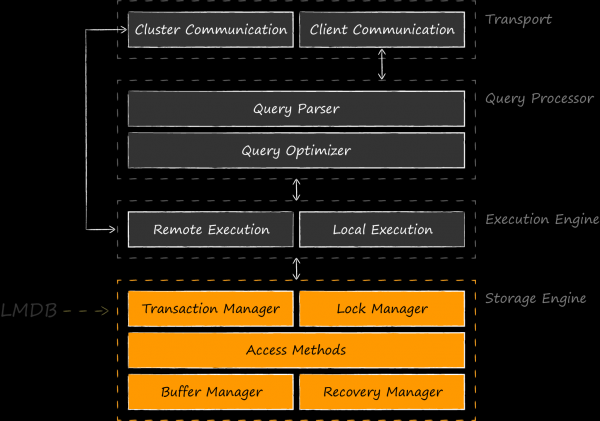
A bemutatott ábra azt mutatja, hogy az LMDB-t az SQLite-hoz hasonlítani, amely magasabb szinteket is megvalósít, nem sokkal korrektabb, mint az SQLite és a Core Data összehasonlítása. Az azonos versenytársak bemutatásához igazságosabb a hasonló tárolómotorok — BerkeleyDB, LevelDB, Sophia, RocksDB stb. — említése. Van olyan fejlesztés is, ahol az LMDB szerepel a SQLite tárolómotorjaként. Az első ilyen kísérlet 2012-ben történt. az LMDB szerzője . olyan izgalmasnak bizonyult, hogy kezdeményezését az OSS-rajongók felkapták, és folytatásra talált . 2020 januárjában a projekt szerzője, Den Shearer bemutatta azt a LinuxConfAu-n.
Az LMDB legfőbb alkalmazási területe az alkalmazás alapú adatbázisok motorjaként való használata. A könyvtár létrejöttét a fejlesztőknek köszönheti , akik nagyon elégedetlenek voltak a BerkeleyDB-vel, mint az ő projektjük alapjával. Egy szerény könyvtárból kiindulva , Howard Chu képes volt létrehozni az egyik legnépszerűbb alternatívát a mai időben. E történetnek, valamint az LMDB belső felépítésének szentelte nagyon érdekes előadását . Jó példát mutatott be a tár tárolásának meghódításáról Leonid Jurjev (aka ) a Positive Technologies-től a Highload 2015-ös előadásában . Itt az LMDB-t a ReOpenLDAP megvalósításának hasonló problémájában mutatja be, míg a LevelDB-t összehasonlító kritikának veti alá. A Positive Technologies-nél az implementáció eredményeképpen még egy aktívan fejlődő fork is létrejött nagyon vonzó jellemzőkkel, optimalizálásokkal és .
Az LMDB-t gyakran használnák tárolásra is. Például a Mozilla Firefox azt számos igényhez, míg a 9-es verziótól kezdve az Xcode az SQLite-t az indexek tárolásához.
A motor megjelent a mobilfejlesztés világában. Felhasználásának nyomait a Telegram iOS kliensében. A LinkedIn még továbbment, és az LMDB-t választotta alapértelmezett tárolónak a saját fejlesztésű Rocket Data adatok gyorsítótárazó keretrendszere számára, amiről 2016-os cikkében.
Az LMDB sikeresen versenyez a napfényért a BerkeleyDB által hagyott résben, miután az Oracle irányítása alá került. A könyvtárat a sebessége és megbízhatósága miatt kedvelik, még a hasonló megoldásokkal összehasonlítva is. Ahogy mondani szokták, ingyenebéd nem létezik, és fontos kiemelni a trade-off-ot, amellyel szembesülnünk kell, amikor az LMDB és az SQLite között választunk. A fenti ábra világosan szemlélteti, hogy mivel érhető el a megnövelt sebesség. Először is, nem fizetünk a diszk tároló fölötti további absztrakciós rétegekért. Nyilvánvaló, hogy egy jó architektúrában ezektől nem lehet elkerülni, és elkerülhetetlenül megjelennek az alkalmazás kódjában, azonban sokkal vékonyabbak lesznek. Ezekben nem lesznek olyan funkciók, amelyeket a konkrét alkalmazás nem igényel, például az SQL nyelven történő lekérdezések támogatása. Másodsorban lehetőség nyílik az alkalmazási műveletek optimalizált leképezésére a diszk tárolóhoz intézett lekérdezésekre. Míg az SQLite az átlagos alkalmazás átlagos igényeire alapoz, Ön mint alkalmazásfejlesztő tökéletesen tisztában van az alapvető terhelési forgatókönyvekkel. A produktívabb megoldásért meg kell fizetni a kezdeti megoldás fejlesztési és későbbi karbantartási költségeit.
3. Az LMDB három pillére
A LMDB-t madártávlatból szemlélve, itt az idő, hogy mélyebbre menjünk. A következő három fejezet az adatbázis architektúrájának alapvető pilléreinek ismertetésével fog foglalkozni:
- A memóriába térképezett fájlok, mint a diszk kezelés és a belső adatszerkezetek szinkronizálásának mechanizmusa.
- A B+-fa mint a tárolt adatok szerkezetének megszervezése.
- A copy-on-write mint az ACID tranzakciós tulajdonságok és a többverziósság biztosításának megközelítése.
3.1. Pillér #1. Memória-térképezett fájlok
A memóriába megjelenített fájlok annyira fontos architektonikai elemei, hogy még a tároló nevét is hordozzák. A cache-elési és a tárolt információkhoz való hozzáférés szinkronizálásának kérdése teljes mértékben az operációs rendszerre hárul. Az LMDB nem tartalmaz belső cache-eket. Ez a szerző tudatos döntése, mivel az adatok közvetlen olvasása a megjelenített fájlokból számos buktatót el lehet kerülni a motor megvalósításában. Az alábbiakban nem teljes listát adok közülük.
- A tároló adatainak konzisztenciájának fenntartása több folyamatból való hozzáférés esetén az operációs rendszer felelőssége. A következő részben ezt a mechanikát részletesen és képekkel mutatjuk be.
- A cache-ek hiánya teljesen megszabadítja az LMDB-t a dinamikus allokálásokkal járó költségektől. Az adatok olvasása valójában annyit jelent, hogy a mutatót a virtuális memória megfelelő címére állítjuk, és nem többet. Igen furcsán hangzik, de a tároló forráskódjában minden salloc hívás a tároló konfigurálásának függvényébe van összpontosítva.
- A cache-ek hiánya a hozzáférésükkel kapcsolatos szinkronizálásból fakadó blokkolások meg- szüntetését is jelenti. A számos olvasónak, akik egyidejűleg létezhetnek, egyetlen mutex-szel sem kell találkozniuk az adataikhoz való hozzáférés útján. Ennek következtében az olvasás sebessége ideális lineáris skálázást épít fel a CPU-k számával. Az LMDB-ben csak a módosító műveletek kerülnek szinkronizálásra. Íráskor mindig csak egy író lehet.
- A cache-elés és a szinkronizálás minimális logikája megszünteti a kódot a rendkívül bonyolult hibáktól, amelyek a több szálú környezetben való munkához kapcsolódnak. Az Usenix OSDI 2014 konferencián két érdekes adatbázis-kutatás volt: és . Ezekből az LMDB precedens nélküli megbízhatóságáról és a tranzakciók ACID-tulajdonságainak majdnem hibátlan megvalósításáról is információt nyerhetünk, amely a SQLite-ban hasonlóan kiemelkedő.
- Az LMDB minimalizmusa lehetővé teszi, hogy a kód gépi reprezentációja teljes mértékben a processzor L1 cache-jében helyezkedjen el, aminek következményeként sebességjellemzői révén kiemelkedő teljesítményt nyújt.
Sajnos az iOS esetében a memória kezelésével kapcsolatos fájlok nem olyan problémamentesek, mint szeretnénk. Ahhoz, hogy tudatosabban beszélhessünk a velük kapcsolatos hátrányokról, emlékeznünk kell az operációs rendszerekben e mechanizmus megvalósításának általános elveire.
Áttekintés a memóriába térképezett fájlokról
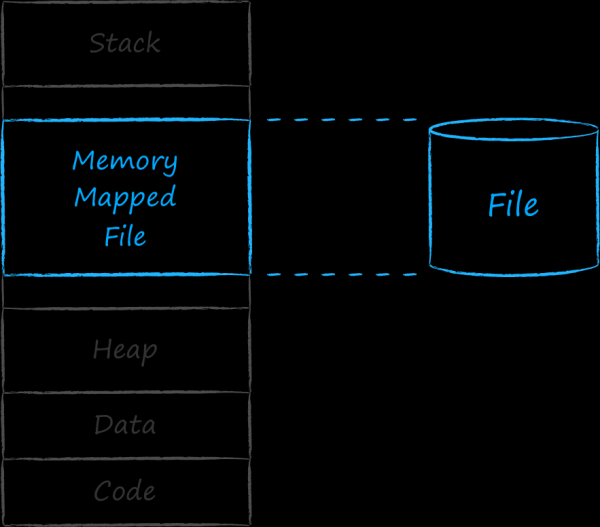 Minden egyes futtatható alkalmazás egy olyan entitáshoz, úgynevezett folyamathoz van társítva az operációs rendszer által. Minden folyamat számára egy folytonos címkészletet foglalnak le, amelyben mindent elhelyeznek, ami a működéséhez szükséges. A legalacsonyabb címeken találhatók a kód szekciói és a beágyazott adatok és erőforrások. Ezt követi egy felfelé növekvő dinamikus címzési tér, amelyet jól ismerünk heap néven. Ebben a tárolóban találhatók azoknak az entitásoknak a címei, amelyek a program futása során jelennek meg. A tetején helyezkedik el az a memória terület, amelyet az alkalmazás veremként használ. Ez folyamatosan nő és zsugorodik, más szavakkal, mérete is dinamikus jellegű. Annak érdekében, hogy a verem és a heap ne ütközzenek és ne zavarják egymást, különböző címzési tartományokban helyezkednek el. A két dinamikus szekció között, fent és lent, van egy rés. Az operációs rendszer ezt a középső szakaszt a folyamathoz legkülönfélébb entitások társítására használja. Például egy folyamatos címkészlet megfeleltethető egy fájlnak a lemezen. Ezt a fájlt nevezzük memóriába térképezett fájlnak.
A folyamathoz kijelölt címzési tér hatalmas. Elméletileg a címek száma csupán a mutató méretével van korlátozva, amely a rendszer bit-értékétől függ. Ha ennek 1-1 megfelelője lenne a fizikai memória, akkor az első folyamat azonnal elfogyasztaná az összes RAM-ot, és a multitasking fogalma elképzelhetetlenné válna.
Azonban a tapasztalataink alapján tudjuk, hogy a modern operációs rendszerek egyszerre tetszőleges számú folyamatot képesek végrehajtani. Ez azért lehetséges, mert papíron csak kiemelnek a folyamatok számára egy csomó memóriát, de a valóságban csak azt a részt töltik be a fizikai memóriába, amelyre itt és most szükség van. Ezért a folyamattal társított memória virtuálisnak nevezik.
Az operációs rendszer a virtuális és a fizikai memóriát meghatározott méretű lapok formájában szervezi meg. Amint egy virtuális memória lapra szükség van, az operációs rendszer betölti azt a fizikai memóriába, és létrehoz egy megfelelő kapcsolatot egy speciális táblázatban. Ha nincsenek szabad helyek, akkor egy korábban betöltött lapot a lemezre másolnak, és a keresett lap az ő helyére kerül. Ezt az eljárást, amellyel hamarosan visszatérünk, swap-nak (kimásolásnak) nevezik. Az alábbi ábra illusztrálja a leírt folyamatot. Az A lap, amelynek címe 0, betöltődött és a fő memória 4-es című lapjára helyezték. Ez a tény a vonatkozó táblázatban a 0. cellában található.
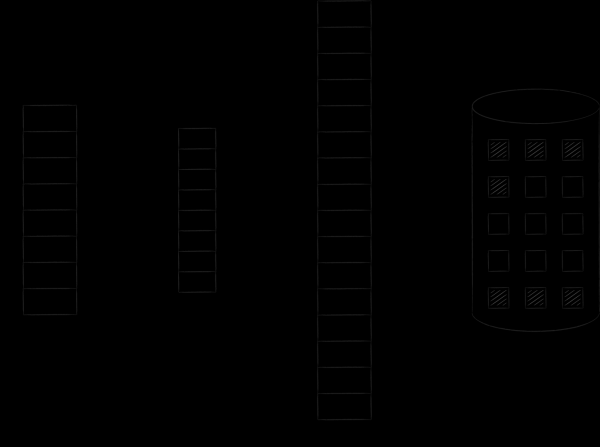
A megjelenített fájlokkal kapcsolatos történet pontosan ugyanez. Logikailag úgy tűnik, hogy folyamatosan és teljesen elhelyezkednek a virtuális címzett térben. Azonban a fizikai memóriába lapról lapra és csak kérésre kerülnek. Az ilyen lapok módosítása szinkronizálva van a lemezen lévő fájllal. Így fájl be- és kiírást lehet végezni, egyszerűen csak a memóriában lévő bitekkel dolgozva – minden változás automatikusan átkerül a kernel által a forráshoz.
Az alábbi ábra bemutatja, hogyan szinkronizálja az LMDB az állapotát, miközben különböző folyamatokkal dolgozik egy adatbázissal. Különböző folyamatok virtuális memóriáját ugyanarra a fájlra térképezve, de facto kötelezzük az operációs rendszert, hogy transzitiv módon szinkronizálja a címzett területeik bizonyos blokkjait, amelyekre az LMDB figyel.
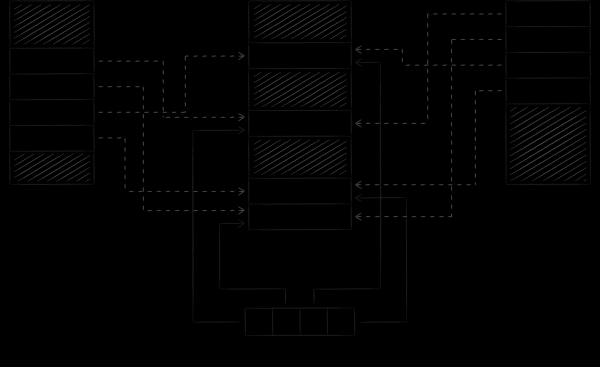
Fontos szempont, hogy az LMDB alapértelmezés szerint a write rendszerhívás mechanizmusán keresztül módosítja az adatfájlt, míg maga a fájl read-only módban van szerkesztve. Ennek a megközelítésnek két fontos következménye van.
Az első következmény — közös minden operációs rendszer számára. Lényege, hogy védelmet ad a véletlen adatbázis-károsodás ellen a hibás kód miatt. Mint ismert, a folyamat futtatható utasításai szabadon hivatkozhatnak az adataink bármely helyére a címzési térben. Ugyanakkor, ahogy most említettük, egy fájl read-write módban való leképezése azt jelenti, hogy bármely utasítás azt módosíthatja is. Ha ezt véletlenül teszi, például megpróbálja újraírni a tömb egy elemét nem létező index alapján, akkor így véletlenül megváltoztathatja a címre leképezett fájlt, ami az adatbázis megsérüléséhez vezethet. Ha a fájl read-only módban van leképezve, akkor a megfelelő cím tér módosításának kísérlete a program összeomlását okozza a jelzéssel SIGSEGV, és a fájl sértetlen marad.
A második következmény már specifikus az iOS számára. Sem a szerző, sem más források nem említik ezt kifejezetten, de nélküle a LMDB nem lenne használható ebben a mobil operációs rendszerben. Ezt a kérdést a következő fejezet tárgyalja.
A memóriában leképezett fájlok specificitása iOS alatt
2018-ban a WWDC-n egy csodálatos előadást tartottak . Ebben arról beszélnek, hogy az iOS-ben az összes, a fizikai memóriában lévő lap a három típus egyikéhez tartozik: dirty, compressed és clean.
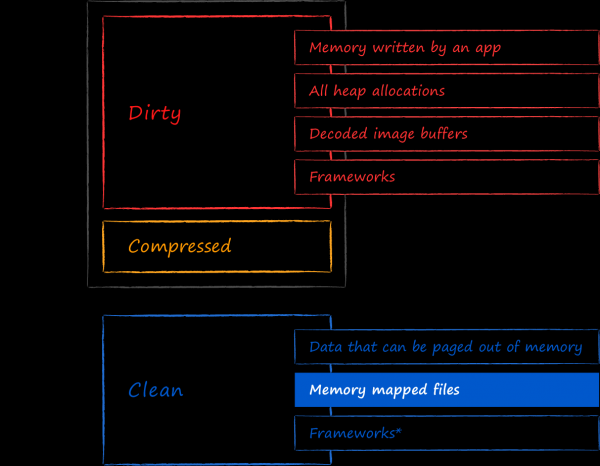
A clean memória azokat az oldalakat jelenti, amelyeket fájdalom nélkül ki lehet üríteni a fizikai memóriából. Azokon lévő adatokat szükség esetén újra le lehet tölteni az eredeti forrásaikból. A read-only memory-mapped fájlok pontosan ebbe a kategóriába tartoznak. Az iOS nem fél bármikor kiüríteni a fájlokra leképezett lapokat a memóriából, mivel garantáltan szinkronban vannak a lemezen lévő fájlokkal.
A dirty memória magában foglalja az összes módosított oldalt, függetlenül attól, hol helyezkedtek el eredetileg. Különösen ezek közé tartoznak a memory-mapped fájlok, amelyeket az azokat kísérő virtuális memória írásával módosítottak. Ha az LMDB-t a MDB_WRITEMAPjelzésű kapcsolóval nyitjuk meg, akkor a módosítások után ezt személyesen is megerősíthetjük.
Amint egy alkalmazás túl sok fizikai memóriát foglal el, az iOS tömöríti a dirty oldalakat. Az összesített memória, amelyet a dirty és a tömörített oldalak elfoglalnak, a alkalmazás memória lábnyomának nevezett összeg. Ha elérik a küszöbértéket, akkor a rendszer démonja, az OOM killer, beavatkozik, és kényszerítetten leállítja a folyamatot. Ez az, ami megkülönbözteti az iOS-t a desktop operációs rendszerektől. Emlékezzünk, hogy az iOS nem teszi lehetővé a memória lábnyom csökkentését a fizikai memória és a lemez közötti lapok swap-elésével. Az okokról csak találgatni lehet. Talán a lapok intenzív áthelyezése a lemezre és vissza túl sok energiát igényel a mobil eszközök számára, vagy az iOS takarékoskodik az SSD cellák újraírásával, vagy talán a tervezők nem voltak elégedettek a rendszer általános teljesítményével, ahol minden folyamatosan swap-el. Mindenesetre a tény, hogy ez így van.
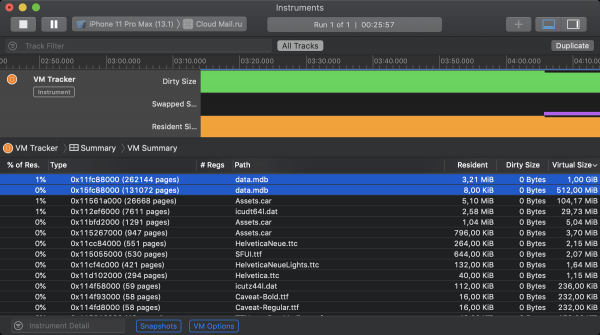
A jó hír, amelyet korábban említettünk, az, hogy az LMDB alapértelmezés szerint nem használ mmap mechanizmust a fájlok frissítéséhez. Ezért a megjelenített adatokat az iOS tiszta memóriának minősíti, és nem járulnak hozzá a memória lábnyomhoz. Ezt a Xcode VM Tracker nevű eszközével ellenőrizhetjük. Az alábbi képernyőképen az iOS alkalmazás felhője virtuális memória állapota látható működés közben. A kezdetekkor 2 LMDB példányt inicializáltak. Az elsőnek 1 GiB virtuális memória megjelenítésére volt engedélye, míg a másodiknak 512 MiB-ra. Annak ellenére, hogy mindkét adattároló bizonyos mennyiségű rezidens memóriát foglal el, egy sem járul hozzá a dirty mérethez.
Most jöjjenek a rossz hírek. A 64-bites asztali operációs rendszerek swap mechanizmusának köszönhetően minden folyamat annyi virtuális címzési teret foglalhat el, amennyit a szabad hely a merevlemezen lehetővé tesz a potenciális swap-jához. Az iOS-ban a swap helyett a tömörítés radikálisan csökkenti a teoretikus maximumot. Most minden folyamatnak be kell férnie a fő (értsd RAM) memóriába, és minden, ami nem fér el, kényszerítve leállításra kerül. Erről az előbb említett szövegben is olvashatunk. -ban, valamint a Ennek következtében az iOS szigorúan korlátozza a mmap-on keresztül foglalható memória méretét. Íme. Meg lehet nézni azokat az empirikus határokat, amelyeket a memória mennyiségeinek allokálására sikerült elérni különböző eszközökön e rendszerhíváson keresztül. A legmodernebb iOS okostelefon modellek 2 gigabájtot, míg a csúcskategóriás iPad modellek 4 gigabájtot biztosítanak. A gyakorlatban azonban a legfiatalabb támogatott eszközmodellekre kell építenünk, ahol a helyzet elég szomorú. Ráadásul, ha megnézzük az alkalmazás memóriájának állapotát a VM Trackerben, kiderül, hogy az LMDB messze nem az egyetlen, aki memory-mapped memóriára pályázik. Jó részeket fogyasztanak a rendszerallokátorok, erőforrásfájlok, képkonzoláló keretrendszerek és más kisebb ragadozók.
A felhőben végzett kísérletek alapján eljutottunk a következő kompromisszumos LMDB memóriaallokációs értékekhez: 384 megabájt 32 bites eszközök számára és 768 megabájt 64 bites eszközök számára. E mennyiség felhasználása után bármilyen módosító művelet kóddal végződik. MDB_MAP_FULL. Ezek a hibák figyelemmel kísérésünk során megfigyelhetők, de elég ritkák ahhoz, hogy ezen a ponton figyelmen kívül hagyhatók legyenek.
A tároló túlzott memóriafogyasztásának egy kevésbé nyilvánvaló oka lehet a hosszú életű tranzakciók. Annak megértéséhez, hogyan kapcsolódik ez a két jelenség, segítségünkre lesz a LMDB két további alapelvének vizsgálata.
3.2. Alapelv №2. B+-fa
A key-value tároló feletti táblázatok emulálásához a következő műveleteknek kell szerepelniük az API-jában:
- Új elem beszúrása.
- Elem keresése adott kulccsal.
- Elem eltávolítása.
- Kulcsok intervaluma szerinti iterálás rendezett sorrendben.
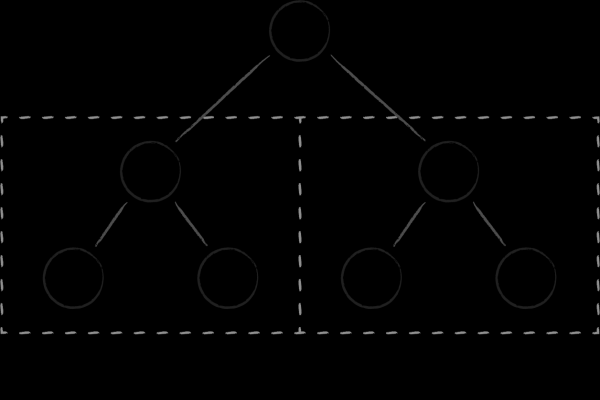 A legegyszerűbb adatszerkezet, amellyel könnyen megvalósíthatók mind a négy művelet, a bináris keresési fa. Minden egyes csúcs egy kulcsot képvisel, amely ketté osztja az összes gyermekkulcsot két részfára. A bal oldalon azok találhatók, amelyek kisebbek a szülőnél, míg a jobb oldalon azok, amelyek nagyobbak. A rendezett kulcskészlet elérése egy klasszikus fa bejárás révén biztosítható.
A bináris fák két alapvető hátránnyal rendelkeznek, amelyek megakadályozzák őket abban, hogy hatékonyak legyenek diszkadat-struktúraként. Először is, az egyensúlyuk foka kiszámíthatatlan. Jelentős kockázat áll fenn, hogy olyan fákat kapunk, amelyek különböző ágak magassága jelentősen eltérhet, ami jelentősen rontja a keresés algoritmikus összetettségét az elvárttal összehasonlítva. Másodszor, a csomópontok közötti kereszthivatkozások bősége megfosztja a bináris fákat a memóriabeli lokalitástól. A közeli csomópontok (a köztük lévő kapcsolatok szempontjából) teljesen különböző oldalakon lehetnek a virtuális memóriában. Ennek következtében még néhány szomszédos csomópont egyszerű bejárása is hasonló mennyiségű oldal látogatását igényelheti. Ez probléma akkor is, ha a bináris fák in-memory adatszerkezetként való hatékonyságáról beszélünk, mivel az oldalakkal való folyamatos forgatás a processzor gyorsítótárában nem olcsó mulatság. Amikor a csomópontokkal kapcsolatos oldalak gyakori felhívása a lemezen szóba kerül, a helyzet teljesen .
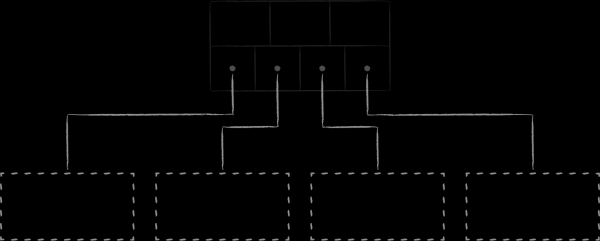 A B-fák, mint a bináris fák evolúciója, megoldják az előző bekezdésben megjelölt problémákat. Először is, ők önkiegyensúlyozók. Másodszor, minden csomópontjuk több gyermekkulcsot nem 2, hanem M rendezett részhalmazra bont, ahol az M száma meglehetősen nagy lehet, akár több száz, sőt ezer is.
Ennek eredményeként:
- Minden csomópontban nagy mennyiségű már rendezett kulcs található, és a fák nagyon alacsonyak lesznek.
- A fa memóriabeli elhelyezkedésének lokalitása is megjelenik, mivel a hasonló értékű kulcsok természetszerűleg közel helyezkednek el egymáshoz egy vagy szomszédos csomópontokban.
- Csökken a tranzitcsomópontok száma a fa alámerülése során a keresési művelet során.
- Csökken a céles csomópontok olvasási száma a range-lekérdezések során, mivel mindegyikük már tartalmaz egy nagy mennyiségű rendezett kulcsot.
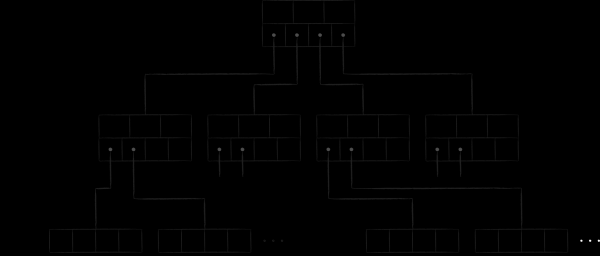
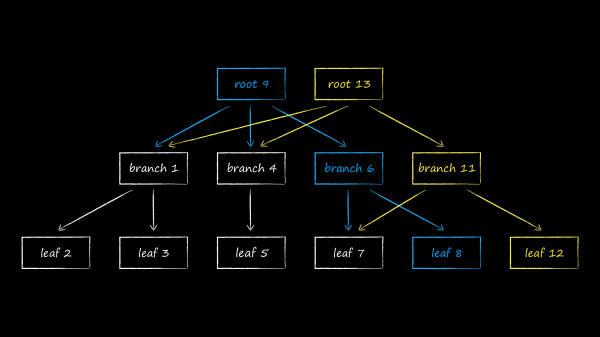
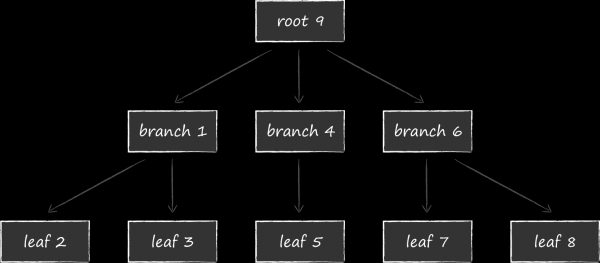
Az LMDB adatok tárolására egy B-fa egyik variációját használja, amelyet B+-fának neveznek. A fenti ábrán háromféle csomópont látható, amelyek ebben előfordulnak:
- A csúcsán található a gyökér (root). Ez nem más, mint egy adatbázis fogalmának megtestesítője a tároló belsejében. Egy LMDB példányon belül több adatbázis is létrehozható, amelyek megosztják a leképezett virtuális címképek teret. Mindegyik a saját gyökerével kezdődik.
- A legalacsonyabb szinten a levelek (leaf) találhatók. Csak ők tartalmazzák az adatbázisban tárolt kulcs-érték párokat. Érdemes megjegyezni, hogy ez a B+-fák sajátossága. Míg a megszokott B-fa az értékeket minden szint csomópontjaiban tárolja, a B+-változat csak a legalacsonyabb szinten. E tény rögzítésével a LMDB-ben használt fa típusát egyszerűen B-fának fogjuk nevezni.
- A gyökér és a levelek között 0 vagy több technikai szint található navigációs (branch) csomópontokkal. Ezek feladata, hogy a kulcsok rendezett halmazát eloszlassák a levelek között.
Fizikailag a csomópontok előre meghatározott hosszúságú memória blokkok. Méretük az operációs rendszer által használt memóriaoldalak méretéhez igazodik, amelyről már korábban beszéltünk. Alább látható a csomópont struktúrája. A fejlécben meta-információ található, amely közül a példa kedvéért a legszembetűnőbb a hibakód. Ezt követi az offsetek információja, ahol az adatok tárolódnak. Az adatok lehetnek kulcsok, ha navigációs csomópontokról beszélünk, vagy teljes kulcs-érték párok a levelek esetében. A lapok struktúrájáról részletesebben lehet olvasni a .
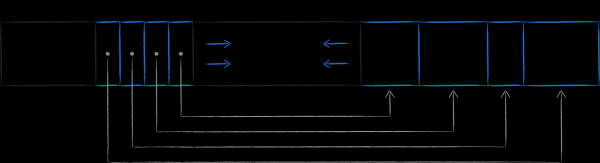
Miután megértettük a lapcsomópontok belső tartalmát, a LMDB B-fáját egyszerűen a következőképpen fogjuk bemutatni.
A csomópontok lapjai folyamatosan helyezkednek el a lemezen. A magasabb számú lapok közelebb helyezkednek el a fájl végéhez. Az úgynevezett meta-lap (meta page) tartalmazza az információt az offsetekről, amelyeken keresztül az összes fa gyökerét meg lehet találni. Az LMDB fájl megnyitásakor oldalanként átvizsgálja a fájlt a végétől a elejéig érvényes meta-lap keresése közben, és már ezen keresztül találja meg a meglévő adatbázisokat.
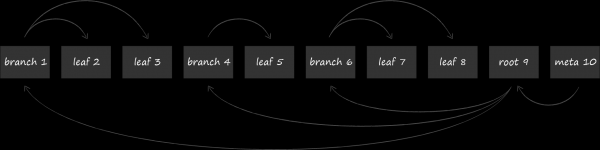
Most már, hogy van képünk az adatok logikai és fizikai struktúrájáról, áttérhetünk a LMDB harmadik pillérének vizsgálatára. Ennek segítségével a tároló minden módosítása tranzakcionálisan és egymástól elszigetelten történik, ezzel a teljes adatbázis multi-verziósság jellemzőjét is kapja.
3.3. Harmadik pillér. Copy-on-write
Néhány B-fával kapcsolatos művelet egy sor módosítást feltételez a csomópontjaiban. Az egyik példa a kulcs hozzáadása egy olyan csomóponthoz, amely már elérte a maximális kapacitását. Ebben az esetben először is a csomópontot ketté kell osztani, másodszor pedig hivatkozást kell hozzáadni az újonnan kiágazott gyerek csomópontra a szülőjében. Ez a folyamat potenciálisan nagyon veszélyes. Ha valamilyen oknál fogva (crash, áramkimaradás stb.) csak a módosítások egy része történik meg, akkor a fa egy inkonzisztens állapotban maradhat.
A hagyományos megoldások közé tartozik a B-fa mellett egy további lemezes adatstruktúra — a tranzakciós napló, amelyet write-ahead log (WAL) néven is ismernek. Ez egy olyan fájl, amelybe a B-fa tényleges módosítása előtt rögzítik a tervezett műveletet. Így ha az önellenőrzés során adatkárosodást észlelnek, az adatbázis konzultál a naplóval, hogy helyreálljon.
Az LMDB a megbízhatóság biztosításának más megközelítését választotta, amelyet copy-on-write néven ismernek. A lényeg az, hogy ahelyett, hogy a meglévő lapon frissítené az adatokat, először teljesen lemásolja azt, és minden módosítást már a másolaton hajt végre.
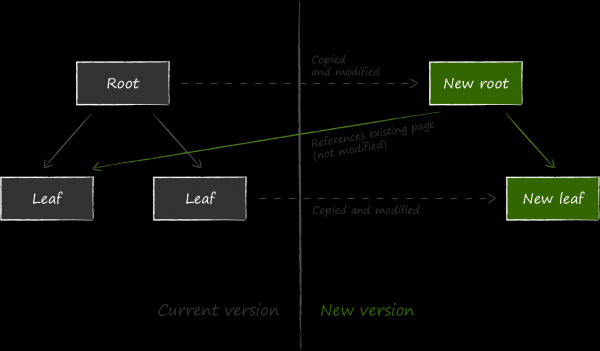
Ezután, hogy a frissített adatok elérhetőek legyenek, módosítani kell a szülőben lévő csomópontra mutató hivatkozást, hogy az aktuális csomópontra mutasson. Mivel ehhez azt is módosítani kell, azt is először lemásolják. A folyamat rekurzívan folytatódik a gyökérig. A legutolsóként az adatok a metaoldalon változnak.
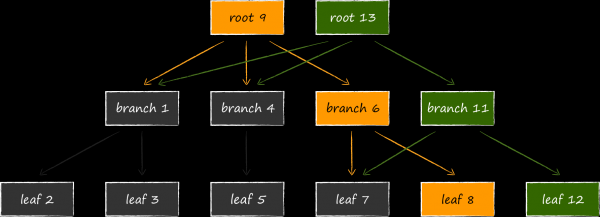
Ha a frissítési folyamat közben váratlan leállás történik, akkor vagy nem készül el az új meta-oldal, vagy az nem kerül mentésre a lemezre, és a checksumja érvénytelen lesz. Bármelyik esetben az új oldalak elérhetetlenné válnak, míg a régiek nem sérülnek. Ez megszünteti az LMDB számára a write ahead log vezetésének szükségességét az adatok konzisztenciájának megőrzésére. A fent leírt adathordozás struktúrája egyben fedi is e funkciót. A tranzakciós napló hiánya kifejezetten az LMDB egyik jellemzője, amely biztosítja az adatok gyors olvasását.
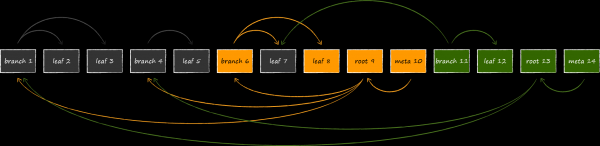
A létrejövő append-only B-tree nevű struktúra természeténél fogva biztosítja a tranzakciók izoláltságát és a többverziósságot. Az LMDB-ben minden megnyitott tranzakció egy aktuális gyökérfa-ágat társít. Amíg a tranzakció nincs befejezve, addig a hozzá kapcsolódó fa lapjai soha nem változnak meg, és nem használhatók új adatverziókhoz. Így bármeddig lehet dolgozni pontosan azzal az adathalazzal, amely a tranzakció megnyitásakor aktuális volt, még akkor is, ha a tároló közben aktívan frissül. Ez a többverziósság lényege, amely az LMDB-t tökéletes adatforrássá teszi mindenki kedvencéhez. UICollectionView. Tranzakció nyitásakor nem szükséges megnövelni az alkalmazás memóriaigényét az aktuális adatok sürgős memóriába kiolvasásával, félve attól, hogy üres kézzel maradunk. Ez a jellemző kedvezően megkülönbözteti az LMDB-t a SQLite-tól, amely nem büszkélkedhet ilyen teljes izolálással. Ha az utóbbiban két tranzakciót nyitunk meg, és az egyikben törlünk egy bejegyzést, azt a bejegyzést már nem lehet elérni a másik fennmaradó tranzakció keretein belül.
A dolog másik oldala a potenciálisan jelentősen megnövekedett virtuális memória-költség. A dián látható, hogy fog kinézni az adatbázis szerkezete, ha egyszerre történik a módosítása 3 nyitott olvasási tranzakcióval, amelyek különböző adatbázis-változatokra néznek. Mivel az LMDB nem tudja újrahasználni az éppen aktuális tranzakciókkal kapcsolatos gyökerekből elérhető csomópontokat, a tárolónak nem marad más választása, mint egy negyedik gyökér elhelyezése a memóriában, és újra klónozni a módosítható oldalakat.
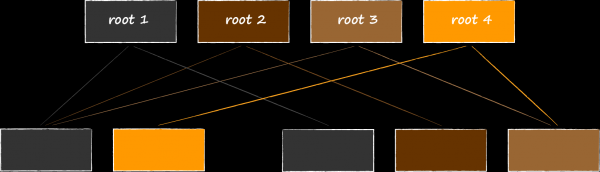
Itt nem árt felidézni a memóriatérképezett fájlokról szóló részt. Úgy tűnik, hogy a plusz virtuális memória költség nem kell, hogy különösebben aggasztó legyen, mivel nem járul hozzá az alkalmazás memóriahasználatához. Ugyanakkor megjegyezték, hogy az iOS nagyon féltékeny a memória kiosztására, és nem tudjuk, mint egy szerveren vagy asztali gépen, a szabad kezekkel biztosítani az LMDB-nek 1 terabyte-nyi területet, és teljesen figyelmen kívül hagyni ezt a sajátosságot. Lehetőleg minél rövidebb ideig kell tartani a tranzakciók élettartamát.
4. Adatséma tervezés a key-value API fölött
Az API elemzését az LMDB által biztosított alapvető absztrakciók áttekintésével kezdjük: környezet és adatbázisok, kulcsok és értékek, tranzakciók és kurzorok.
Megjegyzés a kódlistákról
Minden funkció a LMDB nyilvános API-jában eredményül hiba kódot ad vissza, de az összes következő listámban ez a hibaellenőrzés elmaradt a tömörség kedvéért. Gyakorlatilag teljesen saját C++ wrapper-ünket , amelyben a hibák C++ kivételekként materializálódnak.
A LMDB projektbe való leggyorsabb csatlakozási módjaként javaslom a saját CocoaPod-omat .
4.1. Alapvető absztrakciók
Környezet (environment)
Struktúra MDB_env az LMDB belső állapotának tárolója. Az "mdb_env" előtagú függvények családja lehetővé teszi néhány tulajdonság konfigurálását. A legegyszerűbb esetben a motor inicializálása így néz ki. mdb_env_create(env); mdb_env_set_map_size(*env, 1024 * 1024 * 512) mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664); A Mail.ru Cloud alkalmazásban az alapértelmezett értékeken csak két paraméternél változtattunk.
Szerializálás értékekA Mail.ru Felhő alkalmazásában csak két paraméter alapértelmezett értékeit módosítottuk.
Az első a virtuális címterület mérete, amelyre a tárolófájl térképezve van. Sajnos, még ugyanazon az eszközön is, a konkrét érték jelentősen eltérhet az egyes indítások során. Ennek a tulajdonságnak a figyelembevételéhez az iOS-en a maximális tároló méretet dinamikusan állítjuk be. Egy kiinduló értékből indulva fokozatosan feleződik, míg a funkció mdb_env_open nem tér vissza olyan eredménnyel, amely eltér a ENOMEM. Elméletileg létezik egy ellentétes megközelítés is — először a motor számára minimum memóriát foglalni, majd hiba esetén MDB_MAP_FULL, növelni azt. Ez azonban sokkal nehezebb. Ennek oka abban rejlik, hogy a memória újraaloktatásának (remap) folyamata a mdb_env_set_map_size függvénnyel érvényteleníti az összes korábban a motortól kapott entitást (kurzorok, tranzakciók, kulcsok és értékek). Az ilyen események figyelembevételének kódba történő beépítése jelentős bonyolítást eredményez. Ha azonban a virtuális memória nagyon fontos számodra, ez lehet az oka annak, hogy érdemes szemügyre venni egy messze előrehaladott ágat, amelynek egyik nyújtott funkciója az «automatikus, élő adatbázis méretigazítás».
A második paraméter, amelynek alapértelmezett értéke nem megfelelő számunkra, a szálbiztonság biztosításának mechanikáját szabályozza. Sajnos, legalábbis az iOS 10 alatt problémák vannak a szál-specifikus tárolás támogatásával. Ezért a fenti példában a tárolót a MDB_NOTLSflaggel nyitották meg. Ezen kívül szükség volt egy a C++ wrapperhez , hogy eltávolítsák a változókat ezzel a tulajdonsággal benne.
Adatbázisok
Az adatbázis külön B-fának egy példánya, amiről fentebb beszéltünk. Az megnyitása tranzakción belül történik, ami először kissé furcsának tűnhet.
MDB_txn *txn;
MDB_dbi dbi;
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn);
mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi);
mdb_txn_abort(txn);Valóban, a tranzakció az LMDB-ben a tároló entitása, nem pedig a konkrét adatbázisé. Ez a koncepció lehetővé teszi atomikus műveletek végrehajtását olyan entitásokon, amelyek különböző adatbázisokban találhatóak. Elméletileg ez lehetőséget ad arra, hogy a táblákat különböző adatbázisként modellezzük, de én egy másik, alább részletesen kifejtett utat választottam.
Kulcsok és értékek
Struktúra MDB_val modellez egy kulcs-érték koncepciót. A tároló semmiféle elképzeléssel nincs a szemantikájukról. Számára az egyik vagy a másik csupán a megadott méretű bájtok tömbje. A kulcs maximális mérete 512 bájt.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;A tároló a komparátor segítségével növekvő sorrendbe rendezi a kulcsokat. Ha nem cseréljük le a sajátját, akkor az alapértelmezettet használja, ami bájtonként lexikografikus sorrendben rendezi azokat.
Tranzakciók
A tranzakciók eszköze részletesen le van írva a , ezért itt egy rövid sorral ismétlem főbb jellemzőiket:
- Minden alapvető tulajdonság támogatása : atomikusság, konzisztencia, izolált és megbízhatóság. Nem hagyhatom említés nélkül, hogy a tartósság (durability) tekintetében a macOS és iOS rendszerekben van egy hiba, amelyet az MDBX javít. További részleteket olvashatunk róluk itt: .
- A több szálas megközelítés a "single writer / multiple readers" sémával van leírva. A írók blokkolják egymást, de nem blokkolják az olvasókat. Az olvasók nem blokkolják sem az írókat, sem egymást.
- Beágyazott tranzakciók támogatása.
- Több verzió támogatása.
A több verzió LMDB-ben annyira jól működik, hogy szeretném bemutatni működés közben. Az alábbi kódból látható, hogy minden tranzakció pontosan azzal az adatbázis verzióval dolgozik, amely aktuális volt a megnyitás időpontjában, teljesen elszigetelve minden későbbi változtatástól. A tároló inicializálása és egy tesztbejegyzés hozzáadása nem hoz semmi érdekeset, ezért ezeket a rituálékat spoiler alatt hagytam.
Tesztbejegyzés hozzáadása
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ". /testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Két tranzakciót indítunk, mindkettő
// egy rekord verzióját figyeli az adatbázisban.
mdb_txn_begin(env, NULL, 0, &txn1); // írás-olvasási
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // csak olvasási
// Az első tranzakció keretében eltávolítjuk a meglévő rekordot az adatbázisból.
mdb_del(txn1, dbi, &key, NULL);
// Az eltávolítást rögzítjük.
mdb_txn_commit(txn1);
// Megnyitjuk a harmadik tranzakciót, amely a
// aktuális adatbázis verziót figyeli, ahol a rekord már nincs.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Ellenőrizzük, hogy a keresett kulcs szerint a rekord már nem létezik.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Megszüntetjük a tranzakciót.
mdb_txn_abort(txn3);
// Ellenőrizzük, hogy a második tranzakció keretében, ami az adatbázis
// rekordjának létezésekor volt nyitva, még mindig megtalálható-e a kulcson.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Ellenőrizzük, hogy a kulcshoz nem valamilyen szemét adat, hanem érvényes információ érkezett.
assert(*(int *)val.mv_data == 997);
// Megszüntetjük a tranzakciót, amely bár elavult, de konzisztens adatbázissal dolgozik.
mdb_txn_abort(txn2);Opcióként javaslom, hogy próbálja ki ezt a trükköt SQLite-tel is, és nézze meg, mi történik.
A több verziós architektúra nagyon kellemes előnyöket nyújt az iOS-fejlesztők számára. E tulajdonsággal könnyedén és zökkenőmentesen szabályozhatjuk az adatforrás (data source) frissítési sebességét a felhasználói élmény szempontjából. Például vegyünk egy funkciót a Mail.ru felhő alkalmazásból, mint az automatikus tartalom betöltés a rendszer médiagalériájából. Jó kapcsolaton keresztül az ügyfél képes több fotót is feltölteni a szerverre másodpercenként. Ha minden feltöltés után aktualizáljuk UICollectionView a felhasználó felhőjében lévő médiatartalommal, akkor elfelejthetjük a 60 fps-t és a zökkenőmentes görgetést a folyamat során. A gyakori képernyőfrissítések megakadályozásához valahogyan korlátozni kell az adatok változási sebességét az alapban UICollectionViewDataSource.
Ha az adatbázis nem támogatja a többverziósságot, és csak a jelenlegi állapotával dolgozik, akkor a stabil időbeli adatpillanatkép létrehozásához másolni kell az adatokat egy in-memory adatstruktúrába vagy egy ideiglenes táblába. Bármelyik megoldás nagyon költséges. Az in-memory tárolás esetén memóriaköltségeink vannak a létrehozott objektumok tárolása miatt, valamint időbeli költségeink az elavult ORM-transzformációk miatt. Ami az ideiglenes táblát illeti, ez még költségesebb, és csak nem triviális esetekben van értelme.
Az LMDB többverzióssága nagyon elegánsan oldja meg egy stabil adatforrás fenntartásának feladatát. Csak annyit kell tennünk, hogy megnyitunk egy tranzakciót, és voila — amíg azt be nem fejezzük, a készletünk garantáltan rögzített. Az adatfrissítési sebesség logikája mostantól teljes mértékben a bemutató réteg kezében van, jelentős erőforrások felhasználása nélkül.
Kurzorok
A kurzorok mechanizmust biztosítanak a kulcs-érték párok sorrendben történő iterálására a B-fának bejárásával. Nélkülük lehetetlen lenne hatékonyan modellezni az adatbázis tábláit, amelyeket következtetésként megvizsgálunk.
4.2. Táblamodellezés
A kulcsok sorrendjének tulajdonsága lehetővé teszi, hogy a alapvető absztrakciók fölé egy olyan magas szintű struktúrát alkossunk, mint a tábla. Vizsgáljuk meg ezt a folyamatot egy felhőalapú kliens alap táblájának példáján, amely tárolja az összes fájl és mappa információját a felhasználóról.
A tábla séma
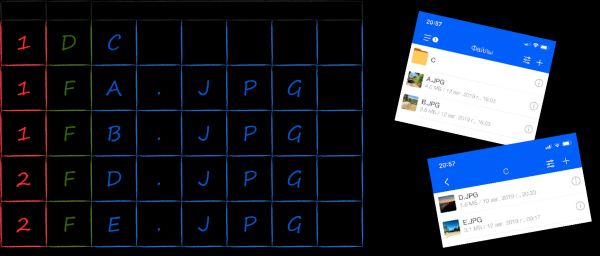
Egy gyakori forgatókönyv, amire a mappafák struktúráját optimalizálni kell — minden elem lekérdezése, amely a megadott könyvtáron belül található. A hatékony lekérdezésekhez jó adatmodellezési megoldás a . Ennek megvalósításához a kulcsokat, amelyek a fájlokat és mappákat képviselik, úgy kell rendezni, hogy a szülő könyvtárhoz való tartozásuk alapján csoportosuljanak. Továbbá a tartalom megszokott Windows nézetében való megjelenítéséhez (először a mappák, majd a fájlok, és mindkettő ábécé sorrendben) megfelelő kiegészítő mezőket kell beépíteni a kulcsba.
Az alábbi képen látható, hogy a feladott feladat alapján hogyan nézhet ki a kulcsok ábrázolása bájt tömbként. Először a szülő könyvtár azonosítójával rendelkező bájtok (piros) kerülnek, majd a típus (zöld) és végül a név (kék). A LMDB alapértelmezett összehasonlítója által lexikográfiai sorrendbe rendezve ezek a kívánt módon kerülnek elrendezésre. A kulcsok sorozatos bejárása ugyanazzal a piros prefixummal a felhasználói felületen (jobbra) megjelenítendő értékeket adja vissza abban a sorrendben, ahogyan azt ki kell adni anélkül, hogy további utófeldolgozásra lenne szükség.
Kulcsok és értékek sorosítása
A világ számos módszert talált ki a objektumok sorosítására. Mivel csak a sebesség volt a követelményünk, mi a leggyorsabbat választottuk a lehetségesek közül - a C nyelv struktúrájának memóriadumpját. Így a könyvtár elemének kulcsa a következő struktúrával modellezhető NodeKey.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;A tárolás érdekében NodeKey a tárolóban lévő objektumban MDB_val a mutatót a struktúra kezdetén lévő adatokra kell helyezni, és a méretét a következő függvénnyel kell kiszámítani sizeof.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = sizeof(NodeKey),
        .mv_data = (void *)key
    };
}
Az első fejezetben az adatbázisválasztás kritériumairól említettem, hogy az egyik fontos szempont a dinamikus allokációk minimalizálása a CRUD műveletek során. A serialize függvény kódja serialize megmutatja, hogy a LMDB esetében ezeket teljesen el lehet kerülni az új rekordok adatbázisba való beszúrásakor. Az érkező bájt tömb először átalakul verem struktúrákká, majd ezek triviálisan kerülnek dumpolásra a tárolóba. Figyelembe véve, hogy a LMDB-ben sincsenek dinamikus allokációk, fantasztikus iOS szituációt kaphatunk - az adatokat a hálózattól a lemezig csak verem memóriával kezeljük!
Kulcsok rendezése bináris összehasonlítóval
A kulcsok sorrendjét egy speciális funkció, az úgynevezett komparátor határozza meg. Mivel a motor semmit sem tud a benne lévő bitek szemantikájáról, a mérvadó komparátor számára nem marad más választás, mint lexikográfiai sorrendben rendezni a kulcsokat, byte-onkénti összehasonlítással. Ennek az eljárásnak a használata a struktúrák rendezésére hasonló, mint when a felületes vágóeszközt használunk. Mégis, egyszerűbb esetekben ezt a módszert elfogadhatónak találom. Az alternatíva alább van leírva, és itt megemlítek pár szétszórt akadályt ezen az úton.
Az első dolog, amit észben kell tartani, az a primitív típusok memória reprezentációja. Például az összes Apple eszközön az egész szám változók tárolása . Ez azt jelenti, hogy a legkevésbé jelentős byte bal oldalon található, és nem lehet egész számokat rendezni, azokat byte-onkénti összehasonlítással. Például, ha ezt megpróbáljuk egy 0-tól 511-ig terjedő számhalmazzal, a következő eredményre jutunk.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
A probléma megoldásához az egész számokat megfelelő formátumban kell tárolni a kulcsban, amely megfelel a byte-alapú komparátor elvárásainak. A szükséges átalakításokban segítenek a hton* függvények (különösen htons a példában említett kétbyte-os számokhoz).
A programozásban a karakterláncok reprezentációs formátuma, mint ismeretes, egy teljes . Ha a karakterláncok szemantikája, valamint a memóriában való képviseletükhöz használt kódolás azt jelenti, hogy egy karakterhez több mint egy byte tartozik, akkor a mérvadó komparátor használatának ötletét jobb azonnal elvetni.
A második dolog, amire figyelmet kell fordítani, az a packed attribútumot..
Kulcsok rendezése külső komparátor által
A kulcsok összehasonlításának logikája túl bonyolult lehet a bináris komparátor számára. Az egyik sok ok közül - a struktúrákban található technikai mezők megléte. Ezen jelenséget a már ismert könyvtár elem kulcsának példájával szeretném szemléltetni.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Bár rendkívül egyszerű, a legtöbb esetben túl sok memóriát használ. A névtároló 256 byte-ot foglal el, bár a fájlok és mappák nevei átlagosan ritkán haladják meg a 20-30 karaktert.
A méretoptimalizálás egyik standard módszere a rögzített méretre 'vágás'. Ennek lényege, hogy a változó hosszúságú mezők tartalmát a struktúra végén tároljuk, a hosszúságukat pedig külön változókban. Ennek a megközelítésnek megfelelően a kulcs NodeKey úgy alakul, hogy.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeKey;A továbbiakban a sorosítás során nem sizeof az egész struktúra méretének, hanem a fix hosszúságú mezők méretének és a ténylegesen használt tároló rész méretének összegét adjuk meg.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength,
        .mv_data = (void *)key
    };
}
A végrehajtott refaktorizálás eredményeként a kulcsok által foglalt hely jelentős megtakarítását értük el. Azonban a technikai mező nameLength, az alapértelmezett bináris összehasonlító már nem alkalmas a kulcsok összehasonlítására. Ha nem cseréljük le a sajátunkra, akkor a név hossza a rendezés során fontosabb tényező lesz, mint maga a név.
Az LMDB lehetővé teszi, hogy minden adatbázishoz saját kulcs-összehasonlító függvényt rendeljen. Ezt a mdb_set_compare függvénnyel állíthatjuk be, szigorúan az adatbázis megnyitása előtt. Nyilvánvaló okokból nem lehet megváltoztatni az adatbázis élete során. A bemenetként a összehasonlító két kulcsot kap bináris formátumban, a kimeneten pedig a összehasonlítás eredményét adja vissza: kisebb (-1), nagyobb (1) vagy egyenlő (0). A pszeudokód így néz ki. NodeKey int compare(MDB_val * const a, MDB_val * const b) { NodeKey * const aKey = (NodeKey * const)a->mv_data; NodeKey * const bKey = (NodeKey * const)b->mv_data; return // ... }
Mindaddig, amíg az adatbázisban minden kulcs ugyanazzal a típussal rendelkezik, a byte-reprezentációk feltétel nélküli átkonvertálása a kulcs alkalmazási struktúrájának típusává jogszerű. Itt van egy kis árnyalat, de ezt később tárgyaljuk az 'Adatok olvasása' szakaszban.Az értékek sorosítása
Szerializálás értékek
A LMDB tárolt rekordjaival való munka rendkívül intenzív. A kulcsok közötti összehasonlítás bármely alkalmazási műveleten belül történik, és a komparátor sebessége befolyásolja az egész megoldás teljesítményét. Az ideális világban a kulcsok összehasonlításához elegendő lenne a default bináris komparátor, de ha sajátot kellett használni, akkor a kulcsok deszerializálási eljárásának annyira gyorsnak kell lennie, amennyire csak lehetséges.
Az érték része a feljegyzésnek (value) a adatbázist különösebben nem érdekli. A bájtábrázolásból objektummá való konvertálás csak akkor történik, amikor az alkalmazáskódnak már szüksége van rá, például a képernyőn való megjelenítéshez. Mivel ez viszonylag ritkán történik meg, a sebességre vonatkozó követelmények nem annyira kritikusak, és a megvalósítás során sokkal inkább szabadon orientálódhatunk a kényelemre. Például a még nem betöltött fájlok metainformációinak szerializálásához ezt használjuk: NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Ennek ellenére előfordulnak olyan esetek, amikor a teljesítmény mégis számít. Például, amikor a felhasználói felhő fájlszerkezetének metaadatainak mentéséről van szó, ugyanazzal a memóriadump-al dolgozunk a objektumok esetében. A feladat érdekessége a szerializált reprezentáció létrehozásában az, hogy a könyvtári elemek osztályhierarchia segítségével vannak modellezve.
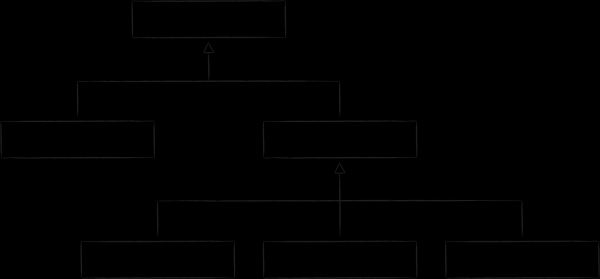
A megvalósításhoz C nyelven a leszármazottak specifikus mezőit külön struktúrákba helyezzük, és azok összekapcsolását egy union típussal határozzuk meg. Az aktuális unió tartalmát egy technikai attributum típus határozza meg.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Rekordok hozzáadása és frissítése
A szerializált kulcsot és értéket hozzá lehet adni a tárolóhoz. Ehhez a következő függvényt használjuk: mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);A konfigurációs lépés során a tárolóban engedélyezheti vagy megtilthatja, hogy több azonos kulccsal rendelkező rekord tárolása történjen. Ha a kulcsok duplikálása tilos, akkor a rekord beszúrásakor meghatározható, hogy megengedett-e a már létező rekord frissítése. Ha a felülírás csak a kódban bekövetkezett hiba miatt történhet, akkor ezt egy zászlóval biztosíthatjuk. NOOVERWRITE.
Rekordok olvasása
Rekordok olvasására az LMDB-ben az alábbi funkció van tervezve: mdb_get. Ha a kulcs-érték pár korábban dumpolt struktúrákkal van reprezentálva, akkor ez az eljárás a következőképpen néz ki.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}A bemutatott példakód megmutatja, hogyan lehet a struktúrák dumpján keresztüli sorosítással megszabadulni a dinamikus allokációktól nemcsak írás, hanem az adatok olvasása során is. A kapott mutató a funkcióból mdb_get a pontosan azon a virtuális memória címen néz, ahol az adatbázis tárolja az objektum byte-reprezentációját. Valójában egyfajta ORM-t kapunk, amely gyakorlatilag ingyen biztosít nagyon magas adatolvasási sebességet. Annak ellenére, hogy megnyerő a megközelítés, fontos figyelembe venni néhány, ezzel járó sajátosságot.
- Readonly tranzakció esetén a struktúra-érték mutatója garantáltan érvényes marad mindaddig, amíg a tranzakció le nem zárul. Ahogy korábban említettük, a B-fák oldalai, amelyeken az objektum található, a copy-on-write elv miatt változatlanok maradnak, amíg legalább egy tranzakció hivatkozik rájuk. Ugyanakkor, amint a legutolsó azzal összefüggő tranzakció befejeződik, az oldalak új adatok számára újra felhasználhatóak. Ha arra van szükség, hogy az objektumok túléljék a keletkeztető tranzakciót, akkor azokat mindenképpen másolni kell.
- Readwrite tranzakció esetén a kapott struktúra-érték mutatója csak az első módosító eljárásig (adat írása vagy törlése) marad érvényes.
- Annak ellenére, hogy a struktúra
NodeValuenem teljes értékű, hanem csökkentett (lásd a 'Kulcsok rendezése külső összehasonlítóval' részben), a mutató segítségével nyugodtan hivatkozhatunk a mezőire. A lényeg, hogy ne dereferáljuk! - Minden esetben tilos a struktúra módosítása a megkapott mutatón keresztül. Minden változtatást kizárólag a metóduson keresztül szabad végrehajtani.
mdb_putBármi is legyen a szándék, nem lehet megtenni, mivel a memória területe, ahol ez a struktúra található, csak olvasható módban van leképezve. - A fájl újramapolása a folyamat címtartományába például a tároló maximális méretének növelésére a következő funkció használatával
mdb_env_set_map_sizeteljesen érvényteleníti az összes tranzakciót és a kapcsolódó entitásokat, valamint a beolvasott objektumokra vonatkozó mutatókat.
Végül, egy másik jellemző olyan ravasz, hogy a lényegének feltárása nem fér bele egy újabb pontra. A B-fáról szóló fejezetben bemutattam a lapok memóriában való elrendezésének diagramját. Ebből kiderül, hogy a sorozatos adatokat tartalmazó puffert kezdőcímének címkéje teljesen véletlenszerű lehet. Emiatt a rájuk mutató mutató, amely a struktúrában található MDB_val és amelyet a struktúrára mutató mutatóvá alakítanak, általában nem megfelelően igazított. Ugyanakkor egyes chiparchitektúrák (iOS esetében az armv7) megkövetelik, hogy az adatok bármilyen címe a gépi szó méretének többszöröse legyen, más szóval a rendszer bitméretének (az armv7 esetében 32 bit). Más szavakkal, egy olyan művelet, mint például *(int *foo)0x800002 ezek esetében a megszegésnek számít és azon a verdikttel végződik, hogy EXC_ARM_DA_ALIGN. A szomorú végzet elkerülhető két módon.
Az első az adatok előzetes másolására korlátozódik egy előre beállított struktúrába. Például egy egyedi összehasonlító esetében ez így néz ki.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return \/\/ ...
}
Alternatív megoldás, hogy előre értesítjük a fordítót, hogy a kulcsokkal és értékekkel rendelkező struktúrák nem feltétlenül igazítottak az aligned(1)attribútummal. ARM esetében ugyanezt az eredményt elérhetjük növelheti is az adatokhoz való hozzáférés költségeit. typedef struct __attribute__((packed)) NodeKey { uint8_t parentId; uint8_t type; uint8_t nameLength; uint8_t nameBuffer[256]; } NodeKey;
Tartomány-megkeresésekRange-запросы
Az LMDB rekordcsoportján való iterálásra kurzor absztraktió áll rendelkezésre. Ahogyan az ismert felhasználói felhőmetaadatok táblázatán dolgozunk, nézzük meg, hogyan kell ezt csinálni.
A könyvtárban található fájlok listájának megjelenítésekor minden kulcsot meg kell találni, amely társítva van a gyermek fájlokkal és mappákkal. Az előző alfejezetekben játszottuk le a kulcsokat. NodeKey úgy, hogy ezek először a szülőkönyvtár azonosítója szerint legyenek rendezve. Így a mappa tartalmának megszerzése technikailag a kurzor beállítására korlátozódik a megadott prefixummal rendelkező kulcsok csoportjának felső határára, majd az alsó határig történő iterálásra.
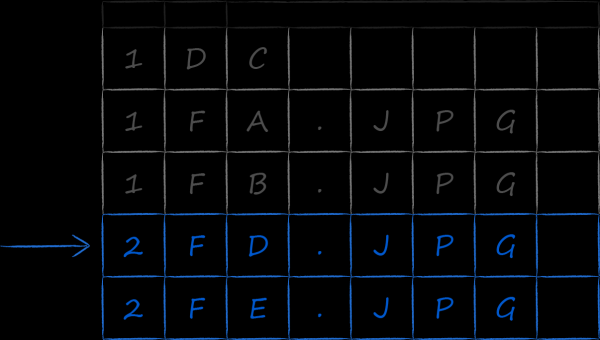
A felső határ megtalálható a "végig" sorozatos kereséssel. Ehhez a kurzort a teljes kulcsliszt elejére állítjuk, és onnantól kezdve növeljük, amíg alatta nem áll a szülőkönyvtár azonosítójával rendelkező kulcs. Ennek a megközelítésnek két szemmel látható hátránya van:
- A keresés lineáris bonyolultsága, bár tudvalevő, hogy fák esetén és különösen B-fák esetén ezt logaritmikus idő alatt lehet végrehajtani.
- Feleslegesen emeljük ki a fájl összes előző oldalát a főmemóriába, ami rendkívül drága.
Szerencsére az LMDB API egy hatékony módot biztosít a kurzor kezdeti pozicionálására. Ehhez olyan kulcsot kell képezni, amelynek értéke biztosan kisebb vagy egyenlő, mint a tartomány felső határán lévő kulcs. Például a fenti ábrához viszonyítva készíthetünk egy kulcsot, amelyben a 'parentId' mező parentId 2-t ér, és minden más mező nulla. Az ilyen félig kitöltött kulcsot a 'mdb_cursor_get' funkció bemenetére kell adni. mdb_cursor_get az 'MDB_SET_RANGE' művelet megadásával. NodeKey upperBoundSearchKey = { .parentId = 2, .type = 0, .nameLength = 0 }; MDB_val value, key = serialize(upperBoundSearchKey); MDB_cursor *cursor; mdb_cursor_open(..., &cursor); mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);.
Ha a kulcsok csoportjának felső határa megtalálható, akkor tovább iterálunk rajta, amíg vagy el nem érünk egy másik kulcsot,vagy a kulcsok véget nem érnek. parentIddo { rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT); // feldolgozás... } while (MDB_NOTFOUND != rc && // ellenőrizzük a táblázat végét IsTargetKey(key)); // ellenőrizzük a kulcsok csoportját
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
// feldolgozás...
} while (MDB_NOTFOUND != rc && // a tábla végét ellenőrizzük
IsTargetKey(key)); // a kulcsok csoportjának végét ellenőrizzükAmi kellemes, hogy az mdb_cursor_get használatával történő iteráció során nemcsak a kulcsot, hanem az értéket is megkapjuk. Ha a lekérdezési feltételek teljesítéséhez szükséges ellenőrizni az érték részéből származó mezőket, azok teljesen elérhetőek további lépések nélkül.
4.3. Kapcsolatok modellezése a táblák között
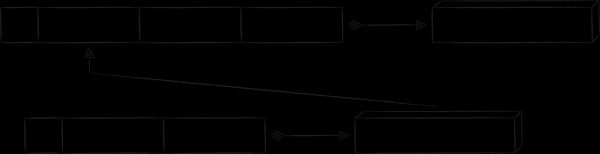
Jelenleg sikerült megvizsgálnunk az egytáblás adatbázis tervezésének és működésének minden aspektusát. Azt lehet mondani, hogy a tábla egy rendezetten sorba állított rekordok halmaza, melyek azonos típusú kulcs-érték párokból állnak. Ha a kulcsot egy téglalapként, az ahhoz kapcsolódó értéket pedig egy párhuzamos hasábként ábrázolnánk, akkor egy vizuális adatbázis sémát kapnánk.

Azonban a valós életben ritkán sikerül ennyire keveset szenvedni. Gyakran szükséges egy adatbázisban több táblát létrehozni, és másodszor, azokat a kiválasztásokat végezni, amelyek eltérnek az elsődleges kulcs sorrendjétől. Ennek a fejezetnek a célja ezen táblák létrehozásának és összekapcsolásának a kérdéseit tárgyalja.
Indexelési táblák
A felhőalkalmazásban van egy "Galéria" szakasz. Ebben az egész felhő médiatartalma dátum szerint van rendezve. Az ilyen kiválasztás optimális végrehajtásához a fő tábla mellett létre kell hozni egy másik, új típusú kulcsokkal rendelkező táblát. Ebben a tábla tartalmazni fog egy mezőt a fájl létrehozásának dátumával, ami a rendezés elsődleges szempontjának fog számítani. Mivel az új kulcsok ugyanarra az adatra hivatkoznak, mint a fő tábla kulcsai, indexelt kulcsoknak hívják őket. Az alábbi képen narancssárga színnel vannak kiemelve.
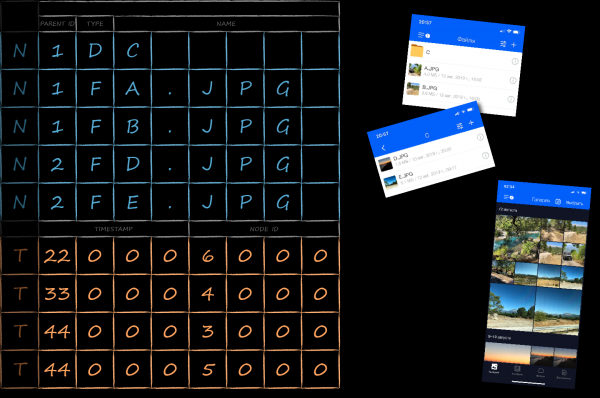
Ahhoz, hogy egy adatbázison belül elkülönítsük a különböző táblák kulcsait, mindegyikhez hozzá lett adva egy kiegészítő technikai mező, a tableId. Ha ezt prioritássá tesszük a rendezésnél, elérhetjük a kulcsok táblák szerinti először csoportosítást, majd a táblákon belül a saját szabályaik szerint.
Az indexelt kulcs ugyanarra az adatra hivatkozik, mint az elsődleges. Ennek a tulajdonságnak a közvetlen megvalósítása az elsődleges kulcs value részével való kapcsolattal több szempontból is nem optimális:
- Helyigény szempontjából, mivel a metaadatok elég gazdagok lehetnek.
- Teljesítmény szempontjából, mivel a metaadatok frissítésekor a csomópontoknak két kulcs mellett kell újraírniuk.
- A kód támogatása szempontjából, ha elfelejtünk frissíteni az adatokat az egyik kulcsnál, akkor egy nehezen észlelhető adat-inkonzisztenciát kapunk a tárolóban.
Tovább nézzük, hogyan lehet felszámolni ezeket a hiányosságokat.
Kapcsolatok szervezése a táblák között
A kapcsolati indexelt táblához jól illik a minta „kulcs mint érték”. Ahogy a neve is sugallja, a value-részében az indexbejegyzés egy példányát adjuk meg az elsődleges kulcs értékének. Ez a megközelítés semlegesíti az összes fent említett hátrányt, amely az elsődleges bejegyzés value-részének másolatának tárolásával jár. Az egyetlen hátrány, hogy az indexkulcs értékének megszerzéséhez két lekérdezést kell végrehajtani az adatbázison, nem pedig egyet. A kapott adatbázis séma így néz ki.
Még egy minta a táblák közötti kapcsolatok szervezésére „túlkönnyű kulcs”. A lényege, hogy a kulcsba további attribútumokat adunk hozzá, amelyek nem a rendezéshez szükségesek, hanem a kapcsolódó kulcs újbóli létrehozásához. A Mail.ru Felhő alkalmazásában valódi példákat találunk erre, azonban anélkül, hogy mélyen belemerülnénk a specifikus iOS-keretrendszerek kontextusába, egy kitalált, de érthetőbb példát hozok fel.
A felhős mobilkliensekben van egy oldal, ahol az összes fájl és mappa látható, amelyhez a felhasználó más személyeknek is hozzáférést adott. Mivel ezekből az állományokból viszonylag kevés van, és sokféle kapcsolódó specifikus információval rendelkeznek a nyilvánosságról (kinek adtak hozzáférést, milyen jogokkal stb.), nem lenne ésszerű a fő táblázat bejegyzésének value-részét így megterhelni. Azonban, ha offline szeretnénk ezeket a fájlokat megjeleníteni, akkor valahol mégis tárolnunk kell őket. A természetes megoldás az, hogy egy külön táblát hozunk létre ennek. Az alábbi sémán a kulcsának prefixe „P”, és a placeholder „propname” egy konkrétabb „nyilvános információ”-ra cserélhető.
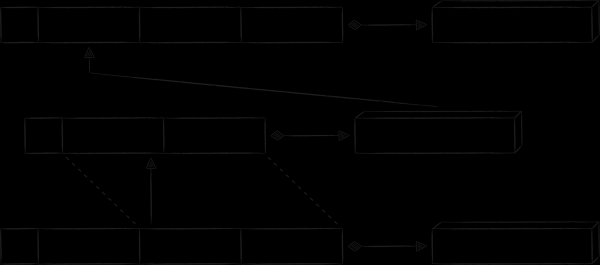
Minden egyedi metaadat, amiért új táblát hoztak létre, a bejegyzés value részébe kerül. Ugyanakkor nem szeretnénk megkettőzni azokat az adatokat a fájlokról és mappákról, amelyek már a fő táblában tárolva vannak. Ehelyett a „P” kulcshoz redundáns adatokat adunk a „node ID” és a „timestamp” mezők formájában. Ezek segítségével felépíthetjük az indexkulcsot, amin keresztül megkaphatjuk az elsődleges kulcsot, amivel végül megkapjuk a csomópont metaadatait.
Következtetés
A LMDB bevezetésének eredményeit pozitívan értékeljük. Ezt követően az alkalmazás fagyásainak száma 30%-kal csökkent.
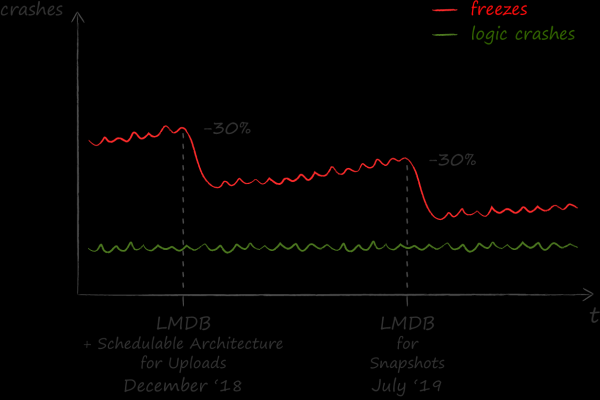
A végzett munka eredményei már a csapaton kívül is visszhangot kaptak. Jelenleg az Android alkalmazás egyik fő szakasza, a „Fájlok”, szintén áttért a LMDB használatára, míg más részek ennek az útján haladnak. A C nyelv, amelyben a key-value tároló megvalósult, jó alapot nyújtott ahhoz, hogy kezdetben multiplatform alkalmazásréteget készítsünk C++ nyelven körülötte. A C++ könyvtár és a platformkód közötti zökkenőmentes kapcsolatra a Djinni kódgenerátort használtuk. a Dropbox-tól, de ez már egy teljesen más történet.
Forrás: habr.com
