

A Netflix – az internetes tévészolgáltatás piacvezetője – egy olyan vállalat, amely létrehozta és aktívan fejleszti ezt a szegmenst. A Netflix nemcsak egy széles film- és sorozatkatalógusról ismert, amelyet szinte bárhol a világon és bármilyen kijelzővel rendelkező eszközön elérhetünk, hanem megbízható infrastruktúrájáról és egyedülálló mérnöki kultúrájáról is.
A Netflix megközelítésének szemléletes példáját mutatta be a DevOops 2019 konferencián – a Netflix fejlesztési igazgatója. A Lobacsevszkij NNI VMK karának végzettje, Szergej az első mérnökök egyike volt az Open Connect – a Netflix CDN csapatában. Ő építette ki a videoadatok monitorozási és elemzési rendszereit, elindította a népszerű internet sebességértékelő szolgáltatást, a FAST.com-ot, és az utolsó néhány évben az internetes kérések optimalizálásán dolgozik, hogy a Netflix alkalmazás a lehető leggyorsabban működjön a felhasználók számára.
A beszámoló a konferencia résztvevőitől a legjobb visszajelzéseket kapta, és elkészítettük a szöveges változatát.
A beszámolóban Szergej részletesen beszélt
- arról, hogy mik befolyásolják az internetes kérések késleltetését a kliens és a szerver között;
- hogyan lehet csökkenteni ezt a késleltetést;
- hogyan lehet tervezni, fenntartani és monitorozni a hibatűrő rendszereket;
- hogyan lehet elérni az eredményeket rövid idő alatt, minimális kockázattal a vállalkozás számára;
- hogyan lehet elemezni az eredményeket és tanulni a hibákból.
Ezekre a kérdésekre nemcsak azoknak van szüksége, akik nagyvállalatoknál dolgoznak.
A bemutatott elvek és technikák ismerete és gyakorlása mindenki számára fontos, aki internetes termékeket fejleszt és tart karban.
Következik a szónok beszámolója.
Az internet sebességének fontossága
Az internetes kérések sebessége közvetlen összefüggésben áll az üzlettel. Vegyük szemügyre a vásárlási szférát: az Amazon 2009-ben , hogy a 100 ms késleltetés 1% -os értékesítési veszteséget okoz.
Műveleti eszközök és velük együtt mobil oldalak és alkalmazások száma folyamatosan növekszik. Ha az Ön oldalának betöltési ideje meghaladja a 3 másodpercet, körülbelül a felhasználók felét elveszíti. A a Google figyelembe veszi a weboldala betöltési sebességét a keresési eredményekben: minél gyorsabb az oldal, annál előkelőbb helyezést kap a Google-ben.
A kapcsolat sebessége szintén fontos a pénzügyi intézményeknél, ahol a késleltetés kritikus. 2015-ben a Hibernia Networks A kábeltávvezeték, amely New York és London között 400 millió dollárért készült, hogy 6 ms-al csökkentse a késleltetést a városok között. Képzelje el, 66 millió dollár 1 ms késleltetés csökkentéséért!
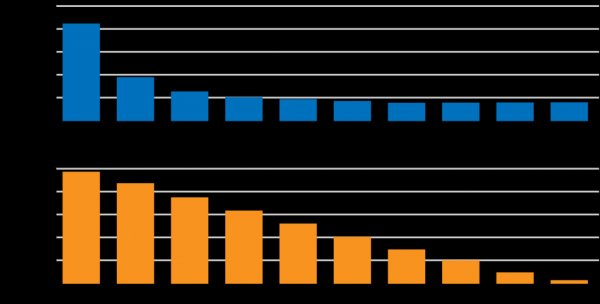
A következő szerint , a 5 Mbit/s sebességnél a kapcsolat sebessége már nem hat közvetlenül a weboldalak betöltési sebességére. Azonban van egy lineáris összefüggés a késleltetés és az oldalbetöltési sebesség között:
A Netflix azonban nem egy tipikus termék. A késleltetés és a sebesség felhasználóra gyakorolt hatása aktív elemzés és fejlesztési terület. Vannak alkalmazásbetöltések és tartalomválasztások, amelyek a késleltetéstől függenek, de a statikus elemek betöltése és a streaming is függ a kapcsolat sebességétől. A felhasználói élmény minőségét befolyásoló kulcsfontosságú tényezők elemzése és optimalizálása a Netflix több csapatának aktív fejlesztési területe. Az egyik feladat a késleltetés csökkentése a Netflix eszközök és a felhőinfrastruktúra között.
Jelentésünk fókuszában a késleltetés csökkentése áll, a Netflix infrastruktúrájának példáján keresztül. Megvizsgáljuk, hogy gyakorlatilag hogyan közelíthetünk a bonyolult elosztott rendszerek tervezéséhez, fejlesztéséhez és üzemeltetéséhez, és hogyan tölthetünk időt az innováción és az eredményeken, nem pedig operációs problémák és hibák diagnosztizálásán.
A Netflix belsejében
Több ezer különböző eszköz támogatja a Netflix alkalmazásokat. Ezek fejlesztését négy különböző csapat végzi, amelyek különféle ügyfél verziókat készítenek Android, iOS, TV és webböngészők számára. Nagy mértékben fektetünk abba, hogy javítsuk és személyre szabjuk a felhasználói felületet. Ehhez párhuzamosan több száz A/B tesztet indítunk.
A személyre szabás több ezer mikroszolgáltatás révén valósul meg az AWS felhőben, amelyek személyre szabott adatokat nyújtanak a felhasználóknak, kérésmenedzsmentet, telemetriát, Big Data-t és kódolást. A forgalom vizualizációja így néz ki:
A bal oldalon található belépési pont, majd a forgalom elosztódik több száz mikroszolgáltatás között, amelyeket különböző backend csapatok támogatnak.
Egy másik fontos összetevője infrastruktúránknak az Open Connect CDN, amely statikus tartalmat – videókat, képeket, ügyfélkódot stb. – juttat el a végfelhasználókhoz. A CDN egyedi szervereken (OCA – Open Connect Appliance) helyezkedik el. Ezekben SSD és HDD tömbök találhatók, optimalizált FreeBSD, NGINX és egy sor szolgáltatás működtetésével. Úgy tervezzük és optimalizáljuk a hardver- és szoftverkomponenseket, hogy a CDN szerver a lehető legtöbb adatot tudja eljuttatni a felhasználókhoz.
Ezeknek a szervereknek a 'fala' az internetforgalom-csere pontján (Internet eXchange – IX) így néz ki:
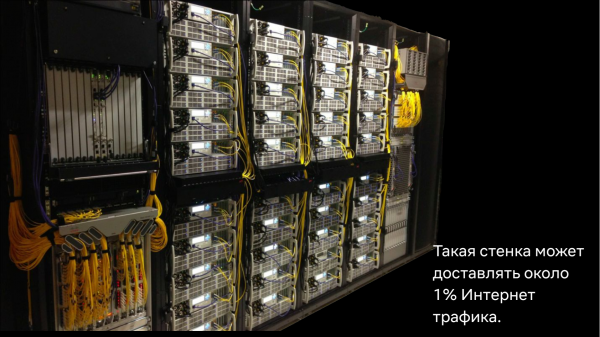
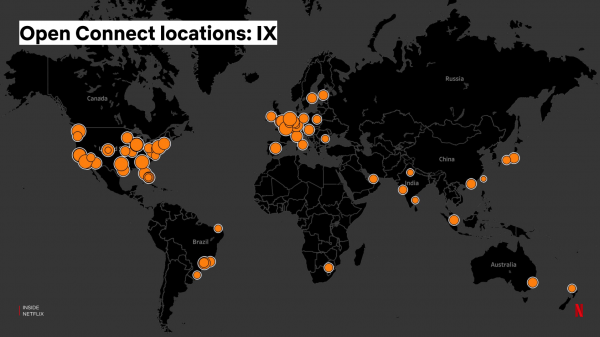
Az Internet Exchange lehetőséget biztosít az internetszolgáltatóknak és a tartalomszolgáltatóknak, hogy "csatlakozzanak" egymáshoz a közvetlenebb adatcserére az interneten. Világszerte kb. 70-80 Internet Exchange pont található, ahol szervereink telepítve vannak, és mi saját magunk végezzük az installálásukat és karbantartásukat:
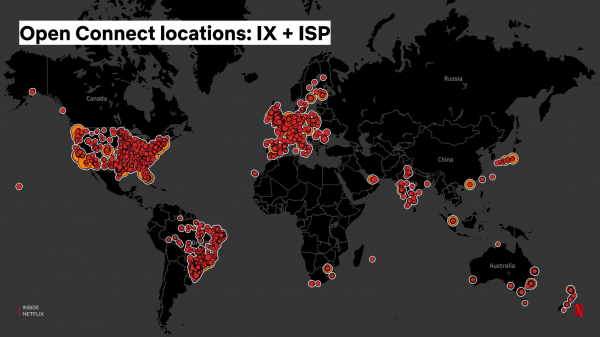
Ezen felül közvetlenül internetszolgáltatóknak is biztosítunk szervereket, amelyeket ők a saját hálózatukba telepítenek, javítva a Netflix forgalom lokalizációját és a streaming minőségét a felhasználók számára:
Az AWS szolgáltatások készlete felelős a videó kérések irányításáért a CDN szerverekhez, valamint a szerverek konfigurálásáért – tartalom, programkód, beállítások frissítése stb. Ehhez létrehoztunk egy backbone hálózatot is, amely összeköti a szervereket az Internet Exchange pontokon az AWS-sel. A backbone hálózat egy globális optikai szálas kábelekből és routerekből álló hálózat, amelyet igényeink szerint tervezhetünk és konfigurálhatunk.
A , a CDN infrastruktúránk csúcsidőszakban a globális internetforgalom körülbelül ⅛-át, és Észak-Amerikában a forgalom ⅓-át juttatja el, ahol a Netflix már a legrégebb óta elérhető. Megdöbbentő számok, de számomra az egyik legmeglepőbb eredmény az, hogy az egész CDN rendszer kevesebb mint 150 fős csapat által kerül kifejlesztésre és fenntartásra.
Kezdetben a CDN infrastruktúrát videóadatok szállítására tervezték. Azonban idővel rájöttünk, hogy a dinamikus kérések optimalizálására is felhasználhatjuk az AWS felhőben.
Az internet gyorsítása
A Netflix 3 AWS régióval rendelkezik, és a felhőhez való kapcsolódás késleltetése attól függ, milyen messze van az ügyfél a legközelebbi régiótól. Ezen kívül számos CDN szerverünk van, amelyek statikus tartalom kiszolgálására szolgálnak. Van valamilyen mód, hogy ezt az infrastruktúrát felhasználva felgyorsítsuk a dinamikus lekéréseket? Sajnos ezeket a lekéréseket nem lehet gyorsítótárazni, mivel az API-k személyre szabottak, és minden eredmény egyedi.
Csináljunk egy proxyt a CDN szerveren, és kezdjük el rajta átvezetni a forgalmat. Ez gyorsabb lesz?
A hálózati alapok
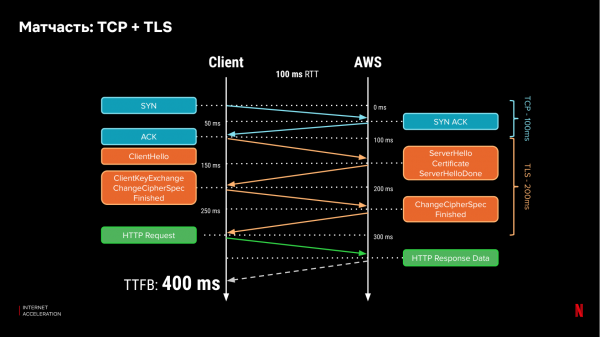
Emlékezzünk, hogyan működnek a hálózati protokollok. Ma a forgalom nagy része az interneten HTTPs-t használ, amely a TCP és TLS alsóbb szintű protokolljaitól függ. Ahhoz, hogy az ügyfél csatlakozzon a szerverhez, kézfogásra van szükség, és a biztonságos kapcsolat létrehozásához az ügyfélnek három üzenetet kell cserélnie a szerverrel, valamint legalább még egyszer, hogy adatokat továbbítson. Ha az egy körben történő késleltetés (RTT) 100 ms, akkor 400 ms-ra van szükségünk, hogy megkapjuk az első adatbitet:
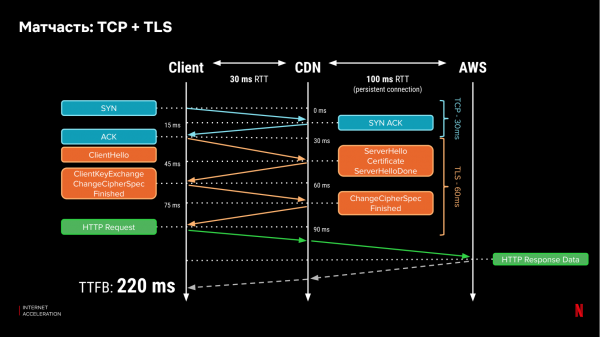
Ha a tanúsítványokat a CDN szerveren helyezzük el, akkor a 'kézfogás' ideje a kliens és a szerver között jelentősen csökkenthető, ha a CDN közelebb van. Tegyük fel, hogy a késleltetés a CDN szerverhez 30 ms. Ekkor az első bit megszerzéséhez már csak 220 ms szükséges:
De a pozitívumok itt nem érnek véget. Miután a kapcsolat már létrejött, a TCP növeli a congestion window-t (azt az információmennyiséget, amelyet párhuzamosan át tud adni ezen a kapcsolaton). Ha egy adatcsomag elveszik, a klasszikus TCP-implementációk (például TCP New Reno) a nyitott 'ablak' méretét a felére csökkentik. A congestion window növekedése és a veszteségből való helyreállás sebessége ismét a szerverhez való késleltetéstől (RTT) függ. Ha a kapcsolat csak a CDN szerverhez vezet, akkor a helyreállítás gyorsabb lesz. A csomagvesztés pedig standard jelenség, különösen vezeték nélküli hálózatokban.
Az internet sávszélessége csökkenhet, különösen csúcsidőben a felhasználói forgalom miatt, ami "dugókat" okozhat. Az interneten nincs módszer a kérések prioritásának megadására másokkal szemben. Például prioritást adni a kis méretű és késleltetésre érzékeny kéréseknek a "nehéz" adatfolyamokkal szemben, amelyek leterhelik a hálózatot. Azonban a saját backbone hálózatunk lehetővé teszi ezt a kérés útjának egy részén – a CDN és a felhő között, és ezt teljes mértékben konfigurálhatjuk. Megtehetjük, hogy a kis és késleltetésre érzékeny csomagokat prioritizedjuk, míg a nagy adatfolyamok kicsit később indulnak el. Minél közelebb van a CDN a klienshez, annál hatékonyabb lesz.
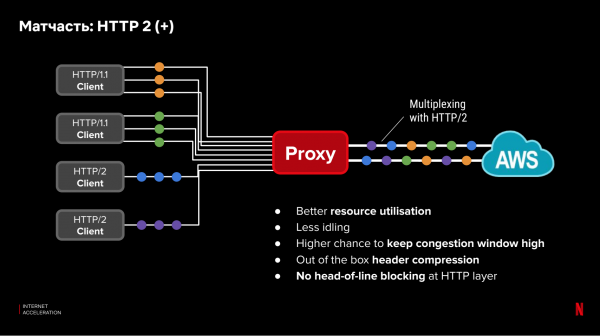
A késleltetésre hatással vannak az alkalmazási szintű protokollok (OSI 7. szint). Az új protokollok, mint például a HTTP/2, lehetővé teszik a párhuzamos kérések teljesítményének optimalizálását. Azonban van a Netflixnek ügyfelei, akik régi eszközöket használnak, amelyek nem támogatják az új protokollokat. Nem minden ügyfelet lehet frissíteni, vagy optimálisan konfigurálni. A CDN proxy és a felhő közötti teljes kontrolljaink és lehetőségünk van új, optimális protokollok és beállítások használatára. A régi protokollokkal rendelkező rész ineffektív lesz, és csak a kliens és a CDN szerver között működik. Ráadásul már létező kapcsolat esetén multiplexelhetjük a kéréseket a CDN és a felhő között, javítva a TCP szintű kapcsolat kihasználását:
Mérjük
Bár a tudomány ígér fejlesztéseket, nem ugrunk rögtön a rendszer éles üzembe helyezésére. Először bizonyítanunk kell, hogy az elképzelés a gyakorlatban is működik. Ehhez néhány kérdésre kell választ adni:
- Sebesség: gyorsabb lesz a proxy?
- Megbízhatóság: gyakrabban fog-e megszűnni?
- Bonyolultság: hogyan integrálható a alkalmazásokkal?
- Ár: mennyibe kerül a további infrastruktúra telepítése?
Részletesen megvizsgáljuk az első ponthoz alkalmazott megközelítésünket. A többit hasonló módon vizsgáljuk meg.
A kérések sebességének elemzéséhez az összes felhasználóra vonatkozó adatokat szeretnénk kapni, anélkül, hogy sok időt pazarolnánk a fejlesztésre vagy megsértenénk a production rendszert. Erre több megközelítés létezik:
- RUM, vagy passzív kérésmérés. Mérjük a felhasználók aktuális kéréseinek végrehajtási idejét, és biztosítjuk a felhasználók teljes lefedettségét. Hátrány — nem túl stabil jel a sok tényező miatt, például a különböző kérésméretek, a szerver és kliens feldolgozási ideje miatt. Ezen kívül nem lehet új konfigurációt tesztelni a produkciós környezet hatása nélkül.
- Laboratóriumi tesztek. Speciális szerverek és infrastruktúra, amelyek ügyfeleket szimulálnak. Ezek segítségével végezzük a szükséges teszteket. Így teljes kontrollt kapunk az mérési eredmények felett és világos jelet. De nincs teljes lefedettség az eszközök és a felhasználók elhelyezkedése szempontjából (különösen a világméretű szolgáltatások és ezer készülékmodell támogatása esetén).
Hogyan lehet összevonni a két módszer előnyeit?
Csapatunk megtalálta a megoldást. Írtunk egy kis kódot — próbát — amelyet beépítettünk az alkalmazásunkba. A próbák lehetővé teszik számunkra, hogy teljesen ellenőrzött hálózati teszteket végezzünk az eszközeinkről. Így működik:
- Nem sokkal az alkalmazás betöltése és az első tevékenységek befejezése után elindítjuk a próbáinkat.
- Az ügyfél kérésére a szerver megkapja a teszt "receptjét". A recept egy URL-címek listáját tartalmazza, amelyekhez HTTP(s) kéréseket kell küldeni. Ezen kívül a recept konfigurálja a kérések paramétereit: késlekedések a kérések között, a kért adatok mennyisége, HTTP(s) fejléc és így tovább. Eközben párhuzamosan több különböző receptet is tesztelhetünk — a konfigurációs kérés során véletlenszerűen határozzuk meg, hogy melyik receptet adjuk ki.
- A próba indításának ideje úgy van kiválasztva, hogy ne ütközzön az ügyfél hálózati erőforrásainak aktív használatával. Lényegében egy olyan időpontot választunk, amikor az ügyfél inaktív.
- A recept megkapása után az ügyfél párhuzamosan kéréseket indít minden egyes URL-címre. A kérések minden egyes címen ismétlődhetnek — a legújabb "impulzusok". Az első impulzus során mérjük, hogy mennyi időt vett igénybe a kapcsolat létesítése és az adatok letöltése. A második impulzus során az adatbetöltési időt mérjük a már létrejött kapcsolaton. A harmadik impulzus előtt késleltetést állíthatunk be, és mérhetjük az új kapcsolat létesítésének sebességét stb.
A teszt során minden olyan paramétert mérünk, amelyet az eszköz képes nyújtani:
- DNS lekérdezés ideje;
- TCP kapcsolat létrehozásának ideje;
- TLS kapcsolat létrehozásának ideje;
- az első bájt adat megérkezésének ideje;
- teljes betöltési idő;
- a válasz státusz kódja.
- Miután az összes mérés befejeződött, a próbafelület betölti az összes mérés eredményeit az elemzéshez.
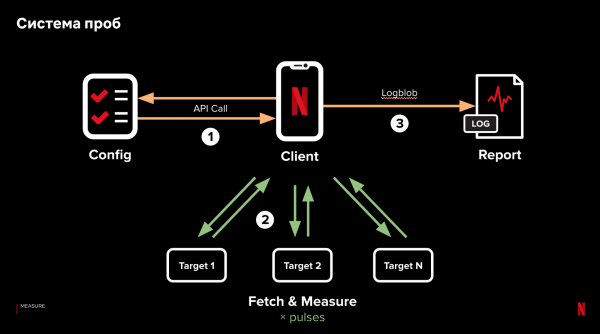
A kulcsfontosságú elemek közé tartozik a minimális függés az ügyfél logikájától, az adatok feldolgozása a szerveren és a párhuzamos lekérdezések mérése. Így lehetőségünk van izolálni és tesztelni a különböző tényezők hatását a lekérdezések teljesítményére, és variálni azokat egy recept keretein belül, valamint eredményekhez jutni a valós helyzetből.
Ez az infrastruktúra nemcsak a lekérdezések teljesítményének elemzésére bizonyult hasznosnak. Jelenleg 14 aktív receptünk van, több mint 6000 próba másodpercenként, amelyek az egész világ minden sarkából adatokat gyűjtenek, teljes eszközborítással. Ha a Netflix külső cégektől vásárolna hasonló szolgáltatást, az évente milliókba kerülne, sokkal rosszabb lefedettséggel.
Ellenőrizzük a elméletet a gyakorlatban: prototípus
Ezzel a rendszerrel lehetőségünk volt értékelni a CDN proxy hatékonyságát a lekérdezések késésében. Most szükség van arra, hogy:
- protótípus proxy-t hozzunk létre;
- a prototípust a CDN-en helyezzük el;
- meghatározzuk, hogyan irányíthatjuk az ügyfeleket a proxyhoz egy adott CDN szerveren;
- összehasonlítsuk a teljesítményt az AWS lekérdezéseivel proxy nélkül.
A feladat az, hogy a lehető leggyorsabban értékeljük a javasolt megoldás hatékonyságát. A prototípus megvalósításához a Go nyelvet választottuk, figyelembe véve a jó hálózati könyvtárakat. Minden CDN szerveren a prototípust statikus binárisként telepítettük, hogy minimalizáljuk a függőségeket és megkönnyítsük az integrációt. A kezdeti megvalósítás során maximálisan kihasználtuk a standard komponenseket, és néhány apró módosítást végeztünk a HTTP/2 kapcsolati pooling és kérés multiplexálás terén.
A regionális terheléselosztás érdekében az AWS régiók között egy földrajzi DNS adatbázist használtunk, amelyet az ügyfélforgalom terheléselosztásához is alkalmazunk. Az ügyfél CDN szerverének kiválasztásához TCP Anycast-ot alkalmazunk az Internet Exchange-en (IX) található szervereknél. Ebben az esetben egy IP-címet használunk az összes CDN szerverhez, így az ügyfél a legkevesebb IP hops-ot igénylő CDN szerverhez kerül irányításra. Az internetszolgáltatók (ISP) által telepített CDN szervereken nincs ellenőrzésünk a router felett a TCP Anycast beállításához, így , amely alapján az ügyfelek az internetszolgáltatókhoz kerülnek irányításra videostreaminghez.
Így háromféle út áll rendelkezésünkre a kérésekhez: a felhőbe nyílt interneten keresztül, IX-en keresztül egy CDN szerveren, vagy egy internetszolgáltató által elhelyezett CDN szerveren keresztül. Célunk, hogy megértsük, melyik út a legjobb, és mi a haszna a proxynak a kérések production-ba való irányításához képest. Ehhez próbálkozási rendszert használunk az alábbi módon:
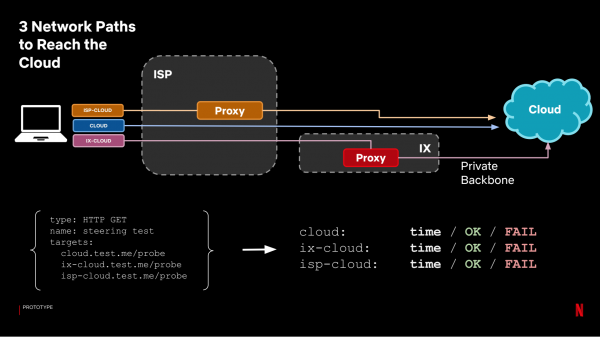
Mindegyik út külön célnak számít, és nézzük az elért időt. Az elemzéshez összevonjuk a proxy eredményeket egy csoportba (kiválasztjuk a legjobb időt az IX és ISP proxy között), és összehasonlítjuk az időt a felhőbe jutó kérelmekkel proxy nélkül:
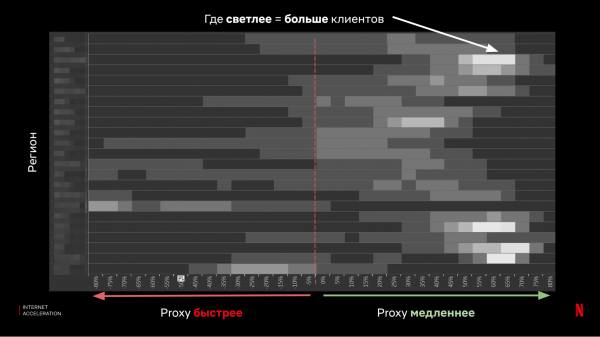
Ahogy látható, az eredmények vegyesek lettek - a legtöbb esetben a proxy jó sebességnövekedést ad, de olyan ügyfelek is vannak számos, akiknek a helyzete jelentősen romlik.
Végül néhány fontos dolgot tettünk:
- Értékeltük az ügyfelek várható kérési teljesítményét a CDN proxy-n keresztül a felhőbe.
- Adatokat gyűjtöttünk valódi ügyfelektől, mindenféle eszközről.
- Megértettük, hogy a teoria nem bizonyult 100%-ig helytállónak, és az eredeti javaslatunk a CDN proxy használatával nem működik számunkra.
- Nem kockáztattunk - nem változtattunk a production konfigurációkon az ügyfelek számára.
- Semmit sem romboltunk le.
Prototípus 2.0
Tehát visszatérünk a tervezőasztalhoz, és újra elkezdjük a folyamatot.
Az ötlet az, hogy a 100%-os proxynak helyett minden ügyfél számára meghatározzuk a leggyorsabb utat, és oda irányítjuk a kéréseket - vagyis azt tesszük, amit ügyfélirányításnak hívunk.
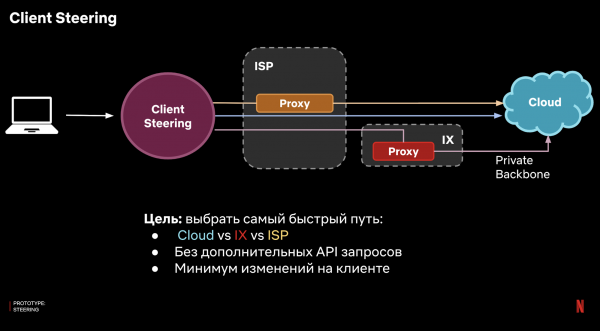
Hogyan valósítható meg? Nem használhatunk szerveroldali logikát, mivel a cél az, hogy csatlakozzunk ehhez a szerverhez. Valahogyan ezt a kliens oldalon kell megoldanunk. Ideális esetben minimális bonyolult logikával kell ezt tennünk, hogy ne kelljen integrálni egy széles ügyfélsorozatra.
A válasz a DNS használata. Az esetünkben saját DNS-infrastruktúránk van, és beállíthatjuk azt a domain zónát, amelyhez a szervereink autoritatívak lesznek. Ez így működik:
- A kliens megkeresést küld a DNS-szerverhez a hoszt használatával, például api.netflix.com.
- A keresés a DNS-szerverünkre érkezik.
- A DNS-szerver tudja, hogy melyik út a leggyorsabb az adott kliens számára, és visszaadja a megfelelő IP-címet.
A megoldásban van egy plusz nehézség: az autoritatív DNS-szolgáltatók nem látják a kliens IP-címét, és csak a kliens által használt rekurzív resolver IP-címét látják.
Végül az autoritatív resolverünknek nem az egyes kliensnek kell döntenie, hanem a klienscsoportoknak a rekurzív resolver alapján.
A megoldáshoz ugyanazokat a próbákat használjuk, aggregálva a mérések eredményeit a kliensektől minden rekurzív resolverhez, és eldöntjük, hogy hova irányítjuk ezt a csoportot — proxy az IX-en TCP Anycast segítségével, ISP proxyn keresztül vagy közvetlenül a felhőbe.
Így kapunk egy rendszert:
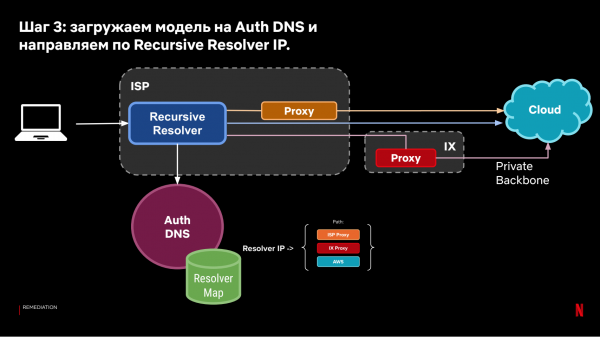
Az elkészült DNS steering modell lehetővé teszi a kliensek irányítását a felhőig terjedő kapcsolatok sebességi megfigyelései alapján.
Ismét felmerül a kérdés — mennyire hatékonyan fog működni ez a megközelítés? A válaszhoz ismét a próbák rendszerét használjuk. Így beállítjuk a konfigot, ahol az egyik cél a DNS steering irányába megy, a másik pedig közvetlenül a felhőbe (jelenlegi termelés).
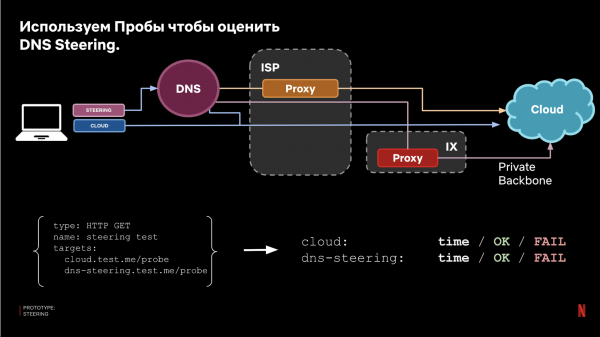
Végül a resultados összehasonlításával értékeljük a hatékonyságot:
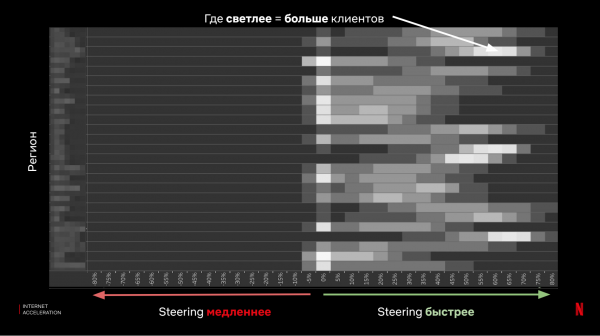
Összességében néhány fontos dolgot tanultunk:
- Értékeltük a várt teljesítményt a kliensek felhőhöz való kapcsolódásával DNS Steering használatával.
- Adatokat gyűjtöttünk valódi ügyfelektől, mindenféle eszközről.
- Bizonyítottuk a javasolt ötlet hatékonyságát.
- Nem kockáztattunk - nem változtattunk a production konfigurációkon az ügyfelek számára.
- Semmit sem romboltunk le.
Most következik a neheze — induljunk a termelésbe.
A legnehezebb mostantól mögöttünk van – van egy működő prototípusunk. A neheze most kezdődik – elindítani a megoldást a Netflix forgalmára, telepíteni 150 millió felhasználóra, ezer eszközre, száz mikroszolgáltatásra és folyamatosan változó termékekre és infrastruktúrára. A Netflix szervereire másodpercenként milliók érkeznek, és egy óvatlan lépéssel könnyen megbomolhat a szolgáltatás. Közben dinamikusan kívánjuk irányítani a forgalmat ezer CDN szerveren keresztül az interneten, ahol valami állandóan változik és romlik, legrosszabb pillanatokban is.
És mindezek mellett a csapatban – 3 mérnök felelős a rendszer fejlesztéséért, telepítéséért és teljeskörű támogatásáért.
Ezért most a nyugodt és egészséges alvásról fogunk beszélni.
Hogyan folytassuk a fejlesztést, anélkül, hogy az időnket folyamatosan támogatásra pazarolnánk? A megközelítésünk alapja 3 elv:
- Csökkentjük a potenciális hibák terjedését (blast radius).
- Készen állunk a meglepetésekre – számítunk arra, hogy valami elromlik, a tesztelés és a személyes tapasztalatok ellenére.
- Fokozatos degradáció (graceful degradation) – ha valami nem működik jól, akkor automatikusan meg kell javulnia, még ha nem is a leghatékonyabb módon.
Kiderült, hogy a mi esetünkben, e megközelítéssel egyszerű és hatékony megoldást találhatunk, amely jelentősen leegyszerűsíti a rendszer támogatását. Rájöttünk, hogy hozzáadhatunk egy kis kódot az ügyfélhez, amely figyeli a hálózati kérések hibáit, amelyeket a kapcsolat hibája okoz. Hálózati hiba esetén közvetlenül az felhőbe térünk vissza. Ez a megoldás nem igényel jelentős erőfeszítést az ügyféligényű csapatoktól, ugyanakkor nagymértékben csökkenti a váratlan hibák és meglepetések kockázatát számunkra.
Természetesen, a fallback ellenére is szigorú fegyelemhez ragaszkodunk a fejlesztés során:
- Próbateszt.
- A/B tesztelés vagy Canaries.
- Fokozatos kiadás (progressive rollout).
A próbák során a megközelítést leírtuk – a módosításokat először egy beállított recept segítségével teszteljük.
A canary teszteléshez összehasonlítható szerverpárokra van szükség, amelyeken összehasonlítható a rendszer működése a változtatások előtt és után. Ehhez számos CDN webhelyünkből párokat választunk ki, amelyek hasonló forgalmat kapnak:
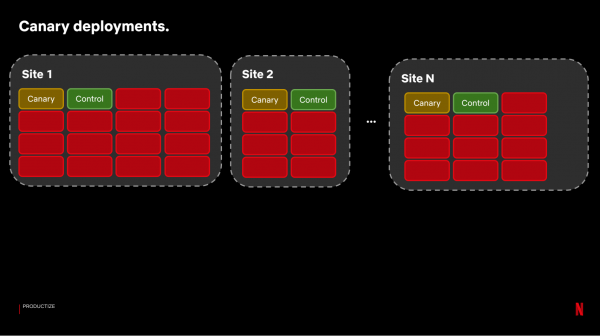
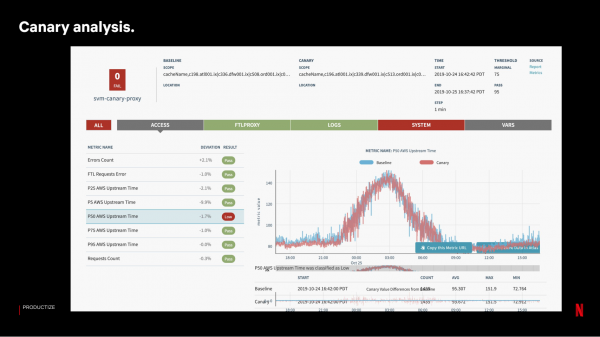
Ezután a módosításokkal ellátott buildet a Canary szerverekre telepítjük. Az eredmények értékelésére egy rendszert indítunk el, amely körülbelül 100-150 metrikát hasonlít össze a Control szerverek mintájával:
Ha a Canary-teszt sikeresen lezajlott, akkor fokozatosan, hullámokban végezzük el a kiadást. Minden weboldalon nem frissítjük a szervereket egyszerre — egy egész weboldal elvesztése a problémák esetén jelentősebb hatással van a szolgáltatásra a felhasználók számára, mint ugyanannyi szerver vesztése, de különböző helyeken.
Összességében ennek a megközelítésnek a hatékonysága és biztonsága a gyűjtött metrikák mennyiségétől és minőségétől függ. A kérésgyorsító rendszerünk számára minden lehetséges komponensből gyűjtünk metrikákat:
- az ügyfelektől — a munkamenetek és kérések száma, fallback arányok;
- proxy — a kérések számának és idejének statisztikája;
- DNS — a kérések száma és eredményei;
- cloud edge — a kérelmek feldolgozásának száma és ideje a felhőben.
Mindezt egy egységes pipeline-ba gyűjtjük, és a szükségleteknek megfelelően döntünk arról, hogy melyik metrikát küldjük a valós idejű elemzésre, és melyik kerül az Elasticsearch-ba vagy Big Data-ba a részletes diagnózis érdekében.
Monitorozás
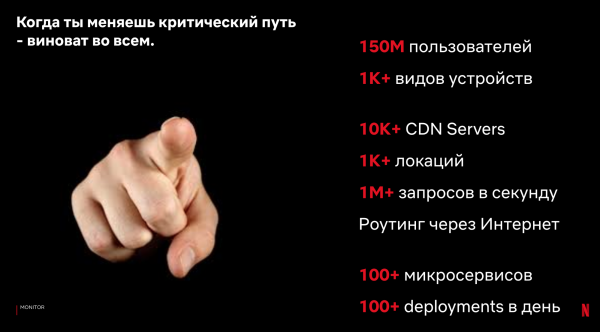
A mi esetünkben a kérések kritikus útvonalán végezzük a változtatásokat az ügyfél és a szerver között. Eközben az ügyfélen, szerveren és az interneten keresztül sokféle komponens van. Az ügyfél és a szerver közötti változások folyamatosan bekövetkeznek — sok csapat munkája és az ökoszisztéma természetes változásai következtében. Mi a középpontban állunk — a problémák diagnosztizálásakor nagy valószínűséggel részt veszünk ebben. Ezért pontosan meg kell értenünk, hogyan kell meghatározni, gyűjteni és elemezni a metrikákat a problémák gyors lokalizálása érdekében.
Ideális esetben — teljes hozzáférés mindenféle metrikához és szűrőkhöz valós időben. De nagyon sok metrika van, így felmerül a költségek kérdése. A mi esetünkben a metrikákat és a fejlesztési eszközöket a következőképpen különböztetjük meg:
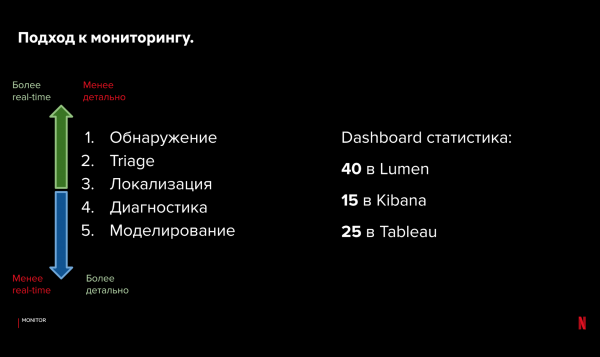
A problémák és a triage észlelése érdekében saját valós idejű, nyílt forráskódú rendszert használunk és — a vizualizáláshoz. Ez az aggregált metrikákat a memóriában tárolja, megbízható és integrálódik az értesítési rendszerrel. A lokalizálásra és diagnózisra hozzáférésünk van az Elasticsearch és Kibana logokhoz. A statisztikai elemzéshez és modellezéshez a big data-t és a Tableau vizualizálását használjuk.
A tűnik, hogy ezzel a megközelítéssel nagyon nehéz dolgozni. Azonban a metrikák és eszközök hierarchikus szervezésével gyorsan meg tudjuk elemezni a problémát, meghatározni a probléma típusát, majd részletes metrikákba mélyedni. A hiba forrásának felderítése általában 1-2 percet vesz igénybe. Ezt követően egy konkrét csapattal dolgozunk a diagnosztikán — ez akár több órát is igénybe vehet.
Még ha a diagnosztika gyorsan is elkészül, nem szeretnénk, ha ez gyakran előfordulna. Ideális esetben csak akkor kapunk kritikus értesítést, ha jelentős hatással van a szolgáltatásra. Az ügyfélkérések gyorsító rendszerünkben csupán 2 értesítést fogunk kapni, amelyek értesítenek:
- Client Fallback százalék — az ügyfelek viselkedésének értékelése;
- Probe errors százalék — a hálózati komponensek stabilitására vonatkozó adatok.
Ezek a kritikus értesítések figyelik, hogy a rendszer működik-e a többségi felhasználók számára. Megnézzük, hány ügyfél használta a fallback-et, ha nem tudtak igénybe venni gyorsítást. Átlagosan heti kevesebb mint 1 kritikus értesítésünk van, pedig a rendszerben hatalmas mennyiségű változás történik. Miért elegendő ez számunkra?
- Van client fallback, ha a proxy-nk nem működik.
- Van egy automatikus steering rendszer, amely reagál a problémákra.
Részletesebben az utolsó pontról. Próba rendszerünk és az ügyfelektől a felhőbe irányuló kérések optimális útvonalának automatikus meghatározására szolgáló rendszer lehetővé teszi, hogy automatikusan kezeljük a problémák egy részét.
Visszatérve a próba konfigurációnkra és a 3 kategóriás útvonalra. A betöltési idő mellett figyelhetjük magának a kéDelivery-t is. Ha nem sikerül adatokat betölteni, akkor a különböző útvonalak eredményeit nézve meg tudjuk határozni, hol és mi romlott el, és képesek vagyunk-e automatikusan kijavítani azt, megváltoztatva a kérés útvonalát.
Példák:
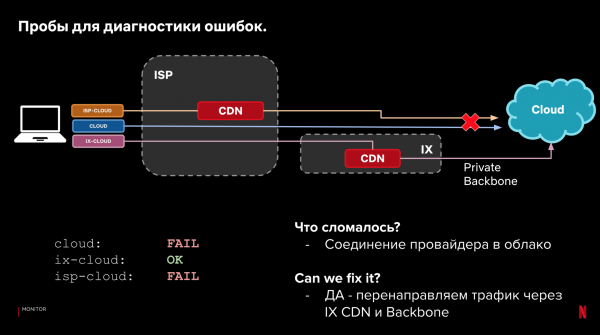
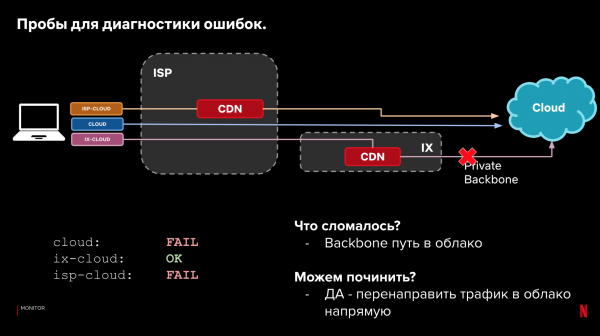
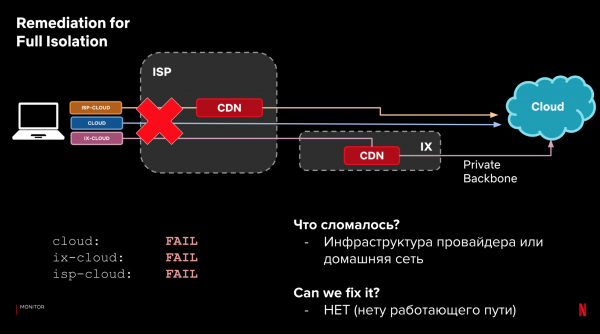
Ez a folyamat automatizálható. Be lehet építeni a steering rendszerbe. És meg lehet tanítani, hogy reagáljon a teljesítmény és megbízhatóság problémáira. Ha valami kezd elromlani — reagáljon, ha van jobb opció. Közben a pillanatnyi reakció nem kritikus, köszönhetően a fallback-nek az ügyfeleknél.
Így a rendszer támogatásának elveit a következőképpen lehet összefoglalni:
- csökkentjük a meghibásodások mértékét;
- mérjük a metrikákat;
- automatikusan kijavítjuk a hibákat, ha tudjuk;
- ha nem, értesítjük.
- Dolgozunk a dashboardokon és a triage eszközökön a gyors reagálás érdekében.
Tanulmányozott leckék.
A prototípus elkészítéséhez nem szükséges sok idő. A mi esetünkben négy hónap alatt elkészült. Ezzel új metrikákat kaptunk, és tíz hónappal a fejlesztés megkezdése után megszereztük az első produkciós forgalmat. Ezután kezdődött a monoton és nagyon bonyolult munka: fokozatosan termékesíteni és skálázni a rendszert, migrálni a fő forgalmat, és tanulni a hibákból. Ez a hatékony folyamat nem lesz lineáris – a nagy erőfeszítések ellenére sem lehet mindent előre látni. Sokkal hatékonyabb a gyors iteráció és a új adatokra való reagálás.
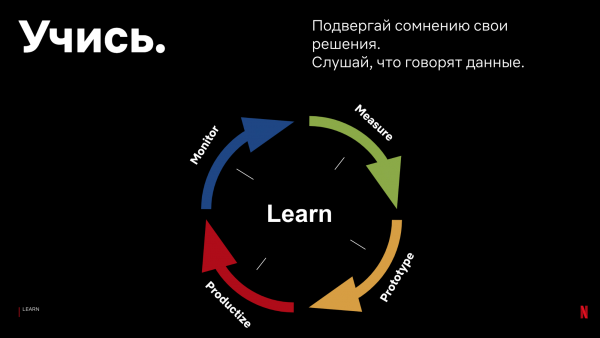
Tapasztalataink alapján a következőket javasoljuk:
- Ne bízz a megérzéseidben.
A megérzéseink folyamatosan cserben hagytak minket, annak ellenére, hogy a csapat tagjainak óriási tapasztalata volt. Például hibásan becsültük meg a CDN proxy használatából várható teljesítménynövekedést, vagy a TCP Anycast viselkedését.
- Szerezz be adatokat a produkcióból.
Fontos, hogy minél hamarabb hozzáférj egy kis mennyiségű produkciós adathoz. A laboratóriumi körülmények között szinte lehetetlen megszerezni az egyedi esetek, konfigurációk és beállítások számát. A gyors hozzáférés az eredményekhez lehetővé teszi, hogy gyorsabban értesülj a potenciális problémákról, és figyelembe tudd venni őket a rendszer architektúrájában.
- Ne kövesd mások tanácsait és eredményeit — gyűjtsd össze a saját adataidat.
Kövesd az adatok gyűjtésének és elemzésének elveit, de ne fogadd el vakon mások eredményeit és állításait. Csak te tudod pontosan, hogy mi működik a felhasználóid számára. A te rendszereid és ügyfeleid jelentősen eltérhetnek más cégektől. Szerencsére a mai világban az elemző eszközök könnyen hozzáférhetők és használhatók. Az általad kapott eredmények lehet, hogy nem egyeznek meg azzal, amit a Netflix, Facebook, Akamai és más cégek állítanak. Az esetünkben a TLS, HTTP2 teljesítménye vagy a DNS lekérdezések statisztikái eltérnek a Facebook, Uber, Akamai eredményeitől — mert nekünk más eszközeink, ügyfeleink és adatfolyamaink vannak.
- Ne törekedj divatos trendek keresésére szükségtelenül és hatékonyságértékelés nélkül.
Kezdj egyszerűen. Jobb egy egyszerű, működő rendszert gyorsan létrehozni, mint óriási időt pazarolni haszontalan komponensek fejlesztésére. Oldd meg azokat a feladatokat és problémákat, amelyek fontosak a méréseid és eredményeid alapján.
- Legyen felkészülve az új alkalmazásokra.
Ahogy nehéz előre megjósolni az összes problémát, úgy a jövőbeni előnyöket és alkalmazásokat is nehéz megbecsülni. Vegyen példát a startupokról – azok alkalmazkodó képessége az ügyfelek igényeihez. Az ön esetében felfedezheti az új problémákat és megoldásaikat. A projektünk célja az volt, hogy csökkentsük a kérések késlekedését. Azonban az elemzések és megbeszélések során rájöttünk, hogy a proxy szervereket is alkalmazhatjuk:
- a forgalom egyensúlyozására az AWS régiók között, és a költségek csökkentésére;
- a CDN stabilitásának modellezésére;
- a DNS konfigurálására;
- a TLS/TCP konfigurálására.
Zárás
A beszámolómban leírtam, hogyan oldja meg a Netflix a gyorsabb internetes kérések problémáját a kliensek és a felhő között. Hogyan gyűjtünk adatokat az ügyfélváltozó rendszeren keresztül, és hogyan használjuk fel az összegyűjtött történeti adatokat, hogy a produkciós kéréseket a leggyorsabb internetes úton irányítsuk. Hogyan használjuk a hálózati protokollok működési elveit, a CDN infrastruktúránkat, a backbone hálózatunkat és a DNS szervereket ennek a célnak az elérésére.
Azonban a mi megoldásunk csupán példa arra, hogyan valósítottuk meg ezt a rendszert a Netflixnél. Ami működött számunkra. A beszámolóm gyakorlati része számotokra a fejlesztési és fenntartási elvek, amelyeket követünk, hogy jó eredményeket érjünk el.
A mi problémamegoldásunk talán nem működik az ön számára. Azonban az elmélet és a fejlesztési elvek érvényben maradnak, még akkor is, ha nincs saját CDN infrastruktúrája, vagy ha jelentősen eltér a miénktől.
Továbbra is fontos a kérések sebessége az üzlet szempontjából. Még a legegyszerűbb szolgáltatás esetén is választani kell: a „felhő” szolgáltatók, a szerverek elhelyezkedése, a CDN és a DNS szolgáltatók között. Az ön választása befolyásolni fogja az internetes kérések hatékonyságát az ügyfelei számára. Fontos, hogy ezt a hatást mérje és megértse.
Kezdje egyszerű megoldásokkal, figyeljen arra, hogyan változtatja meg a terméket. Tanuljon a folyamat során, és finomítsa a rendszert az ügyfeleitől, az infrastruktúrájától és az üzletétől származó adatok alapján. Gondoljon az előre nem látható hibák lehetőségére a tervezés során. Így felgyorsíthatja a fejlesztési folyamatát, javíthatja a megoldás hatékonyságát, elkerülheti a túlzott támogatási terhet, és nyugodtan alhat.
Idén online formátumban. Kérdéseket lehet feltenni a DevOps atyáinak egyikének, magának John Willisonak!
Forrás: habr.com
