

2018-ban a szakmai körökben és az AI-nek szentelt konferenciákon megjelent az MLOps fogalma, amely gyorsan elterjedt az iparágban, és most önálló irányként fejlődik. A jövőben az MLOps az IT egyik legkeresettebb területévé válhat. Mi is ez valójában, és hogyan használják, azt most megtudjuk.
Mi az MLOps
Az MLOps (a gépi tanulási technológiák és folyamatok, valamint a kidolgozott modellek üzleti folyamatokba való integrálásának megközelítése) egy új együttműködési módszer az üzleti képviselők, tudósok, matematikai szakértők, gépi tanulás szakértők és IT mérnökök között az mesterséges intelligencia rendszerek létrehozásakor.
Más szavakkal, ez a gépi tanulási módszerek és technológiák hasznos eszközzé alakításának módja az üzleti problémák megoldására.
Fontos megérteni, hogy a termelékenység láncolata jóval a modell fejlesztése előtt kezdődik. Az első lépés az üzleti feladat meghatározása, az adatokból kinyerhető érték hipotézisei és az ezek alkalmazására vonatkozó üzleti ötletek kidolgozása.
Az MLOps fogalma a DevOps fogalmának analógiájaként született meg a gépi tanulás modelleire és technológiáira vonatkozóan. A DevOps egy szoftverfejlesztési megközelítés, amely lehetővé teszi a változtatások gyorsabb bevezetését, miközben megőrzi a rugalmasságot és megbízhatóságot, többek között folyamatos fejlesztés, szétválasztott funkciók független mikroszolgáltatásokra, automatizált tesztelés és a változtatások bevezetése, globális teljesítmény figyelés és a felmerülő hibákra való gyors reagálás rendszerének alkalmazásával.
A DevOps meghatározta a szoftver életciklusát, és a szakértői közösségben felmerült az ötlet, hogy ugyanazt a módszert alkalmazzák a nagyméretű adatokra. A DataOps arra tett kísérletet, hogy a nagyméretű adatanyagok tárolásának, továbbításának és feldolgozásának sajátosságainak figyelembevételével alkalmazza és bővítse a módszert.
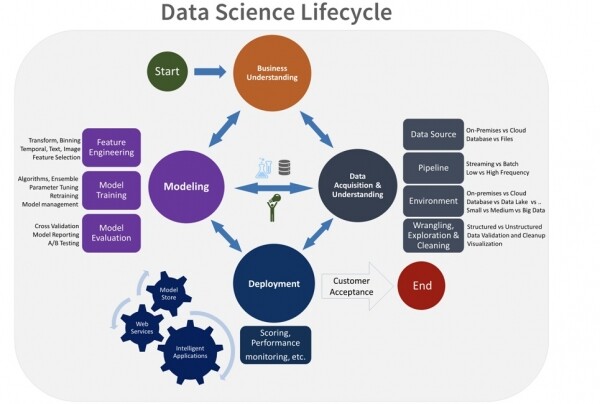
A gépi tanulás modelljeinek üzleti folyamatokba történő integrációjának bizonyos kritikus tömegével erőteljes hasonlóság figyelhető meg a gépi tanulás matematikai modelljeinek életciklusa és a szoftver életciklusa között. A különbség csak annyi, hogy a modellek algoritmusait gépi tanulási eszközök és módszerek segítségével hozák létre. Ezért természetes módon merült fel az ötlet, hogy a szoftverfejlesztés során már ismert megközelítéseket alkalmazzák és adaptálják a gépi tanulás modelljeire. Így a gépi tanulás modelljeinek életciklusában a következő kulcsfontosságú lépéseket lehet kiemelni:
- üzleti ötlet meghatározása;
- modell betanítása;
- a modell tesztelése és bevezetése az üzleti folyamatba;
- a modell üzemeltetése.
Amikor az üzemeltetés során szükségessé válik a modell új adatokkal történő módosítása vagy további tanítása, a ciklus újraindul — a modellt továbbfejlesztik, tesztelik, és egy új verziót telepítenek.
Kitérő. Miért továbbtanulás és nem újratanulás? A „modell újratanulása” kifejezés kettős értelmezésű: a szakértők között a modellek hibaként értelmezésére utal, amikor a modell jól jósol, gyakorlatilag megismétli a becsült paramétert a tanulási mintán, de sokkal rosszabbul teljesít a külső adatok mintáján. Természetesen egy ilyen modell selejt, mivel ez a hiba megakadályozza annak alkalmazását.
Ebben az életciklusban logikusnak tűnik DevOps-eszközök használata: automatizált tesztelés, telepítés és monitorozás, a modellek számításainak elkészítése külön mikroszolgáltatás formájában. De számos sajátosság is létezik, amelyek megakadályozzák e eszközök közvetlen alkalmazását további ML-körítések nélkül.
Hogyan lehet rávenni a modelleket, hogy működjenek és nyereséget hozzanak.
Példaként, amelyen bemutatjuk az MLOps megközelítés alkalmazását, vegyünk egy klasszikussá vált feladatot, amely a banki (vagy bármely más) termék támogatási csevegésének automatizálására vonatkozik. A támogatási csevegés üzleti folyamata általában a következőképpen zajlik: az ügyfél beír egy üzenetet a csevegésbe a kérdésével, és választ kap a szakembertől egy előre meghatározott párbeszédfa keretein belül. Az ilyen csevegések automatizálásának feladata általában szakértők által meghatározott szabályrendszerek segítségével oldható meg, amelyek kidolgozása és fenntartása rendkívül időigényes. Az ilyen automatizálás hatékonysága a feladat bonyolultságának függvényében 20–30% lehet. Természetesen felmerül az az ötlet, hogy jövedelmezőbb lenne egy mesterséges intelligencia modult bevezetni – egy olyan modellt, amelyet gépi tanulás segítségével fejlesztettek ki, amely:
- képes az operátor közreműködése nélkül nagyobb számú kérdést kezelni (a témától függően, bizonyos esetekben a hatékonyság elérheti a 70–80%-ot);
- jobban alkalmazkodik a párbeszédben előforduló nem szabványos megfogalmazásokhoz – képes azonosítani az intentet, a felhasználó valós vágyát a nem pontosan megfogalmazott kérés alapján;
- képes meghatározni, mikor a modell válasza adekvát, és mikor merülnek fel kétségek a válasz "tudatosságával" kapcsolatban, aminek következtében további pontosító kérdést kell feltenni vagy az operátorra kell átirányítani;
- automatikusan továbbképzhető (a válaszkészletek folyamatosan történő alkalmazásához és módosításához szükséges fejlesztőcsapat helyett a továbbképzést a Data Science szakértő végzi, a megfelelő gépi tanulási könyvtárakat alkalmazva).
Hogyan működhet egy ilyen fejlett modell?
Ahogy bármely más feladat megoldásakor, mielőtt egy ilyen modult fejlesztenénk, definiálnunk kell az üzleti folyamatot, és formálisan le kell írnunk a konkrét feladatot, amelyet a gépi tanulás módszerével fogunk megoldani. Ezen a ponton kezdődik az operatacionalizációs folyamat, amelyet az Ops mozaikszó jelöl.
A következő lépésben a Data Science szakember együttműködve az adatmérnökkel ellenőrzi az adatok meglétét és elegendőségét, valamint a vállalkozás hipotézisét a business ötlet működőképességéről. Ez magába foglalja a modell prototípusának kidolgozását és annak tényleges hatékonyságának ellenőrzését. Csak a vállalkozás megerősítése után kezdődhet a modell fejlesztésének integrálása a speciális üzleti folyamatokat végző rendszerekbe. Az integrációs terv folyamatos megfontolása, valamint a mélyreható megértés az egyes lépések során, hogy a modellt hogyan fogják használni és milyen gazdasági hatással lesz, alapvető szempont a MLOps megközelítések vállalati technológiai tájba való bevezetésében.
A mesterséges intelligencia technológiáinak fejlődésével lavinaszerűen nő a gépi tanulás által megoldható feladatok száma és sokfélesége. Minden ilyen üzleti folyamat a vállalat számára munkavállalók tömeges pozícióinak (call center, dokumentumok ellenőrzése és válogatása stb.) automatizálásával járul hozzá a költségek megtakarításához, új vonzó és kényelmes funkciók hozzáadásával bővíti az ügyfélkört, optimalizálja a források felhasználását, és még sok más. Végső soron minden folyamat az értékteremtésre összpontosít, és ennek következményeként gazdasági hatást kell gyakorolnia. Itt rendkívül fontos egyértelműen megfogalmazni az üzleti ötletet és kiszámítani a modell bevezetéséből várható jövedelmet a vállalat értékteremtés összképében. Előfordulnak olyan helyzetek, amikor a modell bevezetése nem térül meg, és a gépi tanulással foglalkozó szakemberek által eltöltött idő sokkal drágább, mint az operátor munkakörének fenntartása, aki ezt a feladatot elvégzi. Ezért ezeket az eseteket már a mesterséges intelligencia rendszerek létrehozásának korai szakaszaiban érdemes azonosítani.
Ezért a modell nyeresége csak akkor kezdődik, amikor a MLOps folyamat során helyesen megfogalmazták az üzleti célt, prioritásokat állapítottak meg, és a fejlesztés korai szakaszában meghatározták a modell rendszerbe való integrálásának folyamatát.
Új folyamat – új kihívások
Kimerítő válasz a vállalkozások alapvető kérdésére arról, hogy mennyire alkalmazhatók a gépi tanulási modellek a feladatok megoldására, a mesterséges intelligenciába vetett bizalom általános kérdése – ez az MLOps megközelítések fejlesztése és bevezetése során az egyik legfontosabb kihívás. Eleinte a vállalkozások szkeptikusak a gépi tanulás folyamatokba történő bevezetésével kapcsolatban – nehéz megbízni azokban a modellekben, ahol korábban általában emberek dolgoztak. A vállalkozások számára a programok „fekete dobozként” tűnnek fel, amelyek válaszainak relevanciáját még bizonyítani kell. Ezen kívül a pénzügyi szektorban, a távközlési szolgáltatók üzletágában és más területeken szigorú állami szabályozói követelmények vannak. Minden rendszert és algoritmust auditálnak, amelyek be vannak vezetve a banki folyamatokba. Ennek a feladatnak a megoldásához, hogy a vállalkozásoknak és a szabályozóknak bizonyítani tudjuk a mesterséges intelligencia válaszainak megalapozottságát és helyességét, a modellek mellett monitorozási eszközöket is bevezetnek. Ezen kívül létezik egy független validálási eljárás, amely kötelező a szabályozói modellek számára, és megfelel a jegybank követelményeinek. Egy független szakértői csoport auditálja a modellek által kapott, a bemeneti adatok figyelembevételével nyert eredményeket.
A második kihívás a modellek kockázatainak értékelése és figyelembe vétele a gépi tanulási modell bevezetése során. Ha még egy ember sem képes százszázalékos bizonyossággal megválaszolni a kérdést, hogy az a ruha fehér vagy kék volt, akkor a mesterséges intelligenciának is joga van a hibázásra. Figyelembe kell venni azt is, hogy az adatok idővel változhatnak, és a modelleknek szükségük van további tanulmányokra, hogy kellően pontos eredményeket adjanak. Ahhoz, hogy a vállalkozási folyamat ne szenvedjen, kezelni kell a modellek kockázatait és nyomon kell követni a modell működését, rendszeresen új adatokkal kell a tanulását frissíteni.
De az első szakaszú bizalmatlanság után elkezd megjelenni a fordított hatás. Minél több modellt sikeresen vezetnek be a folyamatokba, annál inkább nő a vállalkozás igénye a mesterséges intelligencia használatára – egyre újabb és újabb feladatokat találnak, amelyeket gépi tanulási módszerekkel lehet megoldani. Minden feladat egy egész folyamatot indít el, amely bizonyos kompetenciákat igényel:
- adatkutatók készítik elő és dolgozzák fel az adatokat;
- adat-tudósok alkalmazzák a gépi tanulás eszközeit és fejlesztik a modellt;
- Az IT beépíti a modellt a rendszerbe;
- Az ML mérnök meghatározza, hogyan lehet a modellt helyesen beépíteni a folyamatba, milyen IT eszközöket kell használni a modell alkalmazási módjának követelményei, a bekérések áramlása, a válaszidő stb. figyelembevételével.
- Az ML építész megtervezi, hogyan lehet fizikailag megvalósítani a szoftverterméket ipari rendszerben.
Az egész ciklus nagy számú magasan képzett szakembert igényel. A ML modellek üzleti folyamatokba való beépítése során elérhető fejlődési és penetrációs pontnál kiderül, hogy a szakemberek számának lineáris növelése a feladatok számának növekedésével arányosan költséges és hatástalan. Ezért felmerül az MLOps folyamat automatizálásának szükségessége - néhány standard gépi tanulási feladat osztályának meghatározása, tipikus adatfeldolgozási és modellek továbbképzési folyamatok fejlesztése. Az ideális képen ezen feladatok megoldásához olyan szakemberekre van szükség, akik egyaránt jól ismerik a Big Data, Data Science, DevOps és IT határterületeit. Ezért a Data Science iparág legnagyobb problémája és az MLOps folyamatok megszervezésének legnagyobb kihívása - az ilyen szintű kompetenciák hiánya a rendelkezésre álló munkaerőpiacon. Az ilyen követelményeknek megfelelő szakemberek jelenleg egyediek a munkaerőpiacon és arany értékűek.
A kompetenciák kérdéséhez
Elméletileg minden MLOps feladatot klasszikus DevOps eszközökkel is meg lehet oldani, anélkül hogy speciális szerepmódosításhoz folyamodnánk. Ahogy már említettük, az adat tudósnak nemcsak matematikusnak és adat-analitikának kell lennie, hanem az egész folyamat guruja is - az ő feladata az architektúra kidolgozása, a modellek programozása több nyelven az architektúrától függően, az adat vitrinek előkészítése és a saját alkalmazás telepítése. Azonban a technológiai keret létrehozása, amely a MLOps átfogó folyamatában valósul meg, a munkaerőköltség 80%-át emészti fel, ami azt jelenti, hogy a kiváló adat tudós, aki megfelelő matematikai ismeretekkel rendelkezik, csak az idejének 20%-át szenteli a szakterületének. Ezért a gépi tanulási modellek bevezetését végző szakemberek szerepeinek tisztázása életbevágóan szükséges.
A szerepek részletes elkülönítése a vállalat méretétől függ. Egy dolog, amikor egy startupban egy szakember dolgozik, aki minden feladatot ellát, legyen az mérnök, építész vagy DevOps. Teljesen más, amikor egy nagyvállalatnál a modellek fejlesztési folyamatai néhány magasan képzett Data Science szakemberre koncentrálódnak, míg a programozó vagy adatbázis-kezelő szakember, aki a munkaerőpiacon elterjedtebb és olcsóbb kompetencia, átvállalhatja a rutinfeladatok jelentős részét.
Így attól függ, hogy hol húzódik a határ a szakemberek kiválasztásában az MLOps folyamatának támogatásához, valamint hogyan van megszervezve a fejlesztett modellek operacionális folyamata, közvetlenül függ a fejlesztett modellek gyorsaságától és minőségétől, a csapat teljesítményétől és a munkakörnyezetétől.
Ami már most is elkészült a csapatunk által
Nem olyan régen kezdtük el az MLOps kompetenciák és folyamatok struktúráját felépíteni. De már most a modellek életciklusának kezelésére és a modellek szolgáltatásként való alkalmazására vonatkozó projektjeink MVP tesztelési szakaszában vannak.
Emellett meghatároztuk a nagyvállalat számára optimális kompetenciaszerkezetet és az összes résztvevő közötti együttműködési struktúrát. Agilis csapatokat szerveztünk, amelyek a teljes üzleti megrendelői spektrum feladatain dolgoznak, és megszerveztük a kapcsolatot a platformok és infrastruktúrák projektcsapataival, amelyek az MLOps építkezésének alapját képezik.
Jövőbeli kérdések
Az MLOps egy fejlődő terület, amely a kompetenciaszűkösség miatt a jövőben nagyobb lendületet kap. Jelenleg a legjobban a DevOps tapasztalataiból és gyakorlataiból érdemes kiindulni. Az MLOps fő célja a ML modellek hatékonyabb felhasználása az üzleti feladatok megoldásában. Ám közben sok kérdés merül fel:
- Hogyan lehet csökkenteni a modellek üzembe helyezéséhez szükséges időt?
- Hogyan csökkenthetők a bürokratikus akadályok a különböző kompetenciájú csapatok között, és hogyan növelhető a együttműködésre való fókuszálás?
- Hogyan lehet nyomon követni a modelleket, kezelni a verziókat és hatékony monitorozást szervezni?
- Hogyan lehet valóban ciklikus életciklust létrehozni a modern ML modellek számára?
- Hogyan lehet standardizálni a gépi tanulási folyamatot?
A kérdésekre adott válaszok nagymértékben meghatározzák, hogy az MLOps mennyire gyorsan bontakoztatja ki a potenciálját.
Forrás: habr.com
