

Helló mindenkinek! CV-fejlesztő vagyok a KROK-nál. Már három éve valósítunk meg projekteket a CV területén. Ez idő alatt rengeteget csináltunk, például: figyelemmel kísértük a vezetőket, hogy közlekedés közben ne igyanak, ne dohányozzanak, ne telefonáljanak, hanem az útra nézzenek, ne az álmokra vagy a felhőkre; rögzítettük azokat, akik a kijelölt sávokon közlekedtek és több parkolóhelyet foglaltak el; ügyeltünk arra, hogy a munkavállalók viseljenek sisakot, kesztyűt stb.; azonosítottuk az alkalmazottat, aki be szeretett volna lépni az objektumra; megszámláltuk mindent, amit csak lehetett.
Mire akarom kilyukadni?
A projektek megvalósítása során sok tapasztalatot szereztünk, sok pofont kaptunk, néhány problémával vagy ismerkednek, vagy a jövőben meg fognak ismerkedni.
Modellezünk egy helyzetet
Képzeljük el, hogy egy fiatal 'N' nevű céghez csatlakoztunk, amelynek tevékenysége az ML-hez kapcsolódik. Egy ML (DL, CV) projekten dolgozunk, majd valamilyen oknál fogva áttérünk egy másik munkára, tehát szüneteltetjük, és visszatérünk a saját vagy egy másik neurohálóhoz.
- Elérkezik az igazság pillanata, valahogy vissza kell emlékeznünk, hol is hagytuk abba, milyen hiperparamétereket próbáltunk ki, és ami a legfontosabb, hogy ezek milyen eredményekre vezettek. Számos variáció létezhet arról, hogy ki hogyan tárolta az információkat az összes futásról: fejben, konfigurációs fájlokban, jegyzetfüzetben, a felhőben a munkakörnyezetben. Én láttam olyan lehetőséget is, amikor a hiperparamétereket kommentelt sorok formájában tárolták a kódban, valóban a fantázia repült. Most képzeljük el, hogy nem a saját projektünkhöz tértünk vissza, hanem egy olyan ember projektjéhez, aki elhagyta a céget, és örökségként megkaptuk a kódot és a modelt, amelynek neve model_1.pb. A teljes kép és a teljes fájdalom érdekében képzeljük el, hogy kezdő szakember vagyunk.
- Menjünk tovább. A kód futtatásához nekünk és mindenkinek, aki dolgozni fog vele, létre kell hoznunk egy környezetet. Gyakran előfordul, hogy ezt sem hagyták ránk valamilyen ok miatt. Ez is lehet egy szokatlan feladat. Erre a lépésre nem akarunk időt pazarolni, nem igaz?
- Modellek betanítása (például autót érzékelő). Elérkezünk ahhoz a ponthoz, amikor már egészen jónak tűnik — itt az ideje a mentésnek. Hívjuk ezt car_detection_v1.pb-nek. Aztán betanítunk egy másikat — car_detection_v2.pb. Néhány idő elteltével kollégáink vagy mi magunk tovább tanítunk még és még, különböző architektúrákat használva. Végül egy halom artefaktum jön létre, amelyekről alaposan összegyűjtjük az információkat (de ezt majd később csináljuk, hiszen most van fontosabb dolgunk).
- Nos, ez is megvan! Van egy modelünk! Térhetünk a következő modell betanításához, vagy dolgozhatunk egy új feladatra vonatkozó architektúra kidolgozásán, vagy elmehetünk teázni? De ki lesz a telepítő?
Problémák azonosítása
A projekten vagy terméken való munka sok ember munkája. Idővel az emberek eljönnek és jönnek, a projektek száma nő, a projektek pedig egyre bonyolultabbá válnak. Így vagy úgy, a fentebb leírt ciklus (és nem csak) különféle kombinációkban elő fog fordulni iterációról iterációra. Mindez időpocsékoláshoz, zűrzavarhoz, idegességhez, esetleg ügyfél elégedetlenséghez, és végső soron — pénzhiányhoz vezethet. Bár általában a régi tárgyainkon lépkedünk, senki sem szeretné újra és újra átélni ezeket a pillanatokat.
Tehát, végigmentünk egy fejlesztési cikluson, és látjuk, hogy vannak problémák, amelyeket meg kell oldani. Ehhez szükséges:
- kényelmesen tárolni a munkák eredményeit;
- egyszerűsíteni az új munkatársak bevonásának folyamatát;
- megkönnyíteni a fejlesztési környezet telepítési folyamatát;
- beállítani a modellek verziókezelési folyamatát;
- kényelmes módot találni a modellek érvényesítésére;
- megtalálni a modellek állapotának kezelésére alkalmas eszközt;
- megtalálni a modellek production környezetbe való betöltésének módját.
Nyilvánvalóan szükség van egy munkafolyamatra, amely lehetővé teszi ennek az életciklusnak a könnyű és kényelmes kezelését? Ennek a gyakorlatnak van neve: MLOps.
Az MLOps, vagyis a gépi tanuláshoz kapcsolódó DevOps lehetővé teszi az adatok feldolgozásáért és elemzéséért felelős szakemberek és az IT-specialisták együttműködését, valamint felgyorsítja a modellek fejlesztését és telepítését monitorozás, ellenőrzés és kezelés segítségével a gépi tanulás modellekhez.
Megteheti , mit gondolnak erről a Google munkatársai. A cikkből világossá válik, hogy az MLOps egy meglehetősen terjedelmes dolog.
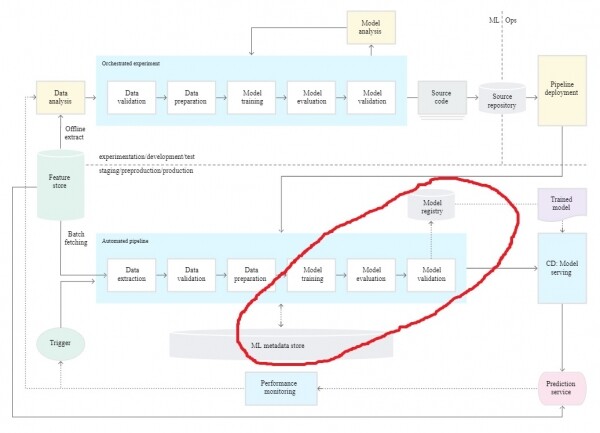
A cikkemben csak a folyamat egy részét írom le. A megvalósításhoz az MLflow eszközt fogom használni, mivel ez egy nyílt forráskódú projekt, és a csatlakozáshoz csak néhány sor kódra van szükség, emellett népszerű gépi tanulási keretrendszerekkel is integrálható. Az interneten kereshet más eszközöket is, például Kubeflow-t, SageMaker-t, Trains-t stb., és esetleg megtalálhatja azt, amely jobban megfelel az igényeinek.
"MLOps-t építünk" az MLFlow eszköz használatával
Az MLFlow egy nyílt forráskódú platform a gépi tanulási modellek életciklusának kezelésére ().
Az MLflow négy összetevőből áll:
- MLflow Tracking – a kapott eredmények és azok paramétereinek rögzítésével foglalkozik, amelyek ezekhez az eredményekhez vezettek;
- MLflow Project – lehetővé teszi a kód becsomagolását és reprodukálását bármely platformon;
- MLflow Models – a modellek telepítéséért felelős a termelésbe;
- MLflow Registry – lehetővé teszi a modellek tárolását és állapotuk központi tárolásából történő kezelését.
Az MLflow két entitással dolgozik:
- a futtatás – teljes tanulási ciklus, paraméterek és metrikák, amelyeket rögzíteni szeretnénk;
- kísérlet – ez a "téma", amely összeköti a futtatásokat.
A példa minden lépése az Ubuntu 18.04 operációs rendszeren valósult meg.
1. Szerver telepítése
Ahhoz, hogy könnyen kezelhessük a projektünket és megkapjuk az összes szükséges információt, telepítünk egy szervert. Az MLflow tracking szervernek két fő összetevője van:
- backend store – az regisztrált modellek információinak tárolásáért felelős (támogat 4 adatbázist: mysql, mssql, sqlite és postgresql);
- artifact store – az artefaktumok tárolásáért felelős (támogat 7 tárolási lehetőséget: Amazon S3, Azure Blob Storage, Google Cloud Storage, FTP szerver, SFTP szerver, NFS, HDFS).
Mint artifact store a egyszerűség kedvéért vegyünk egy sftp szervert.
- csoport létrehozása
$ sudo groupadd sftpg - felhasználó hozzáadása és jelszó beállítása
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - néhány hozzáférési beállítás módosítása
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - néhány sort hozzáadunk a /etc/ssh/sshd_config fájlhoz
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - a szolgáltatás újraindítása
$ sudo systemctl restart sshd
Mint backend store vegyünk egy postgresql-t.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Új felhasználó létrehozása: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Addja meg a hozzáadni kívánt szerep nevét: mlflow_user
Adja meg az új szerep jelszavát: mlflow
Írja be újra: mlflow
Legyen az új szerep szuperfelhasználó? (y/n) n
Hozzáférhet az új szerep az adatbázisok létrehozásához? (y/n) n
Hozzáférhet az új szerep további új szerepek létrehozásához? (y/n) n
# Létrehozás mlflow_bd adatbázis mlflow_user tulajdonában
$ createdb -O mlflow_user mlflow_db
A szerver indításához telepíteni kell a következő python csomagokat (ajánlom, hogy hozzon létre egy külön virtuális környezetet):
pip install mlflow
pip install pysftp
Indítjuk a szerverünket
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Nyomkövetés hozzáadása
Annak érdekében, hogy a tréningjeink eredményei ne vesszenek el, a jövőbeli fejlesztők megértsék, hogy mi történt, és a tapasztalt kollégák és Ön nyugodtan elemezni tudja a tanulási folyamatot, szükség van a nyomkövetés hozzáadására. A nyomkövetés alatt értjük a paraméterek, metrikák, artefaktumok és bármilyen további információ megtartását a tréning futtatásáról, jelen esetben a szerveren.
Például létrehoztam egy kis a Keras keretrendszerben, amely mindent szegmentál, ami a . A nyomkövetés hozzáadásához létrehoztam egy fájlt mlflow_training.py.
Íme a sorok, ahol a legérdekesebb dolgok történnek:
def run(self, epochs, lr, experiment_name):
        # Kérjük, szerezze be a kísérlet azonosítóját, hozzon létre egy kísérletet, ha az hiányzik
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # "futás" létrehozása és az azonosító megszerzése
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # jelezzük, hogy az eredményeket távoli szerveren szeretnénk menteni
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Itt a self.remote_server egy kis burkolat a mlflow.tracking.MlflowClient módszereihez (én készítettem a kényelem érdekében), amellyel kísérletet és futtatást hozok létre a szerveren. Ezután megadom, hová kell összefoglalni a futás eredményeit (mlflow.set_tracking_uri(self.tracking_uri)). Aktiválom az automatikus naplózást mlflow.keras.autolog(). Jelenleg az MLflow Tracking támogatja az automatikus naplózást a TensorFlow, Keras, Gluon, XGBoost, LightGBM és Spark számára. Ha nem találja a keretrendszerét vagy könyvtárát, akkor mindig lehetősége van a nyilvános naplózásra. Indítjuk a tanulást. Bejegyezzük a címkéket és a belépési paramétereket a távoli szerveren.
Pár sor, és Ön, mint minden érdeklődő, hozzáférést kap az összes futás információjához. Menő, nem?
3. A projekt létrehozása
Most tegyük ezt úgy, hogy a projekt indítása gyerekjáték legyen. Ehhez adjunk hozzá egy MLproject fájlt és egy conda.yaml-t a projekt gyökeréhez.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'a coco adathalmazon található kategóriák listája'}
        epochs: {type: int, help: 'a tanulási epochok száma'}

        lr: {type: float, default: 0.001, help: 'tanulási ráta'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'például resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'a szerver címe'}
        experiment_name: {type: str, default: 'My_experiment', help: 'távoli és helyi kísérlet neve'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
Az MLflow Projektnek számos tulajdonsága van:
- Name — a projekt neve;
- Environment — az én esetemben a conda_env arra utal, hogy az Anacondát használják a futtatáshoz, és a függőségek leírása a conda.yaml fájlban található;
- Entry Points — megmutatja, hogy mely fájlokat és milyen paraméterekkel futtathatunk (minden paraméter automatikusan naplózásra kerül a tanulás során)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Futtatási környezetként használhat Docker-t, a részletes információkért kérjük, forduljon a .
4. Indítjuk a tanulást
Klónozza a projektet és lépjen a projekt könyvtárába:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
A futtatáshoz telepítenie kell a könyvtárakat.
pip install mlflow
pip install pysftp
Mivel a példában a conda_env-ot használom, az Ön számítógépén telepítve kell lennie az Anacondának (de ezt megkerülheti, ha önállóan telepíti az összes szükséges csomagot, és játszik a futtatási paraméterekkel).
Minden előkészületi lépés befejeződött, most már elkezdhetjük az oktatás futtatását. A projekt gyökeréből:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .A parancs beírása után automatikusan létrejön egy conda környezet és elindul az edzés.
A fenti példában megadtam az oktatásra szánt epochok számát és a kategóriákat, amelyeket szegmentálni szeretnénk (a teljes listát megtekintheti ) és a távoli szerverünk címét.
A lehetséges paraméterek teljes listáját az MLproject fájlban találjuk.
5. Kiértékeljük az oktatási eredményeket
Az oktatás befejezése után a böngészőnkben a szerverünk címére léphetünk
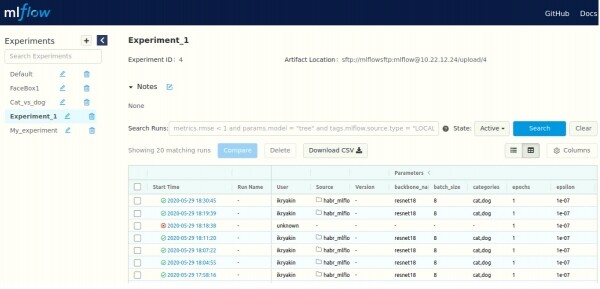
Itt láthatjuk az összes kísérlet listáját (balra fent), valamint a futtatásokkal kapcsolatos információkat (a középpontban). Részletesebb információkat (paraméterek, metrikák, artefaktumok és további információk) is megtekinthetünk minden egyes futtatásról.
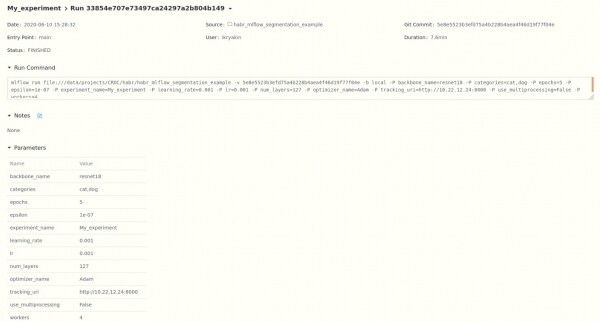
Minden metrikánál nyomon követhetjük a változás történetét.
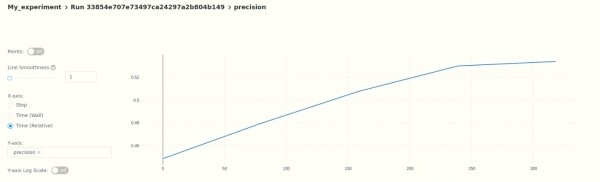
Ezáltal jelenleg "kézi" módban tudjuk elemezni az eredményeket, emellett automatikus validálást is beállíthat a MLflow API segítségével.
6. Modell regisztrálása
Miután elemeztük a modellünket és úgy döntöttünk, hogy készen áll a használatra, elkezdjük a regisztrációt. Ehhez válasszuk ki a kívánt futtatást (ahogyan az az előző pontban látható) és lefelé haladunk.
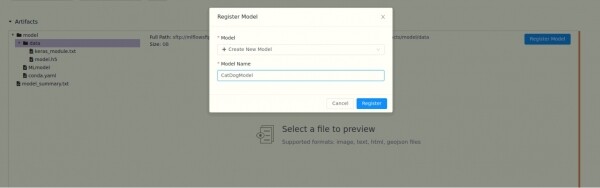
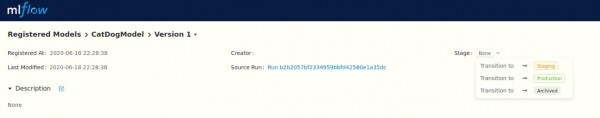
Miután nevet adtunk a modellünknek, megjelenik a verziója. Ha egy másik modellt mentünk el ugyanazzal a névvel, a verzió automatikusan növekszik.
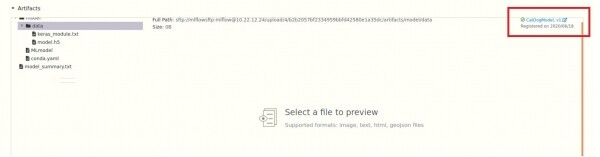
Minden modellhez hozzáadhatunk egy leírást és választhatunk egyet a három állapot közül (Staging, Production, Archived). Ezt követően az API segítségével hozzáférhetünk ezekhez az állapotokhoz, ami a verzionálással együtt további rugalmasságot ad.
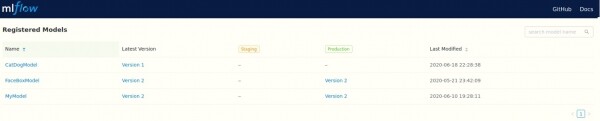
Kényelmes hozzáférésünk van az összes modellhez
és azok verzióihoz.
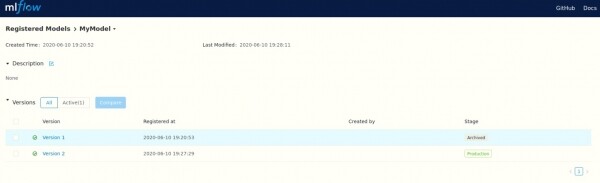
Mint az előző pontban, minden műveletet elvégezhetünk API segítségével.
7. Modell telepítése
Ezen a ponton már van egy betanított (keras) modellünk. Íme egy példa, hogyan használhatjuk:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Itt a self.registry ismét egy kis burkolat a mlflow.tracking.MlflowClient körül, a kényelem érdekében. A lényeg az, hogy távoli szerverhez fordulok, és ott keresek egy modellt a megadott névvel, mégpedig a legfrissebb production verziót. Ezután letöltöm az artefaktumot helyben a .\/model mappába, és ebből a könyvtárból építem fel a modellt a mlflow.keras.load_model(local_path) segítségével. Most már használhatjuk a modellünket. A CV (ML) fejlesztők nyugodtan fejleszthetik a modellt, és közzétehetik az új verziókat.
Végül
Bemutattam egy rendszert, amely lehetővé teszi:
- a ML modellek, az oktatás menetéről és eredményéről szóló információk központosított tárolását;
- a fejlesztési környezet gyors telepítését;
- a modellek munkájának nyomon követését és elemzését;
- a verziókezelés kényelmes lebonyolítását és a modellek állapotának kezelését;
- a kapott modellek egyszerű telepítését.
Ez a példa játékos, és a saját rendszerének kiépítésének kiindulópontjaként szolgál, amely esetleg magában foglalja az eredmények értékelésének automatizálását és a modellek nyilvántartását (5. és 6. pont). Vagy esetleg hozzáadja az adatkészletek verziókezelését, vagy még valami mást? Megpróbáltam kifejezni, hogy szüksége van MLOps-ra összességében, az MLflow csupán egy eszköz a cél eléréséhez.
Írja meg, hogy milyen problémákkal találkozott, amelyek nem jelennek meg?
Mit adna hozzá a rendszerhez, hogy kielégítse az igényeit?
Milyen eszközöket és megközelítéseket használ, hogy megoldja a problémák egy részét vagy egészét?
P.S. Hagyok pár hivatkozást:
github projekt —
MLflow —
A munkahelyi e-mail címem, kérdésekkel — ikryakin@croc.ru
Cégünknél időről időre különböző eseményeket szervezünk IT-szakemberek számára. Például július 8-án 19:00 órakor (MSK) online formátumban találkozót tartunk a CV-ről. Ha érdekel, részt vehetsz, a regisztrációhoz itt csatlakozhatsz. .
Forrás: habr.com
