

Ha az IT infrastruktúrád túl gyorsan növekszik, előbb-utóbb szembesülsz a választással – lineárisan növelni az emberi erőforrásokat annak támogatására, vagy elkezdeni az automatizálást. Egy bizonyos pontig mi is az első paradigmában éltünk, de aztán megkezdődött a hosszú út az Infrastructure-as-Code felé.
Természetesen az NSPK nem startup, de ilyen légkör uralkodott a cég első éveiben, és ezek nagyon izgalmas évek voltak. A nevem , több mint 10 éve támogatom a magas rendelkezésre állású Linux infrastruktúrát. 2016 januárjában csatlakoztam az NSPK csapatához, és sajnos nem tapasztaltam meg a cég kezdeti lépéseit, de egy nagy változás fázisában érkeztem.
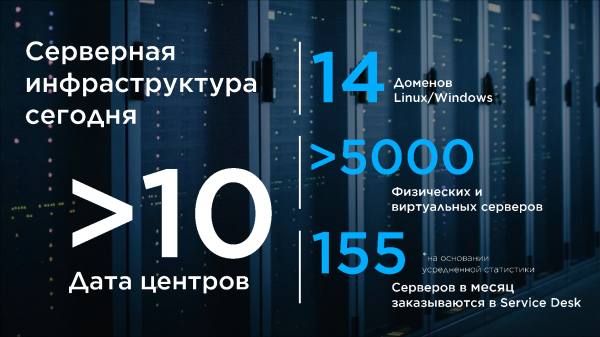
Általánosságban elmondható, hogy csapatunk két terméket biztosít a cég számára. Az első – az infrastruktúra. A levelezésnek működnie kell, a DNS-nek aktívnak kell lennie, a domain-vezérlőknek pedig be kell engedniük azokat a szerverekre, amelyeknek nem szabad leállniuk. A cég IT tája hatalmas! Ezek üzlet- és küldetéskritikus rendszerek, és egyesek elérhetőségi követelményei 99,999%. A második termék – maguk a szerverek, fizikai és virtuális. A meglévőket figyelemmel kell kísérni, az újakat pedig rendszeresen kell szállítani a különböző részlegeknek. Ebben a cikkben arra szeretném helyezni a hangsúlyt, hogy hogyan fejlesztettük az infrastruktúrát, amely a teljes életciklust kezeli. szerverek.
Az út kezdete
Az út elején a technológiai stackünk így nézett ki:
CentOS 7 operációs rendszer
FreeIPA domain-vezérlők
Automatizálás – Ansible(+Tower), Cobbler
Mindez 3 domainben helyezkedett el, amelyeket több adatközpontban osztottak el. Az egyik adatközpontban – irodai rendszerek és tesztelő környezetek, míg a többi PRODUCTION.
A szerverek létrehozása egy időben így zajlott:
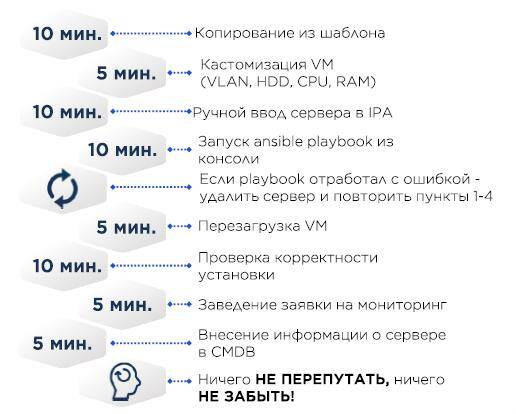
A VM CentOS minimal sablonjában és a szükséges minimum például a helyes /etc/resolv.conf, a többi pedig Ansible-en keresztül érkezik.
CMDB – Excel.
Ha a szerver fizikai, akkor a virtuális gép másolása helyett az OS-t a Cobbler segítségével telepítettük – a Cobbler konfigurációjához a célzott szerver MAC címeit adjuk hozzá, a szerver DHCP-n keresztül IP címet kap, a továbbiakban pedig az OS kerül telepítésre.
Kezdetben még próbáltunk valamilyen konfigurációs kezelést végezni a Cobblerben. De idővel ez problémákat okozott a konfigurációk hordozhatóságával kapcsolatban, mind más adatközpontokba, mind az Ansible kódhoz a VM előkészítéséhez.
Az Ansible-t sokan a Bash kényelmes kiterjesztéseként fogták fel, és szívesen használták a shell, sed konstrukciókat. Tulajdonképpen Bashsible volt. Ez arra vezetett, hogy ha a playbook valamilyen okból nem működött a szerveren, akkor egyszerűbb volt eltávolítani a szervert, javítani a playbookot, és újra futtatni. Gyakorlatilag nem létezett verziókezelés a script-ek esetében, és a konfigurációk hordozhatósága is hiányzott.
Például, ha meg akartuk változtatni egy konfigurációt az összes szerveren:
- A konfiguráció módosítása a meglévő szervereken egy logikai szegmensben/adatközpontban. Néha nem egy nap alatt – a rendelkezésre állásra vonatkozó követelmények és a nagy számok törvénye megakadályozza, hogy az összes változtatást egyszerre alkalmazzuk. Néhány módosítás potenciálisan destruktív lehet, és újraindítást igényel – a szolgáltatásoktól a legfőbb operációs rendszerig.
- Javítás Ansible-ben
- Javítás Cobbler-ben
- Ismételjük meg N-szer minden logikai szegmens/adatközpont számára
Annak érdekében, hogy a változások zökkenőmentesen menjenek végbe, számos tényezőt figyelembe kellett venni, és a változások folyamatosan zajlanak.
- Az Ansible kód, konfigurációs fájlok refaktorálása
- A belső legjobb gyakorlatok megváltoztatása
- A balesetek/incidensek elemzésének eredményei alapján történő változások
- A biztonsági szabványok megváltoztatása, mind a belső, mind a külső. Például, a PCI DSS évről évre új követelményekkel bővül.
Az infrastruktúra növekedése és az út eleje
A szerverek/logikai domainek/adatközpontok száma nőtt, ezzel együtt a konfigurációkban előforduló hibák száma is. Egy idő után három irányba kellett fejlődnünk a konfigurációkezelés terén:
- Automatizálás. Amennyire csak lehetséges, el kell kerülni az emberi tényezőt az ismétlődő műveletek során.
- Ismételhetőség. Sokkal könnyebb az infrastruktúra kezelése, ha az kiszámítható. A szerverek konfigurációjának és előkészítő eszközöknek mindenhol azonosnak kell lennie. Ez ugyanolyan fontos a termékcsapatok számára – az alkalmazásnak biztosan a tesztelés után a tesztkörnyezethez hasonlóan beállított produktív környezetbe kell kerülnie.
- A változások egyszerű és átlátható végrehajtása a konfigurációkezelésben.
Még hozzá kell adnunk néhány eszközt.
Kód tárolására GitLab CE-t választottunk, nem utolsósorban a beépített CI/CD modulok miatt.
Titkos tárként a Hashicorp Vault-ot választottuk, közöttük a kiváló API miatt.
A konfigurációk és az ansible szerepek tesztelése – Molecule+Testinfra. A tesztek sokkal gyorsabban haladnak, ha mitogent csatlakoztatsz az ansible-hez. Párhuzamosan elkezdtük a saját CMDB-nk és automatizált telepítőt írni (a képen a Cobbler fölött), de ez már egy teljesen más történet, amelyről a jövőben a kollégám és ezeknek a rendszereknek a fő fejlesztője fog mesélni.
Választásunk:
Molecule + Testinfra
Ansible + Tower + AWX
Szerverek Világa + DITNET (Saját fejlesztés)
Cobbler
Gitlab + GitLab futtató
Hashicorp Vault
Egyébként az ansible szerepekről. Eleinte csak egy volt, de néhány refaktorálás után 17 lett. Kategórikusan ajánlom, hogy oszd fel a monolitot idempotens szerepekre, amelyeket külön lehet futtatni, további címkéket is hozzáadhatsz. A szerepeinket funkciók szerint osztottuk fel – hálózat, naplózás, csomagok, hardver, molekula stb. Egyébként az alábbi stratégiát követtük. Nem állítom, hogy ez az egyetlen igazság, de nálunk bevált.
- A szerverek másolása „aranyképről” – rossz ötlet!A fő hátrányok közé tartozik, hogy pontosan nem tudod, milyen állapotban vannak most az imázsok, és hogy minden változás minden imázsra és minden virtualizációs farmra átmegy.
- Használj alapértelmezett konfigurációs fájlokat minimálisan, és egyeztesd más részlegekkel, hogy te felelsz az alapvető rendszerszámú fájlokért., például:
- Hagyd üresen a /etc/sysctl.conf-ot, a beállításoknak csak a /etc/sysctl.d/-ban kell lenniük. Az alapértelmezett egy fájlban, az alkalmazás egyedi konfigurációja pedig egy másikban.
- Használj felülíró fájlokat a systemd egységek szerkesztéséhez.
- Template-eld az összes konfigurációt, és egészben töltsd be, amennyire csak lehetséges, semmilyen sed és hasonlók a playbookokban.
- A konfigurációs menedzsment rendszerek kódjának refaktorálása:
- Osztályozd a feladatokat logikai entitásokra, és írd át a monolitot szerepekre.
- Használj lintelő programokat! Ansible-lint, yaml-lint, stb.
- Változtass a megközelítésen! Nincs több bashsible. A rendszer állapotát kell leírni.
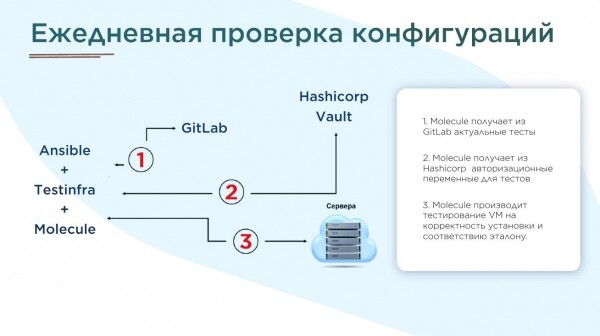
- Minden Ansible szerephez teszteket kell írni a molekulában, és naponta jelentéseket kell generálni.
- A mi esetünkben, a tesztek (több mint 100) elkészítése után körülbelül 70000 hibát találtunk. Több hónapot töltöttünk a javítással.

A mi megvalósításunk
Tehát az ansible szerepek elkészültek, template-elvek és lintelőkkel ellenőrizve. És minden git fel van állítva. De a kód megbízható szállításának kérdése különböző szegmensekbe nyitva maradt. Úgy döntöttünk, hogy szkriptekkel szinkronizálunk. Így néz ki:
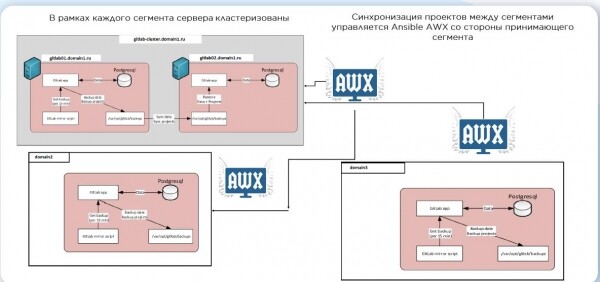
Miután megérkezett a változtatás, elindul a CI, létrejön egy tesztszerver, végigfutnak a szerepek és teszteljük a Molecule-lal. Ha minden rendben, a kód a produkciós ágba kerül. Akkor sem alkalmazunk új kódot a meglévő szervereken automatikusan. Ez egyféle megállás, amely szükséges rendszereink magas rendelkezésre állásához. A gigantikus infrastruktúrák esetében pedig érvényesül a nagy számok törvénye - még ha biztos is abban, hogy a változtatás ártalmatlan, elszomorító következményekkel járhat.
Sokféle lehetőség van a szerverek létrehozására. Végül a testreszabott Python szkriptek mellett döntöttünk. A CI-hez Ansible-t használunk:
- name: create1.yml - Virtuális gép létrehozása egy sablonból
  vmware_guest:
    hostname: "{{datacenter}}".domain.hu
    username: "{{ username_vc }}"
    password: "{{ password_vc }}"
    validate_certs: no
    cluster: "{{cluster}}"
    datacenter: "{{datacenter}}"
    name: "{{ name }}"
    state: poweredon
    folder: "\/{{folder}}"
    template: "{{template}}"
    customization:
      hostname: "{{ name }}"
      domain: domain.hu
      dns_servers:
        - "{{ ipa1_dns }}"
        - "{{ ipa2_dns }}"
    networks:
      - name: "{{ network }}"
        type: static
        ip: "{{ip}}"
        netmask: "{{netmask}}"
        gateway: "{{gateway}}"
        wake_on_lan: True
        start_connected: True
        allow_guest_control: True
    wait_for_ip_address: yes
    disk:
      - size_gb: 1
        type: thin
        datastore: "{{datastore}}"
      - size_gb: 20
        type: thin
        datastore: "{{datastore}}"
Ez az, amit elértünk, a rendszer továbbra is él és fejlődik.
- 17 Ansible szerep a szerver konfigurálásához. Mindegyik szerep egy külön logikai feladat megoldására szolgál (naplózás, audit, felhasználói azonosítás, monitorozás stb.).
- Szerepkörök tesztelése. Molecule + TestInfra.
- Saját fejlesztés: CMDB + Orkesztrátor.
- A szerver létrehozásának ideje ~30 perc, automatizált és gyakorlatilag független a feladatok sorától.
- Az infrastruktúra azonos állapota/neve minden szegmensben – playbookok, tárolók, virtualizációs elemek.
- Napi szintű szerverállapot-ellenőrzés, a normával való eltérésekről jelentések készítése.
Remélem, beszámolóm hasznos lesz azok számára, akik a kezdeti úton járnak. Ön milyen automatizálási technológiát használ?
Forrás: habr.com
