

Manapság elképzelhetetlen egy Kubernetes alapú projekt az ELK stack nélkül, amely lehetővé teszi az alkalmazások és a klaszter rendszerezési komponenseinek naplóinak megőrzését. A gyakorlatunkban az EFK stack-et használjuk a Fluentd-vel a Logstash helyett.
A Fluentd egy modern, sokoldalú naplógyűjtő, amely egyre népszerűbbé válik, és csatlakozott a Cloud Native Computing Foundation-hoz, ezért a fejlesztés iránya a Kubernetes-szel való együttműködésre összpontosít.
A Fluentd Logstash helyetti használata nem változtatja meg a program komplexum lényegét, azonban a Fluentd-nek megvannak a saját specifikus finomságai, amelyek a sokoldalúságából adódnak.
Például, amikor elkezdtük használni az EFK-t egy nagy terhelésű projektben, ahol a naplóbejegyzések intenzív írása zajlott, észrevettük, hogy a Kibana egyes üzenetek többször is megjelennek. Ebben a cikkben elmondjuk, miért történik ez a jelenség, és hogyan lehet megoldani a problémát.
A dokumentumok megduplázódásának problémája
Projektjeinkben a Fluentd DaemonSet-ként van telepítve (automatikusan elindul egy példányban a Kubernetes klaszter minden csomópontján), és a stdout naplókat a /var/log/containers könyvtárban figyeli. A naplók JSON-dokumentumok formájában kerülnek továbbításra az ElasticSearch-be, amely klaszterezett vagy standalone módban fut, a projekt méretétől és a teljesítménnyel és megbízhatósággal kapcsolatos követelményektől függően. A grafikus felület a Kibana.
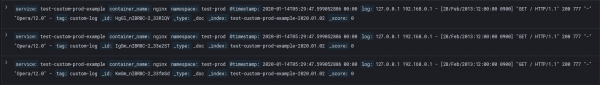
A Fluentd kimeneti puffert használó pluginjának használatakor olyan helyzettel találkoztunk, amikor az ElasticSearch-ben két dokumentum teljesen megegyező tartalommal bír, és csak az azonosítójukban különböznek. Az, hogy ez tényleg az üzenet megismétlődése, a Nginx napló példájával érzékelhető. A naplófájlban ez az üzenet egy példányban létezik:
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Azonban az ElasticSearch-ben több dokumentum is létezik, amelyek ezt az üzenetet tartalmazzák:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}
Ezenkívül a megismétlődések száma meghaladhatja a kettőt.
A probléma rögzítése során a Fluentd naplóiban számos figyelmeztetés figyelhető meg a következő tartalommal:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] nem sikerült kiüríteni a puffert. újrapróbálkozási idő=4 következő_próbálkozási_idő=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="nem lehetett naplókat küldeni az Elasticsearch klaszterhez ({:host=>"elasticsearch", :port=>9200, :scheme=>"http", :user=>"elastic", :password=>"obfuscated"}): olvasási időtúllépés történt"Ezek a figyelmeztetések akkor fordulnak elő, amikor az ElasticSearch nem tud választ adni a kérésre a request_timeout paraméter által megadott időn belül, emiatt a továbbított pufferrész nem tud kiürülni. Ezt követően a Fluentd megpróbálja újra elküldeni a pufferrészt az ElasticSearch-nek, és tetszőleges számú próbálkozás után a művelet sikeresen befejeződik:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] az újrapróbálkozás sikeres volt. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] az újrapróbálkozás sikeres volt. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] az újrapróbálkozás sikeres volt. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] az újrapróbálkozás sikeres volt. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] az újrapróbálkozás sikeres volt. chunk_id="59c37f63a9046e6dff7e9987729be66f"
Azonban, az ElasticSearch minden egyes továbbított pufferrészt egyedinek tekint, és a _id mezők egyedi értékeit rendel a bejegyzéshez. Így jönnek létre a másolatok.
A Kibana-ban ez így néz ki:
A probléma megoldása
Több lehetőség is van a probléma megoldására. Az egyik a fluent-plugin-elasticsearch pluginbe beépített egyedi hash generáló mechanizmus használata, amely minden dokumentumhoz egyedi azonosítót rendel. Ennek a mechanizmusnak a használatával az ElasticSearch észlelni fogja az ismétlődéseket az átvitel során, és megakadályozza a dokumentumok duplikálódását. Azonban figyelembe kell venni, hogy ez a megoldás a következménnyel harcol, és nem szünteti meg a timeout hiányával járó hibát, ezért a használatától eltekintettünk.
Kimeneti buffer plugin-t használunk a Fluentd-ben, hogy elkerüljük a naplófájlok elvesztését átmeneti hálózati problémák vagy a naplóírás fokozott intenzitása esetén. Ha valamilyen oknál fogva az ElasticSearch nem tudja azonnal beírni a dokumentumot az indexbe, akkor a dokumentum egy olyan sorba kerül, amely disk-re kerül mentésre. Tehát a probléma forrásának megszüntetéséhez, amely az előbb említett hiba keletkezéséhez vezet, meg kell határozni a megfelelő buffer paraméterértékeket, amelyek biztosítják, hogy a Fluentd kimeneti bufferje elegendő méretű legyen, és közben időben ki tudjon ürülni.
Fontos megjegyezni, hogy az alább említett paraméterértékek mindegyike egyedi, és az adott bufferelési esetekhez igazodik, mivel számos tényezőtől függ: a szolgáltatások naplóra írásának intenzitása, a tárolórendszer teljesítménye, a hálózati sávszélesség terheltsége és kapacitása. Ezért az optimális, de nem túlzott bufferbeállítások megszerzéséhez, elkerülve a hosszadalmas blind próbálkozásokat, érdemes a Fluentd által működése során generált naplóüzemeltetési információt felhasználni, amivel viszonylag gyorsan pontos értékekhez juthatunk.
A probléma rögzítésekor a konfiguráció a következőképpen nézett ki:
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
A probléma megoldása során a következő paraméterek értékei manuálisan lettek meghatározva:
chunk_limit_size — a chunkok mérete, amelyekre a bufferben a kérdések felosztásra kerülnek.
- flush_interval – az az időintervallum, amely után a puffer tisztításra kerül.
- queue_limit_length – a sorban lévő chunkok maximális száma.
- request_timeout – az az idő, amely alatt a kapcsolat létrejön a Fluentd és az ElasticSearch között.
A puffer összes méretét a queue_limit_length és a chunk_limit_size paraméterek szorzataként lehet kiszámítani, ami a sorban lévő maximális chunkok számát jelenti, mindegyik megadott mérettel. Ha a puffer mérete nem elegendő, a naplókban a következő figyelmeztetés jelenik meg:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] nem sikerült adatot írni a pufferbe a puffer túlfolyásának akciója miatt=:blockEz azt jelenti, hogy a puffer nem tud tisztulni a megadott időn belül, és a megtelt pufferbe érkező adatok blokkolva lesznek, ami a naplók egy részének elvesztéséhez vezethet.
A puffer növelésének két módja van: vagy a sorban lévő chunkok méretét, vagy a sorban lévő chunkok számát növelve.
Ha a chunk méretét chunk_limit_size 32 megabájt fölé állítja, az ElasticSearch nem fogadja el, mivel a bejövő csomag túl nagynak minősül. Ezért, ha a puffer további növelésére van szükség, érdemes inkább a sor maximális hosszát queue_limit_length növelni.
Amikor a puffer már nem túltelítődött, és csak az időtúllépés üzenete marad, akkor lehet kezdeni a request_timeout paraméter növelését. Azonban, ha a beállított érték 20 másodpercnél nagyobb, a Fluentd naplókban a következő figyelmeztetések fognak megjelenni:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] a puffer töltés több időt vett igénybe, mint a slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Ez az üzenet semmilyen hatással nincs a rendszer működésére, és azt jelenti, hogy a puffer tisztítás ideje meghaladta a slow_flush_log_threshold által megadott értéket. Ez egy hibakeresési információ, amelyet a request_timeout paraméter értékének kiválasztásakor használunk.
Az általános kiválasztási algoritmus a következőképpen néz ki:
- Állítsa be a request_timeout értékét garantáltan nagyobbra, mint amire szükséges (száz másodperc). A beállítási időszakban a helyes beállításhoz szükséges fő kritérium a timeout hiányának figyelmeztetéseinek eltűnése lesz.
- Várja meg a slow_flush_log_threshold küszöb túllépéséről szóló üzeneteket. A figyelmeztetés szövegében az elapsed_time mezőben megtalálható a puffer tisztítás tényleges ideje.
- Állítsa a request_timeout értékét magasabbra, mint a monitorozott időszak alatt kapott maximális elapsed_time érték. A request_timeout értékét az elapsed_time + 50%-kal számoljuk ki.
- A slow_flush_log_threshold értékének emelésével eltávolíthatók a hosszú buffer-ürítési figyelmeztetések a naplóból. Ezt az értéket az elapsed_time + 25%-kal számítjuk ki.
A paraméterek végső értékei, ahogy korábban említettük, esetre szabottak. A fent leírt algoritmus követésével biztosítjuk, hogy megszüntessük a hiba okozta üzenetismétlődéseket.
Az alábbi táblázat mutatja, hogyan változik a naponta előforduló hibák száma, amelyek üzenetduplikációhoz vezetnek, a fent említett paraméterek értékeinek keresése során:
node-1
node-2
node-3
node-4
Előtte/Utána
Előtte/Utána
Előtte/Utána
Előtte/Utána
nem sikerült üríteni a buffert
1749/2
694/2
47/0
1121/2
újrapróbálkozás sikerült
410/2
205/1
24/0
241/2
Fontos megjegyezni, hogy a kapott beállítások elavulhatnak a projekt növekedésével és a naplók számának növekedésével. Az alapvető jele a beállított időkorlát hiányának, ha a Fluentd naplóba hosszú buffer-ürítési üzenetek érkeznek, azaz túllépve a slow_flush_log_threshold küszöbértéken. E pillanattól van még egy kis tartalék, mielőtt a request_timeout paraméter túllépésre kerülne, ezért fontos, hogy időben reagáljunk ezekre az üzenetekre, és ismét végezzük el az optimális beállítások keresésének folyamatát, ahogy azt korábban leírtuk.
Zárás
A Fluentd kimeneti buffer finomhangolása a legfontosabb lépés az EFK stack beállításában, amely meghatározza annak működésének stabilitását és a dokumentumok helyes indexelését. A fent leírt beállítási algoritmus alapján biztos lehet benne, hogy minden napló helyes sorrendben, ismétlés és veszteség nélkül kerül rögzítésre az ElasticSearch indexében.
Olvasd el többi cikkünket a blogunkban:
Forrás: habr.com
