

A cikk fordítása a kurzus megkezdése előtt készült
A több nagy teljesítményű számítási példányon végzett elosztott tanulás jelentősen csökkentheti a modern mély neurális hálózatok tanulási idejét nagy adathalmazokkal, akár hetekből órákra vagy percekre, ami ezt a tanulási technikát a mélytanulás gyakorlati alkalmazásában élenjáróvá teszi. A felhasználóknak meg kell érteniük, hogyan osszák meg és szinkronizálják az adatokat több példányon, ami nagy hatással van a skálázás hatékonyságára. Ezen kívül a felhasználóknak azt is tudniuk kell, hogyan telepítsenek egy tanulási szkriptet több példányon, amely egy példányon működik.
Ebben a cikkben egy gyors és egyszerű elosztott tanulási módszert mutatunk be az Apache MXNet nyílt mélytanuló könyvtárral és a Horovod elosztott tanulási keretrendszerével. Számos előnyt mutatunk be a Horovod keretrendszerről a teljesítmény terén, és bemutatjuk, hogyan lehet írni egy MXNet tanulási szkriptet, amely elosztottan működik a Horovod segítségével.
Mi az Apache MXNet
egy nyílt mélytanulási keretrendszer, amely a mély neurális hálózatok létrehozására, tanulmányozására és telepítésére szolgál. Az MXNet elvonatkoztatja a neurális hálózatok megvalósításával járó nehézségeket, magasan teljesít és skálázható, valamint API-t kínál népszerű programozási nyelvekhez, mint például , , , , , , és mások.
Elosztott tanulás az MXNetben paraméter szerverrel
paraméter szerver (parameter server) megközelítést alkalmaz. Egy paraméter szerverekből álló halmazt használ, amely a gradienseket gyűjti össze minden munkától, aggregálja őket, és visszaküldi a frissített gradienseket a munkásokhoz a következő optimalizálási iterációhoz. A szerverek és munkások közötti megfelelő arány meghatározása a hatékony skálázás kulcsa. Ha csak egy paraméter szerver van, az szűk keresztmetszetté válhat a számítások során. Ezzel szemben, ha túl sok szervert használnak, a „több-többhöz” kapcsolat eljuthat a hálózati kapcsolatok telítődéséhez.
Mi az a Horovod
– egy nyílt keretrendszer a decentralizált mélytanuláshoz, amelyet az Uber fejlesztett ki. Hatékony technológiákat használ a több GPU és csomópont közötti interakcióra, mint például a NVIDIA Collective Communications Library (NCCL) és a Message Passing Interface (MPI), a modellparaméterek elosztása és aggregálása érdekében a munkafolyamatok között. Optimalizálja a hálózati sávszélesség felhasználását, és jól skálázható a mély neurális hálózatok modellezésekor. Jelenleg támogatja a népszerű gépi tanulási keretrendszereket, nevezetesen , Tensorflow, Keras és PyTorch.
MXNet és Horovod integrációja
A MXNet integrálódik a Horovod-hoz a Horovod-ban definiált elosztott tanulási API-kon keresztül. A Horovod kommunikációs API-jai horovod.broadcast(), horovod.allgather() és horovod.allreduce() aszimmetrikus visszahívások segítségével valósulnak meg az MXNet motorján belül, a feladatgrafikon részét képezve. Így az adatok közötti függőségek a kommunikáció és számítás között könnyen kezelhetők az MXNet motor által, hogy elkerüljük a teljesítményvesztést a szinkronizáció miatt. A Horovod-ban definiált distributed optimizer horovod.DistributedOptimizer kiterjeszti Optimizer a MXNet-ben úgy van megvalósítva, hogy a megfelelő Horovod API-kat hívja meg a paraméterek elosztott frissítéséhez. Mindezek a végrehajtási részletek átláthatók a végfelhasználók számára.
Gyors indítás
Gyorsan elkezdheti egy kis konvolúciós neurális hálózat betanítását az MNIST adatgyűjteményen a MXNet és a Horovod segítségével a MacBookján.
Először telepítse az mxnet és a horovod csomagokat a PyPI-ból:
pip install mxnet
pip install horovod
Megjegyzés: Ha a telepítés során hiba lép fel pip install horovod, előfordulhat, hogy hozzá kell adnia a változót MACOSX_DEPLOYMENT_TARGET=10.vv, ahol vv – ez a MacOS verziója, például a MacOSX Sierra-hoz a következőt kell írni: MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Ezután telepítse az OpenMPI-t. .
Végül töltsön le egy tesztelő szkriptet mxnet_mnist.py és futtassa a következő parancsokat a MacBook termináljában a munkakönyvtárában:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pyEzzel két processzormag segítségével indítja el a tanulást. Az eredmény a következő lesz:
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Teljesítménydemonstráció
A ResNet50-v1 modell tanítása az ImageNet adatgyűjteményen 64 GPU-val nyolc példán keresztül p3.16xlarge EC2, mindegyik 8 NVIDIA Tesla V100 GPU-t tartalmaz az AWS felhőben, elértük a tanulási teljesítményt 45000 kép/másodperc (azaz a másodpercenkénti tanított minták száma). A tanulás 44 perc alatt befejeződött 90 epókkal, a legjobb pontossággal 75,7%.
Összehasonlítottuk ezt a MXNet elosztott tanulással, paraméter szerverek használatával 8, 16, 32 és 64 GPU-val egy paraméter szerver és 1:1, illetve 2:1 arányú munkás szerverek esetén. Az eredményt az alábbi 1. ábrán láthatja. A bal oldali y tengelyen a rudak a másodpercenkénti tanulási képek számát mutatják, a vonalak a skálázás hatékonyságát (azaz a tényleges teljesítmény és az ideális arányát) az jobb oldali y tengelyen. Ahogy látható, a szerverek számának megválasztása hatással van a skálázás hatékonyságára. Ha a paraméter szerver egy, a skálázás hatékonysága 38%-ra csökken 64 GPU-nál. Az ugyanolyan skálázási hatékonyság eléréséhez, mint a Horovoddal, a szerverek számát a munkások számának kétszeresére kell növelni.
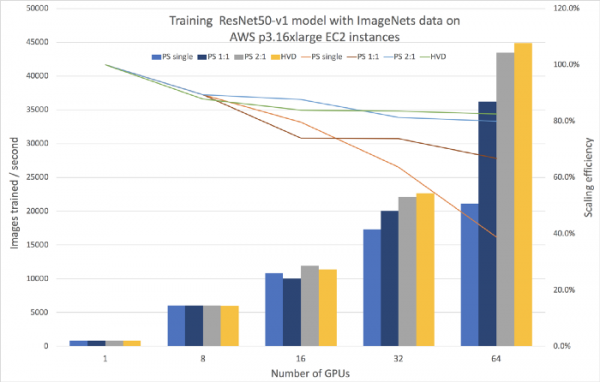
1. ábra. Az elosztott tanulás összehasonlítása MXNet használatával Horovoddal és paraméter szerverrel.
Az alábbi 1. táblázatban összehasonlítottuk a példány végső költségét 64 GPU-nál végzett kísérletek során. A MXNet Horovoddal való használata biztosítja a legjobb teljesítményt a legalacsonyabb költségek mellett.
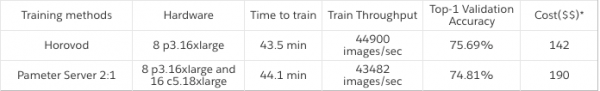
1. táblázat. A Horovod és paraméter szerver közötti költség-összehasonlítás 2:1 arányú munkással.
Lépések a reprodukáláshoz
A következő lépésekben bemutatjuk, hogyan lehet reprodukálni az elosztott tanulás eredményét a MXNet és Horovod segítségével. Az MXNet elosztott tanulásról többet olvashat .
1. lépés
Hozzon létre egy homogén példányklasztert a MXNet 1.4.0-ás vagy újabb, valamint a Horovod 0.16.0-ás vagy újabb verziójával az elosztott tanulás használatához. Az is szükséges, hogy GPU-tanuláshoz szükséges könyvtárakat telepítsen. Példányainkhoz az Ubuntu 16.04 Linuxot választottuk, 396.44-es GPU illesztőprogrammal, CUDA 9.2-vel, cuDNN 7.2.1 könyvtárral, NCCL 2.2.13 kommunikátorral és OpenMPI 3.1.1-gyel. Használhatja a ahol ezek a könyvtárak már telepítve vannak.
2. lépés
Adja hozzá az MXNet tanulási szkripthez a Horovod API-val való munkát. Az alább bemutatott, MXNet Gluon API alapú szkriptet egyszerű sablonként használhatja. A kiemelt sorokat csak akkor kell használnia, ha már rendelkezik a megfelelő tanulási szkripttel. Íme néhány kritikus változtatás, amelyet el kell végeznie a Horovoddal való tanuláshoz:
- Állítsa be a kontextust a Horovod helyi rangjának megfelelően (8. sor), hogy megértse, hogy a tanulás a megfelelő GPU-n zajlik.
- Adja át a kezdő paramétereket egy munkásszámtól minden szükséges munkásszámra (18. sor), hogy biztos legyen benne, hogy minden munkásszám ugyanazzal a kezdő paraméterekkel indítja a munkát.
- Hozza létre a Horovodot DistributedOptimizer (25. sor), hogy a paramétereket elosztva frissítse.
A teljes szkript megtekintéséhez nézze meg a Horovod-MXNet példáit. és .
1 import mxnet as mx
2 import horovod.mxnet as hvd
3
4 # Horovod: a Horovod inicializálása
5 hvd.init()
6
7 # Horovod: rögzítsen egy GPU-t a helyi rang használatra
8 context = mx.gpu(hvd.local_rank())
9
10 # Modell felépítése
11 model = ...
12
13 # Paraméterek inicializálása
14 model.initialize(initializer, ctx=context)
15 params = model.collect_params()
16
17 # Horovod: a paraméterek közvetítése
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Optimalizáló létrehozása
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: az optimalizáló becsomagolása a DistributedOptimizer segítségével
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Tanuló és veszteségfüggvény létrehozása
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Modell tanítása
32 for epoch in range(num_epoch):
33    ...
3. lépés
Lépjen be az egyik munkásszámba a szétosztott tanulás indításához az MPI direktívával. Ebben a példában a szétosztott tanulás négy példányban indul, mindegyik 4 GPU-val, a klaszterben összesen 16 GPU-val. A Stochastic Gradient Descent (SGD) optimalizálót fogjuk használni a következő hiperparaméterekkel:
- mini-batch méret: 256
- tanulási sebesség: 0.1
- impulzus: 0.9
- súlycsökkentés: 0.0001
Ahogy a számítástechnikai teljesítményt a 64 GPU-ra való felskálázás során lineárisan skáláztuk az oktatási sebességet a GPU-k számának megfelelően (0,1-től 1 GPU-ra 6,4-ig 64 GPU-ra), figyelembe véve, hogy a grafikákra eső képek száma 256 maradt (256 képből 1 GPU-ra 16 384-re 64 GPU-ra). A súlycsökkentés és az impulzus paramétereit a GPU-k számának növekedésével változtattuk meg. A tanulmányozáshoz vegyes pontosságú tanulást használtunk, float16 típusú adatokkal az előrehaladott fázisban, és float32-t a gradiensekhez, hogy felgyorsítsuk a float16 számításokat, amit az NVIDIA Tesla GPU támogat.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Zárás
Ebben a cikkben a Apache MXNet és Horovod alkalmazásával végzett elosztott modellképzés skálázható megközelítését vizsgáltuk. Bemutattuk a skálázhatóság hatékonyságát és gazdaságosságát a paraméterező szerverrel történő megközelítéssel összehasonlítva az ImageNet adathalmazon, ahol a ResNet50-v1 modellt képeztük. Emellett bemutattuk azokat a lépéseket, amelyek segítségével módosíthatja a meglévő szkriptet több példányban Horovod segítségével történő tanulás indításához.
Ha most kezd duglálni az MXNet-tel és a mélytanulással, lépjen az installálási oldalra , hogy először összegyűjtse az MXNet-et. Emellett javasoljuk, hogy olvassa el a cikket , hogy elkezdhesse a munkát.
Ha már dolgozott az MXNet-tel, és szeretné kipróbálni az elosztott tanulást Horovod-dal, nézze meg a , gyűjtse össze az MXNet-tel, és kövesse a példát vagy .
*az ár a AWS EC2 példányok esetén
Tudjon meg többet a tanfolyamról
Forrás: habr.com
