

Bevezetés
Helló!
Ebben a cikkben megosztom tapasztalataimat a mikroszolgáltatás-architektúra felépítéséről egy neurális hálózatokat használó projekt számára.
Beszéljünk az architektúrával szemben támasztott követelményekről, nézzük meg a különböző struktúrákat, vizsgáljuk meg a kész architektúra minden egyes komponensét, és értékeljük a megoldás technikai mutatóit.
Jó olvasást!
Néhány szó a feladatról és annak megoldásáról
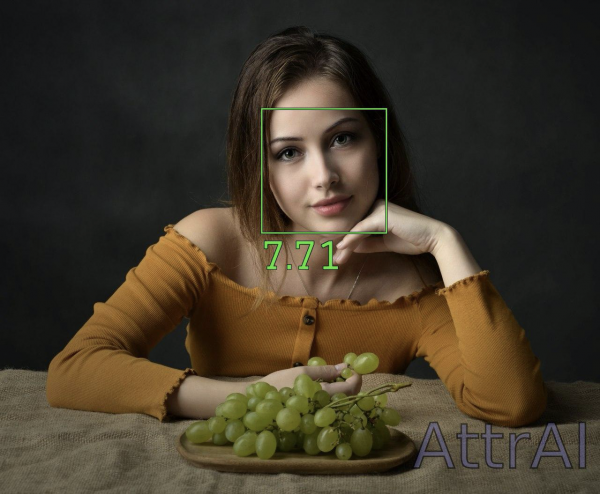
A fő ötlet az, hogy fénykép alapján 10 pontos skálán értékeljük egy személy vonzerejét.
Ebben a cikkben eltávolodunk a neurális hálózatok, valamint az adatok előkészítési és tanulási folyamatának leírásától. Azonban a következő publikációk egyikében mindenképpen visszatérünk az értékelési pipeline részletes elemzésére.
Most azonban magas szintű áttekintést adunk az értékelési pipeline-ról, a hangsúlyt a mikroszolgáltatások interakciójára helyezve a projekt általános architektúrájának kontextusában.
A vonzerejének értékelésével foglalkozó pipeline munkája során a feladatot a következő összetevőkre bontották:
- Az arcok kiemelése a fényképeken
- Minden arcnak az értékelése
- Az eredmény renderelése
Az elsőt egy előképzett segítségével oldjuk meg. A másodikhoz egy konvolúciós neurális hálót képeztem ki a PyTorch keretrendszerben, a backbone-ként a következőt használtuk: – az "minőség / CPU inferálási sebesség" egyensúlyából kiindulva.
Az értékelési pipeline funkcionális diagramja
A projekt architekturájára vonatkozó követelmények elemzése
Egy projekt életciklusában az architektúrával és a modellek telepítésének automatizálásával foglalkozó szakaszok gyakran az egyik legidőigényesebb és erőforrásigényesebb fázisok. A gépi tanulással kapcsolatos projekt életciklusa
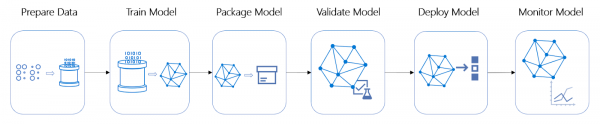
Ez a projekt sem kivétel – úgy döntöttek, hogy az értékelési pipeline-t online szolgáltatásként csomagolják, ezért be kellett merülni az architektúrába. Az alábbi alapvető követelményeket határozták meg:
Közös naplózási tároló – minden szolgáltatásnak egy helyre kell írnia a naplókat, amelyeket könnyen elemezni kell.
- A vonzerejének értékelésénél horizontális skálázhatóság lehetősége – mivel ez a legvalószínűbb szűk keresztmetszet.
- Minden egyes kép értékeléséhez azonos mennyiségű processzor-erőforrást kell biztosítani – a feldolgozási idő eloszlásában előforduló kiugrások elkerülése érdekében.
- Gyors (újra)telepítés lehetősége, mind az egyes szolgáltatások, mind az egész stack esetében.
- Lehetőség, ha szükséges, hogy különböző szolgáltatásokban közös objektumokat használjunk.
- Возможность, при необходимости, использовать в разных сервисах общие объекты
Architektúra
A követelmények elemzése után nyilvánvalóvá vált, hogy a mikroszervizes architektúra szinte tökéletesen illeszkedik.
A felesleges fejfájás elkerülése érdekében a frontendhez a Telegram API-t választottuk.
Először nézzük meg a kész architektúra struktúráját, majd áttekintjük az egyes komponenseket, és formálisan rögzítjük a sikeres képfeldolgozás folyamatát.
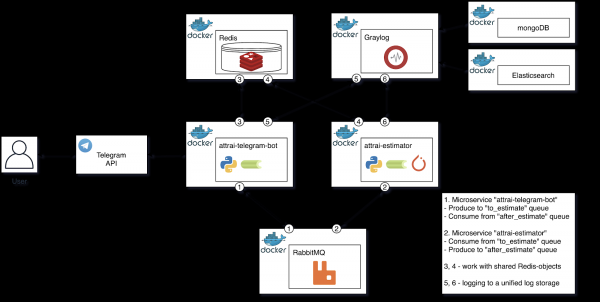
A kész architektúra struktúrája
Beszéljünk részletesebben a diagram minden komponenséről, és jelöljük meg a Single Responsibility-jüket a kép értékelési folyamata során.
Mikroszerviz: „attrai-telegram-bot”
Ez a mikroszerviz összesíti az összes interakciót a Telegram API-val. Két fő forgatókönyvet lehet kiemelni – a felhasználói kép kezelése és az értékelési pipeline eredményeinek kezelése. Áttekintjük mindkét forgatókönyvet általános értelemben.
Felhasználói üzenet fogadása képpel:
- Szűrés történik, amely a következő ellenőrzésekből áll:
- A kép optimális méretének megléte
- A felhasználó által már a sorban lévő képek száma
- Az elsődleges szűrés sikeres teljesítése után a képet elmentjük egy docker volume-ba
- A „to_estimate” sorba egy feladat kerül, amelyben szerepel a kép útvonala, amely a mi volume-unkban található.
- Ha a fent említett lépések sikeresen végrehajtásra kerültek – a felhasználó üzenetet kap a kép feldolgozásának várható idejéről, amelyet a sorban lévő feladatok száma alapján számítanak ki. Hibás eredmény esetén a felhasználót egyértelműen értesítjük arról, hogy mi nem működött.
Továbbá, ez a mikroszerviz, mint celery worker, figyeli az „after_estimate” sort, amely a már a pipeline-on átment feladatok számára szolgál.
Új feladat fogadása az „after_estimate”-ből:
- Ha a kép sikeresen feldolgozva lett – elküldjük az eredményt a felhasználónak, ha nem – értesítjük a hibáról.
- Töröljük a kép eredményét, amely a pipeline értékelésének következménye.
Értékelő mikroszerviz: „attrai-estimator”
Ez a mikroszerviz celery worker, és mindent összesít, ami a kép értékelési pipeline-jával kapcsolatos. Az itt alkalmazott algoritmus egy – bontsuk le.
Új feladat fogadása a „to_estimate”-ből:
- A képet átkonvertáljuk az értékelési pipeline-on:
- A képet a memóriába töltjük.
- Az ábrát a kívánt méretre állítjuk
- Mindent megkeresünk az arcokról (MTCNN)
- Minden arcot értékelünk (a korábban felfedezett arcokat batchbe foglaljuk és inferezünk ResNet34-tal)
- A végső képet rendereljük
- Megrajzoljuk a bounding boxokat
- Megrajzoljuk az értékeléseket
- Eltávolítjuk a felhasználói (eredeti) képet
- Mentjük az értékelési pipeline kimenetét
- A feladatokat az 'after_estimate' sorba helyezzük, amit a fent említett 'attrai-telegram-bot' mikroszolgáltatás figyel
Graylog (+ mongoDB + Elasticsearch)
— ez a naplókezelés központosított megoldása. E projekt keretein belül használtuk az eredeti céljának megfelelően.
Rá esett a választás, nem pedig a mindenki által megszokott stack, mivel kényelmesen használható Pythonból. Minden, amit a Graylogban való naplózáshoz meg kell tennünk, az az, hogy hozzáadjuk a GELFTCPHandler-t a csomagból a python-mikroszolgáltatásunk többi root logger handleréhez.
Mint valaki, aki korábban csak ELK stack-kel dolgozott, összességében pozitív tapasztalatot szereztem a Grayloggal való munkám során. Az egyetlen kiábrándító dolog, hogy a Kibana funkciói túlsúlyban vannak a Graylog webes felülete felett.
RabbitMQ
— ez egy AMQP alapú üzenetközvetítő.
E projekt keretein belül közvetítőként használták a Celery számára és tartós üzemmódban működött.
Redis
— ez egy NoSQL adatbázis, amely kulcs-érték típusú adatstruktúrákkal dolgozik
Időnként szükség lehet különböző python-mikroszolgáltatásokban közös objektumokat használni, amelyek valamilyen adatstruktúrákat valósítanak meg.
Például a Redisben tárolt hashmap a következő formátumban: 'telegram_user_id => aktív feladatok száma a sorban', amely lehetővé teszi, hogy a felhasználótól érkező kérések számát egy bizonyos értékhez korlátozzuk ezzel megakadályozva a DoS támadásokat.
Formalizáljuk a kép sikeres feldolgozásának folyamatát
- A felhasználó elküldi a képet a Telegram botnak
- Az 'attrai-telegram-bot' megkapja az üzenetet a Telegram API-tól és feldolgozza azt
- A képpel kapcsolatos feladatot az 'to_estimate' aszinkron sorba helyezzük
- A felhasználó egy üzenetet kap a tervezett értékelési időről
- Az 'attrai-estimator' leveszi a feladatot az 'to_estimate' sorból, végigfuttatja az értékelési pipeline-on és a feladatot az 'after_estimate' sorba gyártja
- Az 'attrai-telegram-bot', amely figyeli az 'after_estimate' sort, elküldi az eredményt a felhasználónak
DevOps
Végül, az architektúra áttekintése után, áttérhetünk a nem kevésbé érdekes részre — a DevOps-ra
Docker Swarm
— egy klaszterezési rendszer, amelynek funkciói a Docker Engine-en belül valósulnak meg és készen állnak a használatra.
A "sokaság" segítségével a klaszterünk összes csomópontját két típusra lehet bontani – worker és manager. Az első típusú gépeken konténercsoportokat (stack) telepítenek, míg a második típusú gépek felelnek a skálázásért, a terheléselosztásért és . Az alapértelmezett menedzserek egyben worker-ként is működnek.
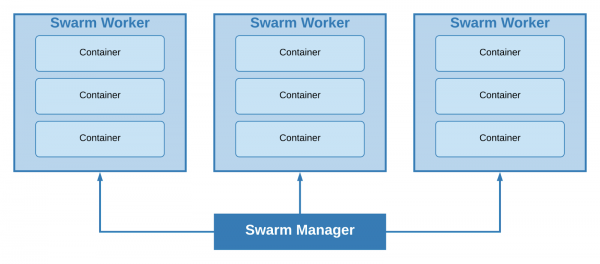
Egy klaszter egy leader manager-rel és három worker-rel
A klaszter minimális mérete 1 csomópont, az egyetlen gép egyidejűleg leader manager- és worker-ként fog működni. A projekt mérete és a nagy rendelkezésre állásra vonatkozó minimális követelmények alapján ezt a megközelítést választották.
Elöljáróban mondom, hogy a június közepén történt első production telepítést követően nem voltak problémák e klaszteresítési megoldással kapcsolatban (de ez nem jelenti azt, hogy ez a megoldás bármilyen közepes vagy nagy projektben megengedett, amelyre magas rendelkezésre állási követelmények vonatkoznak).
Docker Stack
A "sokaság" módban a stacket (docker services csoport) a következő teszi lehetővé
Támogatja a docker-compose konfigurációkat, lehetővé téve a deploy paraméterek további használatát.
Például ezen paraméterek segítségével korlátozták a forrásokat minden egyes mikroszolgáltatás példányra (N példányhoz N CPU-t rendeltünk, a mikroszolgáltatáson belül a PyTorch által használt CPU-k számát egyre korlátoztuk)
attrai_estimator:
  image: 'erqups/attrai_estimator:1.2'
  deploy:
    replicas: 4
    resources:
      limits:
        cpus: '4'
    restart_policy:
      condition: on-failure
      …
Fontos megjegyezni, hogy a Redis, RabbitMQ és Graylog – stateful szolgáltatások, és azokat nem lehet olyan könnyen skálázni, mint az «attrai-estimator»-t.
Előre jelezve a kérdést – miért nem Kubernetes?
Úgy tűnik, hogy a Kubernetes használata kis- és közepes méretű projektekben fölösleges, mivel minden szükséges funkciót megkaphatunk a Docker Swarm-tól, amely meglehetősen felhasználóbarát a konténerorchestrátorok között, és alacsony belépési küszöbbel rendelkezik.
Infrastruktúra
Mindez egy olyan VDS-en valósult meg, amelynek a következő jellemzői voltak:
- CPU: 4 magos Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 GB
- SSD: 160 GB
Helyi terheléses tesztek után úgy tűnt, hogy a jelentős felhasználói forgalom idején ez a gép csak éppen hogy elegendő lesz.
Azonnal a telepítés után közzétettem egy linket a legnépszerűbb posztidőszakokra az SNSZ-területen (igen, arra), amit követően az emberek érdeklődni kezdtek, és néhány óra alatt a szolgáltatás sikeresen számos tízezer képet feldolgozott. A csúcsidei pillanatokban a CPU és a RAM erőforrások felhasználtsága még a felét sem érte el.
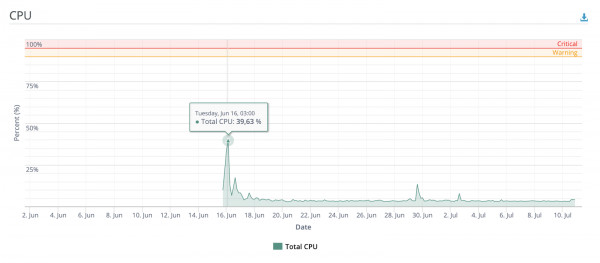
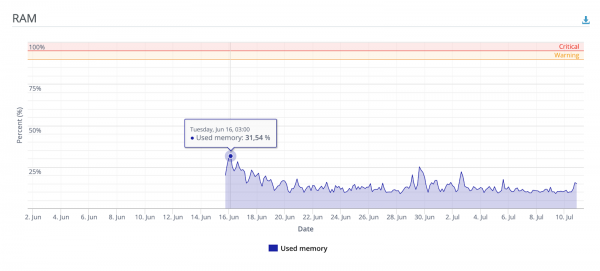
Még néhány grafika
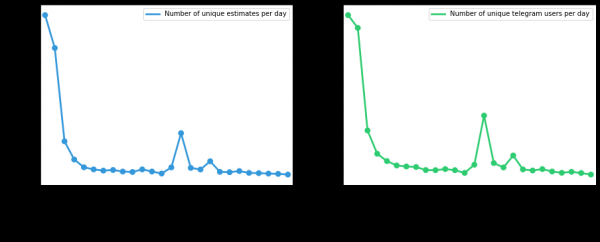
A telepítéstől számított egyedi felhasználók és értékelési kérelmek száma napontként
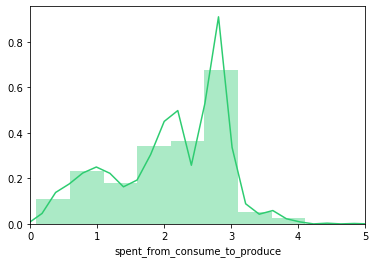
Az értékelő pipeline inferencia idő eloszlása
Következtetések
Összefoglalva, elmondható, hogy az architektúra és a konténerirányítás megközelítése teljes mértékben bevált – még a csúcsidei pillanatokban is nem tapasztaltunk összeomlásokat vagy késlekedéseket a feldolgozási időben.
Úgy gondolom, hogy a kis- és középvállalkozások, amelyek a folyamatuk során valós idejű neurális hálózati inferenciát használnak CPU-n, sikeresen átvehetik az ebben a cikkben leírt gyakorlatokat.
Hozzáteszem, hogy eredetileg a cikk hosszabb volt, de azért, hogy ne posztoljak egy hosszan elnyúló írást, néhány pontot szerettem volna a jelen cikkből kihagyni – visszatérünk ezekhez a jövőbeli publikációk során.
A botot meg lehet próbálni a Telegramon – @AttraiBot, legalább 2020 őszéig működni fog. Emlékeztetem – semmilyen felhasználói adat nem kerül tárolásra – sem a forrásszerkesztett képek, sem az értékelő pipeline eredményei – minden feldolgozás után törlésre kerül.
Forrás: habr.com
