

Ma már létezik 100500 Data Science tanfolyam, és régóta tudjuk, hogy Data Science-ben a legtöbb pénzt a Data Science tanfolyamokkal lehet keresni (minek ásni, ha lapátokat lehet árulni?). Ezeknek a tanfolyamoknak a fő hátránya, hogy semmi közük nincs a valós munkához: senki nem ad tiszta, feldolgozott adatokat a megfelelő formátumban. Amikor befejezed a tanfolyamot és elkezded megoldani a valódi feladatokat, számos árnyalat bukkanna fel.
Ezért elkezdjük a „Mi mehet rosszul a Data Science-szel” című jegyzet sorozatot, amely valós eseményeken alapul, amelyek velem, barátaimmal és kollégáimmal történt. Valós példákon fogjuk elemezni a tipikus Data Science feladatokat: hogy ez valójában hogyan zajlik. Ma a data collection feladattal kezdünk.
Az első, amivel az emberek szembesülnek, amikor valódi adatokkal dolgoznak, az az adott releváns adatok összegyűjtése. Ennek a cikknek a kulcsfontosságú üzenete:
Rendszeresen alábecsüljük az időt, erőforrásokat és energiát az adatok összegyűjtésére, tisztítására és előkészítésére.
És ami a legfontosabb, megvitatjuk, mit tehetünk annak elkerülése érdekében.
Különböző becslések szerint az adatok tisztítása, átalakítása, feldolgozása, feature engineering stb. 80-90% időt vesz igénybe, míg az elemzés 10-20%-ot, miközben a szinte összes tananyag kizárólag az elemzésre összpontosít.
Nézzük meg, hogyan oldható meg egy egyszerű analitikai feladat tipikus példaként három verzióban, és lássuk, milyen "enyhítő körülmények" lehetnek.
Példaként ismét megvizsgáljuk az adatgyűjtés és közösségek összehasonlításának hasonló variációit:
- Két Reddit alréteg
- Két Habr szekció
- Két Osztálytársak csoport
Elméleti megközelítés
Nyisd meg a weboldalt, és olvasd el a példákat, ha érthető, tégy félre néhány órát az olvasásra, néhány órát a példák kódolására és hibakeresésére. Adj hozzá néhány órát az összegyűjtéshez. Szorozd meg ezt kettővel, és adj hozzá N órát.
A kulcsfontosságú pont: az időbecslés feltételezéseken és találgatásokon alapul arról, hogy mennyi időt vesz igénybe.
Az idő elemzését a következő paraméterek becslésével kell kezdeni a fenti feltételezett feladatnál:
- Mekkora az adatok mérete, és mennyit kell fizikailag összegyűjteni (*lásd lent*).
- Mennyi idő szükséges egy felvétel összegyűjtésére, és mennyit kell várni, mielőtt a másodikat lehetne összegyűjteni.
- Mentsd el a kódírást, hogy megőrizze az állapotot, és kezdje újra, amikor (nem ha) minden leáll.
- Ellenőrizd, szükségünk van-e hitelesítésre, és tervezd meg az API-hozzáférés megszerzésének idejét.
- Tervezd meg a hibák számát az adatok összetettsége függvényében — értékeld konkrét feladat alapján: struktúra, hány átalakítás van, mit és hogyan extrahálunk.
- Tervezd meg a hálózati hibákat és a projekt nem szabványos viselkedéséből adódó problémákat.
- Értékeld, hogy a szükséges funkciók szerepelnek-e a dokumentációban, és ha nem, akkor mennyi és hogyan szükséges egy workaroundhoz.
A legfontosabb dolog az időértékelés során — valójában időt és erőfeszítést kell fordítanod a "harci felderítésre" — csak akkor lesz helyes a tervezésed. Tehát bármennyire is nyomnak, hogy "mennyi idő kell az adatok összegyűjtéséhez" — adj magadnak időt az előzetes elemzésre, és érvelj azzal, hogy mennyire fog változni az idő a feladat valós paraméterei alapján.
Most konkrét példákat fogunk bemutatni, ahol az ilyen paraméterek meg fognak változni.
Kulcsfontosságú szempont: az értékelés a munka mennyiségét és összetettségét befolyásoló kulcsfontosságú tényezők elemzésén alapul.
A találgatásokon alapuló értékelés jó megközelítés, amikor a funkcionális elemek elég kicsik, és nem sok tényező van, amely jelentősen befolyásolhatja a feladat struktúráját. De a Data Science egyes feladatainál ezekből a tényezőkből rendkívül sok van, és ez a megközelítés megfelelőtlenné válik.
Reddit közösségek összehasonlítása
Kezdjük a legkönnyebb esettel (mint később kiderül). Ha teljesen őszinték akarunk lenni, előttünk gyakorlatilag egy tökéletes eset áll, ellenőrizzük a komplexitási ellenőrzőlistánkat:
- Van egy rendezett, világos és dokumentált API.
- Rendkívül egyszerű, és legfőképp automatikusan létrejön a token.
- Van — rengeteg példával.
- A Reddit adatgyűjtésre és elemzésre szakosodott közössége (még youtube videók is magyarázzák, hogyan használjunk python wrapper-t) .
- A szükséges módszerek valószínűleg léteznek az API-ban. Sőt, a kód kompakt és tiszta, lent egy példa egy funkcióra, amely a hozzászólásokat gyűjti össze.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Forrás: kényelmes segédprogramok gyűjteménye.
Annak ellenére, hogy itt a legjobb eset áll előttünk, figyelembe kell venni néhány fontos tényezőt a valós életből:
- API-korlátok — a szükséges adatokat kötegekben kell lekérdeznünk (várakozva a kérések között, stb.).
- Adatgyűjtési idő — a teljes elemzéshez és összehasonlításhoz jelentős időt kell szánnunk arra, hogy a pókháló végigjárja a szubreddit-et.
- A botnak a szerveren kell futnia — nem indíthatja el egyszerűen a laptopján, hogy aztán hátizsákba rakja és elmenjen üzleti ügyekhez. Ezért minden VPS-en fut.
- Néhány adat fizikailag elérhetetlen (csak az adminok számára látható vagy túl nehezen gyűjthető) — ezt figyelembe kell venni, nem minden adat gyűjthető össze ésszerű időn belül.
- Hálózati hibák: a hálózattal való munka fájdalmas.
- Ezek élő, valós adatok — sosem tiszták.
Természetesen figyelembe kell venni a megadott szempontokat a fejlesztés során. A konkrét órák/napok tapasztalattól függenek, de látható, hogy ez egy kifejezetten mérnöki feladat, és nem igényel különösebb mozgást a megoldás érdekében — mindent nagyon jól lehet értékelni, kidolgozni és megvalósítani.
Habr szakaszainak összehasonlítása
Térjünk át egy érdekesebb és szokatlanabb esetre, amely a Habr áramlásainak és/vagy szakaszainak összehasonlítására vonatkozik.
Ellenőrizzük a nehézségi ellenőrzőlistánkat — itt, hogy megértsük minden egyes pontot, már kicsit kísérletezni kell a feladattal.
- Először azt hiszi, hogy van API, de nincs. Igen, van API a Habr-nak, de az csak nem elérhető a felhasználók számára (vagy lehet, hogy egyáltalán nem működik).
- Aztán egyszerűen elkezdi a HTML elemzést — „import requests”, mi történhetett rosszul?
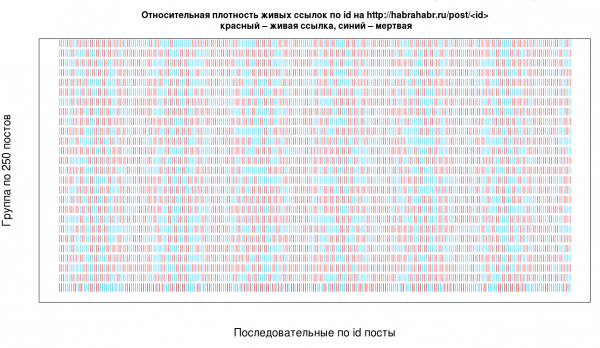
- De hogyan is kell elemezni? A leg egyszerűbb és leggyakrabban használt megközelítés — ID-n való iterálás, megjegyezve, hogy nem a leg hatékonyabb, és különböző eseteket kell kezelni — itt például a valós ID-k sűrűsége a létező összes ID között.

Forrás: cikkek. - A nyers adatok, amelyek HTML-be vannak burkolva a hálózaton, fájdalmasak. Például, ha össze szeretné gyűjteni és tárolni egy cikk értékelését: kitépte a score-t a html-ből, és úgy döntött, hogy számként menti el további feldolgozásra.
1) Az int(score) hibát dob: mivel a Habr-on a mínusz, mint például a "–5" sorban — ez egy rövid gondolatjel, nem mínuszjel (meglepő, ugye?), ezért egy időben fel kellett éleszteni a parsert egy ilyen borzalmas javítással.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
A dátumok, pluszok és mínuszok akár nem is létezhetnek (ahogy azt fent a check_date funkcióból látjuk, ilyen is volt).
2) A nem escaped speciális karakterek — ezek elő fognak jönni, készülni kell rájuk.
3) A struktúra típustól függően változik.
4) A régi posztoknak lehetnek **furcsa struktúráik**.
- Lényegében a hibakezelést és hogy mi történhet, és mi nem, kezelni kell, és nem lehet biztosan megjósolni, mi fog rosszul menni, és milyen további struktúrák vannak, és mi bukhat el — csak próbálkozni kell, és figyelembe kell venni a parsert által dobott hibákat.
- Aztán azt érti meg, hogy párhuzamosan kell parse-olnia, különben egy szálon 30+ órát is el fog venni (ez valójában a már működő, egy szálas parser futási ideje, amely alszik, és nem esik bele semmilyen ban-be). A cikkben ez egy időben ehhez a sémához vezetett:
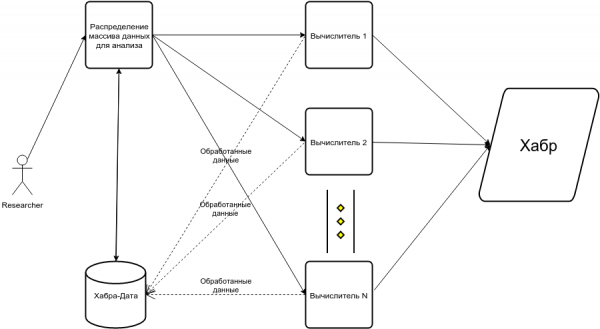
Íme a nehézség checklistája:
- Hálózaton dolgozni és html parse-olni ID-n keresztüli iterációval és ciklussal.
- A dokumentumok heterogén struktúrával rendelkeznek.
- Sok hely, ahol a kód könnyen összeomolhat.
- Kódot kell írni ||.
- Hiányzik a szükséges dokumentáció, kódminták és/vagy közösség.
A feladathoz szükséges idő körülbelül 3-5-ször hosszabb lesz, mint az adatok gyűjtésére a Redditről.
Összehasonlítás az Osztálytársak csoportjával.
Térjünk rá a leírtak közül a legtechnikai szempontból érdekes esetre. Számomra az volt érdekes, hogy első pillantásra elég triviálisnak tűnik, de valójában nem az — amint csak megérinti egy pálcikával.
Kezdjük a nehézségi checklistánkkal, és vegyük észre, hogy sok közülük sokkal nehezebbnek bizonyul, mint amilyennek elsőre tűnik:
- Az API létezik, de majdnem teljesen hiányoznak a szükséges funkciók.
- Bizonyos funkciókhoz e-mailben kell kérni a hozzáférést, tehát a hozzáférés kiadása nem azonnali.
- Rossz dokumentációval rendelkezik (kezdjük azzal, hogy orosz és angol kifejezések keverednek mindenhol, ami abszolút következetlen — néha egyszerűen csak találgatni kell, hogy mit akarnak tőlünk valahol), ráadásul a dizájnja sem alkalmas az adatok megszerzésére, például, .
- A dokumentációban szükséges a munkamenet, de a gyakorlatban nem használja — és nincs mód az API módok összes részletébe belemerülni, csak tapogatni és remélni, hogy valami működni fog.
- Hiányoznak a példák és a közösség, az egyetlen támasz az információgyűjtés során egy kis Pythonban (sok példa nélkül).
- A legjobban működő megoldásnak a Selenium tűnik, mivel sok szükséges adat zár alatt van.
1) Tehát jogosultságok hitelesítése egy fiktív felhasználón keresztül (és kézi regisztráció).2) Azonban a Selenium esetében nincs garancia a helyes és ismételhető működésre (legalábbis az ok.ru esetében bizonyosan).
3) Az ok.ru weboldal JavaScript hibákat tartalmaz, és néha furcsán és következetlenül viselkedik.
4) Foglalkozni kell a lapozással, az elemek betöltésével stb.
5) Az API hibákat, amelyeket a wrapper tartalmaz, ügyesen kell kezelni, például így (kísérleti kód egy darabja):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#mindenképp érdemes nyomon követni a már feldolgozott diskurzusokat
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
A kedvenc hibám a következő volt:
OdnoklassnikiError("Hiba(kód: 'None', leírás: 'HTTP hiba', módszer: 'discussions.getComments', paraméterek: …)")6) Végül a Selenium + API változat tűnik a legracionálisabb megoldásnak.
- Állapot megőrzésére és a rendszer újraindítására van szükség, sok hiba kezelésére, beleértve a weboldal következetlen viselkedését — ráadásul ezek a hibák meglehetősen nehezen elképzelhetők (ha nem ír díszítéseket szakmai szinten, természetesen).
A feladathoz szükséges idő feltételezett becslése 3-5-ször magasabb lesz, mint az adatok gyűjtése a Habról. Annak ellenére, hogy a Habr esetében HTML elemzéssel leplezzük a közvetlen megközelítést, míg az OK esetében kritikus helyeken az API-val dolgozhatunk.
Következtetések
Bárhogy is kérik tőled a "helyszíni" időbecslést (hiszen ma már tervezés zajlik!), a nagyobb adatfeldolgozó modulként az időtartamot szinte soha nem lehet pontosan megítélni a feladatparaméterek elemzése nélkül.
Ha egy kicsit filozofikusabb szempontból nézzük, az agile időbecslési stratégiák jól alkalmazhatók mérnöki feladatokhoz, de a kísérleti és bizonyos értelemben "kreáló" és kutatói feladatokkal, amelyek kevésbé kiszámíthatók, nehézségek adódnak, mint az itt tárgyalt példák esetében.
Természetesen az adatok összegyűjtése csupán egy látványos példa — általában ez a feladat hihetetlenül egyszerűnek és technikailag nem bonyolultnak tűnik, és éppen a részletekben rejtőzik a probléma. Ezen a feladaton keresztül bemutatható a lehetséges variációk teljes spektruma, ami elromolhat, és mennyire elhúzódhat a munka.
Ha gyorsan átfutunk a feladat jellemzőin további kísérletek nélkül, akkor a Reddit és az OK hasonlónak tűnik: van API, Python wrapper, de lényegében hatalmas a különbség. Ha ezek alapján ítéljük meg, akkor a Habr parsing nehezebbnek tűnik, mint az OK — a gyakorlatban viszont éppen ellenkezőleg, és ezt egyszerű kísérletekkel lehet kideríteni a feladatparaméterek elemzésére.
Személyes tapasztalataim szerint a legjobban működő megközelítés a becsült idő, amelyre szükség van a kezdeti elemzéshez és az első egyszerű kísérletekhez, a dokumentáció olvasásához — ezek biztosítják a pontos becslést az egész munkára. Az elterjedt agile módszertan szempontjából kérlek, hozz létre egy jegyet az "útközbeni paraméterek értékeléséhez", amely alapján meg tudom mondani, hogy mi lehetséges a "sprintek" keretein belül, és pontosabb becslést adhatok minden feladatra.
Ezért a legjobbnak tűnő érvet a "nem technikai" szakemberek számára az mutatja meg, hogy mennyire változhat az idő és az erőforrások a még értékelésre váró paraméterek függvényében.
Forrás: habr.com
