

Az SQL-ben azt írja le, hogy mit szeretne kapni, nem azt, hogyan kellene végrehajtani. Ezért az SQL lekérdezések «ahogyan hallatszik, úgy írják» stílusának fejlesztési problémája a maga módján kellően jelentős helyet foglal el .
Ma nagyon egyszerű példákon keresztül nézzük meg, hogy ez hova vezethet az GROUP/DISTINCT és LIMIT használatával.
Ha tehát azt írta a lekérdezésbe, hogy „először csatlakoztassa ezeket a táblázatokat, majd dobja ki az összes duplikáltat, csak egy példány kell maradjon minden kulcsra” - pontosan így fog működni, még akkor is, ha az összekötés nem volt szükséges.
Néha szerencsésen «egyszerűen működik», máskor kellemetlen hatással van a teljesítményre, és néha teljesen váratlan következményekkel jár a fejlesztők számára.
Nos, talán nem annyira látványosak, de...
„Édes pár”: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Világos, hogy mit akartunk kiválasztani az X olyan rekordjait, amelyekhez kapcsolódik valamilyen a Y-ban teljesülő feltétel.A lekérdezés elkészítése után JOIN - kaptunk néhány pk értéket többször (pontosan annyiszor, ahány megfelelő Y rekord volt). Hogyan lehet eltávolítani? Természetesen DISTINCT!
Különösen „örömteli”, amikor minden X rekordhoz több száz kapcsolódó Y rekord található, majd hősiesen eltávolítják a duplikáltakat...
Hogyan lehet kijavítani? Először is fel kell ismerni, hogy a feladatot át lehet formálni „kiválasztani az X olyan rekordjait, amelyekhez a Y-ban VAN legalább EGY kapcsolódó, teljesülő feltétel” - hiszen a Y rekordból nekünk semmi sem szükséges.
Beágyazott EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Néhány PostgreSQL verzió megérti, hogy az EXISTS-hez elegendő megtalálni az első megfelelő rekordot, régebbi verziók nem. Ezért inkább mindig megadom LIMIT 1 bent VÉGE;.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Ez a megoldás lehetővé teszi, hogy szükség esetén azonnal visszakapjunk néhány adatot is a megtalált kapcsolódó Y rekordból. Hasonló megoldást tárgyalunk a cikkben .
„Miért fizessünk többet”: DISTINCT [ON] + LIMIT 1
A további előnye ennek a kérésnek a megváltoztatásának az, hogy könnyedén korlátozhatjuk a rekordok átvizsgálását, ha csak egy/két szükséges, mint az alábbi esetben:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Most olvassuk a lekérdezést, és próbáljuk megérteni, mit javasol az adatbázis-kezelő rendszer:
- összekapcsoljuk a táblákat
- egyesítjük X.pk szerint
- az maradék rekordok közül kiválasztunk egyet
Tehát mit kaptunk? Egy "valamilyen" rekordot az egyesített rekordokból — és ha ezt az egyet a nem egyesítettekből vesszük, vajon változik az eredmény?.. "Ha nincs különbség, miért kell többet fizetni?"
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- ide illeszthetjük a megfelelő feltételeket
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Ugyanez a téma a GROUP BY + LIMIT 1.
"Csak kérdezni szeretnék": implicit GROUP + LIMIT
Az ilyen dolgok változó üres ellenőrzések során a táblázat vagy CTE végrehajtásakor:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Aggregáló függvények (count/min/max/sum/...) sikeresen végrehajthatók az összes adaton, még explicit megadás nélkül is A rekurzív „táblázás” nem található egy beágyazott lekérdezésben.. Csak az a helyzet, hogy LIMIT nem igazán barátkozik velük.
A fejlesztő azt gondolhatja, "ha vannak feljegyzések, akkor nekem nem kell több mint LIMIT". De ne csináld ezt! Mert az adatbázis számára ez:
- számold meg, mit akarnak az összes rekord alapján
- add vissza annyi sort, amennyit kérnek
A célnak megfelelően itt érdemes egyet cserélni:
(count + LIMIT 1) = 0Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használataNOT EXISTS(LIMIT 1)(count + LIMIT 1) > 0Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használataEXISTS(LIMIT 1)count >= NGyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata(SELECT count(*) FROM (... LIMIT N))
"Mennyi a grammban": DISTINCT + LIMIT
SELECT DISTINCT
  pk
FROM
  X
LIMIT $1
Egy naiv fejlesztő őszintén azt gondolhatja, hogy a kérés végrehajtása leáll, amint megtaláljuk az első $1 eltérő értéket.
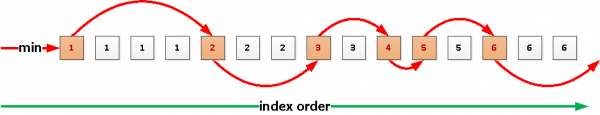
A jövőben ez talán valóban működni fog egy új csomópont miatt Index Skip Scan, amelynek megvalósítása jelenleg folyamatban van, de eddig — nem.
Jelenleg először minden egyes rekordot ki fognak vonni,, egyesítik, és csak azután tér vissza, amennyit kértek. Különösen szomorú lehet, ha valami ilyesmire vágytunk, $1 = 4, és a táblázatban — számos ezer rekord van...
A felesleges szomorúság elkerülése érdekében használjunk rekurzív lekérdezést :
Forrás: habr.com
