

Helló, Habr! Jelenleg az OTUS új kurzusára jelentkezést hirdetünk. . A kurzus kezdetére hagyományosan egy érdekes anyag fordítását készítettük el számotokra.
Minden nap több mint százmillió ember látogat el a Twitterre, hogy megtudja, mi történik a világban, és megbeszélje azt. Minden egyes tweet és egyéb felhasználói tevékenység eseményt generál, amely elérhető a Twitter belső adatainak elemzésére. Számtalan alkalmazott elemzi és vizualizálja ezeket az adatokat, és az ő tapasztalataik javítása kiemelt prioritás a Twitter Adatplatform csapata számára.
Azt gondoljuk, hogy a széleskörű műszaki háttérrel rendelkező felhasználóknak lehetőséget kell biztosítani az adatok keresésére és a jól működő SQL-alapú elemző és vizualizáló eszközökhez való hozzáférésre. Ez lehetővé tenné egy új felhasználói csoport, például az adatkutatók és a termékmenedzserek számára, hogy információt nyerjenek az adatokból, jobban megértsék és kihasználják a Twitter lehetőségeit. Így demokratizáljuk az adatkezelést a Twitteren.
Ahogy tökéletesítjük eszközeinket és belső adatelemző kapacitásainkat, tapasztalataik javulását látjuk a Twitter szolgáltatásain. Mindazonáltal még van hova fejlődni. A jelenlegi eszközök, mint a Scalding, programozói tapasztalatot igényelnek. Az SQL-alapú elemző eszközök, mint a Presto és Vertica, teljesítményproblémákkal küzdenek nagyméretű használat során. Továbbá, gondunk van az adatok több rendszer közötti átvitelével anélkül, hogy folyamatos hozzáféréssel rendelkeznének.
Tavaly bejelentettük , amelynek keretében adataink egyes részeit segíthetnek nekünk az adatelemzés, vizualizáció és gépi tanulás demokratizálásában a Twitteren: : egy SQL-alapú vállalati adattároló, amely a
- Dremel gépi tanulást. .
- инструмент для визуализации больших данных с функциями совместной работы, как в Google Docs.
A cikkből megtudhatja tapasztalatainkat ezekkel az eszközökkel: mit tettünk, mit tanultunk, és mit fogunk tenni a jövőben. Jelenleg a csomagolt és interaktív elemzésre összpontosítunk. Az valós idejű elemzést a következő cikkben fogjuk megvitatni.
A Twitter adatbázisának története
Mielőtt mélyebben belemerülnénk a BigQuery-be, érdemes röviden áttekinteni a Twitter adatbázisának történetét. 2011-ben a Twitterben a Vertica és a Hadoop segítségével végeztek adatelemzést. A Hadoop MapReduce létrehozásához Pigt használtunk. 2012-ben a Pigt Scaldingra cseréltük, amely Scala API-t tartalmazott olyan előnyökkel, mint a bonyolult csővezetékek létrehozása és a tesztelés egyszerűsége. Azonban sok adat-analitikus és termékmenedzser számára, akik számára a SQL kényelmesebb volt, a tanulási görbe elég meredek volt. Körülbelül 2016 körül kezdtük el használni a Presto-t SQL interfészként a Hadoop adatokhoz. A Spark Python interfészt kínált, amely jó választás a helyszíni adatkutatásokhoz és gépi tanuláshoz.
2018-tól kezdve az alábbi eszközöket használtuk az adatok elemzésére és vizualizálására:
- Scalding a termelési csővezetékekhez
- Scalding és Spark az ad hoc adatkutatáshoz és gépi tanuláshoz
- Vertica és Presto ad hoc és interaktív SQL elemzéshez
- Druid kis interaktív, kutatási és alacsony késleltetésű hozzáféréshez az időbeli metrikákhoz
- Tableau, Zeppelin és Pivot az adatok vizualizálásához
Feltártuk, hogy bár ezek az eszközök nagyon erőteljes lehetőségeket kínálnak, nehézségeink voltak ezen lehetőségek hozzáférhetőségének megvalósításában a Twitter szélesebb közönsége számára. A Google Cloud segítségével bővítve platformunkat a célunk az analitikai eszközök egyszerűsítése az egész Twitter számára.
A Google BigQuery adatbázisa
Több csapat a Twitteren már integrálta a BigQueryt néhány gyártási munkafolyamatába. Tapasztalataik felhasználásával elkezdtük értékelni a BigQuery lehetőségeit a Twitter összes felhasználási forgatókönyvéhez. Célunk az volt, hogy a BigQueryt az egész cég számára elérhetővé tegyük, valamint standardizáljuk és támogassuk az adatplatform eszközkészletén belül. Ez sok okból nehézkes volt. Infrastruktúrát kellett kidolgoznunk a nagy mennyiségű adatok megbízható fogadására, az adatok kezelésére a vállalat szintjén, a megfelelő hozzáférés-ellenőrzés biztosítására és az ügyféladatok védelmére. Emellett rendszereket kellett létrehoznunk az erőforrások elosztására, a nyomon követésre és a visszatérítések kezelésére, hogy a csapatok hatékonyan tudják használni a BigQueryt.
2018 novemberében kiadtuk a BigQuery és a Data Studio alfa verzióját az egész cég számára. Ajánlottuk a Twitter alkalmazottainak néhány kivágott személyes adatokkal dolgozó leggyakrabban használt táblánkat. A BigQueryt több mint 250 felhasználó használta különböző csapatokból, beleértve a mérnöki, pénzügyi és marketingcsoportokat. Legutóbb körülbelül 8000 lekérdezést futtattak, havi 100 PB adatfeldolgozással (a tervezett lekérdezéseket nem számítva). Miután nagyon pozitív visszajelzéseket kaptunk, úgy döntöttünk, hogy előrelépünk, és a BigQueryt a Twitterben az adatokkal való interakció fő forrásaként ajánljuk.
Itt látható a Google BigQuery adat-lerakatunk magas szintű architektúrája.
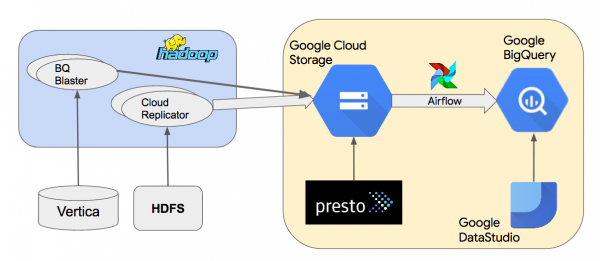
A Hadoop helyi klasztereiből a Google Cloud Storage-ba (GCS) másoljuk az adatokat egy belső Cloud Replicator eszköz segítségével. Ezután az Apache Airflow-t használjuk csővezetékek létrehozására, amelyek használják a „” parancsot az adatok GCS-ből a BigQuery-ba való betöltésére. A Presto-t használjuk a Parquet vagy Thrift-LZO adathalmazok lekérdezésére a GCS-ben. A BQ Blaster egy belső Scalding eszköz a Vertica és Thrift-LZO HDFS adathalmazok BigQuery-ba való betöltésére.
A következő szakaszokban megvitatjuk megközelítésünket és ismereteinket a használhatóságról, a teljesítményről, az adatkezelésről, a rendszer működőképességéről és a költségekről.
Használhatóság
Felfedeztük, hogy a felhasználók számára könnyű volt kezdeni a BigQuery használatát, mivel nem igényelt szoftvertelepítést, és a felhasználók egy intuitív webes felületen keresztül érhették el. Ennek ellenére a felhasználóknak meg kellett ismerniük a GCP egyes funkcióit és azok koncepcióit, beleértve olyan erőforrásokat, mint a projektek, adatállományok és táblák. Képzési anyagokat és útmutatókat dolgoztunk ki, hogy segítsük a felhasználókat a kezdésben. Az alapvető ismeretek megszerzése után a felhasználók számára könnyű volt navigálni az adatállományok között, megtekinteni a táblák sémáját és adatait, egyszerű lekérdezéseket végrehajtani, valamint vizualizálni az eredményeket a Data Studio-ban.
Célunk a BigQuery-adatok betöltésével kapcsolatban az volt, hogy lehetővé tegyük az HDFS vagy GCS adatállományok zökkenőmentes, egy kattintással történő betöltését. Megfontoltuk (kezelhető Airflow), de nem tudtuk használni a Domain Restricted Sharing biztonsági modellünk miatt (erről további információk a 'Adatkezelés' részben találhatók). Kipróbáltuk a Google Data Transfer Service (DTS) használatát a BigQuery teherfeladatainak kezelésére. Míg a DTS gyorsan beállítható volt, nem volt rugalmas az összefüggő csővezetékek létrehozásához. Az alfa verziónkhoz saját Apache Airflow környezetet hoztunk létre a GCE-n, és készítjük elő a termelési üzemeltetésre, hogy több adatforrást támogathasson, például a Vertica-t.
Az adatok BigQuery-be történő átalakításához a felhasználók egyszerű SQL adatcsővezetékeket hoznak létre ütemezett lekérdezések segítségével. A bonyolult, több lépcsős, összefüggő csővezetékekhez tervezzük, hogy vagy a saját Airflow infrastruktúránkat, vagy a Cloud Composer-t használjuk együtt a .
Teljesítmény
A BigQuery a nagyméretű adatok feldolgozására szolgáló általános célú SQL lekérdezésekhez készült. Nem alkalmas alacsony késleltetésű, nagy átviteli sebességet igénylő lekérdezésekhez, amelyek tranzakciós adatbázisra, vagy alacsony késleltetésű idősor-analízishez szükségesek, amelyet . Az interaktív analitikai lekérdezések esetében felhasználóink kevesebb mint egy perces válaszidőt várnak el. A BigQuery használatát úgy kellett megterveznünk, hogy megfeleljen ezeknek az elvárásoknak. A felhasználói előre jelezhető teljesítmény biztosítása érdekében a BigQuery rögzített díjas funkcióját használtuk, amely lehetővé teszi a projekt tulajdonosai számára, hogy minimális slotokat foglaljanak a lekérdezésekhez. A BigQuery az a számítási teljesítmény egysége, amely szükséges SQL lekérdezések végrehajtásához.
Több mint 800 lekérdezést elemeztünk, amelyek mindegyike körülbelül 1 TB adatot dolgoz fel, és megállapítottuk, hogy az átlagos végrehajtási idő 30 másodperc volt. Azt is felfedeztük, hogy a teljesítmény nagymértékben függ a slotok különböző projektekben és feladatokban való felhasználásának módjától. Világosan el kellett választanunk a termelési és ad hoc slot foglalásokat, hogy fenntartsuk a teljesítményt a termelési felhasználási esetek és az interaktív elemzés során. Ez jelentős hatással volt a slot foglalási és projekt hierarchiai tervezésünkre.
Az adatkezelés, funkcionalitás és a rendszerek költségeiről a közeljövőben a fordítás második részében fogunk beszélni, most pedig mindenkit szeretettel várunk a , ahol részletes információkat kaphat a tanfolyamról, és kérdéseket tehet fel szakértőnknek, Egor Matysuk-nak (Senior Data Engineer, MaximaTelecom).
Tovább olvasva:
Forrás: habr.com
