

Kezdetben volt egy technológia, és BPF-nak hívták. Megvizsgáltuk ezt , a ciklusunk ókori írásában. 2013-ban, Алексей Старовойтов (Alexei Starovoitov) és Даниэль Боркман (Daniel Borkman) munkájával elkészült és beillesztésre került a Linux kernelbe a modern 64 bites gépekre optimalizált továbbfejlesztett verziója. Ezt az új technológiát egy rövid ideig Internal BPF-nek hívták, majd később Extended BPF-re keresztelték, és most, néhány év elteltével, egyszerűen BPF-nak nevezik.
Egyszerűen fogalmazva, a BPF lehetővé teszi a felhasználói által biztosított kód végrehajtását a Linux kernel térben, és az új architektúra annyira sikeresnek bizonyult, hogy legalább egy tucat cikkre lesz szükség ahhoz, hogy leírjuk minden alkalmazását. (Az egyetlen dolog, amivel a fejlesztők nem boldogultak, ahogy a lenti kpv-t is láthatjátok, az egy megfelelő logó létrehozása volt.)
Ebben a cikkben a BPF virtuális gép szerkezetét, a BPF-fel való munkához szükséges kernel interfészeket, a fejlesztési eszközöket, valamint egy rövid, nagyon rövid áttekintést adunk a meglévő lehetőségekről, azaz mindenről, amire a jövőben szükségünk lesz a BPF gyakorlati alkalmazásainak mélyebb tanulmányozásához.
A cikk tartalma
Kezdetben szempontjából, madártávlatból tekinthetünk az BPF architektúrájára, és kijelölhetjük a főbb komponenseket.
Miután már van némi elképzelésünk az architektúráról, bemutatjuk a BPF virtuális gép szerkezetét.
Ebben a részben közelebbről megvizsgáljuk a BPF objektumok életciklusát – programokat és mapokat.
Már van némi elképzelésünk a rendszerről, végre megnézzük, hogyan lehet létrehozni és kezelni az objektumokat felhasználói térből a speciális rendszerhívás segítségével – bpf(2).
A programok írása a rendszerhívások segítségével természetesen lehetséges. De nehéz. A kernel fejlesztői egy könyvtárat hoztak létre, libbpf. Készítünk egy egyszerű BPF alkalmazásvázat, amelyet későbbi példákban fogunk használni.
Itt megtudhatjuk, hogyan tudnak a BPF programok hozzáférni a kernel segédfunkcióihoz — olyan eszköz, amely a map-ekkel együtt alapvetően kibővíti az új BPF képességeit a klasszikushoz képest.
E pillanatra elegendő tudással fogunk rendelkezni ahhoz, hogy megértsük, miként állíthatunk elő programokat, amelyek map-eket használnak. Ráadásul egy pillantást vetünk a nagyszerű és hatalmas verifier-re.
Referenciaként szolgáló rész arról, hogyan kell összegyűjteni a szükséges segédprogramokat és a kernelt a kísérletekhez.
A cikk végén azok, akik eljutnak ide, motiváló szavakat és rövid összefoglalót találnak arról, hogy mi lesz a következő cikkekben. Emellett néhány linket is felsorolunk az önálló tanulás számára, azoknak, akiknek nincs kedvük vagy lehetőségük várni a folytatásra.
Bevezetés a BPF architektúrába
Mielőtt nekilátnánk a BPF architektúra tárgyalásának, utoljára (vagy talán nem is) hivatkozunk a , amelyet a RISC gépek megjelenésére válaszul fejlesztettek ki, és amely a csomagok hatékony szűrésének problémáját oldotta meg. Az architektúra olyan sikeres lett, hogy a kilencvenes évek zűrös időszakában a Berkeley UNIX-ban született, majd a legtöbb létező operációs rendszerre átportolták, túlélt a különc húszas évekig, és még mindig új alkalmazási területeket talál.
Az új BPF-ot a 64 bites gépek, felhőszolgáltatások elterjedése és a SDN eszközök iránti megnövekedett igény válaszaként fejlesztették ki (Sszoftver-ddefiniált nhálózat). A kernel hálózati mérnökei által a klasszikus BPF fejlett helyettesítéseként kifejlesztett új BPF mindössze fél év alatt hasznos alkalmazásokban is megtalálta a génekeit, és most, hat évvel a megjelenése után, egy újabb cikkre lesz szükségünk csak a különböző programtípusok felsorolásához.
Vicces Képek
Alapvetően a BPF egy virtuális homokozó gép, amely lehetővé teszi "tetszőleges" kód futtatását a kernel térben anélkül, hogy a biztonság kárát látná. A BPF programok felhasználói térben készülnek, betöltődnek a kernelbe, és csatlakoznak valamilyen eseményforráshoz. Esemény lehet például egy csomag kézbesítése a hálózati interfészre, egy kernel funkció elindítása stb. Csomag esetén a BPF program számára elérhetők lesznek a csomag adatai és metaadatai (olvasható és esetleg írható, a program típusától függően), kernel funkció indítása esetén pedig a funkció argumentumai, beleértve a kernel memória mutatókat is.
Nézzük meg ezt a folyamatot részletesebben. Először is említsük meg az első különbséget a klasszikus BPF-hez képest, amelynél a programokat assembly nyelven írták. Az új verzióban az architektúra kiegészült, így a programok magas szintű nyelveken is írhatók lettek, elsősorban természetesen C nyelven. Ehhez kifejlesztettek egy llvm hátsót, amely lehetővé teszi a BPF architektúrához tartozó bájt-kód generálását.
A BPF architektúrát részben azért fejlesztették ki, hogy hatékonyan működjön a modern gépeken. Ahhoz, hogy ez a gyakorlatban működjön, a BPF bájt-kód, miután betöltötték a kernelbe, egy JIT compiler nevű komponens segítségével natív kódra lesz fordítva (Just In Time). Továbbá, ha emlékszik, a klasszikus BPF esetében a program atomikusan töltődött be a kernelbe és csatlakozott az eseményforráshoz – egy rendszerhívás kontextusában. Az új architektúrában ez két lépésben történik – először a kódot egy rendszerhívás segítségével betöltik a kernelbe, bpf(2), majd később, más mechanizmusok segítségével, a program típusától függően, csatlakozik (attaches) az eseményforráshoz.
Itt a olvasóban felmerülhet a kérdés: Hogyan lehetséges ez? Hogyan biztosítják a végrehajtott kód biztonságát? A BPF programok betöltésének szakasza biztosítja a végrehajtás biztonságát, ezt a szakaszt ellenőrzőnek (angolul verifier) hívják, és a következő szakaszban ezen angol kifejezést fogom használni:
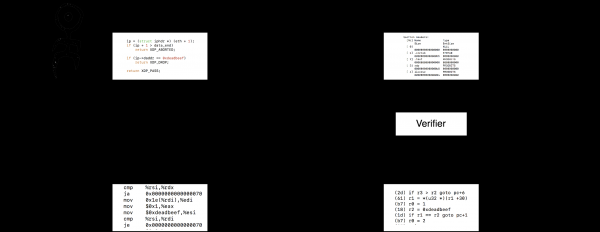
A Verifier egy statikus elemző, amely garantálja, hogy a program nem zavarja meg a kernel normál működését. Ez azonban nem jelenti azt, hogy a program nem avatkozhat be a rendszer működésébe — a BPF programok típustól függően olvashatják és módosíthatják a kernel memória területeit, visszatérési értékeket, szűrhetik, kiegészíthetik, módosíthatják és akár át is küldhetik a hálózati csomagokat. A Verifier garantálja, hogy a BPF program futtatása alatt a kernel nem fog összeomlani, és hogy a program, amelynek írási hozzáférése van bizonyos adatokhoz, például a kimenő csomagok adataihoz, nem tudja módosítani a kernel memóriáját a csomagon kívül. A Verifierre részletesebben a megfelelő szakaszban fogunk rátérni, miután megismerjük a BPF többi komponensét.
Tehát, mit tudtunk meg eddig? A felhasználó C nyelven ír egy programot, és azt a rendszerhívás segítségével betölti a kernelbe bpf(2), ahol az átesik a Verifier ellenőrzésén, és natív bájtcode-dá fordítják. Ezután ugyanaz a felhasználó vagy egy másik felhasználó csatlakoztatja a programot az eseményforráshoz, és az elkezd futni. A betöltés és a csatlakozás szétválasztása több okból is szükséges. Először is, a Verifier futtatása viszonylag költséges, és ha ugyanazt a programot többször töltjük be, akkor fölöslegesen pazaroljuk a számítógép időt. Másodszor, hogy a program hogyan csatlakozik, az típusától függ, és egy olyan „univerzális” interfész, amelyet egy éve fejlesztettek, talán nem használható az új programtípusokhoz. (Bár most, hogy az architektúra érettebbé válik, felmerült az ötlet, hogy ezt az interfészt egységesítsük a szinten) libbpf.)
A figyelmes olvasó észreveheti, hogy még nem fejeztük be a képek kérdését. Valóban, az eddig elmondottak nem magyarázzák meg, hogyan változtatja meg a BPF lényegesen a képet a klasszikus BPF-hez képest. Két újítás jelentősen kibővíti a felhasználási lehetőségek határait: a megosztott memória használatának lehetősége és a kernel segédprogramok (kernel helpers). A BPF-ben a megosztott memória a úgynevezett maps — megosztott adatszerkezetek — API-val valósul meg. A nevét valószínűleg abból kapta, hogy az első megjelent map típus egy hash-tábla volt. Ezt követték a tömbök, helyi (per-CPU) hash-táblák és helyi tömbök, keresőfák, BPF programokra mutató mapok és sok más. Jelenleg számunkra az a tény érdekes, hogy a BPF programok lehetőséget kaptak az állapot megőrzésére a hívások között, és ennek megosztására más programokkal és a felhasználói térrel.
A maps-hoz való hozzáférés a felhasználói folyamatokból a rendszerhívással történik bpf(2), míg a kernelben futó BPF programokból segédprogramok segítségével. Sőt, a helpers nemcsak a maps kezelésére léteznek, hanem a kernel egyéb lehetőségeihez való hozzáférésre is. Például a BPF programok segédprogramokat használhatnak csomagok más interfészekre való átirányítására, a perf alrendszer eseményeinek generálására, a kernel struktúráihoz való hozzáférésre stb.
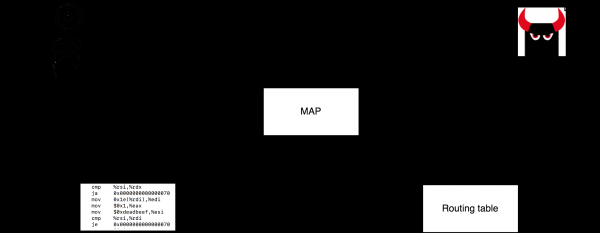
Összességében a BPF lehetőséget biztosít felhasználói, azaz a verifier által ellenőrzött kód betöltésére a kernel térbe. Ez a kód megőrzi az állapotot a hívások között, adatokat cserélhet a felhasználói térrel, valamint hozzáférhet a megengedett alrendszerekhez, amelyeknek ez a programtípus megfelelő.
Ez már hasonlít a magmodulok által nyújtott lehetőségekre, amelyekkel szemben a BPF-nek vannak bizonyos előnyei (természetesen csak hasonló alkalmazások összehasonlítására vonatkozik, például a rendszer nyomkövetésére - nem lehet tetszőleges illesztőprogramot írni a BPF segítségével). Érdemes megemlíteni az alacsonyabb belépési küszöböt (néhány BPF-t használó segédprogram nem igényli a felhasználótól a magprogramozási készségeket, sőt a programozási készségeket általában), a futási idő biztonságát (emelje fel a kezét a megjegyzések között, aki nem törte el a rendszert modulok írásakor vagy tesztelésekor), atomaritást - a modulok újraindításával járó leállási időket, míg a BPF alrendszer garantálja, hogy egy esemény sem marad ki (igazságosságból mondva, ez nem minden BPF programtípusra érvényes).
Ezeknek a lehetőségeknek a megléte teszi a BPF-et univerzális eszközzé a kernel kiterjesztésére, amit a gyakorlat is igazol: egyre több új programtípus kerül bevezetésre a BPF-be, egyre több nagyvállalat használja a BPF-et éles szervereken 24×7, és egyre több startup épít üzletet BPF-alapú megoldásokra. A BPF mindenhol használatban van: DDoS támadások védelmében, SDN létrehozásában (például Kubernetes hálózatok megvalósítása), rendszer nyomkövetésének és statisztika gyűjtésének fő eszközeként, behatolás-észlelő rendszerekben és homokozó rendszerekben stb.
Zárjuk le a cikk áttekintő részét, és nézzük meg részletesebben a virtuális gépet és a BPF ökoszisztémát.
Eltérés: segédprogramok
Ahhoz, hogy lehetőségünk legyen a következő szakaszok példáit futtatni, szükség lehet bizonyos segédprogramokra, minimum llvm/clang bpf támogatással és bpftool. A szakaszban olvashatók a segédprogramok és saját magkernel felépítésének utasításai. Ezt a szakaszt alább helyeztük el, hogy ne zavarja a kifejtett érvet.
A BPF virtuális gépének regiszterei és utasításrendszere
A BPF architektúrá és utasításkészlet úgy lett megtervezve, hogy a programokat C nyelven írták, és a kernelbe való betöltés után natív kódra fordítsák őket. Ennek megfelelően a regiszterek száma és az utasítások sokfélesége a modern gépek lehetőségeinek matematikai mérlegelésével történt. Ezen kívül a programokra különféle korlátozások is vonatkoztak, például eddig nem volt lehetőség ciklusok és alprogramok írására, és az utasítások száma 4096-ra volt korlátozva (jelenleg a kiváltságos programok akár egymillió utasítást is betölthetnek).
A BPF-ben tizenegy, a felhasználó számára elérhető 64-bites regiszter áll rendelkezésre. r0—r10 és a programszámláló (program counter). A regiszter r10 tartalmazza a verem mutatóját (frame pointer), és csak olvasható. A programok végrehajtása során egy 512 bájtos verem és korlátlan mennyiségű megosztott memória (maps) áll rendelkezésre.
A BPF programok számára engedélyezett egy, a program típusa szerint definiált segédfunkciók (kernel helpers) meghívása, és most már szokványos funkciók is. Minden meghívott funkció legfeljebb öt argumentumot fogadhat el, amelyek regiszterekben kerülnek átvitelre. r1—r5, az érték, amit visszaadnak, pedig átkerül a r0. Garantált, hogy a funkcióból való visszatérés után a r6—r9 regiszterek tartalma nem változik.
A programok hatékony lefordítása érdekében a r0—r11 minden támogatott architektúrához egyértelműen hozzárendelődik a valódi regiszterekhez, figyelembe véve az aktuális architektúra ABI-jának sajátosságait. Például a x86_64 regiszterek, r1—r5amelyek a funkciók paraméterei átadására szolgálnak, a következőre vannak hozzárendelve: rdi, rsi, rdx, rcx, r8, amelyek a paraméterek átadására szolgálnak funkciókban a x86_64. Például, a bal oldali kód a következőképpen van lefordítva a jobb oldali kódra:
1:  (b7) r1 = 1                    mov    $0x1,%rdi
2:  (b7) r2 = 2                    mov    $0x2,%rsi
3:  (b7) r3 = 3                    mov    $0x3,%rdx
4:  (b7) r4 = 4                    mov    $0x4,%rcx
5:  (b7) r5 = 5                    mov    $0x5,%r8
6:  (85) call pc+1                 callq  0x0000000000001ee8
A regiszter r0 szintén a program végrehajtásának eredményét visszaadó regiszter, míg a regiszterben r1 a program számára egy kontextusra mutató mutató kerül átadásra — a program típusától függően ez például lehet a következő struktúra: (a XDP-hez) vagy a következő struktúra: (különböző hálózati programokhoz) vagy a következő struktúra: (különböző típusú tracing programokhoz) és így tovább.
Tehát volt egy készlet regiszterekből, kernel segédprogramokból, veremből, kontextusmutatóból és megosztott memóriából maps formájában. Nem igazán volt szükség mindezekre az utazás során, de…
Folytassuk a leírást, és beszéljünk az ezzel a tárgyakkal kapcsolatos parancsok rendszerről. Minden () BPF utasítás rögzített 64 bites mérettel rendelkezik. Ha megnézel egy utasítást egy 64 bites Big Endian gépen, akkor látni fogod

Itt Code — ez az utasítás kódolása, Dst/Src — ezek a cél- és forráskódolások, a megfelelőek, Ki — egy 16 bites aláírt eltolás, és Imm — ez egy 32 bites aláírt egész szám, amelyet egyes utasításokban használnak (hasoló a cBPF K konstansához). A kódolás Code kétféle lehet:
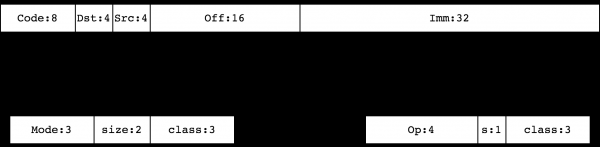
A 0, 1, 2, 3 típusú utasítások osztályai meghatározzák a memóriával végzett műveleteket. Ezeket , BPF_LD, BPF_LDX, BPF_ST, BPF_STX, megfelelően. A 4, 7 osztályok (BPF_ALU, BPF_ALU64) alkotják az ALU utasítások halmazát. Az 5, 6 osztályok (BPF_JMP, BPF_JMP32) tartalmazzák az ugrási utasításokat.
A BPF utasítások rendszerének további tanulmányozási terve a következő: ahelyett, hogy alaposan felsorolnánk minden utasítást és azok paramétereit, nézzünk meg néhány példát ebben a részben, és világossá válik, hogyan működnek az utasítások valójában, és hogyan disszemblálhatunk manuálisan bármelyik BPF bináris fájlt. Az anyag megerősítése érdekében a cikk későbbi részeiben még találkozunk egyedi utasításokkal a Verifier, a JIT fordító, a klasszikus BPF fordításának, valamint a maps, a függvények hívásának és hasonlóknak a tanulmányozásánál.
Amikor az egyedi utasításokról beszélünk, a következő kernel fájlokra fogunk hivatkozni: és , ahol a BPF utasítások numerikus kódjai kerülnek meghatározásra. A birtokos bármely architektúra és/vagy bináris fájlok tanulmányozása során a szemantikai információkat a következő forrásokban találhatja meg, bonyolultság szerint rendezve: , , és természetesen a Linux forráskódokban — verifikátor, JIT, BPF értelmező.
Példa: BPF disszemblálása mentálisan
Nézzünk meg egy példát, amelyben lefordítunk egy programot: readelf-example.c és megnézzük a keletkezett binárist. Az alábbiakban felfedjük az eredeti tartalmát, miután helyreállítottuk logikáját a bináris kódokból: readelf-example.c $ clang -target bpf -c readelf-example.c -o readelf-example.o -O2 $ llvm-readelf -x .text readelf-example.o Hex dump of section '.text': 0x00000000 b7000000 01000000 15010100 00000000 ................ 0x00000010 b7000000 02000000 95000000 00000000 ................
$ clang -target bpf -c readelf-example.c -o readelf-example.o -O2
$ llvm-readelf -x .text readelf-example.o
Hex dump of section '.text':
0x00000000 b7000000 01000000 15010100 00000000 ................
0x00000010 b7000000 02000000 95000000 00000000 ................
Az első oszlop a kimenetben readelf — ez a behúzás, és a programunk így négy parancsból áll:
Code Dst Src Off  Imm
b7   0   0   0000 01000000
15   0   1   0100 00000000
b7   0   0   0000 02000000
95   0   0   0000 00000000
A parancskódok megegyeznek b7, 15, b7 és 95. Emlékezzünk arra, hogy a három legkisebb bit az utasítás osztálya. Esetünkben a negyedik bit minden utasítás esetén üres, így a parancsok osztályai egyenlőek, tehát 7, 5, 7, 5. A 7-es osztály a BPF_ALU64, míg az 5-ös a BPF_JMP. Mindkét osztály formátuma azonos (lásd fent), és átírhatjuk a programunkat így (egyúttal az összes többi oszlopot is emberi olvasható formára):
Op S  Class   Dst Src Off  Imm
b  0  ALU64   0   0   0    1
1  0  JMP     0   1   1    0
b  0  ALU64   0   0   0    2
9  0  JMP     0   0   0    0
Művelet b kapcsolat és csatornák ALU64 — ez . Ez az értéket hozzárendeli a célregiszterhez. Ha a bit s (forrás) be van állítva, az értéket a forrásregiszterből vesszük, ha pedig, mint esetünkben, nincs beállítva, akkor az érték a mezőből Imm. Így az első és harmadik utasításban végrehajtjuk a műveletet r0 = Imm. Továbbá, az 1-es osztályú JMP művelet — ez (ugrás egyenlőség esetén). Esetünkben, mivel a bit S nulla, az összehasonlítás a forrásregiszter értékét a mezővel végzi Imm. Ha az értékek megegyeznek, az ugrás a PC + Off, ahol PC, ahogy megszokott, tartalmazza a következő utasítás címét. Végül a 9-es osztályú JMP művelet — ez . Ez az utasítás befejezi a programot, visszatérve a kernelhez r0. Adjunk hozzá egy új oszlopot a táblázathoz:
Op    S  Class   Dst Src Off  Imm    Disassm
MOV   0  ALU64   0   0   0    1      r0 = 1
JEQ   0  JMP     0   1   1    0      if (r1 == 0) goto pc+1
MOV   0  ALU64   0   0   0    2      r0 = 2
EXIT  0  JMP     0   0   0    0      exit
Ezt kényelmesebb formában is átírhatjuk:
     r0 = 1
     if (r1 == 0) goto END
     r0 = 2
END:
     exit
Ha emlékezünk, hogy a regiszter r1 az alkalmazásban a kernel által biztosított kontextusra mutat, míg a regiszter r0 a kernelbe visszatérő értéket hordoz, akkor láthatjuk, hogy ha a kontextusra mutató adat nullával egyenlő, visszaadunk 1-et, különben 2-t. Ellenőrizzük, hogy igazunk van-e, megvizsgálva a forrást:
$ cat readelf-example.c
int foo(void *ctx)
{
        return ctx ? 2 : 1;
}
Igen, ez egy értelmetlen program, de mindössze négy egyszerű utasításra fordítódik.
Példa-kivétel: 16-bites utasítás
Korábban említettük, hogy egyes utasítások több mint 64 bitet foglalnak el. Ez vonatkozik például a lddw (Kód = 0x18 = | | ) — kétszavas adat betöltése a mezőkből Imm. A dolog az, Imm a mérete 32, a kettős szó pedig 64 bit, így nem lehet egy 64 bites azonnali értéket betölteni egyetlen 64 bites utasítás keretein belül. Ehhez két szomszédos utasítást alkalmaznak a 64 bites érték második részének tárolására a mezőben Imm. Példa:
$ cat x64.c
long foo(void *ctx)
{
        return 0x11223344aabbccdd;
}
$ clang -target bpf -c x64.c -o x64.o -O2
$ llvm-readelf -x .text x64.o
Hex dump of section '.text':
0x00000000 18000000 ddccbbaa 00000000 44332211 ............D3".
0x00000010 95000000 00000000                   ........
A bináris program mindössze két utasítást tartalmaz:
Bináris                                 Disassm
18000000 ddccbbaa 00000000 44332211    r0 = Imm[0]|Imm[1]
95000000 00000000                      exit
Még találkozunk az utasítással lddw, amikor a relokációkról és a térképek használatáról beszélünk.
Példa: BPF disassemblálása szabványos eszközökkel
Tehát megtanultuk olvasni a BPF bináris kódokat, és készen állunk bármilyen utasítás elemezésére, ha szükséges. Érdemes azonban megjegyezni, hogy a gyakorlatban kényelmesebb és gyorsabb a programok disassemblálása szabványos eszközökkel, mint például:
$ llvm-objdump -d x64.o

A szakasz disassembliálása .text:

0000000000000000 <foo>:
 0: 18 00 00 00 dd cc bb aa 00 00 00 00 44 33 22 11 r0 = 1234605617868164317 ll
 2: 95 00 00 00 00 00 00 00 exit
BPF objektumok élettartama, bpffs fájlrendszer
(Néhány részlet, amelyet ebben a szakaszban leírok, először Alexei Starovoitov a .)
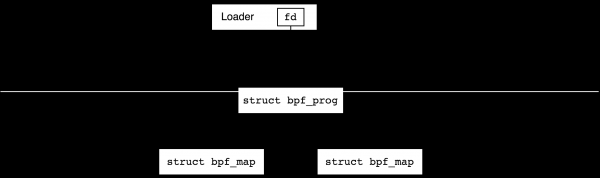
A BPF objektumok - programok és térképek - a felhasználói térből az alábbi parancsok segítségével jönnek létre BPF_PROG_LOAD és BPF_MAP_CREATE rendszerhívás bpf(2), arról fogunk beszélni, hogy ez pontosan hogyan történik a következő szakaszban. Eközben a kernel adatstruktúrái jönnek létre, és mindegyikhez refcount (referenciaszámláló) egyesre van állítva, és a felhasználó egy fájl deszkriptort kap, amely az objektumra mutat. A deszkriptor lezárásakor refcount az objektum száma egyre csökken, és ha az nullára csökken, az objektum megsemmisül.
Ha a program térképeket használ, akkor refcount ezeknek a térképeknek a száma eggyel nő a program betöltése után, azaz a fájl deszkriptorok a felhasználói folyamatból zárhatók, és ekkor refcount nem csökken nullára:
A program sikeres betöltése után általában csatlakoztatjuk egy eseménygenerátorhoz. Például a hálózati interfészhez ültethetjük az érkező csomagok feldolgozására, vagy csatlakozhatunk egy tracepoint-hoz a kernelben. Ekkor a referenciaszámláló is eggyel nő, így a fájl deszkriptort a betöltő programban le tudjuk zárni.
Mi fog történni, ha most befejezzük a betöltő munkáját? Ez attól függ, hogy milyen típusú eseménygenerátorról (hook) van szó. Minden hálózati hook létezni fog a betöltő befejezése után, ezek az úgynevezett globális hookok. Például a nyomkövető programok a létrehozó folyamat befejezése után felszabadulnak (ezért nevezik őket lokálisnak, azaz „local to the process”). Technikailag a lokális hookok mindig rendelkeznek a megfelelő fájl leíróval a felhasználói térben, így a folyamat bezárásakor záródnak, míg a globális hookok nem. A következő ábrán piros keresztekkel próbálom megmutatni, hogyan befolyásolja a betöltő program befejezése az objektumok életciklusát lokális és globális hookok esetén.
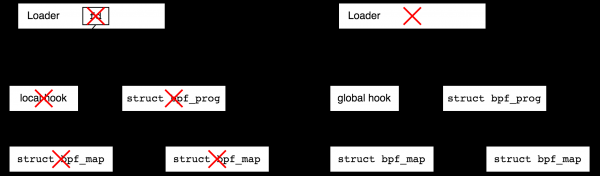
Miért létezik a lokális és globális hookok közötti megkülönböztetés? Bizonyos típusú hálózati programok indítása értelmes lehet a felhasználói tér nélkül is, például képzelje el a DDoS elleni védelmet — a betöltő felírja a szabályokat és csatlakoztat egy BPF programot a hálózati interfészhez, majd a betöltő megsemmisülhet. Másrészről képzeljen el egy nyomkövető programot, amelyet tíz perc alatt írt össze — a befejezése után szeretné, ha a rendszerben nem maradna szemét, és a lokális hookok ezt garantálják.
Másrészt képzelje el, hogy csatlakozni szeretne a kernel egy tracepointjához, és statisztikát gyűjteni évekig. Ebben az esetben szeretné befejezni a felhasználói részt, és időnként visszatérni a statisztikákhoz. Ezt a lehetőséget a bpf fájlrendszer biztosítja. Ez egy pszeudo-fájlrendszer, amely csak a memóriában létezik, lehetővé téve fájlok létrehozását, amelyek BPF objektumokra mutatnak, ezzel növelve refcount az objektumok életciklusát. Ezután a betöltő befejezheti a működését, míg az általa létrehozott objektumok életben maradnak.
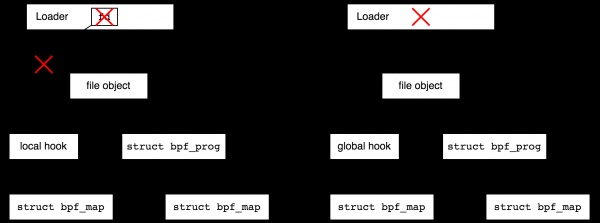
A bpffs fájlok létrehozása, amelyek BPF objektumokra mutatnak, „rögzítésnek” (pin, mint a következő mondatban: „a folyamat rögzíthet egy BPF programot vagy térképet”) nevezzük. A BPF objektumokhoz tartozó fájlobjektumok létrehozása nemcsak a lokális objektumok életciklusának meghosszabbítása szempontjából van értelme, hanem a globális objektumok használata szempontjából is kényelmes — visszatérve a globális DDoS védelmi program példájára, időnként szeretnénk visszajönni és megnézni a statisztikákat.
A BPF fájlrendszer általában be van csatolva /sys/fs/bpf, de helyben is csatolható, például így:
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
A fájlrendszer nevei a BPF_OBJ_PIN rendszervcallsal készülnek. Például vegyünk egy programot, fordítsuk le, töltsük be és pineljük a bpffsalá. A programunk nem végez semmilyen hasznos feladatot, a kódját csupán példaként hoztuk, hogy újra tudja alkotni a példát:
$ cat test.c
__attribute__((section("xdp"), used))
int test(void *ctx)
{
        return 0;
}

char _license[] __attribute__((section("license"), used)) = "GPL";
Fordítsuk le ezt a programot, és hozzunk létre egy helyi másolatot a fájlrendszerről bpffs:
$ clang -target bpf -c test.c -o test.o
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Most töltsük be a programunkat a bpftool segítségével, és nézzük meg a kapcsolódó rendszerhívásokat bpf(2) (a strace kimenetéből eltávolítva néhány irreleváns sort):
$ sudo strace -e bpf bpftool prog load .\/test.o bpf-mountpoint\/test
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="test", ...}, 120) = 3
bpf(BPF_OBJ_PIN, {pathname="bpf-mountpoint\/test", bpf_fd=3}, 120) = 0
Itt a programunkat a BPF_PROG_LOADsegítségével töltöttük be, kaptunk a magtól egy fájl deszkriptort 3 és a BPF_OBJ_PIN parancs segítségével rögzítettük ezt a fájl deszkriptort egy fájlként "bpf-mountpoint\/test". Ezt követően a betöltő program befejezte a működését, de a programunk a magban maradt, bár nem csatoltuk semmilyen hálózati interfészhez: bpftool $ sudo bpftool prog | tail -3 783: xdp name test tag 5c8ba0cf164cb46c gpl loaded_at 2020-05-05T13:27:08+0000 uid 0 xlated 24B jited 41B memlock 4096B
Egy fájljátékos objektumot normál módon tudunk törölniunlink(2) és ezt követően a megfelelő programot törlik: $ sudo rm .\/bpf-mountpoint\/test $ sudo bpftool prog show id 783 Error: get by id (783): No such file or directory
Objektumok törléseAz objektumok törléséről beszélve fontos tisztázni, hogy miután leválasztottuk a programot a horgotól (eseménygenerátor), egy új esemény sem fogja elindítani, de a program aktuális példányai normálisan le fognak állni.
Bizonyos típusú BPF programok lehetővé teszik a programok futás közbeni cseréjét, vagyis atomaritást biztosítanak a sorozat során
replace = detach old program, attach new program . Ez azt jelenti, hogy az összes aktív példány a régi verzióból leáll, és az új eseménykezelők már az új programból készülnek, és az "atomaritás" ebben az esetben azt jelenti, hogy egyetlen esemény sem maradhat ki.Ezáltal az összes aktív példány befejezi a munkáját, míg az új eseménykezelők már az új programból fognak létrejönni, és az "atomaritás" itt azt jelenti, hogy egy esemény sem marad ki.
Programok csatlakoztatása eseményforrásokhoz
Ebben a cikkben nem részletezzük külön a programok eseményforrásokhoz való csatlakoztatását, mivel ezt egy adott programtípus kontextusában érdemes tanulmányozni. Lásd alább, ahol bemutatjuk, hogyan csatlakoztathatók az XDP típusú programok.
Objektumok kezelése a bpf rendszerhívás segítségével
BPF programok
Minden BPF objektumot a felhasználói térből hoznak létre és kezelnek a bpf rendszerhívás segítségével, bpf, aminek a következő prototípusa van:
#include <linux/bpf.h>

int bpf(int cmd, union bpf_attr *attr, unsigned int size);
Itt a parancs cmd — ez egy érték a , attr — mutató a konkrét program paramétereihez, és méret — az objektum mérete a mutatón, azaz általában ez sizeof(*attr). Az 5.8-as kernelben a rendszerhívás bpf 34 különböző parancsot támogat, míg union bpf_attr 200 sorból áll. De ez minket ne ijesztessen meg, mivel a parancsokkal és paraméterekkel több cikk során fogunk megismerkedni.
Kezdjük a parancsal BPF_PROG_LOAD, amely BPF programokat hoz létre – eltárolja a BPF utasítások sorozatát és betölti azt a kernelbe. A betöltés pillanatában elindul a verifier, majd a JIT fordító, és ha a végrehajtás sikeres, a felhasználónak visszatér egy fájldeszkriptor a programhoz. Láttuk, hogy mi történik vele ezután az előző részben .
Most egy felhasználói programot fogunk írni, amely betölti egy egyszerű BPF programot, de először meg kell határoznunk, hogy pontosan milyen programot szeretnénk betölteni – választanunk kell , és ezen belül egy olyan programot kell írnunk, amely megfelel a verifier ellenőrzésének. Azonban, hogy ne bonyolítsuk túl a folyamatot, itt van egy kész megoldás: egy BPF_PROG_TYPE_XDPtípust fogunk választani, amely visszaadja az értéket XDP_PASS (minden csomag átkonvertálása). BPF assembly nyelven ez nagyon egyszerűen néz ki:
r0 = 2
exit
Miután meghatároztuk, hogy mit mit fogunk betölteni, elmondhatjuk, hogyan tesszük ezt:
#define _GNU_SOURCE
#include <string.h>
#include <unistd.h>
#include <sys/syscall.h>
#include <linux/bpf.h>

static inline __u64 ptr_to_u64(const void *ptr)
{
        return (__u64) (unsigned long) ptr;
}

int main(void)
{
    struct bpf_insn insns[] = {
        {
            .code = BPF_ALU64 | BPF_MOV | BPF_K,
            .dst_reg = BPF_REG_0,
            .imm = XDP_PASS
        },
        {
            .code = BPF_JMP | BPF_EXIT
        },
    };

    union bpf_attr attr = {
        .prog_type = BPF_PROG_TYPE_XDP,
        .insns     = ptr_to_u64(insns),
        .insn_cnt  = sizeof(insns)/sizeof(insns[0]),
        .license   = ptr_to_u64("GPL"),
    };

    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Az érdekes események a programban a insns meghatározásával kezdődnek – a BPF programunk gépi kódjainak tömbje. A BPF program minden utasítása egy struktúrába van csomagolva. Az első elem insns a r0 = 2, a másik pedig — exit.
utasítást képviseli. Kitérő. A kernelben kényelmesebb makrók találhatók a gépi kódok írásához, és a kernel fejlécfájl használatával tools/include/linux/filter.h
struct bpf_insn insns[] = {
    BPF_MOV64_IMM(BPF_REG_0, XDP_PASS),
    BPF_EXIT_INSN()
};
De mivel a BPF-programok írása gépi kódokban csak a kernel teszteléséhez és a BPF-ről szóló cikkekhez szükséges, ezeknek a makróknak a hiánya valójában nem nehezíti meg a fejlesztők életét.
A BPF-program meghatározása után áttérünk a kernelbe történő betöltésére. Minimalista paraméterkészletünk attr tartalmazza a program típusát, az utasítások számát és számát, a kötelező licencet, valamint a nevet "woo", amelyet arra használunk, hogy a betöltés után megtaláljuk programunkat a rendszerben. A program, ahogy ígértük, a rendszerhíváson keresztül töltődik be bpf.
A program végén egy végtelen ciklusba kerülünk, amely az hasznos terhelést szimulálja. Enélkül a program megszűnik a kernel által a fájlleíró bezárásakor, amelyet a rendszerhívásunk visszaadott bpf, és nem fogjuk látni a rendszerben.
Nos, készen állunk a tesztelésre. Fordítsuk le és futtassuk a programot strace, hogy ellenőrizzük, minden rendben működik:
$ clang -g -O2 simple-prog.c -o simple-prog

$ sudo strace .\/simple-prog
execve(".\/simple-prog", [".\/simple-prog"], 0x7ffc7b553480 \/ * 13 vars *\/ ) = 0
...
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0x7ffe03c4ed50, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(0, 0, 0), prog_flags=0, prog_name="woo", prog_ifindex=0, expected_attach_type=BPF_CGROUP_INET_INGRESS}, 72) = 3
pause(
Minden rendben van, bpf(2) visszaadott nekünk 3-as fájlleíróval és beléptünk egy végtelen ciklusba a pause(). Próbáljuk meg megtalálni programunkat a rendszerben. Ehhez egy másik terminálba lépünk és használjuk az eszközt bpftool:
# bpftool prog | grep -A3 woo
390: xdp  name woo  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-31T24:66:44+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        pids simple-prog(10381)
Látjuk, hogy a rendszerben van egy betöltött program woo melynek globális ID-je 390, és hogy a folyamatban simple-prog van egy nyitott fájlleíró, amely a programra mutat (és ha simple-prog abbahagyja a működést, akkor woo eltűnik). Ahogy vártuk, a program woo 16 bájt helyet foglal el — két utasítás — BPF architektúrában bináris kódokban, de natív formában (x86_64) — ez már 40 bájt. Nézzük meg programunkat eredeti formájában:
# bpftool prog dump xlated id 390
   0: (b7) r0 = 2
   1: (95) exit
meglepetések nélkül. Most nézzük meg a JIT fordító által létrehozott kódot:
# bpftool prog dump jited id 390
bpf_prog_3b185187f1855c4c_woo:
   0:   nopl   0x0(%rax,%rax,1)
   5:   push   %rbp
   6:   mov    %rsp,%rbp
   9:   sub    $0x0,%rsp
  10:   push   %rbx
  11:   push   %r13
  13:   push   %r14
  15:   push   %r15
  17:   pushq  $0x0
  19:   mov    $0x2,%eax
  1e:   pop    %rbx
  1f:   pop    %r15
  21:   pop    %r14
  23:   pop    %r13
  25:   pop    %rbx
  26:   leaveq
  27:   retq
nem túl hatékony a exit(2), de igazság szerint a programunk túl egyszerű, és nem trivialis programok esetén a JIT fordító által hozzáadott prolog és epilog nyilvánvalóan szükséges.
Maps
A BPF programok struktúrált memória területeket használhatnak, amelyek más BPF programok, valamint a felhasználói tér programjai számára is elérhetők. Ezeket az objektumokat maps-nak hívják, és ebben a részben megmutatjuk, hogyan lehet velük a rendszerhívás segítségével kezelni. bpf.
Azonnal meg kell mondanunk, hogy a maps lehetőségei nem korlátozódnak pusztán a közös memória elérésére. Léteznek speciális célú mappák is, amelyek például BPF programokra vagy hálózati interfészekre mutató mutatókat tartalmaznak, perf events kezelésére szolgáló mappák stb. Ezekről nem fogunk beszélni, hogy ne zavarjuk meg az olvasót. Emellett figyelmen kívül hagyjuk a szinkronizációs problémákat, mivel ezek nem fontosak példáinkhoz. A rendelkezésre álló map típusok teljes listáját megtalálhatja a , itt viszont például az első, történelmileg első típust, a hash-táblát fogjuk bemutatni. BPF_MAP_TYPE_HASH.
Ha hash-táblát hoz létre, mondjuk C++-ban, akkor ezt mondaná: unordered_map woo, ami magyarul annyit jelent, hogy "szükségem van egy táblázatra, woo amely korlátlan méretű, kulcsai típusa egész, az értékek típusa pedig long. Ahhoz, hogy létrehozzunk egy BPF hash-táblát, körülbelül ugyanazt kell tennünk, figyelembe véve, hogy meg kell adnunk a tábla maximális méretét, a kulcsok és értékek helyett pedig azok méretét kell megadnunk bájtban. A mappák létrehozásához a következő parancs használható: BPF_MAP_CREATE rendszerhívás bpf. Nézzünk meg egy viszonylag minimális programot, amely létrehozza a map-t. A korábbi program, amely a BPF programokat betölti, után ez egyszerűnek tűnik:
$ cat simple-map.c
#define _GNU_SOURCE
#include
#include
#include
#include

int main(void)
{
    union bpf_attr attr = {
        .map_type = BPF_MAP_TYPE_HASH,
        .key_size = sizeof(int),
        .value_size = sizeof(int),
        .max_entries = 4,
    };
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));

    for (;;)
        pause();
}
Itt egy paraméterhalmazt definiálunk, attr, amelyben azt mondjuk: "szükségem van egy hash-táblára, amelynek kulcsai és értékei mérete sizeof(int), amelybe maximum négy elemet tudok betenni." BPF mappák létrehozásakor más paramétereket is meg lehet adni, például ahogyan a program példájánál, itt is megadtuk az objektum nevét, mint "woo".
Kompiláljuk és futtassuk a programot:
$ clang -g -O2 simple-map.c -o simple-map
$ sudo strace ./simple-map
execve("./simple-map", ["./simple-map"], 0x7ffd40a27070 /* 14 vars */) = 0
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_HASH, key_size=4, value_size=4, max_entries=4, map_name="woo", ...}, 72) = 3
pause(
Itt van a rendszerhívás bpf(2) visszaadta nekünk a térképezési leíró számot 3 és a program, ahogy elvártuk, várja a további utasításokat a rendszerhívásban pause(2).
Most küldjük el a programunkat háttérbe, vagy nyissunk meg egy másik terminált, és nézzük meg az objektumunkat az eszközzel bpftool (megkülönböztethetjük a térképünket a neve alapján):
$ sudo bpftool map
...
114: hash  név woo  flags 0x0
		kulcs 4B  érték 4B  max_entries 4  memlock 4096B
...
A 114-es szám a globális ID-je az objektumunknak. Bármelyik program a rendszerben használhatja ezt az ID-t, hogy megnyissa a már meglévő térképet a parancs segítségével BPF_MAP_GET_FD_BY_ID rendszerhívás bpf.
Most játszadozhatunk a hash-táblánkkal. Nézzük meg a tartalmát:
$ sudo bpftool map dump id 114
0 elemet találtunk
Üres. Tegyünk bele egy értéket hash[1] = 1:
$ sudo bpftool map update id 114 kulcs 1 0 0 0 érték 1 0 0 0Nézzük meg a táblát még egyszer:
$ sudo bpftool map dump id 114
kulcs: 01 00 00 00  érték: 01 00 00 00
1 elemet találtunk
Hurrá! Sikerült hozzáadnunk egy elemet. Észrevehette, hogy ezért bájt szinten kell dolgoznunk, mivel bptftool nem tudja, milyen típusúak az értékek a hash-táblában. (Ezt az információt át lehet adni BTF segítségével, de erről most nem beszélünk.)
Hogyan olvassa és adja hozzá az elemeket a bpftool? Nézzük meg a motorháztető alatt:
$ sudo strace -e bpf bpftool map dump id 114
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, kulcs=NULL, next_key=0x55856ab65280}, 120) = 0
bpf(BPF_MAP_LOOKUP_ELEM, {map_fd=3, kulcs=0x55856ab65280, érték=0x55856ab652a0}, 120) = 0
kulcs: 01 00 00 00  érték: 01 00 00 00
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, kulcs=0x55856ab65280, next_key=0x55856ab65280}, 120) = -1 ENOENT
Először megnyitottuk a térképet a globális ID-ja alapján a parancs segítségével BPF_MAP_GET_FD_BY_ID és bpf(2) visszaadta nekünk a 3-as leíró számodat. Ezután a parancs segítségével BPF_MAP_GET_NEXT_KEY megtaláltuk az első kulcsot a táblában, átadva NULL mint a „előző” kulcs hivatkozása. Ha van kulcsunk, akkor megtehetjük BPF_MAP_LOOKUP_ELEM, ami visszaadja az értéket a hivatkozásban érték. A következő lépés: megpróbáljuk megtalálni a következő elemet, átadva a hivatkozást a jelenlegi kulcsra, de a táblánknak csak egy eleme van, és a parancs BPF_MAP_GET_NEXT_KEY a pénzeszközöket! Még dicséretet is kap 75-90% -tól a résztvevők közül, bár a projekt fejlődése nyilvánvalóan lelassult. A legmeglepőbb, hogy mindenki ENOENT.
Rendben, változtassuk meg az értéket az 1-es kulcsnál, mondjuk, üzleti logikánk megköveteli: hash[1] = 2:
$ sudo strace -e bpf bpftool map update id 114 kulcs 1 0 0 0 érték 2 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, kulcs=0x55dcd72be260, érték=0x55dcd72be280, flags=BPF_ANY}, 120) = 0
Ahogy elvártuk, ez nagyon egyszerű: a parancs BPF_MAP_GET_FD_BY_ID megnyitja a térképünket az ID-ján, és a parancs BPF_MAP_UPDATE_ELEM felülírja az elemet.
Összességében, miután létrehoztunk egy hash-táblát egy programból, képesek vagyunk olvasni és írni a tartalmát egy másik programból. Vegye figyelembe, hogy ha ezt a parancssorból meg tudtuk tenni, akkor ezt bármely más program a rendszerben is megteheti. Az előzőekben leírt parancsokon kívül a felhasználói térből elérhető mappákkal kapcsolatosan :
BPF_MAP_LOOKUP_ELEM: érték keresése kulcs alapjánBPF_MAP_UPDATE_ELEM: érték frissítése/ létrehozásaBPF_MAP_DELETE_ELEM: kulcs eltávolításaBPF_MAP_GET_NEXT_KEY: következő (vagy első) kulcs kereséseBPF_MAP_GET_NEXT_ID: lehetővé teszi, hogy végigmenjünk az összes meglévő mappán, így működikbpftool mapBPF_MAP_GET_FD_BY_ID: meglévő mappa megnyitása globális azonosítója alapjánBPF_MAP_LOOKUP_AND_DELETE_ELEM: atomikusan frissíti a objektum értékét és visszaadja a régi értéketBPF_MAP_FREEZE: a mappa változtathatatlanná tétele a felhasználói térből (ez a művelet nem vonható vissza)BPF_MAP_LOOKUP_BATCH,BPF_MAP_LOOKUP_AND_DELETE_BATCH,BPF_MAP_UPDATE_BATCH,BPF_MAP_DELETE_BATCH: tömeges műveletek. PéldáulBPF_MAP_LOOKUP_AND_DELETE_BATCH— ez az egyetlen megbízható módszer, hogy elolvassuk és nullázzuk az összes értéket a mappából
Nem minden ezen parancsok működik az összes mappa típusra, de egyébként a felhasználói térből való munka más típusú mappákkal pontosan úgy néz ki, mint a hash-táblákkal való munka.
Rend kedvéért, fejezzük be a kísérleteinket a hash-táblával. Ne feledje, hogy létrehoztunk egy táblázatot, amely legfeljebb négy kulcsot tartalmazhat? Adjunk hozzá néhány további elemet:
$ sudo bpftool map update id 114 key 2 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 3 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 4 0 0 0 value 1 0 0 0
Eddig minden rendben:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
key: 02 00 00 00  value: 01 00 00 00
key: 04 00 00 00  value: 01 00 00 00
key: 03 00 00 00  value: 01 00 00 00
4 elemet találtunk
Próbáljuk meg hozzáadni az ötödiket:
$ sudo bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
Hiba: frissítés sikertelen: Az argumentum lista túl hosszú
Ahogy vártuk, nem sikerült. Nézzük meg a hibát részletesebben:
$ sudo strace -e bpf bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_OBJ_GET_INFO_BY_FD, {info={bpf_fd=3, info_len=80, info=0x7ffe6c626da0}}, 120) = 0
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x56049ded5260, value=0x56049ded5280, flags=BPF_ANY}, 120) = -1 E2BIG (Az argumentum lista túl hosszú)
Hiba: frissítés sikertelen: Az argumentum lista túl hosszú
+++ 255-kel távozott +++
Minden rendben van: ahogy vártuk, a parancs BPF_MAP_UPDATE_ELEM megpróbál egy új, ötödik kulcsot létrehozni, de elbukik azzal, hogy E2BIG.
Most már tudjuk, hogyan kell BPF programokat létrehozni és betölteni, valamint hogyan kell térképeket létrehozni és kezelni a felhasználói térből. Logikus tehát, hogy megnézzük, hogyan használhatjuk a térképeket magukból a BPF programokból. Beszélhetnénk erről gépi kódokban, nehezen olvasható makrók formájában, de valójában itt az ideje megmutatni, hogyan is írjuk és karbantartjuk a BPF programokat. libbpf.
(A mélyebb példák iránt érdeklődő olvasóknak: részletesen bemutatjuk a térképeket és a segédfunkciókat használó programokat, libbpf és elmondjuk, mi történik az utasítások szintjén. Azok számára, akiket ez nem elégít ki, nagyon is, a cikk megfelelő helyén hozzáadtuk .
BPF programok írása a libbpf segítségével
BPF programokat gépi kódokkal írni kezdetben izgalmas, de idővel unalmassá válik. Ebben a pillanatban érdemes ránézni llvm, ahol van egy backend a BPF architektúrához történő kódgeneráláshoz, valamint a libbpf, amely lehetővé teszi, hogy a BPF programok felhasználói részét írjuk és a BPF programok kódját betöltsük, amelyet a llvm/clang.
segítségével generáltunk. Valójában, ahogy a következő cikkekből is láthatjuk, libbpf elég sok munkát végez el anélkül is (vagy hasonló eszközökként - iproute2, libbcc, libbpf-go, stb.) nélkül nem lehet élni. A projekt egyik figyelemre méltó jellemzője, libbpf a BPF CO-RE (Compile Once, Run Everywhere) - egy projekt, amely lehetővé teszi BPF programok írását, amelyek egy kerneltől a másikra átkonvertálhatók, különböző API-kon való futtatás lehetőségével (például amikor a kernelfelépítése verzióról verzióra változik). Ahhoz, hogy a CO-RE-vel dolgozhasson, a kernelét BTF támogatással kell lefordítania (erről a részben beszélünk). Ellenőrizni, hogy a kernelt BTF-vel fordították-e, nagyon egyszerű - a következő fájl meglétét kell ellenőrizni:
$ ls -lh /sys/kernel/btf/vmlinux
-r--r--r-- 1 root root 2.6M Jul 29 15:30 /sys/kernel/btf/vmlinux
Ez a fájl tárolja az összes adatfolyamtípust, amelyet a kernel használ, és minden példánkban használjuk, amely a libbpf. A CO-RE-ról részletesebben a következő cikkben beszélünk, de ebben az esetben - csak építse meg a kernelt CONFIG_DEBUG_INFO_BTF.
Könyvtár libbpf a tools/lib/bpf könyvtárban él, és fejlesztése a bpf@vger.kernel.org levelezőlistán keresztül történik.. Az alkalmazások, amelyek a magon kívül működnek, külön adattárat támogatnak. Ez a mag könyvtára olvasási hozzáféréssel tükröződik, nagyjából ahogyan van.
Ebben a szakaszban megnézzük, hogyan hozhatunk létre egy projektet, amely használja libbpf, írunk néhány (nagyjából értelmetlen) tesztprogramot, és részletesen átbeszéljük, hogyan működik mindez. Ez lehetővé teszi, hogy a következő szakaszokban könnyebben elmagyarázzuk, hogyan lépnek kapcsolatba a BPF programok a maps-szal, kernel helperrel, BTF-vel, stb.
Általában a projektek, amelyek használják libbpf git submodule-ként hozzáadják a GitHub tárhelyet, tegyük meg ezt is:
$ mkdir /tmp/libbpf-example
$ cd /tmp/libbpf-example/
$ git init-db
Üres Git adattár inicializálva itt: /tmp/libbpf-example/.git/
$ git submodule add https://github.com/libbpf/libbpf.git
Klónozás a '/tmp/libbpf-example/libbpf' könyvtárba...
Remote: Objektumok számlálása: 200, kész.
Remote: Objektumok száma: 100% (200/200), kész.
Remote: Objektumok tömörítése: 100% (103/103), kész.
Remote: Összesen 3354 (delta 101), újrahasználva 118 (delta 79), pack-reused 3154
Objektumok fogadása: 100% (3354/3354), 2.05 MiB | 10.22 MiB/s, kész.
Delták megoldása: 100% (2176/2176), kész.
Összeállítás libbpf nagyon egyszerű:
$ cd libbpf/src
$ mkdir build
$ OBJDIR=build DESTDIR=root make -s install
$ find root
root
root/usr
root/usr/include
root/usr/include/bpf
root/usr/include/bpf/bpf_tracing.h
root/usr/include/bpf/xsk.h
root/usr/include/bpf/libbpf_common.h
root/usr/include/bpf/bpf_endian.h
root/usr/include/bpf/bpf_helpers.h
root/usr/include/bpf/btf.h
root/usr/include/bpf/bpf_helper_defs.h
root/usr/include/bpf/bpf.h
root/usr/include/bpf/libbpf_util.h
root/usr/include/bpf/libbpf.h
root/usr/include/bpf/bpf_core_read.h
root/usr/lib64
root/usr/lib64/libbpf.so.0.1.0
root/usr/lib64/libbpf.so.0
root/usr/lib64/libbpf.a
root/usr/lib64/libbpf.so
root/usr/lib64/pkgconfig
root/usr/lib64/pkgconfig/libbpf.pc
A következő tervünk ebben a szakaszban a következő: írunk egy BPF programot BPF_PROG_TYPE_XDP, ugyanazt, mint az előző példában, de C nyelven, és lefordítjuk clang, valamint írunk egy segédprogramot, amely betölti azt a kernelbe. A következő szakaszokban bővítjük a BPF program és a segédprogram lehetőségeit.
Példa: létrehozunk egy teljes értékű alkalmazást a libbpf segítségével
Először használni fogjuk a fenti fájlt, és létrehozzuk annak megfelelőjét egy fejléc fájl formájában: /sys/kernel/btf/vmlinux$ bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.h
Ebben a fájlban tárolódnak az összes adatstruktúra, amely a kernelünkben található, például így definiálódik az IPv4 fejléc a kernelben:$ grep -A 12 'struct iphdr {' vmlinux.h struct iphdr { __u8 ihl: 4; __u8 version: 4; __u8 tos; __be16 tot_len; __be16 id; __be16 frag_off; __u8 ttl; __u8 protocol; __sum16 check; __be32 saddr; __be32 daddr; };
Most pedig megírjuk a BPF programunkat C nyelven:Most megírjuk a BPF programunkat C nyelven:
$ cat xdp-simple.bpf.c
#include "vmlinux.h"
#include

SEC("xdp/simple")
int simple(void *ctx)
{
        return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Bár a programunk nagyon egyszerű lett, de mégis figyelembe kell vennünk számos részletet. Először is, az első fejlécfájl, amelyet beillesztünk, a vmlinux.h, amelyet most generáltunk a bpftool btf dump — most már nem szükséges telepíteni a kernel-headers csomagot ahhoz, hogy tudjuk, hogyan néznek ki a kernel struktúrák. A következő fejlécfájl a libbpfkönyvtárból érkezik. Jelenleg csak azért van szükségünk rá, hogy a SECmakró meg legyen határozva, amely a megfelelő ELF objektumfájl szekcióba küldi a szimbólumot. A programunk a xdp/simpleszekcióban található, ahol a perjel előtt meghatározzuk a BPF program típusát – ez egy megállapodás, amelyet a libbpfhasznál, a szekció neve alapján a megfelelő típust fogja betenni a futtatáskor. bpf(2)Maga a BPF program a C nagyon egyszerű, és egy sorból áll. return XDP_PASS. Végül, egy külön szekció "license" tartalmazza a licenc nevét.
Programunkat az llvm/clang segítségével fordíthatjuk le, a verziótól >= 10.0.0, de a legjobb, ha még újabb (lásd a szakaszt ):
$ clang --version
clang version 11.0.0 (https://github.com/llvm/llvm-project.git afc287e0abec710398465ee1f86237513f2b5091)
...

$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
Néhány érdekes jellemző: megadjuk a cél architektúrát -target bpf és az elérési utat a fejlécekhez, amelyeket nemrég telepítettünk. Ne felejtsük el a libbpf-O2 , ez az opció nélkül meglepetések várhatnak ránk a jövőben. Nézzük meg a kódunkat, sikerült-e megírnunk a kívánt programot?$ llvm-objdump --section=xdp/simple --no-show-raw-insn -D xdp-simple.bpf.oxdp-simple.bpf.o: file format elf64-bpfDisassembly of section xdp/simple:0000000000000000 : 0: r0 = 2 1: exit
Igen, sikerült! Most már van egy bináris fájlunk a programmal, és szeretnénk létrehozni egy alkalmazást, amely betölti azt a kernelbe. Ehhez a könyvtárkét lehetőséget kínál – használhatjuk az alacsony szintű API-t vagy a magas szintű API-t. Mi a második utat választjuk, mivel szeretnénk megtanulni, hogyan kell írni, betölteni és csatlakoztatni a BPF programokat minimális erőfeszítéssel a további tanulmányozás érdekében. libbpf Először is, szükségünk van a programunk „csontvázának” generálására a binárisából, ugyanazzal az eszközzel.
Először is, szükségünk van a programunk "vázának" generálására a binárisából a már megszokott hasznos segítségével. bpftool — a világ BPF svájci bicskája (ami szó szerint is érthető, mivel Daniel Borkman – a BPF egyik létrehozója és karbantartója – svájci):
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.hA fájlban xdp-simple.skel.h tartalmazza a programunk bináris kódját és funkciókat a kezeléshez – betöltéshez, csatlakozáshoz, objektumunk eltávolításához. Egyszerű esetünkben ez túlzásnak tűnik, de működik abban az esetben is, ha az objektumfájl sok BPF programot és térképet tartalmaz, és ennek a hatalmas ELF-nek a betöltéséhez elegendő csak a vázat generálni és meghívni egy vagy két funkciót a felhasználói alkalmazásból, amelynek megírásához most eljutunk.
Valójában a betöltő programunk triviális:
#include <err.h>
#include <unistd.h>
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    pause();

    xdp_simple_bpf__destroy(obj);
}
Itt struct xdp_simple_bpf a fájlban van definiálva xdp-simple.skel.h és leírja objektumfánkat:
struct xdp_simple_bpf {
    struct bpf_object_skeleton *skeleton;
    struct bpf_object *obj;
    struct {
        struct bpf_program *simple;
    } progs;
    struct {
        struct bpf_link *simple;
    } links;
};
Itt észlelhetjük az alacsony szintű API nyomait: a következő struktúrát struct bpf_program *simple és struct bpf_link *simple. Az első struktúra kifejezetten a programunkat írja le, amely a szakaszban található, xdp/simple, míg a második azt írja le, hogyan csatlakozik a program az eseményforráshoz.
Funkció xdp_simple_bpf__open_and_load, megnyitja az ELF objektumot, elemezni kezdi, létrehozza az összes struktúrát és alstructúrát (az ELF-ben található program mellett más szakaszok is vannak – adat, csak olvasható adat, hibakeresési információk, licensz stb.), majd a rendszervívás segítségével betölti a kernelbe, bpf, amit ellenőrizhetünk, ha lefordítjuk és futtatjuk a programot:
$ clang -O2 -I ./libbpf/src/root/usr/include/ xdp-simple.c -o xdp-simple ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz

$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_BTF_LOAD, 0x7ffdb8fd9670, 120)  = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0xdfd580, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(5, 8, 0), prog_flags=0, prog_name="simple", prog_ifindex=0, expected_attach_type=0x25 /* BPF_??? */, ...}, 120) = 4
Most nézzük meg programunkat a bpftoolsegítségével. Keresd meg az ID-ját:
# bpftool p | grep -A4 simple
463: xdp  name simple  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-01T01:59:49+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        btf_id 185
        pids xdp-simple(16498)
és dumpoljuk le (rövidített változatban használjuk a parancsot bpftool prog dump xlated):
# bpftool p d x id 463
int simple(void *ctx):
; return XDP_PASS;
   0: (b7) r0 = 2
   1: (95) exit
Valami új! A program kiírta C nyelvű forrásfájlunk töredékeit. Ezt a könyvtár végezte el, libbpf, amely megtalálta a hibakeresési szakaszt a bináris fájlban, és BTF objektummá fordította, majd betöltötte azt a kernelbe a BPF_BTF_LOAD, majd a program betöltésekor megadta az így kapott fájlleírót a parancs használatával BPG_PROG_LOAD.
Kernel Helpers
A BPF program can invoke "external" functions — kernel helpers. These helper functions allow BPF programs to access kernel structures, manage maps, and interact with the "real world" — creating perf events, managing hardware (for instance, redirecting packets), and so on.
Example: bpf_get_smp_processor_id
Within the paradigm of "learning by examples", let’s examine one of the helper functions, bpf_get_smp_processor_id(), a fájlban kernel/bpf/helpers.c. It returns the processor number on which the calling BPF program is executed. However, we are more interested in how its implementation is done in a single line:
BPF_CALL_0(bpf_get_smp_processor_id)
{
    return smp_processor_id();
}
The definitions of BPF helper functions are similar to the definitions of Linux system calls. Here, for example, a function without arguments is defined. (A function that takes, say, three arguments is defined using the macro BPF_CALL_3. The maximum number of arguments is five.) However, this is just the first part of the definition. The second part is related to defining a structure of type struct bpf_func_proto, which contains a description of the helper function understandable by the verifier:
const struct bpf_func_proto bpf_get_smp_processor_id_proto = {
    .func     = bpf_get_smp_processor_id,
    .gpl_only = false,
    .ret_type = RET_INTEGER,
};
Registration of helper functions
In order for specific types of BPF programs to use this function, they need to register it, for example, for the type BPF_PROG_TYPE_XDP In the kernel, a function is defined xdp_func_proto, which determines whether XDP supports this function based on the helper function ID. Our function is :
static const struct bpf_func_proto *
xdp_func_proto(enum bpf_func_id func_id, const struct bpf_prog *prog)
{
    switch (func_id) {
    ...
    case BPF_FUNC_get_smp_processor_id:
        return &bpf_get_smp_processor_id_proto;
    ...
    }
}
New types of BPF programs are "defined" in the file using the macro BPF_PROG_TYPE. They are referred to as defined in quotes, as this is a logical definition, and in terms of the C language, the definition of a whole set of specific structures takes place elsewhere. In particular, in the file kernel/bpf/verifier.c all definitions from the file bpf_types.h are used to create an array of structures bpf_verifier_ops[]:
static const struct bpf_verifier_ops *const bpf_verifier_ops[] = {
#define BPF_PROG_TYPE(_id, _name, prog_ctx_type, kern_ctx_type)
    [_id] = & _name ## _verifier_ops,
#include
#undef BPF_PROG_TYPE
};
Tehát minden BPF-programtípushoz meghatározzuk a típust reprezentáló adatstruktúra mutatóját struct bpf_verifier_ops, amelyet a következő értékkel inicializálunk _name ## _verifier_ops, azaz xdp_verifier_ops a xdp. A struktúra xdp_verifier_ops a fájlban net/core/filter.c így:
const struct bpf_verifier_ops xdp_verifier_ops = {
    .get_func_proto     = xdp_func_proto,
    .is_valid_access    = xdp_is_valid_access,
    .convert_ctx_access = xdp_convert_ctx_access,
    .gen_prologue       = bpf_noop_prologue,
};
Itt láthatjuk a már ismert funkciónkat xdp_func_proto, amelyet a verifikátor minden alkalommal végrehajt, amikor egy hívást talál valamilyen függvényre a BPF-program belsejében, lásd: .
Nézzük meg, hogyan használja egy hipotetikus BPF-program a funkcionalitást bpf_get_smp_processor_id. Ehhez átírjuk a programot az előző részünkből a következőképpen:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

SEC("xdp/simple")
int simple(void *ctx)
{
    if (bpf_get_smp_processor_id() != 0)
        return XDP_DROP;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
A szimbólum bpf_get_smp_processor_id be. <bpf/bpf_helper_defs.h> könyvtár libbpf hogyan
static u32 (*bpf_get_smp_processor_id)(void) = (void *) 8;azaz, bpf_get_smp_processor_id — ez egy mutató a függvényhez, amelynek értéke 8, ahol a 8 a BPF_FUNC_get_smp_processor_id típusú enum bpf_fun_id, amelyet a következő fájlban határozunk meg vmlinux.h (a fájl bpf_helper_defs.h a kernelben egy szkripttel generálódik, így a 'varázsszámok' rendben vannak). Ez a függvény nem fogad el argumentumokat, és egy __u32. Amikor futtatjuk a programunkban, clang értelmezi a BPF_CALL 'helyes formátumát'. Szóval fordítsuk le a programot, és nézzük meg a szekciót xdp/simple:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ llvm-objdump -D --section=xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Disassembly of section xdp/simple:

0000000000000000 <simple>:
       0:       85 00 00 00 08 00 00 00 call 8
       1:       bf 01 00 00 00 00 00 00 r1 = r0
       2:       67 01 00 00 20 00 00 00 r1 <<= 32
       3:       77 01 00 00 20 00 00 00 r1 >>= 32
       4:       b7 00 00 00 02 00 00 00 r0 = 2
       5:       15 01 01 00 00 00 00 00 if r1 == 0 goto +1 <LBB0_2>
       6:       b7 00 00 00 01 00 00 00 r0 = 1

0000000000000038 <LBB0_2>:
       7:       95 00 00 00 00 00 00 00 exit
Az első sorban látjuk az call, a 'options.priority' paraméter, IMM amelynek értéke 8, és a SRC_REG – nulla. Az ABI-szerződés szerint, amelyet a verifikátor használ, ez a nyolcadik számú segédfüggvény hívása. Miután végrehajtottuk, a logika egyszerű. A visszatérési érték a regiszterből r0 másolva van r1 és a 2,3. sorokban konvertálódik u32 – a felső 32 bitet nullázzuk. A 4,5,6,7. sorokban 2-t (XDP_PASS) vagy 1-et (XDP_DROP) adunk vissza attól függően, hogy a segédfüggvény a 0. sorból nullát vagy nem nullát adott.
Ellenőrizzük magunkat: töltsük be a programot, és nézzük meg a kimenetet bpftool prog dump xlated:
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple &
[2] 10914

$ sudo bpftool p | grep simple
523: xdp  name simple  tag 44c38a10c657e1b0  gpl
        pids xdp-simple(10915)

$ sudo bpftool p d x id 523
int simple(void *ctx):
; if (bpf_get_smp_processor_id() != 0)
   0: (85) call bpf_get_smp_processor_id#114128
   1: (bf) r1 = r0
   2: (67) r1 <>= 32
   4: (b7) r0 = 2
; }
   5: (15) if r1 == 0x0 goto pc+1
   6: (b7) r0 = 1
   7: (95) exit
Rendben, a verifier megtalálta a megfelelő kernel-helper-t.
Példa: átadjuk az argumentumokat, és végül elindítjuk a programot!
Minden végrehajtási szintű segédfunkciónak van prototípusa
u64 fn(u64 r1, u64 r2, u64 r3, u64 r4, u64 r5)A segédfunkcióknak a paramétereit regiszterekben adjuk át r1—r5, és az értéket regiszterben térítjük vissza r0. Nincsenek olyan függvények, amelyek több mint öt argumentumot fogadnak el, és a jövőben nem tervezik a támogatásuk bővítését.
Nézzük meg az új kernel helper-t és azt, hogyan adja át a BPF a paramétereket. Írjuk át xdp-simple.bpf.c a következő módon (a többi sor változatlan maradt):
SEC("xdp/simple")
int simple(void *ctx)
{
    bpf_printk("fut a(z) CPU%un", bpf_get_smp_processor_id());
    return XDP_PASS;
}
A programunk kiírja annak a CPU-nak a számát, amelyen fut. Fordítsuk le és nézzük meg a kódot:
$ llvm-objdump -D --section=xdp/simple --no-show-raw-insn xdp-simple.bpf.o

0000000000000000 :
       0:       r1 = 10
       1:       *(u16 *)(r10 - 8) = r1
       2:       r1 = 8441246879787806319 ll
       4:       *(u64 *)(r10 - 16) = r1
       5:       r1 = 2334956330918245746 ll
       7:       *(u64 *)(r10 - 24) = r1
       8:       call 8
       9:       r1 = r10
      10:       r1 += -24
      11:       r2 = 18
      12:       r3 = r0
      13:       call 6
      14:       r0 = 2
      15:       exit
A 0-7. sorokban a veremben tároljuk a szöveget fut a(z) CPU%un, majd a 8. sorban elindítjuk a nekünk ismert bpf_get_smp_processor_id. A 9-12. sorokban előkészítjük a paramétereket a helper-hez bpf_printk — regiszterek r1, r2, r3. Miért van belőlük három, és nem kettő? Mert bpf_printk — a valódi helper körül bpf_trace_printk, amelynek meg kell adni a formátumú szöveg méretét.
Most adjunk hozzá néhány sort a xdp-simple.c, hogy a programunk csatlakozzon a hálózati interfészhez lo és valóban elinduljon!
$ cat xdp-simple.c
#include
#include
#include
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    __u32 flags = XDP_FLAGS_SKB_MODE;
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "nem sikerült megnyitni és/vagy betölteni a BPF objektumotn");

    bpf_set_link_xdp_fd(1, -1, flags);
    bpf_set_link_xdp_fd(1, bpf_program__fd(obj->progs.simple), flags);

cleanup:
    xdp_simple_bpf__destroy(obj);
}
Itt a bpf_set_link_xdp_fd, amely a BPF XDP típusú programokat csatlakoztatja a hálózati interfészekhez. A interfész számát hardcode-oltuk lo, amely mindig 1-nek felel meg. Két alkalommal hívjuk meg a funkciót, hogy először is leválasszuk a régi programot, ha az csatlakoztatva volt. Észrevették, hogy most már nincs szükség hívásra pause vagy végtelen ciklusra: betöltő programunk befejezi a működését, de a BPF program nem lesz megsemmisítve, mivel az csatlakozik az eseményforráshoz. A sikeres betöltés és csatlakozás után a program minden egyes bejövő hálózati csomagra futni fog, amely érkezik lo.
Betöltjük a programot és megnézzük a felületet lo:
$ sudo ./xdp-simple
$ sudo bpftool p | grep simple
669: xdp  név simple  tag 4fca62e77ccb43d6  gpl
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue állapot UNKNOWN mód DEFAULT csoport default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 669
A betöltött program ID-ja 669, és ugyanazt az ID-t látjuk a felületen lo. Küldjünk pár csomagot a 127.0.0.1 (kérés + válasz):
$ ping -c1 localhostés most nézzük meg a hibakeresési virtuális fájl tartalmát /sys/kernel/debug/tracing/trace_pipe, amelybe bpf_printk írja az üzeneteit:
# cat /sys/kernel/debug/tracing/trace_pipe
ping-13937 [000] d.s1 442015.377014: bpf_trace_printk: running on CPU0
ping-13937 [000] d.s1 442015.377027: bpf_trace_printk: running on CPU0
Két csomagot észleltek a lo és a CPU0-n feldolgozásra került — a mi első teljes értékű, értelmetlen BPF programunk már működik is!
Érdemes megjegyezni, hogy bpf_printk nem véletlenül ír a hibakeresési fájlba: ez nem a legjobb segédprogram a produkciós környezetben való használatra, de a célunk az volt, hogy valami egyszerűt mutassunk be.
Hozzáférés a BPF programokból a mapokhoz
Példa: egy mapot használunk a BPF programból
Az előző fejezetekben megtanultuk, hogyan kell létrehozni és használni a mapokat a felhasználói térből, most nézzük meg a kernel részét. Kezdjük, természetesen, egy példával. Írjuk át a programunkat xdp-simple.bpf.c így:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

struct {
    __uint(type, BPF_MAP_TYPE_ARRAY);
    __uint(max_entries, 8);
    __type(key, u32);
    __type(value, u64);
} woo SEC(".maps");

SEC("xdp/simple")
int simple(void *ctx)
{
    u32 key = bpf_get_smp_processor_id();
    u32 *val;

    val = bpf_map_lookup_elem(&woo, &key);
    if (!val)
        return XDP_ABORTED;

    *val += 1;

    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
A program elejére hozzáadtuk a map definícióját woo: ez egy 8 elemből álló tömb, amelyben u64 (C-ben ezt a tömböt így definiálnánk: u64 woo[8]). A programban "xdp/simple" a jelenlegi CPU számát kapjuk meg a változóba key és ezután a segédfüggvény segítségével bpf_map_lookup_element megkapjuk a mutatót a megfelelő rekordra a tömbben, amelyet eggyel növelünk. Magyarul: számoljuk a statisztikát arról, hogy hány CPU-n dolgozták fel a bejövő csomagokat. Próbáljuk meg futtatni a programot:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple
Ellenőrizzük, hogy csatlakozott-e a lo és küldjünk néhány csomagot:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 108

$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
Most nézzük meg a tömb tartalmát:
$ sudo bpftool map dump name woo
[
    { "key": 0, "value": 0 },
    { "key": 1, "value": 400 },
    { "key": 2, "value": 0 },
    { "key": 3, "value": 0 },
    { "key": 4, "value": 0 },
    { "key": 5, "value": 0 },
    { "key": 6, "value": 0 },
    { "key": 7, "value": 46400 }
]
Majdnem minden folyamat a CPU7-en lett feldolgozva. Ez számunkra nem fontos, a lényeg, hogy a program működik, és megértettük, hogyan érhetjük el a BPF térképeket — az .
Mágikus mutató
Így a BPF programból elérhetjük a térképet hívásokkal, mint például
val = bpf_map_lookup_elem(&woo, &key);ahol a segédfunkció így néz ki:
void *bpf_map_lookup_elem(struct bpf_map *map, const void *key)de mi csak egy mutatót küldünk &woo egy névtelen struktúrára struct { ... }…
Ha megnézzük a program assembly-jét, látni fogjuk, hogy az érték &woo valójában nincs definiálva (4. sor):
llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

A xdp/simple szakasz disassemblere:

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
...
és a relokációkban található:
$ llvm-readelf -r xdp-simple.bpf.o | head -4

A .relxdp/simple relokációs szakasz 0xe18 offsetnél 1 bejegyzést tartalmaz:
    Offset             Info             Type               Symbol's Value  Symbol's Name
0000000000000020  0000002700000001 R_BPF_64_64            0000000000000000 woo
De ha megnézzük a már betöltött programot, látni fogjuk, hogy a mutató a megfelelő térképre mutat (4. sor):
$ sudo bpftool prog dump x name simple
int simple(void *ctx):
   0: (85) call bpf_get_smp_processor_id#114128
   1: (63) *(u32 *)(r10 -4) = r0
   2: (bf) r2 = r10
   3: (07) r2 += -4
   4: (18) r1 = map[id:64]
...
Így arra a következtetésre juthatunk, hogy a betöltő programunk futásának pillanatában a hivatkozás &woo valamiért a könyvtár által lett kicserélve libbpf. Kezdjük azzal, hogy megnézzük a kimenetet strace:
$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, key_size=4, value_size=8, max_entries=8, map_name="woo", ...}, 120) = 4
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="simple", ...}, 120) = 5
Látjuk, hogy libbpf létrehozott egy térképet woo majd betöltötte a programunkat simple. Nézzük meg közelebbről, hogyan töltjük be a programot:
- hívjuk
xdp_simple_bpf__open_and_loadfájlbólxdp-simple.skel.h - ami hívja
xdp_simple_bpf__loadfájlbólxdp-simple.skel.h - ami hívja
bpf_object__load_skeletonfájlbóllibbpf/src/libbpf.c - ami hívja
bpf_object__load_xattralibbpf/src/libbpf.c
Az utolsó funkció, többek között, meghívja a bpf_object__create_maps, amely létrehozza vagy megnyitja a meglévő térképeket, és fájlleírókká alakítja azokat. (Itt látjuk, BPF_MAP_CREATE a kimenetben, strace.) Ezután meghívásra kerül a bpf_object__relocate , amely minket is érdekel, mivel emlékezünk arra, hogy láttuk woo a relokációs táblázatban. Ennek a tanulmányozásával végül eljutunk a bpf_program__relocate, amely :
case RELO_LD64:
    insn[0].src_reg = BPF_PSEUDO_MAP_FD;
    insn[0].imm = obj->maps[relo->map_idx].fd;
    break;
Tehát, vesszük a parancsunkat,
18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 llés kicseréljük benne a forrástartományt BPF_PSEUDO_MAP_FD, az első IMM-t pedig a térképünk fájlleírójára, és ha az például 0xdeadbeef, akkor az eredmény egy parancs lesz,
18 11 00 00 ef eb ad de 00 00 00 00 00 00 00 00 r1 = 0 llÍgy történik a térképekről szóló információ átadása egy konkrétan betöltött BPF programba. A térkép vagy létrehozható a BPF_MAP_CREATE, vagy a megfelelő ID alapján nyitható meg, BPF_MAP_GET_FD_BY_ID.
Összességében, a következő algoritmus használatos: libbpf a fordítás során a térképekre való hivatkozásokhoz relokációs bejegyzések készülnek,
- megnyitja az ELF objektumot, megtalálja az összes használt térképet és fájlleírókat készít számukra,
libbpfa fájlleírók betöltődnek a kernelbe, mint a- LD64
Ahogy értjük, ez még nem minden, és bele kell néznünk a kernelbe. Szerencsére van egy nyomunk — a forrástartományt beírtuk, és meg tudjuk érinteni, ami elvezet minket a szentélybe —
, ahol egy jellegzetes nevű funkció helyettesíti a fájlleírót a BPF_PSEUDO_MAP_FD struct bpf_map kernel/bpf/verifier.cstatic int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) { ...f = fdget(insn[0].imm); map = __bpf_map_get(f); if (insn->src_reg == BPF_PSEUDO_MAP_FD) { addr = (unsigned long)map; } insn[0].imm = (u32)addr; insn[1].imm = addr >> 32; (a teljes kód megtalálható,:
). Tehát kiegészíthetjük algoritmusunkat:a program betöltésekor a verifier ellenőrzi a térkép helyes használatát, és beírja a megfelelő struktúra címét, Amikor az ELF binálist betöltjük,
- még sok minden történik, de ezt más cikkekben fogjuk megvitatni.
(a teljes kód megtalálható,
Programok és térképek betöltése libbpf nélkül. libbpf Ahogy ígértük, íme egy példa az olvasóknak, akik tudni akarják, hogyan hozhatnak létre és tölthetnek be egy programot, amely térképeket használ, segítség nélkül.
Programok és mappák betöltése libbpf nélkül
Ahogy ígértük, itt egy példa azoknak az olvasóknak, akik szeretnék tudni, hogyan lehet programot kreálni és betölteni, amely mappákat használ, külső segítség nélkül. libbpf. Ez hasznos lehet, amikor olyan környezetben dolgozik, ahol nem tudod összegyűjteni a függőségeket, vagy ahol minden bájtot meg akarsz spórolni, vagy amikor olyan programot írsz, mint , amely BPF bináris kódot generál menet közben.
A logika követése érdekében újraírjuk a példánkat, xdp-simple. A példában tárgyalt program teljes és kissé kibővített kódját megtalálhatod itt: .
Alkalmazásunk logikája a következő:
- létrehozni egy
BPF_MAP_TYPE_ARRAYa parancs segítségévelBPF_MAP_CREATE, - típusú map-ot,
- a programot csatlakoztatni az interfészhez,
lo,
ami emberi nyelven így hangzik:
int main(void)
{
    int map_fd, prog_fd;

    map_fd = map_create();
    if (map_fd < 0)
        err(1, "bpf: BPF_MAP_CREATE");

    prog_fd = prog_load(map_fd);
    if (prog_fd < 0)
        err(1, "bpf: BPF_PROG_LOAD");

    xdp_attach(1, prog_fd);
}
Itt map_create pontosan úgy hozza létre a map-ot, ahogy azt az első példában tettük a rendszerhíváskor, bpf — "kernel, kérlek, készíts nekem egy új map-ot, ami egy 8 elemű, __u64 típusú tömbből áll és adj vissza nekem egy fájl deszkriptort:"
static int map_create()
{
    union bpf_attr attr;

    memset(&attr, 0, sizeof(attr));
    attr.map_type = BPF_MAP_TYPE_ARRAY,
    attr.key_size = sizeof(__u32),
    attr.value_size = sizeof(__u64),
    attr.max_entries = 8,
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    return syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));
}
A program betöltése is egyszerű:
static int prog_load(int map_fd)
{
    union bpf_attr attr;
    struct bpf_insn insns[] = {
        ...
    };

    memset(&attr, 0, sizeof(attr));
    attr.prog_type = BPF_PROG_TYPE_XDP;
    attr.insns     = ptr_to_u64(insns);
    attr.insn_cnt  = sizeof(insns)/sizeof(insns[0]);
    attr.license   = ptr_to_u64("GPL");
    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    return syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));
}
A nehéz része, prog_load — a programunk BPF definíciója struktúrák tömbjeként, struct bpf_insn insns[]. De mivel C nyelven van programunk, kicsit okoskodhatunk:
$ llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
       7:       b7 01 00 00 00 00 00 00 r1 = 0
       8:       15 00 04 00 00 00 00 00 if r0 == 0 goto +4
       9:       61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0)
      10:       07 01 00 00 01 00 00 00 r1 += 1
      11:       63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1
      12:       b7 01 00 00 02 00 00 00 r1 = 2

0000000000000068 :
      13:       bf 10 00 00 00 00 00 00 r0 = r1
      14:       95 00 00 00 00 00 00 00 exit
Tehát 14 utasítást kell írni a struct bpf_insn (típusú struktúrákban. Vegye le a dumpot, olvassa el az utasítások részét, nyissa meg és és próbálja meg meghatározni struct bpf_insn insns[] önállóan):
struct bpf_insn insns[] = {
    /* 85 00 00 00 08 00 00 00 call 8 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 8,
    },

    /* 63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0 */
    {
        .code = BPF_MEM | BPF_STX,
        .off = -4,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_10,
    },

    /* bf a2 00 00 00 00 00 00 r2 = r10 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_10,
        .dst_reg = BPF_REG_2,
    },

    /* 07 02 00 00 fc ff ff ff r2 += -4 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_2,
        .imm = -4,
    },

    /* 18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll */
    {
        .code = BPF_LD | BPF_DW | BPF_IMM,
        .src_reg = BPF_PSEUDO_MAP_FD,
        .dst_reg = BPF_REG_1,
        .imm = map_fd,
    },
    { }, /* placeholder */

    /* 85 00 00 00 01 00 00 00 call 1 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 1,
    },

    /* b7 01 00 00 00 00 00 00 r1 = 0 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 0,
    },

    /* 15 00 04 00 00 00 00 00 if r0 == 0 goto +4  */
    {
        .code = BPF_JMP | BPF_JEQ | BPF_K,
        .off = 4,
        .src_reg = BPF_REG_0,
        .imm = 0,
    },

    /* 61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0) */
    {
        .code = BPF_MEM | BPF_LDX,
        .off = 0,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_1,
    },

    /* 07 01 00 00 01 00 00 00 r1 += 1 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 1,
    },

    /* 63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1 */
    {
        .code = BPF_MEM | BPF_STX,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* b7 01 00 00 02 00 00 00 r1 = 2 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 2,
    },

    /* : bf 10 00 00 00 00 00 00 r0 = r1 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* 95 00 00 00 00 00 00 00 exit */
    {
        .code = BPF_JMP | BPF_EXIT
    },
};
Gyakorlat azoknak, akik ezt nem írták meg maguk — találják meg map_fd.
Még egy felfedésre váró rész maradt a programunkban — xdp_attach. Sajnos, az XDP típusú programok nem csatolhatók rendszerhívás segítségével bpf. Azok az emberek, akik a BPF-et és az XDP-t létrehozták, a Linux hálózati közösségéből származtak, így a számukra legtermészetesebb, de nem a normális emberek) kernel interfész volt: , lásd még . A legegyszerűbb megvalósítás módja xdp_attach — a kód másolása a libbpf, nevezetesen a fájlból , amit mi is megtettünk, kicsit lerövidítve:
Üdvözöljük a netlink socketek világában
Megnyitunk egy netlink socketet a NETLINK_ROUTE:
int netlink_open(__u32 *nl_pid)
{
    struct sockaddr_nl sa;
    socklen_t addrlen;
    int one = 1, ret;
    int sock;

    memset(&sa, 0, sizeof(sa));
    sa.nl_family = AF_NETLINK;

    sock = socket(AF_NETLINK, SOCK_RAW, NETLINK_ROUTE);
    if (sock < 0)
        err(1, "socket");

    if (setsockopt(sock, SOL_NETLINK, NETLINK_EXT_ACK, &one, sizeof(one)) < 0)
        warnx("netlink error reporting not supported");

    if (bind(sock, (struct sockaddr *)&sa, sizeof(sa)) < 0)
        err(1, "bind");

    addrlen = sizeof(sa);
    if (getsockname(sock, (struct sockaddr *)&sa, &addrlen) < 0)
        err(1, "getsockname");

    *nl_pid = sa.nl_pid;
    return sock;
}
Olvasás egy ilyen socketből:
static int bpf_netlink_recv(int sock, __u32 nl_pid, int seq)
{
    bool multipart = true;
    struct nlmsgerr *errm;
    struct nlmsghdr *nh;
    char buf[4096];
    int len, ret;

    while (multipart) {
        multipart = false;
        len = recv(sock, buf, sizeof(buf), 0);
        if (len nlmsg_pid != nl_pid)
                errx(1, "wrong pid");
            if (nh->nlmsg_seq != seq)
                errx(1, "INVSEQ");
            if (nh->nlmsg_flags & NLM_F_MULTI)
                multipart = true;
            switch (nh->nlmsg_type) {
                case NLMSG_ERROR:
                    errm = (struct nlmsgerr *)NLMSG_DATA(nh);
                    if (!errm->error)
                        continue;
                    ret = errm->error;
                    // libbpf_nla_dump_errormsg(nh); too many code to copy...
                    goto done;
                case NLMSG_DONE:
                    return 0;
                default:
                    break;
            }
        }
    }
    ret = 0;
done:
    return ret;
}
Végül itt van a funkciónk, amely megnyit egy socketet és küld bele egy speciális üzenetet, amely fájl leírót tartalmaz:
static int xdp_attach(int ifindex, int prog_fd)
{
    int sock, seq = 0, ret;
    struct nlattr *nla, *nla_xdp;
    struct {
        struct nlmsghdr  nh;
        struct ifinfomsg ifinfo;
        char             attrbuf[64];
    } req;
    __u32 nl_pid = 0;

    sock = netlink_open(&nl_pid);
    if (sock nla_type = NLA_F_NESTED | IFLA_XDP;
    nla->nla_len = NLA_HDRLEN;

    /* add XDP fd */
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FD;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(int);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &prog_fd, sizeof(prog_fd));
    nla->nla_len += nla_xdp->nla_len;

    /* if user passed in any flags, add those too */
    __u32 flags = XDP_FLAGS_SKB_MODE;
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FLAGS;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(flags);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &flags, sizeof(flags));
    nla->nla_len += nla_xdp->nla_len;

    req.nh.nlmsg_len += NLA_ALIGN(nla->nla_len);

    if (send(sock, &req, req.nh.nlmsg_len, 0) < 0)
        err(1, "send");
    ret = bpf_netlink_recv(sock, nl_pid, seq);

cleanup:
    close(sock);
    return ret;
}
Most már minden készen áll a tesztelésre:
$ cc nolibbpf.c -o nolibbpf
$ sudo strace -e bpf ./nolibbpf
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, map_name="woo", ...}, 72) = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=15, prog_name="woo", ...}, 72) = 4
+++ exited with 0 +++
Nézzük meg, csatlakozott-e a programunk a lo:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 160
Küldjünk pingeket és nézzük meg a map-ot:
$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
$ sudo bpftool m dump name woo
key: 00 00 00 00  value: 90 01 00 00 00 00 00 00
key: 01 00 00 00  value: 00 00 00 00 00 00 00 00
key: 02 00 00 00  value: 00 00 00 00 00 00 00 00
key: 03 00 00 00  value: 00 00 00 00 00 00 00 00
key: 04 00 00 00  value: 00 00 00 00 00 00 00 00
key: 05 00 00 00  value: 00 00 00 00 00 00 00 00
key: 06 00 00 00  value: 40 b5 00 00 00 00 00 00
key: 07 00 00 00  value: 00 00 00 00 00 00 00 00
Found 8 elements
Hurrá, minden működik. Érdemes megjegyezni, hogy a mapunk ismét bájtokban jelenik meg. Ez azért van, mert ellentétben libbpf nem töltöttük be a típusinformációkat (BTF). De erről részletesebben a következő alkalommal fogunk beszélni.
Fejlesztési eszközök
Ebben a szakaszban megnézzük a minimális BPF fejlesztői eszközkészletet.
Általánosságban elmondható, hogy BPF programok fejlesztéséhez nincs szükség különös dologra - a BPF bármely megfelelő disztribúciójú kernelén működik, a programok pedig a következő segítségével fordíthatók össze. clang, amely telepíthető a csomagból. Azonban mivel a BPF fejlesztés alatt áll, a kernel és az eszközök folyamatosan változnak. Ha nem szeretnél 2019-es módszerekkel BPF programokat írni, össze kell állítanod
llvm/clangpahole- a saját kernel-edet
bpftool
(Tájékoztatásul: ez a szakasz és minden példa a cikkben Debian 10-en futott.)
llvm/clang
A BPF kompatibilis az LLVM-mal, és bár az utóbbi időben a BPF programok gcc segítségével is összeállíthatók, minden aktuális fejlesztés az LLVM-re összpontosít. Ezért először az aktuális verziót állítjuk össze clang a git-ből:
$ sudo apt install ninja-build
$ git clone --depth 1 https://github.com/llvm/llvm-project.git
$ mkdir -p llvm-project/llvm/build/install
$ cd llvm-project/llvm/build
$ cmake .. -G "Ninja" -DLLVM_TARGETS_TO_BUILD="BPF;X86"
                      -DLLVM_ENABLE_PROJECTS="clang"
                      -DBUILD_SHARED_LIBS=OFF
                      -DCMAKE_BUILD_TYPE=Release
                      -DLLVM_BUILD_RUNTIME=OFF
$ time ninja
... sok idő múlva
$
Most ellenőrizhetjük, hogy mindent helyesen állítottunk-e össze:
$ ./bin/llc --version
LLVM (http://llvm.org/):
  LLVM verzió 11.0.0git
  Optimalizált build.
  Alapértelmezett cél: x86_64-unknown-linux-gnu
  Gazda CPU: znver1

  Regisztrált célok:
    bpf    - BPF (host endian)
    bpfeb  - BPF (big endian)
    bpfel  - BPF (little endian)
    x86    - 32-bites X86: Pentium-Pro és felette
    x86-64 - 64-bites X86: EM64T és AMD64
(A build utasítást clang én innen vettem .)
Nem fogjuk telepíteni az éppen megépített programokat, hanem egyszerűen hozzáadjuk őket a PATH, például:
export PATH="`pwd`/bin:$PATH"(Ezt hozzá lehet adni a .bashrc vagy egy külön fájlba. Én személy szerint az ilyesmit a ~ /bin/activate-llvm.sh a szükséges időpontban aktiválom . activate-llvm.sh.)
A Pahole és a BTF
Eszköz pahole a kernel buildelésekor a BTF formátumú hibakeresési információk létrehozására szolgál. A cikkünkben nem fogunk részletesen foglalkozni a BTF technológiával, azon kívül, hogy ez hasznos, és szeretnénk használni. Ezért ha saját kernelt szeretnél építeni, először össze kell állítanod pahole (nélkül pahole nem tudsz kernelt összeállítani azzal a beállítással, CONFIG_DEBUG_INFO_BTF:
$ git clone https://git.kernel.org/pub/scm/devel/pahole/pahole.git
$ cd pahole/
$ sudo apt install cmake
$ mkdir build
$ cd build/
$ cmake -D__LIB=lib ..
$ make
$ sudo make install
$ which pahole
/usr/local/bin/pahole
Kernel kísérletezéshez a BPF-vel
A BPF lehetőségeinek kutatásakor érdemes lehet saját magunk összerakni a kernelt. Ez egyébként nem kötelező, mivel a BPF programok összerakását és betöltését még a disztribúciós kernel alatt is el lehet végezni, azonban a saját kernelünk lehetővé teszi a legújabb BPF funkciók használatát, amelyek a disztribúcióban legjobb esetben hónapok múlva, vagy bizonyos hibakereső eszközök esetében egyáltalán nem jelennek meg a közeljövőben. A saját kernel birtoklása emellett lehetőséget ad a kód kísérletezésére is.
A kernel összerakásához szükség van egyrészt magára a kernelre, másrészt a kernel konfigurációs fájlra. A BPF kísérletezéshez használhatunk egy normál kernelt vagy egy fejlesztői kernelt. A BPF fejlesztése történelmileg a Linux hálózati közösség keretein belül valósul meg, ezért a változások idővel mind átmennek David Miller (David Miller) kezén, aki a Linux hálózati részének karbantartója. A természetük szerint — javítás vagy új funkciók — a hálózati változások az egyik két kernelbe kerülnek — vagy . A BPF-hez kapcsolódó változások hasonló módon oszlanak meg a és , amelyek később a netbe és a net-nextbe kerülnek, megfelelően. További részletek a és . Tehát válaszd a kernelt az ízlésed és az tesztelésre használt rendszered stabilitásának igénye szerint (*-next kernelt a leginstabilabbak közé tartoznak).
E cikk keretein belül nem térünk ki a kernel konfigurációs fájlok kezelésére — azt feltételezzük, hogy vagy már tudod, hogyan kell ezt csinálni, vagy önállóan. Az alábbi utasítások azonban többé-kevésbé elegendőek lesznek ahhoz, hogy egy működő rendszert építs ki BPF támogatással.
Töltsd le az előbb említett kernelt:
$ git clone git://git.kernel.org/pub/scm/linux/kernel/git/bpf/bpf-next.git
$ cd bpf-next
Összeállítani a minimális működő kernel konfigurációt:
$ cp /boot/config-`uname -r` .config
$ make localmodconfig
Kapcsolj be BPF opciókat a .config fájlban, ahogy szeretnéd (valószínűleg a CONFIG_BPF már be lesz kapcsolva, mivel a systemd ezt használja). Íme, a cikkben használt kernel opcióinak listája:
CONFIG_CGROUP_BPF=y
CONFIG_BPF=y
CONFIG_BPF_LSM=y
CONFIG_BPF_SYSCALL=y
CONFIG_ARCH_WANT_DEFAULT_BPF_JIT=y
CONFIG_BPF_JIT_ALWAYS_ON=y
CONFIG_BPF_JIT_DEFAULT_ON=y
CONFIG_IPV6_SEG6_BPF=y
# CONFIG_NETFILTER_XT_MATCH_BPF is not set
# CONFIG_BPFILTER is not set
CONFIG_NET_CLS_BPF=y
CONFIG_NET_ACT_BPF=y
CONFIG_BPF_JIT=y
CONFIG_BPF_STREAM_PARSER=y
CONFIG_LWTUNNEL_BPF=y
CONFIG_HAVE_EBPF_JIT=y
CONFIG_BPF_EVENTS=y
CONFIG_BPF_KPROBE_OVERRIDE=y
CONFIG_DEBUG_INFO_BTF=y
Ezután könnyen összegyűjthetjük és telepíthetjük a modulokat és a kernelt (egyébként a kernelt egy frissen összeállított clang, hozzáadva CC=clang):
$ make -s -j $(getconf _NPROCESSORS_ONLN)
$ sudo make modules_install
$ sudo make install
és újraindulhatunk az új kernellel (én ezt használom kexec csomagból kexec-tools):
v=5.8.0-rc6+ # ha az aktuális kernelt állítja össze, akkor v=`uname -r`
sudo kexec -l -t bzImage /boot/vmlinuz-$v --initrd=/boot/initrd.img-$v --reuse-cmdline &&
sudo kexec -e
bpftool
A cikkben leggyakrabban használt eszköz az lesz bpftool, amely a Linux kernel részeként érkezik. Ezt a BPF fejlesztői írták és támogatják, és segítségével kezelhetjük az összes BPF objektumot – programok betöltése, map-ek létrehozása és módosítása, a BPF ökoszisztéma működésének vizsgálata stb. A dokumentáció forráskód formájában a man pages-hez megtalálható vagy már lefordítva, .
A cikk írásának időpontjában bpftool kész formában csak RHEL, Fedora és Ubuntu rendelkezik róla (például lásd , amely a csomagolás befejezetlen történetét meséli el bpftool Debianban). De ha már összeállította a kernelt, akkor összebontani bpftool nagyon egyszerű:
$ cd ${linux}/tools/bpf/bpftool
# ... adja meg az utakat a legutolsó clang-hoz, ahogy fentebb említettem
$ make -s

Rendszerfunkciók automatikus érzékelése:
...                        libbfd: [ be  ]
...        disassembler-four-args: [ be  ]
...                          zlib: [ be  ]
...                        libcap: [ be  ]
...               clang-bpf-co-re: [ be  ]

Rendszerfunkciók automatikus érzékelése:
...                        libelf: [ be  ]
...                          zlib: [ be  ]
...                           bpf: [ be  ]

$
(itt ${linux} — a kerneldirektóriód.) Ezeknek a parancsoknak a végrehajtása után bpftool az ${linux}/tools/bpf/bpftool könyvtárban fog összeállni, és ezt be lehet állítani az útvonalban (elsősorban a felhasználónak ) vagy egyszerűen át lehet másolni a , felhasználó nevében fut, mivel alapvető rendszerbeállításokat módosítanak, de a WordPress közvetlenül egy normál felhasználóként működik.Az összeszerelést /usr/local/sbin.
a legutolsó által érdemes végezni, amelyet fent említettem, és ellenőrizni lehet, hogy helyesen állt-e össze, például a következő parancs segítségével: bpftool $ sudo bpftool feature probe kernel Rendszer konfigurációjának vizsgálata... bpf() syscall nem privát felhasználók számára engedélyezve JIT fordító engedélyezve JIT fordító megerősítés letiltva JIT fordító kallsyms exportálva a root számára ... clangamely megmutatja, milyen funkciók kapcsoltak be a kernelében.
Egyébként az előző parancsot lehet futtatni úgy, hogyEz az eszközök csomagjaira hasonlít
Egyébként az előző parancsot úgy is futtathatjuk, mint
# bpftool f p kEz a csomagban található hasznos programok analógiájára készült. iproute2, ahol például elmondhatjuk ip a s eth0 $CI_COMMIT_TAG ip addr show dev eth0.
Zárás
A BPF lehetővé teszi a hatékony mérést és a kernel funkcionalitásának módosítását valós időben. A rendszer nagyon sikeres lett, az UNIX legjobb hagyományainak megfelelően: egy egyszerű mechanizmus, amely lehetővé tette a kernel (újra)programozását, sok ember és szervezet számára nyújtott lehetőséget a kísérletezésre. Bár a kísérletezés, akárcsak a BPF infrastruktúrájának fejlődése, még nem ért véget, a rendszer már stabil ABI-t kínál, amely lehetővé teszi megbízható, legfőképpen hatékony üzleti logika kialakítását.
Szeretném megjegyezni, hogy véleményem szerint a technológia népszerűsége részben abból fakad, hogy egyrészt lehet vele játszani (a gép architektúráját nagyjából egy este alatt meg lehet érteni), másrészt pedig olyan problémákat oldhatunk meg, amelyeket (szépen) nem lehetett megoldani a megjelenése előtt. E két összetevő együtt arra ösztönzi az embereket, hogy kísérletezzenek és álmodjanak, ami újabb és újabb innovatív megoldások megjelenéséhez vezet.
Ez a cikk, bár nem lett túl rövid, csak bevezetés a BPF világába, és nem írja le a "haladó" lehetőségeket és fontos architekturális elemeket. A további terv körülbelül a következő: a következő cikk a BPF programok típusaival foglalkozik (az 5.8-as kernel 30 programtípust támogat), utána végre megnézzük, hogyan lehet valódi alkalmazásokat írni BPF-re, kernel trace programok példáján keresztül, majd jön a mélyebb kurzus a BPF architektúráról, végül pedig a BPF hálózati és biztonsági alkalmazásokról szóló példák.
E ciklus korábbi cikkei
Hivatkozások
— a BPF dokumentációja a cilium-tól, pontosabban Daniel Borkmantól, a BPF egyik megalkotójától és karbantartójától. Ez az egyik első komoly leírás, ami abban különbözik a többitől, hogy Daniel pontosan tudja, miről beszél, és nincsenek benne hibák. Különösen ebben a dokumentumban arról van szó, hogyan kell dolgozni az XDP és TC típusú BPF programokkal egy ismert segédprogram segítségével.
ipcsomagbóliproute2.— az eredeti fájl a klasszikus, majd az extended BPF dokumentációjáról. Hasznos olvasni, ha bele akarsz ásni az assemblerbe és az architektúra technikai részleteibe.
. Ritkán frissül, de pontos, mivel Alexei Starovoitov (az eBPF szerzője) és Andrii Nakryiko (karbantartó) írnak bele.
libbpf).. Érdekes Twitter-szál Quentin Monnet-tól, amely a bpftool használatának példáit és titkait tartalmazza.
. Egy hatalmas (és még mindig karbantartott) linkgyűjtemény a BPF dokumentációjáról Quentin Monnet-től.
Forrás: habr.com
