

Mivel a ClickHouse egy specializált rendszer, fontos figyelembe venni az architektúrájának sajátosságait a használata során. Ebben a beszámolóban Alexej tipikus hibás példákról fog beszélni, amelyek a ClickHouse használatával kapcsolatosak, és amelyek a hatékonyság csökkenéséhez vezethetnek. A gyakorlat példáin keresztül megmutatjuk, hogy az adatok feldolgozásának különböző sémái miként változtathatják meg a teljesítmény mértékét.
Üdv mindenkinek! A nevem Alexej, a ClickHouse-t fejlesztem.
Először is, örömmel közlöm, hogy ma nem fogom elmondani, mi a ClickHouse. Őszintén szólva már unom ezt. Minden alkalommal elmondom, hogy mi ez. És valószínűleg már mindenki tudja.
Ehelyett arról fogok beszélni, hogy milyen buktatók vannak, azaz hogyan lehet helytelenül használni a ClickHouse-t. Valójában nem érdemes félni, mert a ClickHouse-t úgy fejlesztjük, mint egy egyszerű, kényelmes rendszert, ami dobozból kivéve működik. Feltelepíted, és kész, nincsenek problémák.
De mindenképpen figyelembe kell venni, hogy ez a rendszer specializált, és könnyen találkozhatunk szokatlan használati forgatókönyvekkel, amelyek a rendszert kényelmetlen helyzetbe hozhatják.
Tehát, mik a buktatók? Főként nyilvánvaló dolgokról fogok beszélni. Mindenkinek evidens, mindenki ért mindent, és örülnek annak, hogy ilyen okosak, míg akik nem értik, új dolgokat tanulnak.
Az első és legnyilvánvalóbb példa, amit sajnos gyakran tapasztalunk, a sok kis batch-ből álló insert, tehát sok kis insert.
Ha megvizsgáljuk, hogyan hajtja végre a ClickHouse az insertet, akkor egyetlen kérés keretében akár terabájt adatfolyamot is küldhetsz. Ez nem probléma.
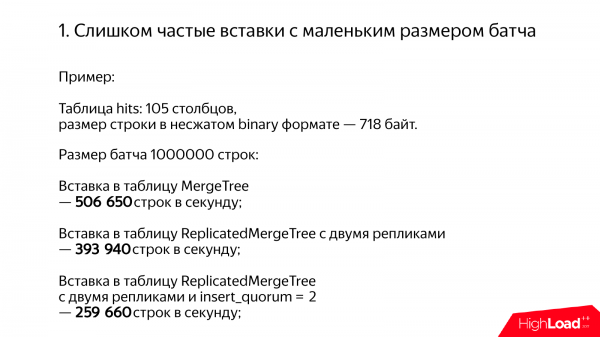
Nézzük meg, hogyan néz ki a tipikus teljesítmény. Például, van egy táblánk a Yandex.Metrikából. Találatok. 105 oszlopa van. 700 byte tömörítetlenül. És akkor egy millió sort fogunk batchenként korrekt módon beszúrni.
A MergeTree táblába történő beszúrással félmillió sort kapunk másodpercenként. Remek. A replikált táblába – egy kicsit kevesebbet, körülbelül 400 000 sort másodpercenként.
Ha kvórum beszúrást használunk, az egy kicsit kevesebb lesz, de még mindig tisztességes teljesítmény, 250 000 sort másodpercenként. A kvórum beszúrás egy nem dokumentált lehetőség a ClickHouse*-ban.
* 2020-as állapot szerint, .
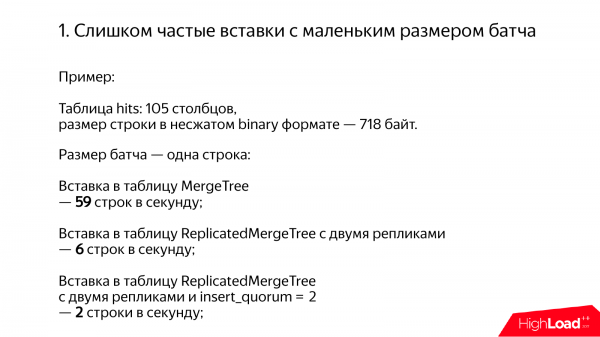
Mi fog történni, ha rosszul csináljuk? Egyesével beszúrva a MergeTree táblába 59 sor másodpercenként. Ez 10 000-szer lassabb. A ReplicatedMergeTree-nél 6 sor másodpercenként. Ha pedig a kvórum is bekapcsolódik, akkor 2 sor másodpercenként. Véleményem szerint ez egy katasztrofális helyzet. Hogyan lehetséges ennyire belassulni? Még a pólómon is úgy van írva, hogy a ClickHouse-nak nem szabad elakadnia. De néha mégis előfordul.
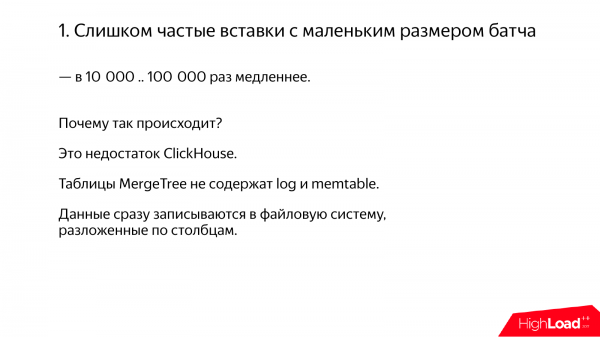
Valójában ez a mi hibánk. Teljesen meg tudtuk volna csinálni, hogy minden jól működjön, de nem tettük. És nem tettük, mert a mi forgatókönyvünkben erre nem volt szükség. Így is voltak batch-ünk. Csak bejöttek a batch-ek, és nem volt probléma. Beszúrjuk, és minden rendben működik. De persze különféle forgatókönyvek lehetségesek. Például amikor rengeteg szerver van, ahol az adatok generálódnak. És ritkábban szúrnak be adatokat, de így is gyakori beszúrások keletkeznek. Ezt valahogyan el kell kerülni.
Technikai szempontból a lényeg az, hogy amikor insert-et hajt végre a ClickHouse-ban, az adatok nem kerülnek memtable-be. Nálunk valójában nincs valós log structure MergeTree, hanem egyszerűen MergeTree, mert nincs sem log, sem memTable. Az adatokat közvetlenül a fájlrendszerbe írjuk, már oszlopok szerint rendezve. Ha 100 oszlop van, akkor több mint 200 fájlt kell majd írni egy külön könyvtárba. Ez az egész meglehetősen terjedelmes.
És felmerül a kérdés: "Hogyan kell helyesen csinálni?", ha olyan helyzet áll elő, hogy mindenképpen valahogyan adatokat kell írni a ClickHouse-ba.
1. módszer. Ez a legegyszerűbb mód. Használjon valamilyen elosztott üzenetsorozatot. Például Kafka. Csak kiemeli az adatokat a Kafkából, batch-eli másodpercenként. És minden rendben lesz, írja be, minden jól működik.
A hátrányok az, hogy a Kafka egy újabb terjedelmes elosztott rendszer. Még értem, ha a cégében már van Kafka. Ez jó, ez kényelmes. De ha nincs, akkor érdemes háromszor is megfontolni, mielőtt még egy elosztott rendszert hozna a projektjébe. Így alternatívákat kell keresni.
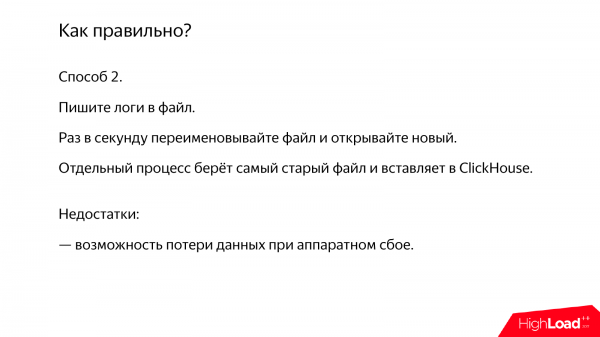
Módszer 2. Itt van egy régi iskola alternatíva, ami nagyon egyszerű. Van egy szervered, ami generálja a naplóidat. Ez egyszerűen kiírja a naplóidat egy fájlba. És másodpercenként, például átnevezzük ezt a fájlt, és új fájlt nyitunk. Egy külön szkript vagy cron, vagy valamilyen daemon pedig elviszi a legöregebb fájlt, és beírja a ClickHouse-ba. Ha a naplókat másodpercenként írjuk, akkor minden jól fog működni.
De ennek a módszernek a hátránya, hogy ha a szervered, ahol a naplókat generálják, eltűnik, akkor az adatok is eltűnnek.
Módszer 3. Van még egy érdekes módszer, ami teljesen időszakos fájlok nélkül működik. Például van egy reklámforgató vagy valamilyen érdekes daemon, ami adatokat generál. És te egy csomó adatot felhalmozhatsz közvetlenül a memóriában, a bufferben. Amikor elegendő idő telik el, ezt a buffert félreteszed, újat hozol létre, és egy külön szálban az összegyűlt adatokat beírod a ClickHouse-ba.
Másrészről viszont az adatok a kill -9 parancs alatt is eltűnnek. Ha a szervered leáll, akkor ezeket az adatokat elveszíted. Egy másik probléma pedig az, hogy ha nem tudtál beírni az adatbázisba, akkor az adatok felhalmozódnak a memóriában. És vagy elfogy a memória, vagy egyszerűen elveszíted az adatokat.
Módszer 4. Van egy másik érdekes módszer. Van egy szerveroldali folyamatod. És ez a folyamat azonnal küldhet adatokat a ClickHouse-ba, de ezt egyetlen kapcsolatban kell megtennie. Például HTTP-kérést küldött transfer-encoding: chunked-tel egy insert-tel. És a darabokat már nem túl ritkán generálja, lehet, hogy minden egyes sort elküld, bár ez túlterhelést jelent az adatok keretezésénél.
De ennek ellenére ebben az esetben az adatok azonnal el lesznek küldve a ClickHouse-ba. És a ClickHouse magától fogja ezeket a bufferelni.
De ez is problémákat okoz. Most elveszítheted az adatokat, különösen, ha a folyamatod megölődik, és ha a ClickHouse folyamata megölődik, mert ez egy befejezetlen insert lesz. A ClickHouse-ban az insert-ek atomikusak egy bizonyos sormennyiségig. Elvileg ez egy érdekes módszer. Ezt is lehet használni.
5. módszer. Itt van még egy érdekes módszer. Ez egy közösség által fejlesztett szerver az adatok batch-eltetéséhez. Én magam nem néztem meg, ezért semmit sem tudok garantálni. Azonban a ClickHouse esetében sem adnak garanciát. Ez is nyílt forráskódú, de másrészt lehet, hogy megszoktad a minőségi standardokat, amelyeket megpróbálunk biztosítani. Ezzel kapcsolatban viszont nem tudom, nézz utána a GitHub-on, nézd meg a kódot. Talán írtak valamit normálisat.
* 2020-as állapot szerint, azt is érdemes megfontolni .
6. módszer. Egy másik módszer a Buffer táblák használata. Ennek a módszernek az előnye, hogy nagyon egyszerű elkezdeni. Létrehozol egy Buffer táblát, és beilleszted az adatokat.
A hátránya viszont az, hogy a probléma nem oldódik meg teljesen. Ha az inserálás MergeTree típusú, akkor egy másodperc alatt egy batch-re kell csoportosítanod az adatokat, de Buffer táblába való beillesztéskor legalább több ezerre kell csoportosítanod másodpercenként. Ha ez meghaladja a 10 000-et másodpercenként, akkor az is rossz. Ha pedig batch-ként illesztesz, akkor azt láttad, hogy ott százas ezrek sor van másodpercenként. És ez már elég nehéz adatokkal.
A Buffer táblák nem rendelkeznek loggal sem. Ha valami gond van a szervereddel, akkor az adatok el fognak veszni.
És bónuszként nemrégiben a ClickHouse-ban megjelent a lehetőség, hogy adatokat nyerjünk ki a Kafka-ból. Van egy Kafka nevű táblagépként ismert motor. Csak létrehozod, és anyagolt nézeteket is lehet hozzá csatolni. Ebben az esetben automatikusan kivonja az adatokat a Kafka-ból, és beszúrja a kívánt táblákba.
És különösen örvendetes ebben a lehetőségben, hogy ezt nem mi csináltuk. Ez egy közösségi funkció. Amikor azt mondom, hogy "közösségi funkció", erre semmiféle megvetéssel nem utalok. A kódot átnéztük, a felülvizsgálatokat elvégeztük, normálisan kell működnie.
* 2020-as állapot szerint, hasonló támogatás jelent meg .
Milyen más kényelmetlenségek vagy váratlan dolgok merülhetnek fel az adatok beszúrásakor? Ha insert values kérést végzel, és a values-ban valamilyen számított kifejezés található. Például a now() is egy számított kifejezés. Ilyen esetben a ClickHouse-nak minden egyes sorra el kell indítania ezen kifejezések értelmezőjét, és a teljesítmény jelentősen csökken. Jobb ezt elkerülni.
* Jelenleg a problémát teljesen megoldották, a teljesítmény visszaesése a VALUES kifejezések használatakor már nincs.
Egy másik példa, amikor problémák merülhetnek fel, ha egy batch-ben az adatok számos partícióhoz tartoznak. Alapértelmezés szerint a ClickHouse-ban a partíciók hónapokra vannak osztva. Ha egy millió soros batch-t szúrsz be, és azok több évnyi adatot tartalmaznak, akkor több tucat partíciód lesz. Ez azt jelenti, hogy a batch-ek több tucat mérettel kisebbek lesznek, mert belül mindig először a partíciók szerint osztódnak.
* Nemrégiben a ClickHouse-ban kísérleti módban bevezették a szegmensek és a memóriaalapú szegmensek tömörített formátumának támogatását write-ahead log-gal, ami szinte teljesen megoldja a problémát.
Most nézzük meg a problémák második típusát – az adatok típusát.
Az adatok típusa lehet szigorú, vagy karakterlánc. A karakterlánc az, amikor egyszerűen csak bejelented, hogy minden meződ string típusú. Ez pocsék. Ezt nem szabad csinálni.
Nézzük meg, hogyan lehet helyesen csinálni olyan esetekben, amikor szeretnénk mondani, hogy egy mezőnk karakterlánc, és hagyjuk, hogy a ClickHouse maga megoldja, én nem akarok ezzel foglalkozni. De mindenképpen érdemes némi erőfeszítést tenni.
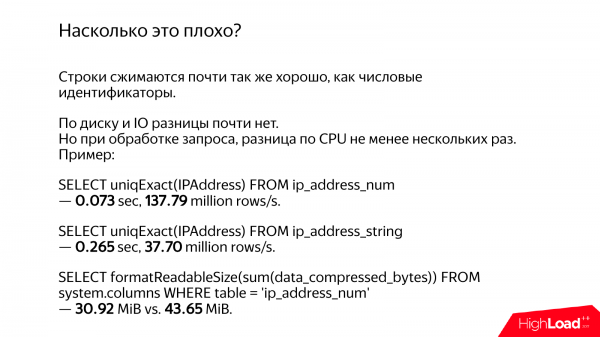
Például van egy IP-címünk. Az egyik esetben string-ként tároltuk, például 192.168.1.1. A másik esetben pedig UInt32* típusú szám lesz. A 32 bit elegendő az IPv4 címekhez.
Először is, nem meglepő módon, az adatok körülbelül azonos mértékben tömörülnek. Lesz különbség, persze, de nem túl nagy. Tehát a lemez be- és kimenetével nem lesznek különösebb problémák.
De jelentős különbség van a processzorteljesítmény és a lekérdezés végrehajtási ideje között.
Számítsuk ki az egyedi IP-címek számát, ha számok formájában tároljuk őket. Ez 137 millió sort jelent másodpercenként. Ugyanez stringek formájában 37 millió sor másodpercenként. Nem tudom, miért jött ki ilyen egyezés. Én magam hajtottam végre ezeket a lekérdezéseket. De mindenesetre körülbelül 4-szer lassabb.
Ha pedig a lemezhely különbségét nézzük, akkor ott is van eltérés. A különbség körülbelül egynegyed, mert elég sok egyedi IP-cím van. És ha itt olyan sorok lennének, amelyekben kevés különböző érték található, akkor azok nyugodtan tömörülhettek volna szótár formájában, körülbelül azonos méretre.
És a négyes időeltolódás az úton nem tűnik el. Talán önnek ez nem számít, de amikor ilyen különbséget látok, szomorú leszek.
Nézzük meg a különböző eseteket.
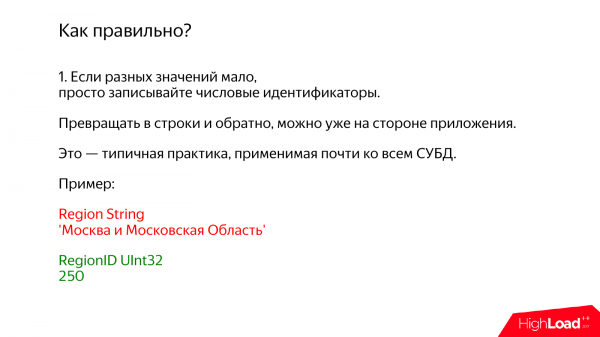
1. Egy eset, amikor csak néhány különböző egyedi értéke van. Ebben az esetben egy egyszerű gyakorlatot alkalmazunk, amit valószínűleg ismer és bárhol használhat bármilyen adatbázis-kezelő rendszerben. Ez nem csak a ClickHouse-ra vonatkozik. Egyszerűen beírja a számokat az adatbázisba. A karakterláncokra történő konvertálás már a saját alkalmazásának oldalán történhet.
Például, van egy régiója. És megpróbálja karakterláncként tárolni. Azt fogja róla írni: Moszkva és MO. Amikor azt látom, hogy «Moszkva», az még semmi, de amikor már MO is, akkor valahogy nagyon szomorú leszek. Mennyi bájt ez már.
Ehelyett egyszerűen eltárolunk egy Ulnt32 számot és 250-et. Nálunk 250 található a Yandexban, de önnél talán más. Egy kis elővigyázatosságként elmondom, hogy a ClickHouse-ban van beépített lehetőség a geoadatbázisok kezelésére. Csak beírja a régiókat, beleértve a hierarchikusakat is, tehát ott lesz Moszkva, MO, és minden, amire szüksége van. A lekérdezés szintjén konvertálható.
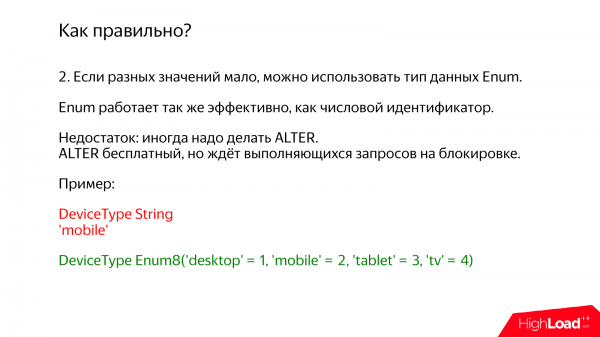
A második megoldás körülbelül hasonló, de már a ClickHouse-on belüli támogatással rendelkezik. Ez az Enum adattípus. Egyszerűen felsorolja az összes szükséges értéket az Enum-on belül. Például az eszköz típusa, és ott van: asztali, mobil, tablet, tévé. Összesen 4 változat.
A hátrány az, hogy időnként módosítani kell. Csak egy új opciót adtunk hozzá. Módosítsa a táblát. Valójában a ClickHouse-ban a tábla módosítása ingyenes. Különösen ingyenes az Enum esetében, mert az adatok a lemezen nem változnak. Ennek ellenére a módosítás zárolja a táblát és várnia kell, amíg minden SELECT végrehajtódik. Csak ezután hajtódik végre a módosítás, tehát lényegében bizonyos kellemetlenségek vannak.
* Az újabb ClickHouse verziókban az ALTER teljesen blokkolásmentes.
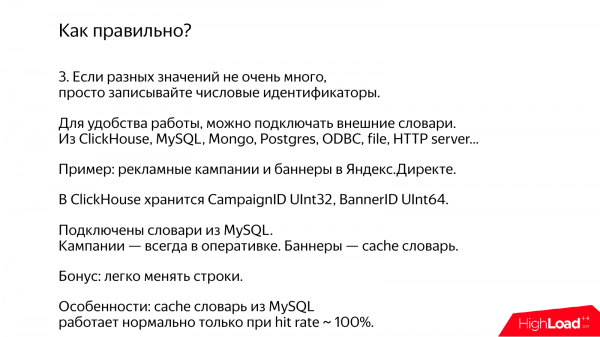
Még egy meglehetősen egyedi megoldás a ClickHouse számára – külső szótárak csatlakoztatása. Írhat számokat a ClickHouse-ba, míg az Ön szótárai bármilyen kényelmes rendszerben tárolhatók. Például használhat: MySQL, Mongo, Postgres. Még egy saját mikroszolgáltatást is létrehozhat, amely http-n keresztül adja vissza ezeket az adatokat. A ClickHouse szintjén egy funkciót ír, amely átalakítja ezeket az adatokat számokból karakterláncokká.
Ez egy specializált, de nagyon hatékony módja annak, hogy csatlakoztassunk egy külső táblázathoz. Ráadásul két lehetőség van. Az egyik lehetőség, hogy ezek az adatok teljesen gyorsítótárazva vannak, teljes mértékben a memóriában és egy bizonyos időközönként frissülnek. A másik lehetőség, ha ezek az adatok nem férnek el a memóriában, akkor részlegesen lehet őket gyorsítótárazni.
Itt egy példa. Van a Yandex.Direct. Ott van egy reklámkampány és bannerek. A reklámkampányokból valószínűleg körülbelül tízmillió van. Ezek eltárolhatók a memóriában. A bannerekből viszont milliárdok vannak, ezek nem férnek el. És használunk egy gyorsítótárazott szótárt a MySQL-ből.
Az egyetlen probléma az, hogy a gyorsítótárazott szótár csak akkor működik jól, ha a találati arány közel 100%-os. Ha ennél alacsonyabb, akkor minden adatcsomag feldolgozásakor valósággal kell beszerezni a hiányzó kulcsokat és adatokat kell kérni a MySQL-ból. A ClickHouse-ra még azt mondhatom, hogy igen, nem lassul le, más rendszerekről nem beszélnék.
Bónuszként az is előny, hogy a szótárak nagyon egyszerű módot kínálnak az adatok frissítésére a ClickHouse-ban a múltban. Tehát ha volt egy jelentése a reklámkampányokról, a felhasználó egyszerűen megváltoztatja a reklámkampányt, és az összes régi adatban, az összes jelentésben ezek az adatok szintén megváltoznak. Ha közvetlenül a táblázatba írunk sorokat, akkor frissíteni őket lehetetlen lesz.
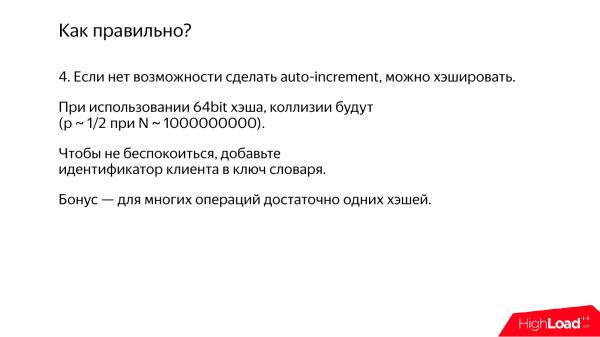
Még egy módja van, amikor nem tudja, honnan szerezzen azonosítókat a soraidhoz. Egyszerűen csak hash-elheti őket. Ráadásul a legegyszerűbb megoldás, ha egy 64 bites hash-t használ.
Az egyetlen probléma az, hogy ha a hash 64 bites, akkor ütközések szinte biztosan elő fognak fordulni. Mert ha milliárd sor van, a valószínűség már érezhetővé válik.
És nem lenne túl jó így hash-elni a reklámkampányok nevét. Ha a reklámkampányok különböző cégeknél összezavarodnak, akkor valami érthetetlen dolog fog kisülni.
És van egy egyszerű trükk. Igaz, a komoly adatokhoz nem nagyon megfelelő, de ha valami nem annyira komoly, akkor egyszerűen csak adjunk hozzá a szótár kulcsához egy ügyfél azonosítót. És akkor ütközések lesznek, de csak egy ügyfél keretein belül. Ilyen módszert használunk a hivatkozások térképén a Yandex.Metrikában. Ott vannak url-ek, tároljuk a hash-eket. És tudjuk, hogy természetesen léteznek ütközések. De amikor a lap megjelenik, akkor a valószínűsége annak, hogy egy lapon belül egy felhasználónál valamilyen url-ök összekapcsolódnak és ezt még észre is veszik, elhanyagolható.
Bónuszként - sok művelethez elegendő csak a hashek, és magukat a szövegeket nem is szükséges tárolni sehol.
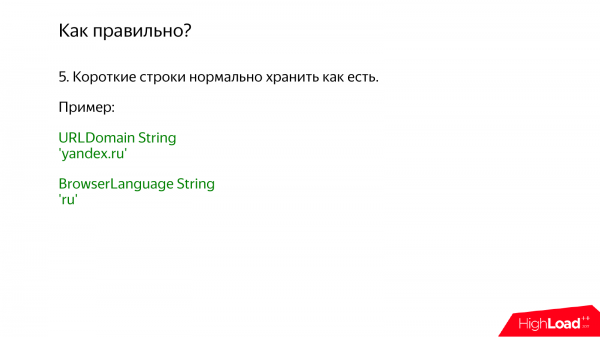
Egy másik példa, ha a szövegek rövidek, például a weboldalak domainjei. Azokat tárolhatjuk úgy, ahogy vannak. Vagy például, ha a böngésző nyelve ru - 2 bájt. Persze nagyon sajnálom a kis bájtokat, de ne aggódjon, a 2 bájt nem veszteség. Kérem, tárolja azokat így, ne bonyolítsa.
Más helyzet, amikor éppen ellenkezőleg, nagyon sok sor van, és azokban sok egyedi is, sőt a potenciálisan nem korlátozott mennyiség. A tipikus példa - keresési kifejezések vagy url-ek. Keresési kifejezések, beleértve a gépelési hibákat is. Nézzük meg, hány egyedi keresési kifejezés van naponta. És kiderül, hogy ez szinte a fele az összes eseménynek. És ebben az esetben gondolkodhatna rajta, hogy az adatokat normalizálni kellene, azonosítókat számolni, és külön táblázatba gyűjteni. De ezt nem szabad csinálni. Egyszerűen tárolja ezeket a sorokat úgy, ahogy vannak.
Jobb - ne találjon ki semmit, mert ha külön tárolja, akkor join-t kell csinálni. És ez a join - a legjobban esetben véletlenszerű memória hozzáférést jelent, ha még a memória is elfér. Ha nem fér el, akkor teljesen problémák lesznek.
Ha az adatok in place tárolódnak, akkor csak a megfelelő sorrendben olvassák be a fájlrendszerből, és minden rendben van.
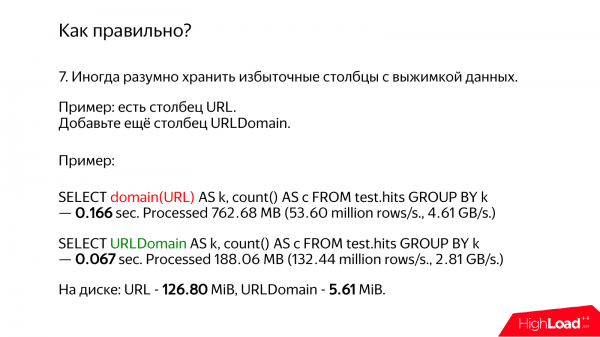
Ha url-jei vagy bármilyen más bonyolult hosszú szövege van, akkor érdemes elgondolkodnia azon, hogy előre számolhatna valamilyen kivonatot, és külön oszlopba rögzíthetné.
Például url-ek esetén a domain-t külön tárolhatja. És ha valóban szüksége van a domainekre, akkor egyszerűen használja ezt az oszlopot, míg az url-ek állni fognak, és nem is fog hozzájuk nyúlni.
Nézzük meg, mekkora a különbség. A ClickHouse-ban van egy speciális függvény, amely az domain-t számolja. Nagyon gyors, optimalizáltuk. És őszintén szólva, még az RFC-nek sem felel meg, de mégis mindent számol, amire szükségünk van.
Az egyik esetben egyszerűen csak az URL-eket fogjuk kinyerni és az domain-t számolni. Ez 166 milliszekundumot vesz igénybe. Ha viszont a már meglévő domain-t vesszük, akkor csak 67 milliszekundumot jelent, ami majdnem háromszor gyorsabb. Ez azért van, mert nem kell számításokat végezni, hanem kevesebb adatot olvasunk.
Valamiért egy lassabb lekérdezésnél a másodpercenkénti gigabájt sebesség magasabb. Mert több gigabájtot olvas. Ezek teljesen felesleges adatok. A lekérdezés gyorsabban működik, de hosszabb ideig tart a végrehajtása.
Ha megnézzük a lemezre írt adatokat, akkor az URL 126 megabájtot, míg a domain csak 5 megabájtot foglal el. Ez 25-ször kevesebb. De ennek ellenére a lekérdezés csak 4-szer gyorsabb. De ez azért van, mert az adatok forrók. Ha hidegek lennének, akkor valószínűleg 25-ször gyorsabb lenne a lemez I/O miatt.
Egyébként, ha megnézzük, mennyivel kisebb a domain, mint az URL, akkor 4-szerese. De valamiért a lemezen az adatok 25-ször kevesebb helyet foglalnak. Miért? A tömörítés miatt. Az URL tömörül, és a domain is. De gyakran az URL tele van szeméttel.
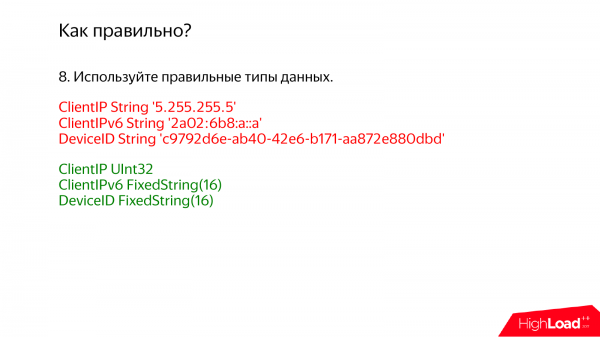
Természetesen fontos a megfelelő adat típusok használata, amelyek kifejezetten a szükséges értékekhez készültek, vagy amelyek megfelelnek. Ha IPv4-ről van szó, akkor tárolj UInt32*-t. Ha IPv6, akkor FixedString(16), mert az IPv6 cím 128 bit, tehát közvetlenül bináris formátumban tárold.
Mi a teendő, ha néha IPv4 címek, néha pedig IPv6 címek vannak? Igen, tárolhatod mindkettőt. Egy oszlop az IPv4-nek, másik az IPv6-nak. Persze van lehetőség az IPv4-et IPv6-ra áttérni. Ez is működni fog, de ha a lekérdezésekben gyakran van szükséged kifejezetten az IPv4 címre, akkor jó lenne külön oszlopba tenni.
* most már a ClickHouse-ban külön adatszerkezetek vannak az IPv4 és IPv6 számára, amelyek ugyanolyan hatékonyan tárolják az adatokat, mint a számok, de olyan kényelmesen mutatják be őket, mint a karakterláncok.
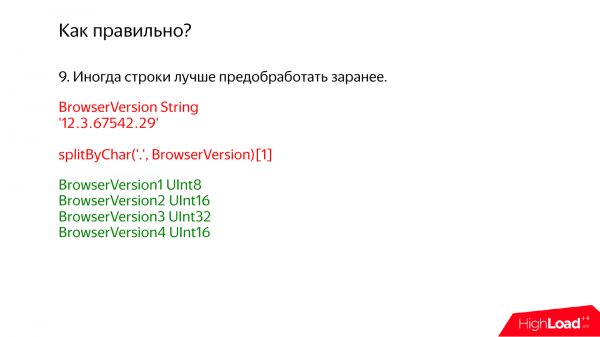
Fontos megemlíteni, hogy az adatokat előre érdemes előkészíteni. Például, ha nyers naplók érkeznek hozzád, lehet, hogy nem érdemes őket azonnal a ClickHouse-ba helyezni, bár nagyon csábító, hogy ne csinálj semmit, és minden működni fog. De azért érdemes elvégezni azokat a számításokat, amiket lehet.
Például a böngésző verziója. Egy közeli osztályban, amelyre nem szeretnék mutogatni, a böngésző verziója így tárolják, azaz string formájában: 12.3. Aztán, hogy jelentést készítsenek, ezt a stringet veszik és osztják egy tömbbel, majd az első tömb elemmel. Nyilvánvaló, hogy minden lelassul. Megkérdeztem, miért csinálják így. Azt válaszolták, hogy nem szeretik a korai optimalizációt. Én pedig nem szeretem a korai pessimizmust.
Ezért ebben az esetben helyesebb lenne négy oszlopra osztani. Itt ne félj, mert ez ClickHouse. A ClickHouse oszlop alapú adatbázis. Minél több apró, rendezett oszlopod van, annál jobb. Ha van 5 BrowserVersion-ed, készíts 5 oszlopot. Ez normális.
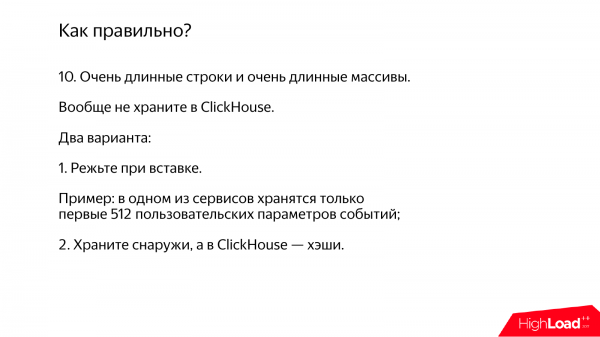
Most nézzük meg, mit tegyünk, ha sok nagyon hosszú stringed vagy nagyon hosszú tömböd van. Ezeket nem szabad tárolni a ClickHouse-ban. Ehelyett csak egy azonosítót menthetsz el a ClickHouse-ba. A hosszú stringeket tedd valamilyen más rendszerbe.
Például az egyik analitikai szolgáltatásunkban vannak bizonyos eseményparaméterek. Ha az eseményekhez sok paraméter érkezik, egyszerűen csak az első 512-t mentjük el. Mert az 512 – nem sajnáljuk.
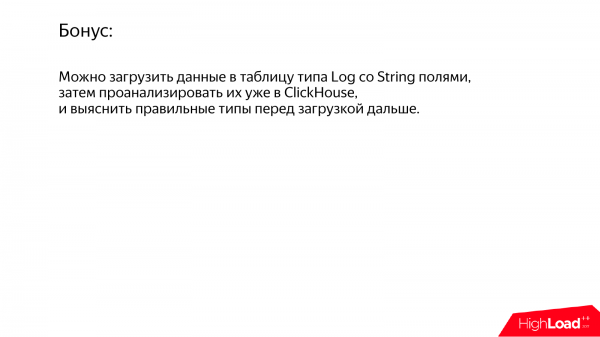
Ha pedig nem tudod eldönteni, milyen adattípusokra van szükséged, az adatokat a ClickHouse-ba is rögzítheted, de egy Log típusú ideiglenes táblába, amely kifejezetten ideiglenes adatokhoz készült. Ezt követően elemezheted, hogy milyen értékmegoszlásod van, hogy mi van ott, és meghatározhatod a megfelelő típusokat.
* Jelenleg a ClickHouse-ban van egy adattípus amely hatékonyan tárolja a stringeket kevesebb erőforrással.
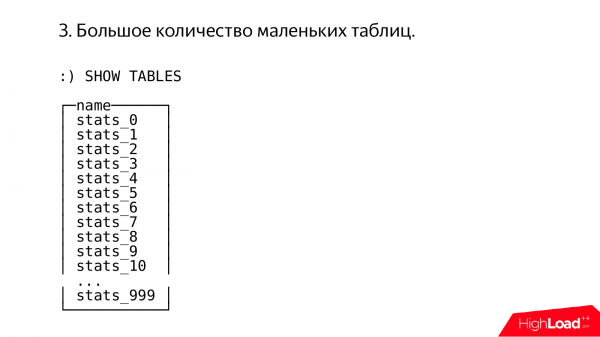
Most nézzünk egy másik érdekes esetet. Néha az emberek rendszere furcsán működik. Belépek, és ilyet látok. Azonnal felmerül, hogy ezt valami nagyon tapasztalt, okos admin készítette, akinek nagy tapasztalata van a MySQL 3.23 beállításában.
Itt ezer táblát látunk, mindegyikben valaminek az ezerrel való osztásának maradéka van rögzítve.
Alapvetően tiszteletben tartom mások tapasztalatait, beleértve azt is, hogy milyen szenvedéseken keresztül ezek a tapasztalatok keletkeztek.
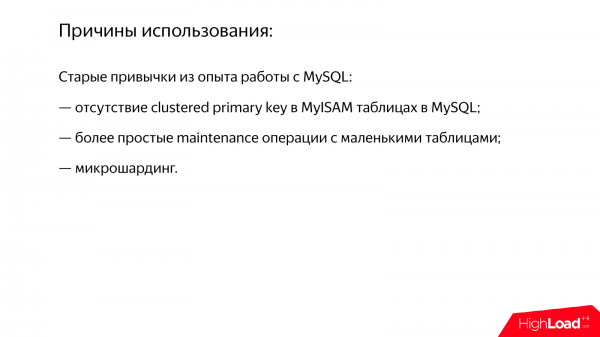
És az okok többé-kevésbé világosak. Ezek régi sztereotípiák, amelyek felhalmozódhattak más rendszerekkel való munka során. Például az MyISAM táblákban nincs klaszterezett elsődleges kulcs. Ez a fajta adatmegosztás kétségbeesett próbálkozás lehet arra, hogy megkapjuk ugyanazt a funkcionalitást.
Egy másik ok az, hogy a nagy táblákon végzett alter műveletek nehezen végezhetők. Minden blokkolódni fog. Bár a modern MySQL verziókban ez a probléma már nem olyan komoly.
Vagy például a mikrosharding, de erről kicsit később.
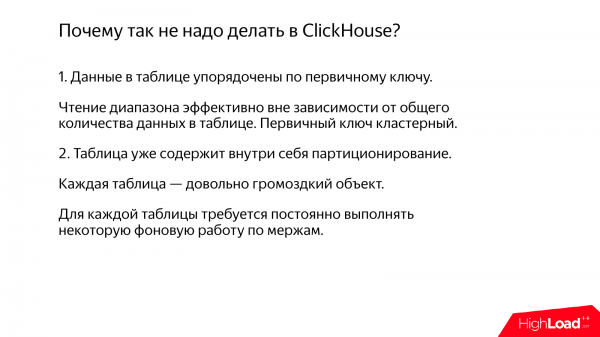
A ClickHouse-ban ezt nem szükséges csinálni, mert egyrészt az elsődleges kulcs klaszterezett, az adatok pedig az elsődleges kulcs szerint rendezettek.
Néha megkérdezik tőlem: „Hogyan változik a ClickHouse-ban a tartományos lekérdezések teljesítménye a táblázat méretétől függően?” A válaszom az, hogy semennyire. Például ha van egy milliárd soros táblázata, és egymillió sort olvas, akkor minden rendben van. Ha a táblázatban trillió sor van, és egymillió sort olvas, akkor az szinte ugyanolyan lesz.
Másrészt különböző manuális partíciókra sincs szükség. Ha belépsz és megnézed, mi található a fájlrendszeren, láthatod, hogy a táblázat elég komoly dolog. És ott belül van valami, ami a partíciókhoz hasonlítható. Vagyis a ClickHouse mindent elvégez helyetted, és neked nem kell szenvedned.
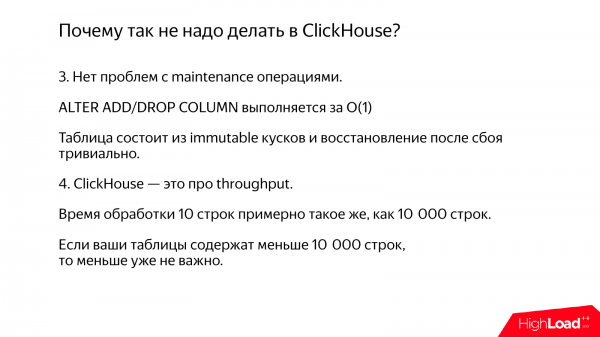
Az alter a ClickHouse-ban ingyenes, ha alter add/drop column.
Nem érdemes kis táblákat létrehozni, mert ha a táblázatodban 10 sor vagy 10 000 sor van, az teljesen lényegtelen. A ClickHouse egy olyan rendszer, amely az áteresztőképességet optimalizálja, nem a késleltetést, így 10 sort feldolgozni nem sok értelme van.
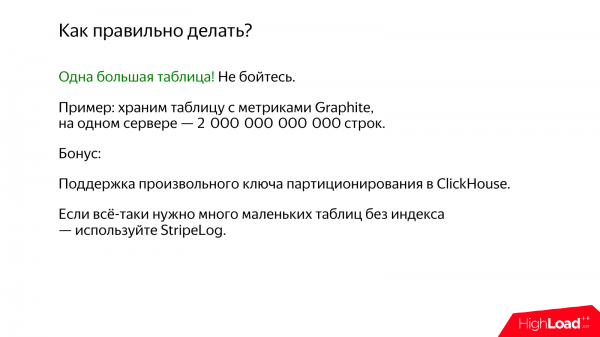
Helyes, ha egy nagy táblát használsz. Szabadulj meg a régi sztereotípiáktól, minden rendben lesz.
Bónuszként az utolsó verzióban megjelent a lehetőség, hogy tetszőleges partícionálási kulcsot hozz létre, hogy különféle karbantartási műveleteket végezhess az egyes partíciókon.
Például sok kis táblázatra van szüksége, például amikor köztes adatok feldolgozására van szüksége, chunkok érkeznek, és átalakítania kell azokat, mielőtt a végső táblázatba írná. Erre az esetre van egy csodálatos táblázatmotor – StripeLog. Olyasmi, mint a TinyLog, csak jobb.
* most a ClickHouse-ban van még .
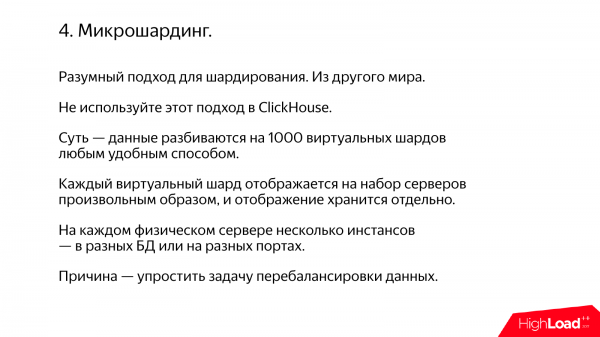
Egy másik antipattern a mikrosherelés. Például az adatait shardolnia kell, és öt szervere van, de holnap hat szervere lesz. És gondolkodik, hogyan kellene újraelosztani ezeket az adatokat. És ehelyett nem 5 shardra bontja, hanem 1000 shardra. És továbbra is minden mikrosherdet egy külön szerverre irányít. Így például az egyik szerveren 200 ClickHouse lesz, különböző instance-ök különböző portokon vagy különböző adatbázisokban.
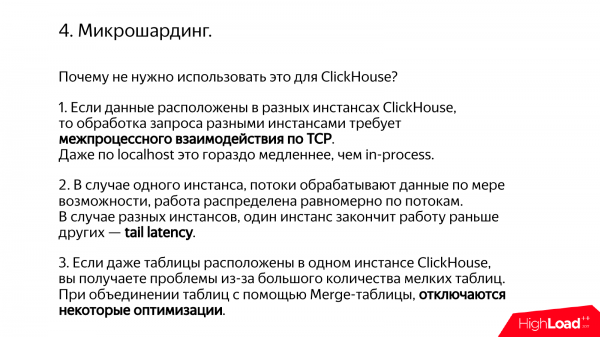
De a ClickHouse-ban ez nem igazán működik jól. Mert még egy ClickHouse példány is megpróbálja felhasználni a kiszolgáló összes rendelkezésre álló erőforrását egy kérés feldolgozásához. Tehát ha van egy szervere, mondjuk 56 processzormaggal. Végrehajt egy lekérdezést, ami egy másodpercig tart, és ez 56 magot fog használni. Ha pedig 200 ClickHouse-t helyezett el egy szerveren, akkor 10 000 szál fog elindulni. Összességében minden nagyon rosszul fog működni.
A másik ok az, hogy a munka elosztása ezek között az instance-ák között egyenlőtlen lesz. Az egyik korábban befejeződik, a másik később. Ha mindez egy instance-ban történne, a ClickHouse egyedül is el tudná dönteni, hogyan kellene helyesen elosztani az adatokat a szálak között.
És egy további ok, hogy TCP-n keresztüli interprocess kommunikációs kapcsolat lesz. Az adatokat sorba kell állítani, visszaalakítani, és ez óriási számú mikrosherdet jelent. Egyszerűen nem hatékonyan fog működni.
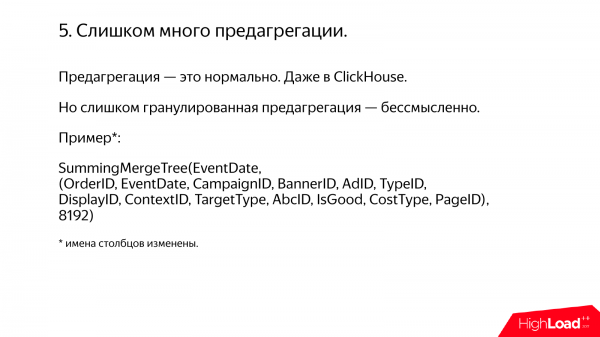
Egy újabb antipattern, bár nehéz antipatternnek nevezni. Ez a nagy mennyiségű preaggregáció.
Általában a preaggregáció jó. Volt egy milliárd sor, aggregálta, és lett belőle 1000 sor, és most a lekérdezés azonnal végrehajtódik. Minden csodálatos. Így lehet csinálni. Erre a ClickHouse-ban van egy speciális táblasorozat, az AggregatingMergeTree, amely folyamatos aggregálást végez az adatok beillesztése során.
De vannak esetek, amikor azt hiszed, hogy így aggregáljuk az adatokat, és még így aggregáljuk az adatokat. Egy szomszédos osztályban, szintén nem szeretnék mondani, hogy melyikben, SummingMergeTree táblákat használnak az elsődleges kulcs alapján történő összegzéshez, és az elsődleges kulcsként kb. 20 oszlopot használnak. Különböző esetek miatt megváltoztattam néhány oszlop nevét, de nagyjából így van.
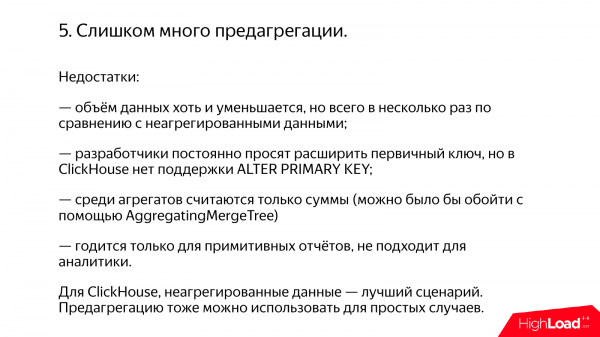
Egy ilyen problémák merülnek fel. Először is, az adatok mennyisége nem csökken túl drámaian. Például háromszorosára csökken. Háromszor – ez már jó ár lenne, hogy korlátlan elemzési lehetőségeket engedhessünk meg, amelyek akkor merülnek fel, ha az adatok nem aggregáltak. Ha az adatok aggregáltak, akkor az elemzés helyett csupán szánalmas statisztikát kapsz.
És mi zavar különösen? Az, hogy ezek az emberek a szomszédos osztályból időnként jönnek és kérik, hogy adjunk hozzá egy oszlopot az elsődleges kulcshoz. Tehát így aggregáltuk az adatokat, és most egy kicsit többet akarunk. De a ClickHouse-ban nincs mód az elsődleges kulcs módosítására. Ezért valamilyen C++-ban írt szkripteket kell írni. Én nem szeretem a szkripteket, még akkor sem, ha C++-ban vannak.
És ha megnézzük, miért készült a ClickHouse, akkor az aggregálatlan adatok éppen az a forgatókönyv, amiért született. Ha a ClickHouse-t aggregálatlan adatokhoz használod, akkor mindent helyesen csinálsz. Ha aggregálsz, az néha megbocsátható.
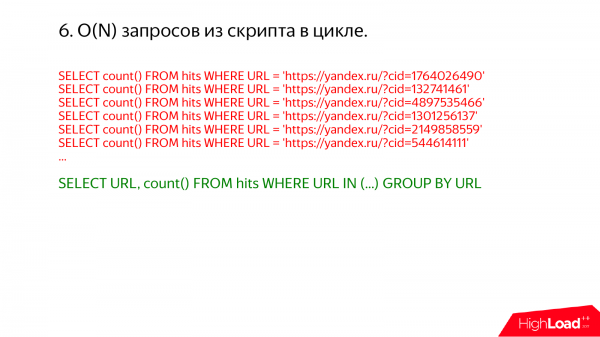
Egy másik érdekes eset a végtelen ciklusban zajló lekérdezések. Néha belenézek egy production szerverbe, és megnézem ott a show processlist-et. És mindig felfedezem, hogy valami borzalmas történik.
Például ez. Azonnal látható, hogy mindezt egy lekérdezésben is végrehajthatták volna. Egyszerűen írd be a url in és a lista.
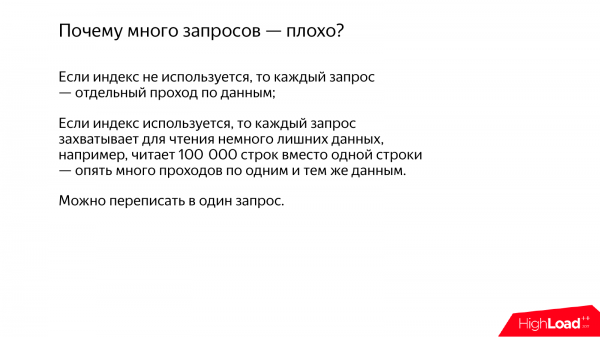
Miért rossz sok ilyen végtelen ciklusban futó lekérdezés? Ha az index nem használatos, akkor sokszor átfutsz ugyanazon adatokon. De ha az index használatban van, például van egy elsődleges kulcsod ru-ra, és te url = valamire írsz. És azt hiszed, hogy egy url-t pontosan olvasni fog a táblából, akkor minden rendben lesz. De valójában nem. Mert a ClickHouse mindent adagokban csinál.
Amikor egy adott adatsort kell olvasnia, egy kicsit többet olvas, mert a ClickHouse indexe ritkás. Ez az index nem teszi lehetővé egy egyedi sor megtalálását a táblában, csak egy adott tartományt. Az adatok blokkokban tömörülnek. Ahhoz, hogy egy sort elolvasson, egy egész blokkot kell gyűjtenie és kicsomagolnia. Ha sok lekérdezést hajt végre, akkor sok ilyen átfedés lesz, és sok munka fog újra és újra elvégeződni.
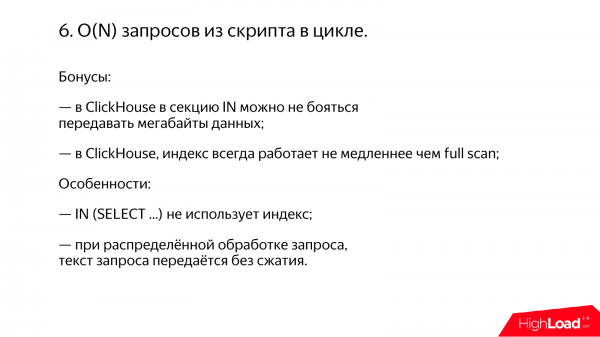
Bónuszként megjegyezhetjük, hogy a ClickHouse-ban nem érdemes félnünk több megabájtnyi, akár több száz megabájtnyi adat továbbításától az IN szekcióban. Emlékszem, hogy a gyakorlatunk során, ha a MySQL-ben sok értéket adunk meg az IN szekcióban, például 100 megabájtnyi számot, akkor a MySQL akár 10 gigabájt memóriát is felhasznál, és utána már semmi nem történik, minden rosszul működik.
A második pedig az, hogy a ClickHouse-ban, ha a lekérdezések használják az indexet, az mindig nem lassabb, mint a teljes átvizsgálás, tehát ha a táblázat szinte teljes tartalmát el kell olvasni, akkor az sorban halad és az egész táblát olvassa. Az összességében magától megoldódik.
Mindazonáltal vannak bizonyos nehézségek. Például az, hogy az IN al-lekérdezéssel nem használ indexet. De ez a mi problémánk, és nekünk kell ezt helyrehozni. Nincs itt semmi alapvető. Meg fogjuk javítani.
És egy újabb érdekes dolog – ha nagyon hosszú lekérdezés van, és elosztott lekérdezésfeldolgozás zajlik, akkor ez a nagyon hosszú lekérdezés minden szerverre tömörítés nélkül kerül továbbításra. Például 100 megabájt és 500 szerver. Ennek megfelelően 50 gigabájtot fogunk átadni az hálózaton. Át fogják adni, majd minden sikeresen végrehajtódik.
* már használatban van; mindent megjavítottunk, ahogy ígértük.
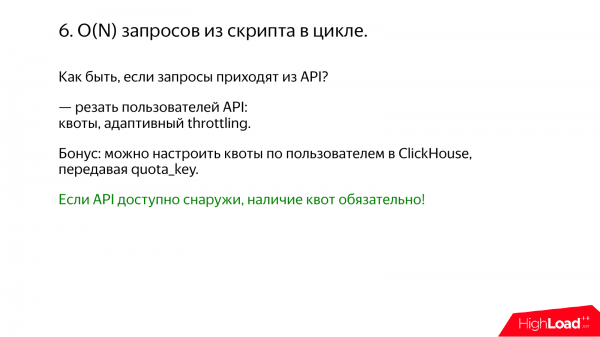
És eléggé gyakori eset, hogy a lekérdezések az API-ból érkeznek. Például készített egy szolgáltatást. Ha az Ön szolgáltatására szüksége van valakinek, akkor megnyitotta az API-t, és már két nappal később látja, hogy valami érthetetlen történik. Minden túlterhelt, és borzalmas lekérdezések érkeznek, amelyek soha nem kellett volna bekövetkezniük.
Itt egy megoldás létezik. Ha megnyitotta az API-t, akkor azt bizony módosítania kell. Például be kell vezetnie valamilyen kvótát. Nincs más normális lehetőség. Ellenkező esetben azonnal írnának egy szkriptet, és problémák merülnének fel.
A ClickHouse-ban lehetőség van a kvóták számítására. Ráadásul saját kvótakulcsot is megadhatunk. Ez például egy belső felhasználói azonosító. A kvóták számítása függetlenül történik mindegyikük számára.
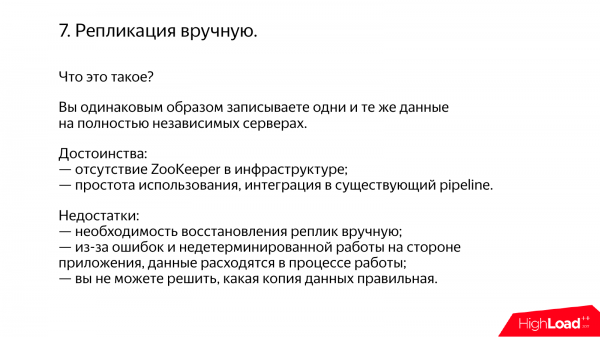
Most egy másik érdekes dolog. Ez a kézi meghajtású replikáció.
Tudok sok esetről, amikor, annak ellenére, hogy a ClickHouse beépített replikációt támogat, az emberek manuálisan replikálják a ClickHouse-t.
Mi ennek az elve? Van egy adatfeldolgozó pipeline-od. Ez függetlenül működik, például különböző adatközpontokban. Az azonos adatokat azonos módon írod be a ClickHouse-ba. Az igazság az, hogy a gyakorlat azt mutatja, hogy az adatok mégis eltérhetnek a kódod sajátosságai miatt. Remélem, hogy nem a tiéd.
Időről időre mégis kézzel kell szinkronizálnod. Például havonta egyszer az adminisztrátorok rsync-et végeznek.
Valójában sokkal egyszerűbb a ClickHouse beépített replikációját használni. De itt lehetnek bizonyos ellenjavallatok, mert ehhez ZooKeeper-t kell használni. Nem mondok rosszat a ZooKeeper-ről, alapvetően a rendszer működik, de előfordul, hogy az emberek nem használják, mert java-fóbiájuk van, mivel a ClickHouse egy olyan jó rendszer, amit C++-ban írtak, amely működik és minden rendben lesz. A ZooKeeper pedig Java. És valahogy még csak nem is szeretném megnézni, de akkor használhatod a kézi meghajtású replikációt.
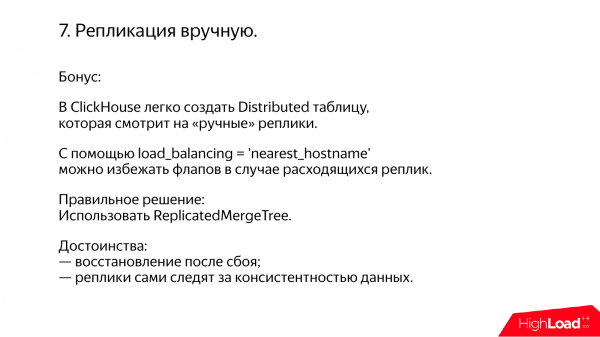
A ClickHouse egy praktikus rendszer. Figyelembe veszi az igényeidet. Ha kézi meghajtású replikációt használsz, létrehozhatsz egy Distributed táblát, amely a kézi replikáidra néz, és magától végrehajtja a failover-t közöttük. Még egy speciális opció is van, amely lehetővé teszi, hogy elkerüld a flappokat, még akkor is, ha a replikáid rendszeresen eltérnek egymástól.
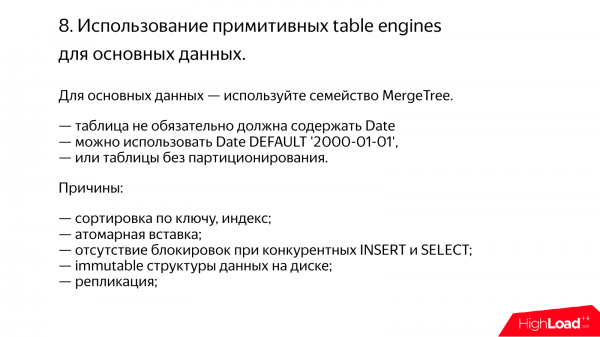
Továbbá problémák adódhatnak, ha primitív táblamotorokat használsz. A ClickHouse egy olyan építőelem, amelyben sok különböző táblamotor található. Minden komolyabb esethez, ahogy a dokumentáció is írja, a MergeTree család tábláit kell használnod. Minden más – csak külön esetekre vagy tesztekhez való.
A MergeTree táblában nem szükséges, hogy legyen valamilyen dátum és idő. Akkor is használhatod őket. Ha nincs dátum és idő, írd be, hogy az alapértelmezett – 2000-es év. Ez működni fog, és nem igényel sok erőforrást.
Az új szerver verzióban akár testreszabott partícionálást is megadhat, kulcs nélküli partícióval. Ez ugyanaz lesz.
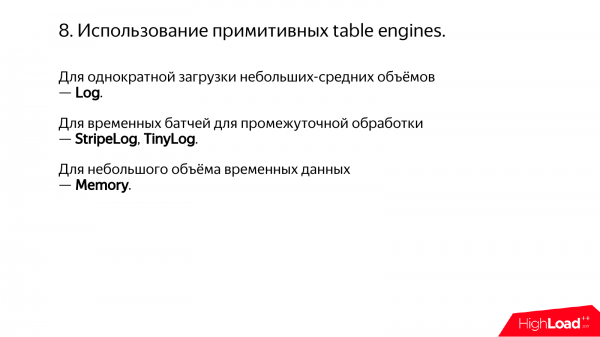
Másrészt primitív táblamotorokat is használhat. Például egyszer tölti fel az adatokat, megnézi, elforgatja és törli. Használhat Log-ot.
Vagy kis mennyiségek tárolására az intermedier feldolgozáshoz – ez a StripeLog vagy TinyLog.
A Memory-t használhatja, ha kis mennyiségű adat van, és csak valamit forgatna a memóriában.
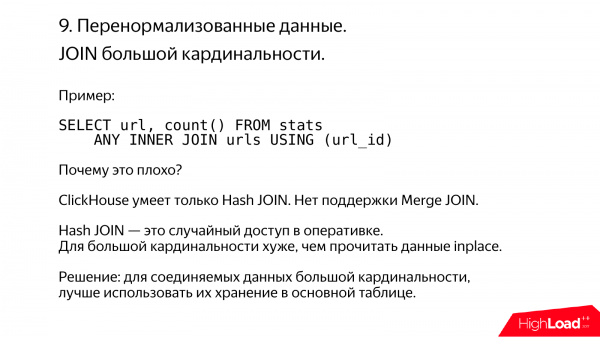
A ClickHouse nem nagyon kedveli a túlnormalizált adatokat.
Itt egy tipikus példa. Ez egy hatalmas URL mennyiség. Beletette őket a szomszédos táblába. Aztán úgy döntött, hogy JOIN-t szeretne végrehajtani velük, de általában ez nem fog működni, mert a ClickHouse csak Hash JOIN-t támogat. Ha nincs elegendő memória a sok adat összekapcsolásához, akkor a JOIN nem hajtható végre*.
Ha az adatok nagy kardináliságúak, akkor ne aggódjon, tárolja őket denormalizált formában, az URL-eket közvetlenül a fő táblában.
* Most a ClickHouse-ban már merge join is van, és ez olyan környezetben működik, ahol a közbenső adatok nem férnek el a memóriában. De ez nem hatékony, és a javaslat továbbra is érvényes.
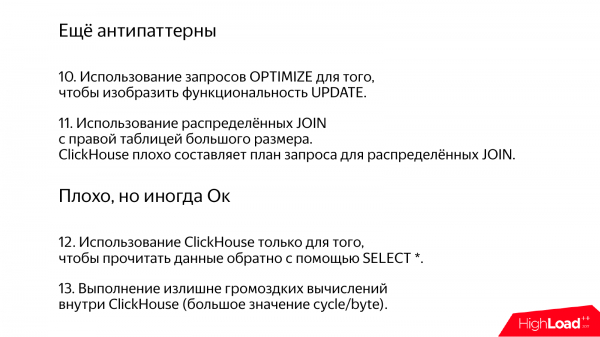
Még pár példa, de már kételkedem, hogy anti-mintásak-e vagy sem.
A ClickHouse-nak van egy ismert hátránya. Nem tud frissítéseket végezni*. Bizonyos értelemben ez még jónak is tekinthető. Ha fontos adatai vannak, például a könyvelés, akkor senki sem tudja őket elküldeni, mert nincsenek frissítések.
* A frissítési és törlési támogatás már régóta hozzá lett adva batch módba.
De van néhány különleges módszer, amely lehetővé teszi a frissítéseket szinte a háttérben. Például a ReplaceMergeTree típusú táblák. Ezek a háttérbeli összevonások során végzik a frissítéseket. Ezt a optimize table-vel kényszerítheti. De ne tegye ezt túl gyakran, mert az teljes újraírást jelent a partícióra.
A terjesztett JOIN-ok a ClickHouse-ban szintén rosszul kezelhetők a lekérdezés–tervező által.
Rossz, de néha rendben van.
A ClickHouse használata kizárólag arra, hogy az adatokat visszaolvassa select*-tál.
Nem ajánlanám a ClickHouse használatát nagyméretű számításokhoz. De ez nem teljesen igaz, mert már eltávolodunk ettől az ajánlástól. Nemrégiben lehetőség nyílt gépi tanulási modellek alkalmazására a ClickHouse-ban – Catboost. Ez aggaszt, mert azt gondolom: „Micsoda szörnyűség. Hány ciklus van egy byte-ra!”. Nagyon sajnálom, hogy ciklusokat pazarolok byte-okkal.
De ne féljetek, telepítsétek a ClickHouse-t, minden rendben lesz. Ha bármi baj van, van közösségünk. Egyébként, a közösség – az ti vagytok. És ha problémáitok vannak, legalább csatlakozhattok a chatünkhez, és remélem, segítenek nektek.
Kérdések
Köszönöm az előadást! Hova lehet panaszt tenni a ClickHouse leállására?
Személyesen nekem is panaszolhattok most.
Nemrég kezdtem el használni a ClickHouse-t. Azonnal leállítottam a CLI interfészt.
Szerencséd van.
Később egy kis select-tel leállítottam a szervert.
Tehetséged van.
Hibát nyitottam a GitHub-on, de figyelmen kívül hagyták.
Nézzük meg.
Alexey becsapott, hogy részt vegyek az előadáson, megígérve, hogy elmondja, hogyan tömörítitek az adatokat belül.
Nagyon egyszerű.
Ezt már tegnap megértettem. Több konkrétumot szeretnék.
Nincsenek ott szörnyű trükkök. Csak blokk alapú tömörítés van. Alapértelmezés szerint LZ4-t használunk, de lehet ZSTD-t is bekapcsolni*. A blokkok 64 kilobajtól 1 megabájtig terjednek.
* emellett van támogatás speciális tömörítési kodekekhez, amelyeket más algoritmusokkal kombinálva lehet használni.
A blokkokban csak nyers adatok vannak?
Nem teljesen nyers adatokról van szó. Ott tömbök vannak. Ha van egy numerikus oszlopod, akkor a számok egymás után tömbökbe vannak rendezve.
Értem.
Alexey, például a uniqExact esetében az IP címek felett, hogy az uniqExact sorok szerint lassabban számolódik, mint a számok. Mi van, ha az olvasáskor konvertálunk? Tehát, úgy tűnik, azt mondtad, hogy a lemezen nem nagyon különbözik. Ha a lemezről olvasunk sorokat és konvertálunk, akkor gyorsabban lesznek az aggregátumaink, vagy nem? Vagy itt nem nyerhetünk jelentősen? Úgy tűnik, hogy ezt tesztelted, de valamiért nem jelölted meg a benchmarkon.
Azt hiszem, hogy lassabb lesz, mint a cast nélkül. Ebben az esetben az IP-címet ki kell parsolni a sorból. Nálunk, természetesen, a ClickHouse-ban is optimalizálva van az IP-címek parse-olása. Nagyon erősen igyekeztünk, de ott ugye a számok tízezres formában vannak feljegyezve. Nagyon kényelmetlen. Másrészt a uniqExact függvény lassabban fog működni a sorokon, nemcsak azért, mert azok sorok, hanem mert az algoritmus más specializációt választ. A sorokat egyszerűen másképp dolgozzák fel.
De mi van, ha egy primitívebb adat típust választunk? Például, feljegyeztük a felhasználói azonosítót, amely nálunk in, felírtuk sorban, majd castoltuk, viccesebb lesz vagy sem?
Kétlem. Azt hiszem, hogy még szomorúbb lesz, mert a számok parse-olása komoly probléma. Úgy tűnik, hogy ennek a kollégának volt egy előadása arról, hogy mennyire nehéz a számokat tízes formában parse-olni, de lehet, hogy nem.
Alexei, köszönöm szépen az előadást! És köszönöm szépen a ClickHouse-t! Van egy kérdésem a tervekkel kapcsolatban. Terveznek-e olyan funkciót, ami nem teljesen frissíti a szótárakat?
Tehát részleges újraindítás?
Igen-igen. Olyan lehetőség, hogy megadhassuk a MySQL mezőt, tehát frissíteni az aftert, hogy csak ezek az adatok tölthetők be, ha a szótár nagyon nagy.
Nagyon érdekes funkció. És úgy tűnik, hogy valaki azt javasolta a chaten. Talán ez akár ön volt.
Nem hiszem, hogy én lennék.
Remek, most pedig úgy tűnik, hogy két lekérdezés van. És nyugodtan el lehet kezdeni csinálni. De azonnal figyelmeztetni szeretném, hogy ez a funkció meglehetősen egyszerűen megvalósítható. Tehát elvileg csak annyit kell tenni, hogy beírjuk a táblába a verziószámot, és utána: verzió kisebb, mint ez meg ez. Ez azt jelenti, hogy valószínűleg ezt a lelkesedőknek fogjuk ajánlani. Ön lelkesedő?
Igen, de sajnos nem C++-ban.
A kollégái tudnak C++-ban programozni?
Meg fogok találni valakit.
Remek*.
* a lehetőség két hónappal az előadás után lett hozzáadva – a kérdés szerzője fejlesztette, és elküldte a sajátját .
Köszönöm!
Üdvözlöm! Köszönöm az előadást! Emlegette, hogy a ClickHouse nagyon jól kihasználja az összes rendelkezésre álló erőforrást. A Luxoft szomszédos előadója a megoldásáról beszélt a Orosz Posta számára. Azt mondta, hogy nekik nagyon tetszett a ClickHouse, de nem használták az alapvető konkurensük helyett, pontosan azért, mert teljesen elfogyasztja a processzort. Nem tudták integrálni a saját architektúrájukba, a ZooKeeper-jükbe a dockerekkel. Van lehetőség arra, hogy korlátozzuk a ClickHouse-t, hogy ne fogyassa el mindazt, ami elérhető neki?
Igen, lehet, és nagyon egyszerű. Ha kevesebb magot szeretne használni, akkor egyszerűen írja be set max_threads = 1. És kész, egy magon végzi a lekérdezéseket. Ráadásul különböző felhasználók számára beállíthat különböző paramétereket. Tehát ezzel nincs probléma. És az Luxoft munkatársainak is mondja el, hogy nem helyes, hogy nem találták meg ezt a beállítást a dokumentációban.
Alexej, üdvözlöm! Szeretnék egy kérdést feltenni. Már nem először hallom, hogy sokan a ClickHouse-t kezdték el logok tárolására használni. Az előadásban azt mondta, hogy ezt nem kéne csinálni, azaz nem kell hosszú sorokat tárolni. Mit gondol erről?
Először is, a logok általában nem hosszú sorok. Persze vannak kivételek. Például egy Java nyelven írt szolgáltatás dob egy exception-t, ami naplózásra kerül. És ez végtelen ciklusban zajlik, végül pedig elfogy a hely a merevlemezen. A megoldás nagyon egyszerű. Ha a sorok túl hosszúak, akkor vágja le őket. De mit jelent, hogy hosszú? Tízes kilobájt – ez rossz*.
* a ClickHouse legújabb verzióiban be van kapcsolva az "adaptív granulált indexelés", ami nagyrészt megoldja a hosszú sorok tárolásának problémáját.
És a kilobájt – az normális?
Normális.
Üdvözlöm! Köszönöm az előadást! Már kérdeztem erről a csatornában, de nem emlékszem, kaptam-e választ. Tervezik-e valamikor bővíteni a WITH szekciót hasonlóan a CTE-hez?
Jelenleg nem. A WITH szekciónk kicsit komolytalan. Egy kicsi funkcióként kezeljük.
Megértettem. Köszönöm!
Köszönöm az előadást! Nagyon érdekes! Globális kérdés. Tervezik-e valamilyen módon a törlés funkció módosítását, esetleg valamilyen helyettesítő használatával?
Kétségtelenül. Ez a feladatunk az első helyen a sorban. Jelenleg aktívan kidolgozzuk, hogyan csináljuk jól. És el kell kezdeni ütögetni a billentyűzetet*.
* megnyomkodtuk a billentyűket a billentyűzeten, és mindent megcsináltunk.
Folyásolja ez valamilyen módon a rendszer teljesítményét, vagy nem? A beszúrás olyan gyors lesz, mint most?
Lehetséges, hogy maguk a törlések és frissítések nagyon nehéznek bizonyulnak, de ez semmilyen hatással nem lesz a lekérdezések és a beszúrások teljesítményére.
És még egy kis kérdés. Az előadáson említetted a primer kulcsot. Tehát van egy partícionálás, amely alapértelmezés szerint havi, ugye? Amikor megadunk egy dátumtartományt, ami belefér egy hónapba, akkor csak ezt a partíciót olvassuk le, igaz?
Igen.
Egy ilyen kérdés. Ha nem tudunk megnevezni egy primer kulcsot, helyes-e a "Dátum" mező alapján kialakítani, hogy a háttérben kevesebb átszervezés történjen, és a adatok rendezettebben legyenek? Ha nincsenek tartományos lekérdezések, és még csak egy primer kulcsot sem tudunk választani, akkor érdemes-e a dátumot a primer kulcsba tenni?
Igen.
Lehet, hogy van értelme a primer kulcsba tenni egy olyan mezőt, amely alapján az adatok jobban tömöríthetők, ha azokat aszerint rendezik. Például a felhasználó azonosítója. A felhasználó például ugyanarra az oldalra látogat. Ebben az esetben tedd bele a felhasználó azonosítóját és az időt. És akkor az adatok jobban tömöríthetők. A dátumot illetően, ha valóban nincsenek és soha nem is voltak tartományos lekérdezések a dátumokkal kapcsolatban, akkor nem szükséges a dátumot a primer kulcsba tenni.
Rendben, nagyon köszönöm!
Forrás: habr.com
