

Üdvözlök mindenkit! A nevem Nikolaj Golov. Korábban az Avitonál dolgoztam, ahol hat éven át vezettem az Adatplatformot, tehát mindenféle adatbázissal foglalkoztam: analitikai (Vertica, ClickHouse), folyamatos és OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). Ezen időszak alatt sok különféle és szokatlan adatbázist megértettem, valamint a használatuk nem szabványos eseteit is.
Jelenleg a ManyChatnél dolgozom. Gyakorlatilag egy startup – új, ambiciózus és gyorsan növekvő. Amikor először beléptem a céghez, felmerült a klasszikus kérdés: "Mit érdemes most választania egy fiatal startupnak az adatbázisok piacáról?"
Ebben a cikkben, amely az én előadásomra épül a , válaszolok erre a kérdésre. Az előadás videóváltozata elérhető a .
2020-as köztudott adatbázisokban.
2020 van, körülnéztem, és három adatbázistípust láttam.
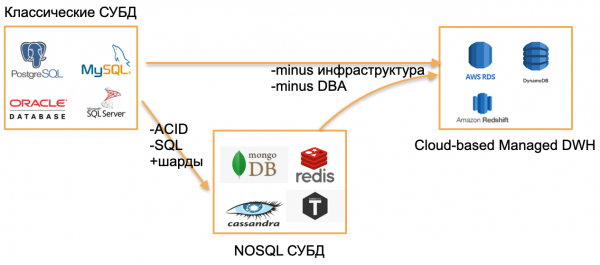
Az első típus — klasszikus OLTP adatbázisok:PostgreSQL, SQL Server, Oracle, MySQL. Ezeket régen írták, de még mindig relevánsak, mert a fejlesztői közösség jól ismeri őket.
A második típus — a "nullás" adatbázisok.Ezek megpróbáltak eltávolodni a klasszikus mintáktól az SQL, a hagyományos struktúrák és az ACID elhagyásával, beépített sharding és egyéb vonzó funkciók hozzáadásával. Például, ilyenek a Cassandra, MongoDB, Redis vagy Tarantool. Mind ezek a megoldások valami alapvetően újat akartak kínálni a piacnak, és megtalálták a saját nichesüket, mert bizonyos feladatoknál rendkívül kényelmesek voltak. Ezt az adatbázist NOSQL jelzőtermékkel fogom megnevezni.
A "nullás" korszak véget ért, a NOSQL adatbázisokhoz hozzászoktak, és a világ, véleményem szerint, megtette a következő lépést — a managed (kezelő) adatbázisok felé.Ezeknek az adatbázisoknak a magja azonos a klasszikus OLTP adatbázisokkal vagy az új NoSQL megoldásokkal. De nincs szükségük DBA-ra és DevOps-ra, és felhőben működnek a kezelt hardveren. A fejlesztő számára ez egy "csak adatbázis", ami valahol működik, az pedig, hogyan lett telepítve a szerverre, ki állította be a szervert és ki frissíti, senkit sem érdekel.
Ezekre az adatbázisokra példák:
- AWS RDS — kezelő burkolat a PostgreSQL/MySQL-hez.
- DynamoDB — az AWS dokumentum alapú adatbázisának megfelelője, hasonló a Redishez és a MongoDB-hez.
- Amazon Redshift — kezelő analitikai adatbázis.
Alapvetően ezek régi adatbázisok, de kezelő környezetben emelték őket, anélkül, hogy szükség lenne a hardverrel való foglalkozásra.
Megjegyzés. A példák az AWS környezetéből valók, de az analógjaik léteznek a Microsoft Azure, a Google Cloud vagy a Yandex.Cloud környezetében is.
Mi az újdonság 2020-ban? Ebből semmi.
A Serverless koncepció.
Valóban új a piacon 2020-ban — ez a serverless vagyis kiszolgáló nélküli megoldások.
Megpróbálom elmagyarázni, mit jelent ez, egy hagyományos szolgáltatás vagy backend-alkalmazás példáján keresztül.
Egy hagyományos backend-alkalmazás telepítéséhez szervert vásárolunk vagy bérelünk, átmásoljuk rá a kódot, közzétesszük a kinyitott végpontot, és rendszeresen fizetünk a bérlésért, az elektromosságért és az adatközponti szolgáltatásokért. Ez a standard séma.
Van-e más mód? A serverless szolgáltatásokkal lehetséges.
Mi a fókusz ebben a megközelítésben: nincs szerver, még virtuális példány bérlete sincs a felhőben. A szolgáltatás telepítéséhez a kódot (funkciókat) átmásoljuk a tárolóba, és közzétesszük a kinyitott végpontot. Ezután csak fizetünk minden egyes funkcióhívásért, teljesen figyelmen kívül hagyva a hardvert, ahol végrehajtják.
Megpróbálom szemléltetni ezt a megközelítést képeken.
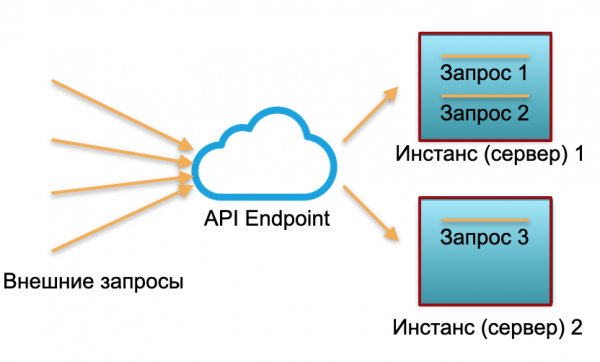
Hagyományos telepítés. Van egy szolgáltatásunk meghatározott terheléssel. Két példányt indítunk: fizikai szervereket vagy AWS példányokat. Ezekre a példányokra irányulnak a külső kérések, amelyeket ott dolgoznak fel.
Ahogy a képen látható, a szerverek eltérő módon vannak kihasználva. Az egyik 100%-ban kihasznált, ott két kérés van, míg a másik csak 50%-ban — részben inaktív. Ha nem három kérés érkezik, hanem 30, akkor az egész rendszer nem tud megbirkózni a terheléssel, és elkezd lassulni.
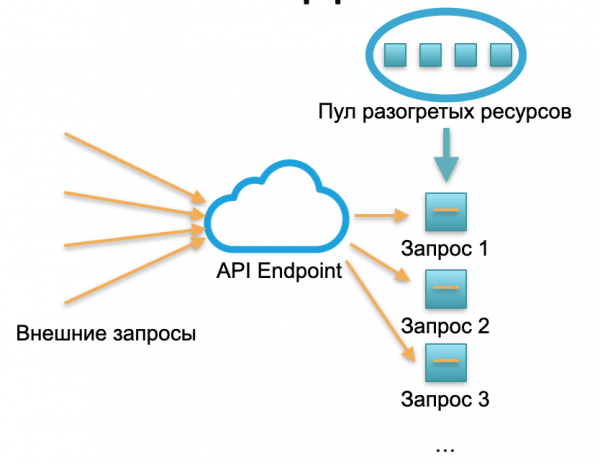
Serverless telepítés. Serverless környezetben egy ilyen szolgáltatásnak nincsenek példányai és szerverei. Van egy bizonyos tartomány a felfűtött erőforrásokból — apró előre konfigurált Docker-konténerek a funkció kódjával. A rendszer külső kéréseket kap, és minden egyes kéréshez a serverless keretrendszer egy kis konténert indít el a kóddal: ez az adott kérést kezeli és elpusztítja a konténert.
Egy kérés — egy indított konténer, 1000 kérés — 1000 konténer. A fizikai szerverekre történő telepítés már a felhőszolgáltató munkája. Ez teljesen rejtve van a serverless keretrendszer előtt. Ebben a koncepcióban minden hívásért fizetünk. Például, ha egy hívás érkezik naponta — egy hívásért fizetünk, ha egy millió érkezik percenként — egy millióért. Vagy másodpercenként, ez is előfordul.
A közzétételi koncepció a serverless funkcióhoz illeszkedik egy stateless szolgáltatás számára. Ha azonban állapotot (state) kezelő szolgáltatásra van szükség, akkor az adatbázist hozzáadjuk a szolgáltatáshoz. Ilyen esetben, amikor az állapot kezeléséről van szó, minden statefull funkció egyszerűen ír és olvas az adatbázisból. Ráadásul az adatbázis bármely a cikk elején leírt három típusából származhat.
Milyen általános korlátozások vonatkoznak az összes ilyen adatbázisra? Ez a folyamatosan használt felhő vagy fizikai szerver (vagy több szerver) költsége. Mindegy, hogy klasszikus adatbázist használunk vagy managed megoldást, van-e DevOps és adminisztrátor vagy nincs, akkor is 24/7 fizetünk a hardverért, az áramért és az adatközpont bérléséért. Ha klasszikus adatbázisunk van, akkor a master és a slave után is fizetünk. Ha nagy terhelésű sharded adatbázis — akkor 10, 20 vagy 30 szerver után fizetünk, és ez folyamatosan.
A költségszerkezetben folyamatosan fenntartott szerverek meglétét korábban elkerülhetetlen rosszként fogták fel. Az átlagos adatbázisoknak más nehézségeik is vannak, mint például a kapcsolatok számának korlátozása, a skálázás korlátozása, a geoelhelyezett konszenzus — ezeket bizonyos adatbázisokban valamilyen módon meg lehet oldani, de nem mind egyszerre, és nem is tökéletesen.
Serverless adatbázis — elmélet
A 2020-as kérdés: lehet-e az adatbázist is serverless megoldásra átállítani? Mindenki hallott a serverless backendről… de próbáljuk meg az adatbázist is serverless megoldásra átállítani!
Ez furcsán hangzik, mert az adatbázis egy statefull szolgáltatás, ami nem pontosan illeszkedik a serverless infrastruktúrához. Ugyanakkor az adatbázis állapota is nagyon nagy: gigabájtok, terabájtok, míg az analitikai adatbázisokban akár petabájtok is. Ezt nem olyan egyszerű könnyűsúlyú Docker konténerekben futtatni.
Másrészről szinte minden modern adatbázis hatalmas mennyiségű logikát és komponenst tartalmaz: tranzakciók, adatintegritás biztosítása, eljárások, relációs függőségek és sok logika. Az adatbázis logikájának elég nagy része meglehetősen kis állapotú. A gigabájtok és terabájtok közvetlenül csak az adatbázis logikájának kis részénél használatosak, amely közvetlenül kapcsolódik a lekérdezések végrehajtásához.
Ennek megfelelően az ötlet: ha a logika egy része lehetővé teszi a stateless végrehajtást, miért ne osztanánk fel az adatbázist stateful és stateless részekre.
Serverless az OLAP megoldásokra
Nézzük meg, hogyan nézhet ki az adatbázis stateful és stateless részekre való felosztása gyakorlati példákon.
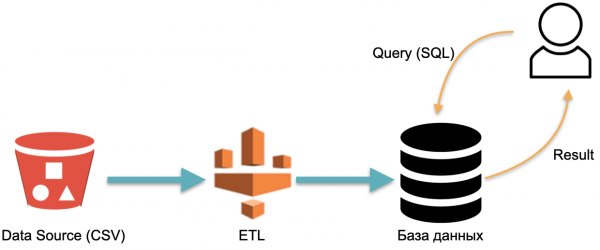
Például van egy analitikai adatbázisunk: külső adatok (a bal oldali piros hengert), ETL-procesz, amely adatokat tölt be az adatbázisba, és egy elemző, aki SQL-lekérdezéseket küld az adatbázishoz. Ez egy klasszikus adattárolási séma.
Ebben a séma szerint feltételezhetően egyszer végzik el az ETL-t. Ezután folyamatosan kell fizetni a szerverekért, amelyeken az ETL által feltöltött adatokat tartalmazó adatbázis fut, hogy legyen mibe küldeni a lekérdezéseket.
Nézzük meg az alternatív megközelítést, amelyet az AWS Athena Serverless adatbázisban valósítanak meg. Itt nincs folyamatosan kijelölt hardver, amelyen a feltöltött adatok tárolódnak. Ehelyett:
- A felhasználó SQL-lekérdezést küld az Athenához. Az Athena optimalizálója elemzi az SQL-lekérdezést, és a metaadat-tárolóban (Metadata) megkeresi a kérdés végrehajtásához szükséges konkrét adatokat.
- Az optimalizáló a begyűjtött adatok alapján a szükséges adatokat kiemeli a külső forrásokból egy ideiglenes tárolóba (ideiglenes adatbázis).
- Az ideiglenes tárolóban a felhasználó SQL-lekérdezése végrehajtódik, az eredmény visszatér a felhasználóhoz.
- Az ideiglenes tároló ürítése, az erőforrások felszabadulnak.
Ebben az architektúrában csak a lekérdezés végrehajtásáért fizetünk. Nincsenek lekérdezések — nincsenek költségek.
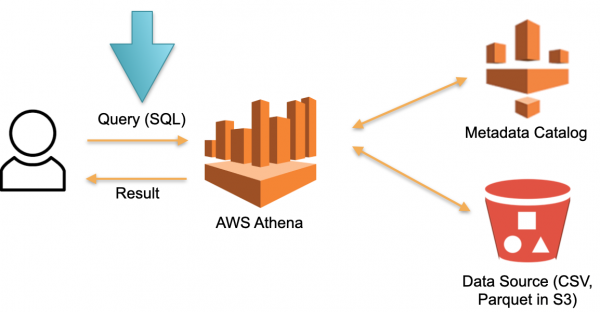
Ez egy működő megközelítés, és nemcsak az Athena Serverlessben, hanem a Redshift Spectrum (az AWS-ben) is megvalósul.
Az Athena példáján látható, hogy a Serverless adatbázis valós lekérdezéseken működik, akár több tíz vagy száz terabájtnyi adatsorral. Száz terabájthoz száz szerverre lenne szükség, de nekünk nem kell fizetnünk értük — mi a lekérdezésekért fizetünk. Minden lekérdezés sebessége (nagyon) alacsony a speciális analitikai adatbázisok, például a Vertica-hoz képest, de így nem kell fizetnünk a leállási időszakokért.
Az ilyen adatbázis ritka analitikai ad-hoc lekérdezésekhez alkalmazható. Például, amikor spontán módon döntünk úgy, hogy ellenőrizzük egy hipotézis érvényességét hatalmas mennyiségű adat esetén. Ezekhez az esetekhez az Athena tökéletes. A rendszer rendszeres lekérdezések esetén drága. Ilyenkor tárolja az adatokat valamilyen speciális megoldásban.
Serverless OLTP megoldásokhoz
Az előző példában OLAP-feladatokat (analitikai) vizsgáltunk. Most nézzük meg az OLTP-feladatokat.
Képzeljünk el egy skálázható PostgreSQL vagy MySQL rendszert. Emeljük fel a szokásos kezelt PostgreSQL vagy MySQL példányt minimális erőforrásokkal. Amikor a példányra nagyobb terhelés érkezik, extra replikákat csatlakoztatunk, amelyekre részben elosztjuk a lekérdezési terhelést. Ha nincsenek lekérdezések és terhelés, akkor lekapcsoljuk a replikákat. Az első példány a master, a többi replikaként működik.
Ez az ötlet az Aurora Serverless AWS néven ismert adatbázisban valósult meg. Az elv egyszerű: a külső alkalmazásoktól érkező lekérdezéseket egy proxy flottán keresztül fogadják. A terhelés növekedését látva, kiszabadítja a számítási erőforrásokat az előkészített minimális példányokból - a csatlakozás a lehető leggyorsabb. A példányok kikapcsolása is így történik.
Az Aurora keretein belül létezik az Aurora Kapacitás Egység, ACU fogalma. Ez (értelemszerűen) egy példány (szerver). Minden egyes ACU lehet master vagy slave. Minden Kapacitás Egység saját memóriával, processzorral és minimális lemezzel rendelkezik. Így egy master és a többi csak olvasási replikaként működik.
Ezeknek az aktív Aurora Kapacitás Egységeknek a száma egy konfigurálható paraméter. A minimális szám lehet egy vagy nulla (ebben az esetben az adatbázis nem működik, ha nincsenek lekérdezések).
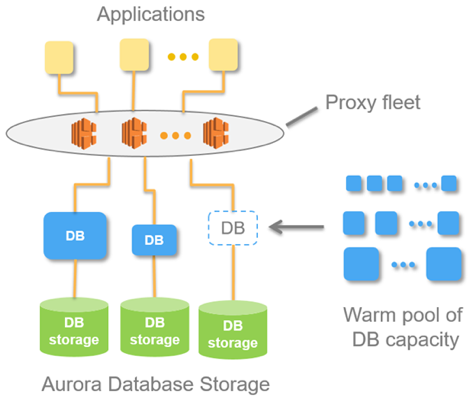
Amikor az adatbázis lekérdezéseket kap, a proxy flották felemelik az Aurora Kapacitás Egységeket, növelve a rendszer teljesítményforrásait. Az erőforrások növelésének és csökkentésének lehetősége lehetővé teszi a rendszer számára, hogy "zsonglőrködjön" az erőforrásokkal: automatikusan eltávolítja a különböző ACU-kat (újakkal helyettesítve őket), és alkalmazza a kiadott frissítéseket.
Az Aurora Serverless adatbázis képes a lekérdezési terhelés skálázására. De erről a dokumentációban nincs egyértelmű említés. Lehet, hogy az a benyomás keletkezik, hogy képesek multi-master rendszert létrehozni. De valójában nincs varázslat.
Ez az adatbázis jól alkalmas arra, hogy ne költsünk el hatalmas összegeket olyan rendszerekre, amelyek hozzáférése kiszámíthatatlan. Például MVP vagy marketing látogatói oldalak készítésekor általában nem számítunk stabil terhelésre. Ennek megfelelően, ha nincs hozzáférés, akkor nem fizetünk az instance-ekért. Amikor váratlan terhelés lép fel, például egy konferencia vagy reklámkampány után, sok ember látogat el az oldalra, és a terhelés hirtelen megnő, az Aurora Serverless automatikusan kezeli ezt a terhelést és gyorsan csatlakoztatja a szükséges erőforrásokat (ACU). Aztán a konferencia véget ér, mindenki elfelejti a prototípust, a szerverek (ACU) leállnak, és a költségek nullára csökkennek — kényelmes.
Ez a megoldás nem alkalmas stabil magas terhelés kezelésére, mert nem képes méretezni az írói terhelést. Mindezek a kapcsolódások és lekapcsolások a úgynevezett „scale point” pillanatában történnek — abban az időpontban, amikor az adatbázist nem tartja egy tranzakció, nem tartják ideiglenes táblák. Például egy héten belül a scale point talán meg sem történik, és az adatbázis egyetlen erőforráson működik, így egyszerűen nem tud sem bővülni, sem összehúzódni.
Nincs varázslat — ez egy átlagos PostgreSQL. De a gépek hozzáadásának és lekapcsolásának folyamata részben automatizált.
Serverless by design
Az Aurora Serverless egy régi adatbázis, amelyet felhőre írtak át, hogy kihasználja a Serverless előnyeit. Most pedig mesélek egy adatbázisról, amelyet eredetileg felhőre, a serverless megközelítés szerint írtak — Serverless-by-design. Ezt az alapot azzal a céllal fejlesztették ki, hogy nem feltételezzék, hogy fizikai szervereken működik.
Ez az adatbázis Snowflake néven fut. Három kulcsfontosságú blokkja van.
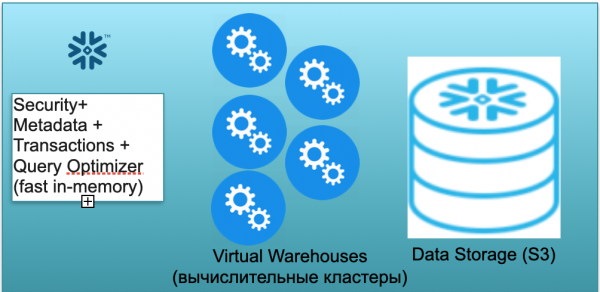
Az első — a metadatblokk. Ez egy gyors in-memory szolgáltatás, amely a biztonság, metaadatok, tranzakciók és a lekérdezés optimalizálásának kérdéseivel foglalkozik (a bal oldali illusztráción).
A második blokk — több virtuális számító klaszter a számításokhoz (a képen — egy kék körökből álló készlet).
A harmadik blokk — az S3 alapú adatkezelő rendszer. Az S3 egy korlátlan objektumtár az AWS-ben, olyasmi, mint egy korlátlan Dropbox az üzlet számára.
Nézzük meg, hogyan működik a Snowflake egy hideg indítással. Ez azt jelenti, hogy van egy adatbázis, az adatok betöltve, de aktív lekérdezések nincsenek. Ennek megfelelően, ha nincs lekérdezés az adatbázishoz, akkor egy gyors in-memory Metaadat szolgáltatásunk van felállítva (az első blokk). Van egy S3 tárolónk, ahol az adataink táblákra felosztva, úgynevezett mikropartíciókban találhatók. Egyszerűsítve: ha a táblában ügyletek vannak, akkor a mikropartíciók a tranzakciók napjai. Minden nap külön mikropartíció, külön fájl. Ezért amikor az adatbázis ebben a módban működik, csak az adatok által elfoglalt helyért fizet. Ráadásul a helydíj nagyon alacsony (különösen a jelentős tömörítés figyelembevételével). A metaadat szolgáltatás is folyamatosan üzemel, de az optimalizáláshoz nem igényel sok erőforrást, így a szolgáltatás lényegében ingyenesnek tekinthető.
Most képzeljük el, hogy egy felhasználó érkezik az adatbázisunkhoz, és indít egy SQL-lekérdezést. Az SQL-lekérdezés azonnal a Metaadat szolgáltatás feldolgozásába kerül. Ennek megfelelően, miután megkapta a lekérdezést, ez a szolgáltatás elemzi a lekérdezést, az elérhető adatokat, a felhasználó jogosultságait, és ha minden rendben van, elkészíti a lekérdezés feldolgozási tervét.
Ezután a szolgáltatás elindítja a számítási klasztert. A számítási klaszter egy szerverekből álló klaszter, amely végrehajtja a számításokat. Ez azt jelenti, hogy a klaszter tartalmazhat 1 szervert, 2, 4, 8, 16, 32 — ahogy szeretné. Ön csak bedobja a lekérdezést, és rá azonnal megkezdődik a klaszter elindítása. Ez valójában másodperceket vesz igénybe.
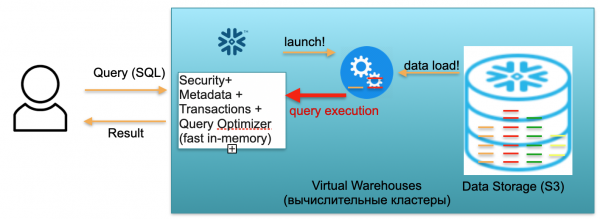
Ezután, miután a klaszter elindult, az S3-ból elkezdik másolni a mikropartikákat, amelyek szükségesek a kérésed feldolgozásához. Tehát, tegyük fel, hogy egy SQL kérés végrehajtásához két partícióra van szükség egy táblázatból, és egy másikból egy. Ilyen esetben a klaszterbe csak a három szükséges partíció másolódik, nem pedig az összes táblázat. Pontosan ezért, és mivel minden egy adatközpont keretein belül található és nagyon gyors csatornák kapcsolják össze, a teljes átvitel folyamata rendkívül gyorsan zajlik: másodpercek alatt, nagyon ritkán percek alatt, hacsak nem valamilyen rendkívüli kérésről van szó. Ennek megfelelően, a mikropartikák átmásolódnak a számítási klaszterre, és a befejezés után ezen a számítási klaszteren végrehajtják az SQL kérdést. Ennek a kérdésnek az eredménye lehet egy sor, több sor vagy táblázat - ezeket kiadják a felhasználónak, hogy az letöltse, megjelenítse a BI eszközében vagy más módon használja.
Minden SQL kérdés nemcsak aggregált adatokat olvashat ki a korábban betöltött adatokból, hanem új adatokat is betölthet/létrehozhat az adatbázisban. Tehát lehet egy olyan kérés, ami például új rekordokat illeszt be egy másik táblázatba, ami egy új partíció megjelenését eredményezi a számítási klaszteren, amely, cserébe, automatikusan elmentődik az egyetlen S3 tárolóba.
A fent leírt forgatókönyv, a felhasználó érkezésétől a klaszter elindításáig, az adatok betöltéséig, a kérdések végrehajtásáig, az eredmények megszerzéséig, a virtuális számítási klaszter, virtuális raktár használatának perc alapú tarifája szerint kerül elszámolásra. A tarifa az AWS zónától és a klaszter méretétől függően változik, de átlagosan ez néhány dollár óránként. A négy gépből álló klaszter kétszer annyiba kerül, mint a két gépből álló, a nyolc gépből álló pedig még kétszer annyiba. A 16-os, 32-es gépes lehetőségek is elérhetők, a kérések összetettségétől függően. De csak azokért a percekért fizetsz, amikor a klaszter valóban működik, mert ha nincsenek kérdések, „felrakod a kezed”, és 5-10 perc várakozás után (konfigurálható paraméter) magától leáll, felszabadítja az erőforrásokat és ingyenessé válik.
Teljesen valós forgatókönyv, amikor küldesz egy lekérdezést, a klaszter megjelenik, mondjuk, egy perc alatt, további egy percig számolja, aztán öt perc a leállítás, és végül hét percnyi munkáért fizetsz a klaszternek, nem hónapokért és évekért.
Az első forgatókönyv a Snowflake egyfelhasználós verziójának használatát írta le. Most képzeljük el, hogy sok felhasználó van, ami már közelebb áll a valós forgatókönyvhöz.
Tegyük fel, hogy sok elemző és Tableau-jelentés van, amelyek folyamatosan bombázzák az adatbázisunkat rengeteg egyszerű analitikai SQL-lekérdezéssel.
Ezen kívül legyenek leleményes adatkutatók, akik borzalmas dolgokat próbálnak végrehajtani az adatokkal, tizedek terabájtnyit kezelve, milliárdok és trilliók sorait elemezve.
A fent leírt két terheléstípus esetén a Snowflake lehetővé teszi, hogy több független számítási klasztert hozzunk létre különböző teljesítménnyel. Ezek a számítási klaszterek függetlenül működnek, de közös, konzisztens adatokkal dolgoznak.
Sok egyszerű lekérdezés esetén 2-3 kisebb klasztert hozhatsz létre, amelyek mérete körülbelül 2 gép. Ez a viselkedés automatikus beállításokkal is megvalósítható. Tehát azt mondod: „Snowflake, hozz létre egy kis klasztert. Ha a terhelése meghalad egy bizonyos paramétert, hozz létre hasonló másodikat, harmadikat. Amikor a terhelés csökkenni kezd — állítsd le a felesleget.” Így függetlenül attól, hogy hány elemző érkezik és kezd el jelentéseket nézni, mindenkinek elegendő erőforrása van.
Jelentkező esetén, ha az elemzők alszanak, és senki sem nézi a jelentéseket — a klaszterek teljesen leállíthatók, és ezért már nem kell fizetni.
Ezenkívül, nehéz lekérdezések esetén (adatkutatóktól) egy nagyon nagy klasztert is létrehozhatsz körülbelül 32 géppel. Ez a klaszter is csak azokért a percekért és órákért lesz számlázva, amikor a hatalmas lekérdezésed fut.
A fent leírt lehetőség lehetővé teszi, hogy a klasztereket ne csak 2, hanem több különböző terheléstípusra (ETL, monitoring, jelentések materializálása, …) is szétosszuk.
Összefoglalva a Snowflake-ről. Az adatbázis ötvözi a szép ötletet és a működő megvalósítást. A ManyChat-ben a Snowflake-t használjuk az összes rendelkezésre álló adat elemzésére. Nálunk nem három klaszter található, mint a példában, hanem 5 és 9 között, különböző méretekben. Vannak 16 gépes, 2 gépes, és nagyon kicsi, 1 gépes klaszterek is bizonyos feladatokhoz. Ezek sikeresen elosztják a terhelést és lehetővé teszik számunkra, hogy jelentős költségeket takarítsunk meg.
Az adatbázis sikeresen skálázza az olvasási és írási terhelést. Ez óriási különbség és hatalmas áttörés a 'Aurora'-hoz képest, amely csak az olvasási terhelést tudta kezelni. A Snowflake lehetővé teszi, hogy ezeket a számítási klasztereket az írási terhelés skálázására is használjuk. Amint említettem, a ManyChat-ben több klasztert használunk, a kis és szuperkicsi klaszterek főként ETL-feladatokra és adatok betöltésére szolgálnak. Az elemzők pedig közepes klasztereken dolgoznak, amelyek nincsenek kitéve az ETL-terhelésnek, ezért nagyon gyorsan működnek.
Ennek megfelelően az adatbázis jól illik az OLAP-feladatokhoz. Azt azonban sajnálatos módon elmondhatjuk, hogy az OLTP-terhelésekhez még nem alkalmazható. Először is, ez egy oszlopos adatbázis, az összes következményével együtt. Másodsorban, az a megközelítés, amikor minden egyes kérés esetén a szükséges számítási klasztert előhívják és adatokkal töltik fel, sajnos még nem elég gyors az OLTP-terhelésekhez. A másodperces várakozási idő OLAP-feladatoknál normális, de OLTP-feladatoknál elfogadhatatlan, jobb lenne 100 ms, de még jobb lenne - 10 ms.
Result
A serverless adatbázis lehetővé válik az adatbázis Stateless és Stateful részekre való felosztásával. Valószínűleg észrevette, hogy az összes példában a Stateful rész – mondjuk, hogy – a mikropartíciók S3-ban való tárolása, míg a Stateless – az optimalizáló, a metaadatok kezelése, a biztonsággal kapcsolatos kérdések feldolgozása, amelyek független, könnyű Stateless szolgáltatásként emelkedhetnek fel.
A SQL lekérdezések végrehajtása szintén úgy értelmezhető, mint könnyű állapotú szolgáltatások, amelyek serverless üzemmódban megjelenhetnek, mint a Snowflake számítási klaszterei, letölthetik csak a szükséges adatokat, végrehajthatják a lekérdezést és 'elhalhatnak'.
A szerver nélküli, produkciós szintű adatbázisok már elérhetők, és működnek. Ezek a szerver nélküli adatbázisok készen állnak az OLAP feladatok kezelésére. Sajnos az OLTP feladatokhoz való alkalmazásuk… árnyalt, mivel vannak korlátozások. Egyrészt ez hátrány. Másrészt viszont lehetőség. Lehet, hogy az olvasók között valaki megtalálja a módját, hogyan lehet az OLTP adatbázist teljesen szerver nélküli, korlátozások nélkül megvalósítani az Aurorával.
Remélem, érdekes volt. A szerver nélküli jövőért 🙂
Forrás: habr.com
