

Ha több mint egy évtizede fejlődő termékről van szó, egyáltalán nem meglepő, hogy elavult technológiákkal találkozunk benne. De mi van, ha fél év múlva tízszeres terhelést kell kezelnie, és a leállások költségei százszorosára nőnek? Ebben az esetben szüksége van egy kiváló Highload Engineerre. De mivel nem állt rendelkezésre ilyesfajta segítség, a problémát nekem kellett megoldanom. A cikk első részében arról mesélek, hogyan költöztünk a Redisról a Redis-clusterre, a második részben pedig tanácsokat adok, hogyan kezdjünk el használni egy klustert, és mire érdemes figyelni a működtetése során.
Technológia választás
Olyan rossz lenne különálló Redis (standalone redis) az 1 mester és N slave konfigurációban? Miért nevezem elavult technológiának?
Nem, a Redis nem olyan rossz… Azonban vannak bizonyos hiányosságai, amelyeket nem lehet figyelmen kívül hagyni.
Először is, a Redis nem támogatja a mester leállás utáni helyreállítási mechanizmusokat. E probléma megoldására egy automatikus VIP átkapcsolási konfigurációt használtunk, ami lehetővé tette a masterre való váltást, egyes slave-ek szerepének megváltoztatását és a többi átkapcsolását. Ez a mechanizmus működött, de nem nevezhető megbízható megoldásnak. Először is, hamis riasztások léptek fel, másodszor pedig egyszer használatos volt, és aktiválása után manuális lépések szükségesek a mechanizmus újraindításához.
Másodszor, egyetlen mester megléte a shardolási problémát okozott. Több független '1 mester és N slave' klasztert kellett létrehozni, majd manuálisan elosztani az adatbázisokat e gépek között, és remélni, hogy az egyik adatbázis másnap nem nő olyan nagyra, hogy külön instance-be kelljen áthelyezni.
Milyen lehetőségek vannak?
- A legdrágább és legkifinomultabb megoldás a Redis-Enterprise. Ez egy kész megoldás teljes technikai támogatással. Annak ellenére, hogy technikai szempontból tökéletesnek tűnik, ideológiai okokból nem volt megfelelő számunkra.
- Redis-cluster. Beépített támogatása van a mester átkapcsolásának és a shardolásnak. A felület szinte nem különbözik a normál verziótól. Ígéretesnek tűnik, a nehézségekről később beszélünk.
- Tarantool, Memcache, Aerospike és mások. Mindezek az eszközök körülbelül ugyanazt csinálják. De mindegyiknek megvannak a saját hátrányai. Úgy döntöttünk, hogy nem tesszük az összes tojást egy kosárba. A Memcache-t és a Tarantool-t más feladatokhoz használjuk, és, hogy előre mondjam, a gyakorlatunkban több problémánk is volt velük.
Felhasználási sajátosságok
Nézzük meg, hogy milyen feladatokat oldottunk meg történelmileg a Redis-szel és milyen funkciókat használtunk:
- Cache távoli szolgáltatásokhoz, mint például a 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Cache a MYSQL előtt | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Alap tároló a munkamenetek és a sofőrök koordinátáinak kezeléséhez | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Ahogy látjátok, itt nincs szükség felső matematikára. Mi a nehézség akkor? Nézzük meg külön-külön minden módszert.
Módszer
Leírás
Redis-cluster sajátosságai
Megoldás
GET SET
Kulcs írása/olvasása
MGET MSET
Több kulcs írása/olvasása
A kulcsok különböző csomópontokon lesznek. A kész könyvtárak csak egy csomóponton belül tudják végrehajtani a Multi-műveleteket.
Cserélje le az MGET-et N GET művelet pipeline-ra
SELECT DB
Válasszon egy adatbázist, amellyel dolgozni fogunk
Több adatbázis nem támogatott
Mindent egy adatbázisba helyezünk. Prefixeket kell adni a kulcsokhoz.
SCAN
Járja be az összes kulcsot az adatbázisban
Mivel egy adatbázisunk van, az összes kulcs bejárása a klaszterben túl költséges.
Fenntartani az invarianciát egy kulcs körül, és HSCAN-t végrehajtani ezen a kulcson. Vagy teljesen lemondani.
GEO
Műveletek a geo-kulccsal
A geo-kulcs nem shardolható.
KEY BY PATTERN
Kulcs keresése mintázat alapján
Mivel egy adatbázisunk van, a klaszterben minden kulcsot át kell nézni. Ez túl költséges.
Lemondani vagy fenntartani az invarianciát, ahogy a SCAN esetén.
Redis vs Redis-cluster
Mit veszítünk és mit nyerünk a klaszterre való áttéréssel?
- Hátrányok: elveszítjük a több adatbázis funkciókat.
- Ha logikailag nem összefüggő adatokat akarunk tárolni egy klaszterben, prefixekkel kell trükközni.
- Elveszítjük az összes "adatbázis szintű" műveletet, például a SCAN, DBSIZE, CLEAR DB stb. műveleteket.
- A Multi-műveletek jelentősen bonyolultabbá váltak, mivel lehet, hogy több csomóponthoz kell fordulni.
- Előnyök:
- Hibatűrés, mint a fő felhasználó vészkapcsolása.
- Shardolás a Redis oldalán.
- Adatok atomisztikus átvitele a csomópontok között és leállások nélkül.
- Kapacitások és terhelések hozzáadása és újraelosztása leállások nélkül.
Azt mondanám, hogy ha nem szükséges a magas szintű rendelkezésre állás biztosítása, akkor nem éri meg a migrálás a klaszterre, mivel ez nem triviális feladat lehet. De ha eredendően választani kellene a külön verzió és a klaszter között, akkor a klasztert érdemes választani, mivel semmivel sem rosszabb, sőt, csökkenti a fejfájást.
Készülődés a migrációra
Kezdjük a migráció követelményeivel:
- Zavartalanul kell végbemennie. A szolgáltatás teljes leállítása 5 percre számunkra nem elfogadható.
- Minél biztonságosabb és fokozatosabb kell, hogy legyen. Szeretnénk valamilyen kontrollt a helyzet felett. Nem akarunk mindent egyszerre eldobni és imádkozni a visszaállító gombra.
- Minimális adatvesztés a migráció során. Tudatában vagyunk annak, hogy atomarizálva nagyon nehéz lesz a migráció, ezért elengedjük a bizonyos fokú adatszinkronizációt a hagyományos és a klaszteres Redis között.
A klaszter karbantartása
A migráció előtt érdemes elgondolkodni azon, hogy tudjuk-e támogatni a klasztert:
- Grafikonok. A Prometheus-t és a Grafana-t használjuk a processzorok terheléséről, az elfoglalt memóriáról, a kliensszámról, a GET, SET, AUTH stb. műveletek számáról készült grafikonokhoz.
- Szakértelem. Képzelje el, hogy holnap egy hatalmas klaszter lesz a felelőssége alatt. Ha meghibásodik, senki, csak Ön tudja megjavítani. Ha elkezd akadozni – mindenki Önhez fog futni. Ha erőforrásokat kell hozzáadni vagy a terhelést újra kell osztani – ismét Önre hárul. Hogy elkerülje, hogy 25 évesen megőszüljön, érdemes előre gondoskodni ezekről az esetekről és előre megvizsgálni, hogyan fog a technológia viselkedni az egyes intézkedések során. Erről bővebben az „Szakértelem” részben fogunk beszélni.
- Monitoring és értesítések. Amikor a klaszter meghibásodik, elsők között szeretnénk tudomást szerezni róla. Mi itt annyira kértük, hogy értesítést kapjunk, ha az összes node ugyanazt az információt adja a klaszter állapotáról (igen, előfordulhat másképp is). A többi problémát gyorsabban észlelni a Redis kliensszolgáltatások értesítésein keresztül.
Költözés
Hogyan fogunk migrálni:
- Elsősorban fel kell készíteni a könyvtárat a klaszter működésére. A Gо verzió alapjaként a go-redis-t vettük, és kissé módosítottuk. A Multi-módszereket pipeline-okon keresztül valósítottuk meg, és a kérésismétlési szabályokat is némileg finomítottuk. A PHP verzióval több probléma merült fel, de végül a php-redis mellett döntöttünk. Nemrégiben bevezették a klaszter támogatását, ami szerintünk jól néz ki.
- Ezután magát a klasztert kell telepíteni. Ez gyakorlatilag két parancs végrehajtásával történik a konfigurációs fájl alapján. A beállítást részletesebben az alábbiakban vitatjuk meg.
- A fokozatos átálláshoz dry-mode-ot használunk. Mivel két, azonos interfésszel rendelkező könyvtárverziónk van (az egyik a normál verzió, a másik a klaszterhez), nem nehéz készíteni egy burkolót, amely az egyik verzióval működik, és párhuzamosan minden kérdést duplikál a klaszterbe, összehasonlítja a válaszokat, és a különbségeket a naplóba írja (az esetünkben a NewRelic-be). Így ha a klaszter verzió telepítésekor hiba merül fel, az nem érinti a termelési környezetünket.
- A klaszter dry-üzemmódban történő kiadásával nyugodtan figyelhetjük a válaszok eltérésének grafikonját. Ha a hibák aránya lassan, de biztosan egy kis konstans felé mozdul, akkor minden rendben van. Miért vannak még eltérések? Mert a külön verzióba való írás egy kicsit korábban történik, mint a klaszterbe, és a mikrolag miatt az adatok eltérhetnek. Csak meg kell nézni a különbségek naplóit, és ha azok mind érthetőek a nem atomikus írás miatt, akkor lehet tovább haladni.
- Most visszaállíthatjuk a dry-mode-ot. Írás és olvasás most a klaszterből fog történni, miközben duplikálunk egy külön verzióba. Miért? A következő héten szeretnénk figyelni a klaszter működését. Ha esetleg kiderül, hogy a terhelés csúcsán problémák merülnek fel, vagy valamit elfelejtettünk, mindig van lehetőségünk vészhelyzeti visszavonásra a régi kódra és a naprakész adatokra a dry-mode-nak köszönhetően.
- Most már csak a dry-mode kikapcsolása és a külön verzió eltávolítása maradt hátra.
Szaktudás
Először is, röviden a klaszter felépítéséről.
Elsősorban a Redis – egy kulcs-érték tároló. A kulcsként tetszőleges karakterláncok használhatók. Az értékek lehetnek számok, karakterláncok és összetett struktúrák. Utóbbiból rengeteg van, de a teljes felépítés megértéséhez ez nem fontos.
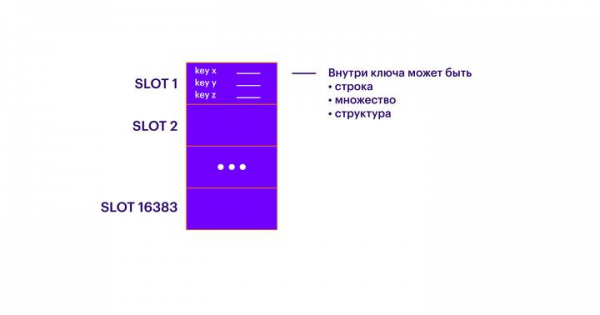
A következő absztrakciós szint a slotok (SLOTS). Minden kulcs egy a 16 383 slot közül tartozik. Minden slotban bármennyi kulcs lehet. Így a kulcsok 16 383 diszjunkt halmazra oszthatók.
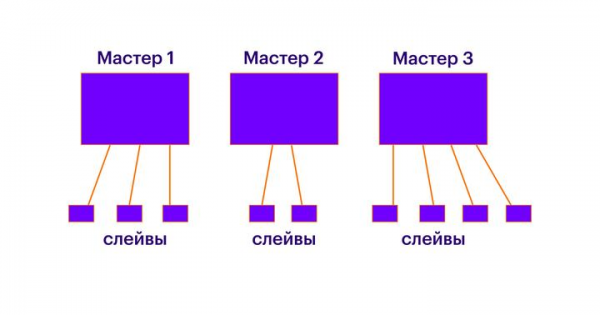
Ezután a klaszterben N mester-nódnak kell lennie. Minden nódot egy külön Redis példányként képzelhetünk el, amely tud mindent a klaszter többi nódjáról. Minden mester-nód tartalmaz néhány slotot. Minden slot csak egy mester-nódhoz tartozik. A slotokat el kell osztani a nódok között. Ha vannak olyan slotok, amelyek nem lettek elosztva, akkor az azokban tárolt kulcsok nem lesznek elérhetők. Érdemes minden mester-nódot külön logikai vagy fizikai gépen futtatni. Azt is érdemes észben tartani, hogy minden nód csak egy magon működik, és ha több Redis példányt akarunk futtatni egy logikai gépen, akkor győződjünk meg arról, hogy azok különböző magokon fussanak (mi nem próbáltuk így, de elméletileg minden működik). Lényegében a mester-nódok biztosítják a szokásos shardelést, és a több mester-nód lehetővé teszi a felírási és olvasási lekérések skálázását.
Miután minden kulcs el van osztva a slotok között, és a slotok a mester-nódokon szétszóródnak, bármennyi slave-nódot hozzáadhatunk minden mester-nódhoz. Minden ilyen „mester-slave” párosban a szokásos replikáció fog működni. A slave-ek szükségesek az olvasási lekérések skálázásához és a mester meghibásodása esetén a hibamentes váltáshoz.
Most beszéljünk azokról a műveletekről, amelyeket jobb lenne tudni végezni.
A rendszerhez a Redis-CLI-n keresztül fogunk elérni. Mivel a Redis-nak nincs egyetlen belépési pontja, a következő műveleteket bármelyik nódon el lehet végezni. Minden egyes pontnál külön figyelembe veszem a művelet terhelés alatti végrehajtásának lehetőségét.
- Az első és legfontosabb dolog, amire szükségünk van: a cluster nodes művelet. Ez visszaadja a klaszter állapotát, megmutatja a nódok listáját, a szerepüket, a slotok eloszlását és így tovább. További információk a cluster info és a cluster slots segítségével érhetők el.
- Jó lenne tudni, hogyan kell csomópontokat hozzáadni és eltávolítani. Ehhez a cluster meet és cluster forget műveletek állnak rendelkezésre. Fontos megjegyezni, hogy a cluster forget-t minden egyes csomópont esetében alkalmazni kell, mind a mesterek, mind a replikák esetében. A cluster meet viszont csupán egyetlen csomóponton is elégséges. Ez a különbség zavaró lehet, ezért jobb tájékozódni róla, mielőtt üzembe helyezné a klasztert. Egy csomópont biztonságosan hozzáadható aktív működés közben, és nem befolyásolja a klaszter működését (ami logikus). Ha azonban el szeretné távolítani a csomópontot a klaszterből, győződjön meg arról, hogy nem maradtak lemezek rajta (különben kockázatot vállal arra, hogy elveszíti az összes kulcsot ezen a csomóponton). Ezenkívül ne távolítsa el azt a mestert, amelynek vannak replikái, mert külön szavazás indul új mester kiválasztására. Ha a csomópontokon már nincsenek lemezek, akkor ez kicsi probléma, de miért lenne szükségünk felesleges választásokra, ha először eltávolíthatjuk a replikákat.
- Ha szükség van a mester és a replika kényszerített felcserélésére, akkor a cluster failover parancs megfelelő. Aktív működés közben ezt a parancsot használva figyelembe kell venni, hogy a művelet végrehajtása során a mester elérhetetlen lesz. Általában a váltás kevesebb mint egy másodperc alatt megtörténik, de nem atomikus. Számíthat arra, hogy a mesterhez érkező néhány lekérdezés hibaüzenettel zárul ebben az időszakban.
- A klaszterből való node eltávolítása előtt nem maradhatnak rajta slotok. Ezeket legjobban a cluster reshard paranccsal érdemes áthelyezni. A slotok egyik mesterről a másikra lesznek átvive. Az egész művelet több percet is igénybe vehet, attól függően, hogy mennyi adatot kell átkonvertálni, azonban a folyamat biztonságos, és a klaszter működésére nincs hatással. Így az összes adatot közvetlenül terhelés alatt lehet áthelyezni egy nodról a másikra, anélkül, hogy aggódni kellene a rendelkezésre állásuk miatt. Viszont vannak finomságok is. Először is, az adatok áthelyezése bizonyos terhelést ró a fogadó és az elküldő nodra. Ha a fogadó node már erősen terhelt a CPU-jával, akkor nem érdemes még új adatok átvételével is terhelni. Másodszor, amint a küldő masteren már nem marad slot, az összes slave azonnal átkerül arra a masterre, ahová a slotokat átvitték. A probléma az, hogy ezek a slave-ek egyszerre akarnak majd szinkronizálni az adatokkal. Szerencséje lesz, ha ez részleges, és nem teljes szinkronizálás lesz. Ezt vegye figyelembe, és kombinálja a slotok áthelyezését és a slave-ek lekapcsolását/áthelyezését. Vagy remélje, hogy elegendő tartalék áll rendelkezésre.
- Mi a teendő, ha áthelyezés közben észreveszi, hogy valahová elvesztette a slotokat? Remélem, ez a probléma nem érinti, de ha mégis, van egy cluster fix művelet. Ez véletlenszerűen szétszórja a slotokat a nodok között. Azt javaslom, hogy tesztelje a működését azelőtt, hogy eltávolítaná a klaszterből azt a nodot, ahol a slotok el vannak osztva. Mivel az adatok a nem elosztott slotokon így is elérhetetlenek, már késő aggódni a hozzáférhetőségi problémák miatt. Viszont az elosztott slotokra a művelet nem fog hatással lenni.
- Egy másik hasznos művelet a monitor. Ez lehetővé teszi, hogy valós időben lássa a node-ot elérő összes kérés listáját. Sőt, ezen keresztül grep-elhet, és megtudhatja, van-e szükséges forgalom.
Érdemes szólni a mester átkapcsolási eljárásról is. Röviden, van ilyen, és véleményem szerint jól működik. azonban ne gondold, hogy ha kihúzod a gépből a tápkábelt, a Redis azonnal átkapcsol, és az ügyfelek nem érzékelik a veszteséget. Tapasztalataim szerint az átkapcsolás néhány másodpercet vesz igénybe. Ezalatt az idő alatt egyes adatok nem lesznek elérhetők: a rendszer észleli a mester elérhetetlenségét, a csomópontok szavaznak egy újra, a slave-ek átkapcsolnak, az adatok szinkronizálódnak. A legjobb módja annak, hogy saját magad győződj meg arról, hogy a rendszer működik, az, hogy helyi gyakorlatokat végezzen. Indítsd el a klasztert a laptopodon, adj minimális terhelést, szimuláld a leállást (például portok blokkolásával), értékeld az átkapcsolás sebességét. Véleményem szerint csak néhány napos kreatív játék után lehet biztosan tudni, hogy a technológia működik. Vagy bízhatsz abban, hogy a szoftver, amelyet az internet fele használ, biztosan működik.
Konfiguráció
Gyakran a konfiguráció az első, amire szükség van az eszközzel való munkához. És amikor minden működik, nem szeretnél hozzá nyúlni a konfigurációhoz. Bizonyos erőfeszítéseket kell tenni ahhoz, hogy rávegyed magad, hogy visszatérj a beállításokhoz és alaposan átnézd őket. Emlékeim szerint legalább két súlyos hiba történt a konfigurációval való figyelmetlenség miatt. Kérlek, különösen figyelj a következő pontokra:
- timeout 0
Az az idő, amely után a tétlen kapcsolatok bezáródnak (másodpercben). 0 — nem záródnak be
Nem minden könyvtárunk tudta helyesen bezárni a kapcsolatokat. Ennek a beállításnak a kikapcsolásával kockára tesszük, hogy elérjük a klienslimitet. Másrészről, ha ilyen problémánk van, akkor az elveszett kapcsolatok automatikus megszakítása elrejti azt, és talán észre sem vesszük. Ezen kívül érdemes elkerülni ezt a beállítást persistent kapcsolatok használatakor. - Save x y & appendonly yes
Az RDB pillanatkép mentése.
Az RDB/AOF problémákat részletesen megvitatjuk később. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Ha be van kapcsolva, a mester abbahagyja a módosító kérések fogadását, ha az RDB pillanatkép hibás. Ha a mesterrel való kapcsolat megszakad, a slave továbbra is válaszolhat a kérésekre (igen). Vagy leállíthatja a válaszadást (nem)
Nem vagyunk elégedettek azzal a helyzettel, amikor a Redis tök formájúvá válik. - repl-ping-slave-period 5
Ezen időszak után kezdünk aggódni amiatt, hogy a mester leállt, és ideje lenne elvégezni a failover eljárást.
Kézzel kell megtalálni az egyensúlyt a hamis riasztások és a failover elindítása között. Tapasztalataink szerint ez 5 másodperc. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Pont annyi adatot tudunk tárolni a leállt replikák puffereiben. Ha a puffer elfogy, teljes szinkronizációra lesz szükség.
A gyakorlat azt mutatja, hogy érdemes nagyobb értéket megadni. Rengeteg ok van, ami miatt a replika késlekedhet. Ha késlekedik, valószínűleg a mestere már nehezen birkózik meg, és a teljes szinkronizáció az utolsó csepp lesz. - maxclients 10000
A maximális egyidejű kliensek száma.
Tapasztalataink szerint érdemes nagyobb értéket beállítani. A Redis 10 ezer kapcsolatot is remekül kezel. Csak győződjön meg arról, hogy a rendszerben elegendő socket található. - maxmemory-policy volatile-ttl
A szabály, amely alapján a kulcsok eltávolításra kerülnek, ha elérjük a rendelkezésre álló memória határát.
Itt nem maga a szabály a fontos, hanem a megértés, hogyan fog ez végbemenni. A Redis dicséretes abban, hogy képes normálisan működni a memóriahatár elérésekor.
RDB és AOF problémák
Bár maga a Redis minden információt a memóriában tárol, létezik egy adatok lemezre mentésére szolgáló mechanizmus. Konkrétan három mechanizmus:
- RDB-snapshot - a teljes adathalom pillanatképe. A SAVE X Y konfigurálásával állítható be, és úgy olvasható, mint „Minden X másodpercben készítsen teljes pillanatképet az adatokról, ha legalább Y kulcs változott meg”.
- Append-only file - az elvégzett műveletek listája a végrehajtás sorrendjében. Újonnan érkezett műveleteket ad hozzá a fájlhoz X másodpercenként vagy Y műveletenként.
- RDB és AOF - a két előző kombinációja.
Minden módszernek megvannak a maga előnyei és hátrányai, nem fogom mindet felsorolni, csak a számomra nem nyilvánvaló szempontokra hívom fel a figyelmet.
Először is, az RDB-pillanatkép mentéséhez FORK hívása szükséges. Ha sok adat van, ez akár néhány millisecondtól egy másodpercig is felfüggesztheti az egész Redis-t. Ezenkívül a rendszernek memóriát kell allokálnia egy ilyen pillanatképhez, ami dupla memóriatartalék fenntartását igényli a logikai gépen: ha a Redis számára 8 GB van fenntartva, akkor a virtuális gépen ennek 16 GB-nak kell lennie.
Másodszor, problémák vannak a részleges szinkronizációval. A AOF üzemmódban, amikor a sláverként való újracsatlakozás történik, ahelyett, hogy részleges szinkronizáció valósulna meg, teljes szinkronizáció történhet. Nem tudtam kideríteni, miért van ez így. De érdemes erre figyelni.
Ez a két pont már elgondolkodtat arról, hogy tényleg szükségünk van-e ezekre az adatokra a lemezen, ha úgyis minden a slávokon van másolva. Az adatok elvesztése csak akkor lehetséges, ha az összes sláv meghibásodik, ami már egy „tűzeset az adatközpontban” szintű probléma. Kompromisszumként ajánlhatjuk, hogy az adatokat csak a slávokon tároljuk, de ebben az esetben biztosítani kell, hogy ezek a slávok soha ne váljanak fő gittté vészhelyzet-helyreállításkor (ehhez a slávok prioritásának beállítása szükséges a konfigurációjukban). Minden egyes esetben mérlegeljük, hogy szükség van-e az adatok lemezre mentésére, és leggyakrabban azt válaszoljuk, hogy „nem”.
Zárás
Összességében remélem, hogy sikerült általános képet adnom a redis-cluster működéséről azoknak, akik még sosem hallottak róla, és felhívtam a figyelmet néhány nem nyilvánvaló dologra azok számára, akik már régóta használják.
Köszönöm az időt, és mint általában, a témával kapcsolatos megjegyzések mindig üdvözlendők.
Forrás: habr.com
