

Vizsgáljuk meg a Kubernetes monitorozás koncepcióját, ismerkedjünk meg a Prometheus eszközzel, és beszéljünk az értesítésekről.
A monitorozás témája kiterjedt, egyetlen cikkben nem lehet kimerítően bemutatni. Ennek a szövegnek a célja, hogy áttekintő képet adjon az eszközökről, koncepciókról és megközelítésekről.
A cikk anyaga - a . Ha teljes körű képzést szeretne, iratkozzon fel a .
Mit figyelnek a Kubernetes klaszterben?
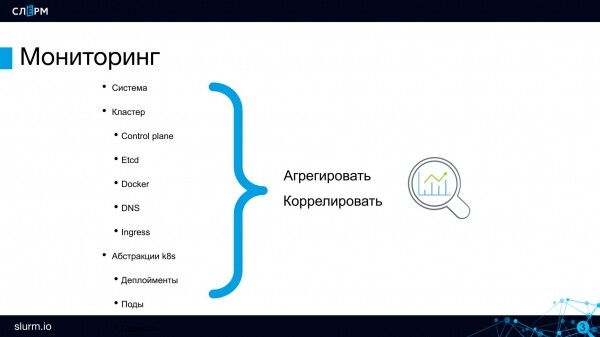
Fizikai szerverek. Ha a Kubernetes klaszter saját szervereken van telepítve, figyelni kell azok állapotára. Ezt a feladatot a Zabbix végzi; ha Ön ezt használja, akkor nem szükséges lemondania róla, nem lesznek konfliktusok. A szervereink állapotát éppen a Zabbix figyeli.
Lépjünk a klaszter szintű monitorozásra.
Control Plane komponensek: API, Scheduler és mások. Legalább annyit figyelni kell, hogy az API szerverek vagy az etcd állománya nagyobb legyen 0-nál. Az etcd sok metrikát tud biztosítani: a rajta futó lemezekről, a saját klasztere egészségéről és másokról.
Docker a Docker régóta létezik, és a problémái jól ismertek: sok konténer generálja a fagyásokat és egyéb problémákat. Ezért magát a Dockert is érdemes ellenőrizni, legalábbis a hozzáférhetősége szempontjából.
DNS. Ha a klaszterben a DNS megszakad, akkor az összes Discovery szolgáltatás is megszakad, megszűnnek a podok közötti hívások. A gyakorlatomban ilyen problémák nem voltak, de ez nem jelenti azt, hogy a DNS állapotát ne kellene figyelni. Késések a lekérdezésekben és más metrikák nyomon követhetők a CoreDNS-en.
Ingress. Figyelni kell az ingresszek (beleértve az Ingress Controller-t) elérhetőségét, mint a projekt belépési pontjait.
A klaszter főbb komponenseit átbeszéltük – most nézzük meg az absztrakciók szintjét.
Elsőre úgy tűnhet, hogy az alkalmazások podokban futnak, ezért ezeket is figyelni kellene, de valójában nem. A podok efemer típusúak: ma az egyik szerveren működnek, holnap a másikon; ma 10 pod van, holnap 2. Ezért egyszerű podokat senki nem monitoroz. A mikroszolgáltatás-architektúra keretein belül fontosabb az alkalmazás elérhetőségének figyelése, mint az egyes podoké. Különösen ellenőrizni kell a szolgáltatás végpontjainak elérhetőségét: működik-e egyáltalán valami? Ha az alkalmazás elérhető, akkor mi történik mögötte, hány replikája van most – ezek másodlagos kérdések. Nincs szükség az egyes példányok figyelésére.
Az utolsó szinten szükséges figyelemmel kísérni az alkalmazás működését, üzleti metrikákat gyűjteni: megrendelések száma, felhasználói viselkedés és egyebek.
Prometheus
A legjobb rendszer a klaszter monitorozására a Prometheus. Nem tudok olyan eszközről, amely a Prometheus minőségével és használhatóságával versenyezhetne. Kiválóan alkalmas rugalmas infrastruktúrákra, ezért amikor a „Kubernetes monitorozásáról” beszélünk, általában a Prometheusra gondolunk.
Van néhány lehetőség, ahogyan kezdhetjük a munkát a Prometheusszal: a Helm segítségével telepíthetjük a szokásos Prometheust vagy a Prometheus Operator-t.
- Szokásos Prometheus. Ezzel minden rendben van, de konfigurálni kell a ConfigMap-et — lényegében szöveges konfigurációs fájlokat kell írni, ahogy azt régen tettük, a mikroszerviz architektúra előtt.
- A Prometheus Operator egy kicsit bonyolultabb, egy kicsit nehezebb a belső logikája, de könnyebb vele dolgozni: külön objektumok vannak, az absztrakciók hozzáadódnak a klaszterhez, így sokkal kényelmesebb őket ellenőrizni és konfigurálni.
A termék megértéséhez ajánlom, hogy először állítsuk be a szokásos Prometheust. Minden konfigurálni kell a konfigurációs fájlon keresztül, de ez jótékony hatással lesz: megértjük, hogy mi micsoda és hogyan állítható be. A Prometheus Operatorral azonnal egy magasabb absztrakciós szintre lépünk, bár ha szeretnénk, mélyebben is belemerülhetünk.
A Prometheus jól integrálódik a Kubernetes-be: képes interfészelni az API Severrel és kölcsönhatásba lépni vele.
A Prometheus népszerű, ezért sok alkalmazás és programozási nyelv támogatja. A támogatás szükséges, mivel a Prometheus saját metrikái formátumban működik, és a metrikák átviteléhez belső könyvtárra van szükség a programon belül vagy egy előre elkészített exportálóra. Számos ilyen exportáló létezik. Például van PostgreSQL Exporter: ez adatokat vesz a PostgreSQL-ből és konvertálja őket a Prometheus formátumába, hogy a Prometheus dolgozhasson velük.
A Prometheus architektúrája
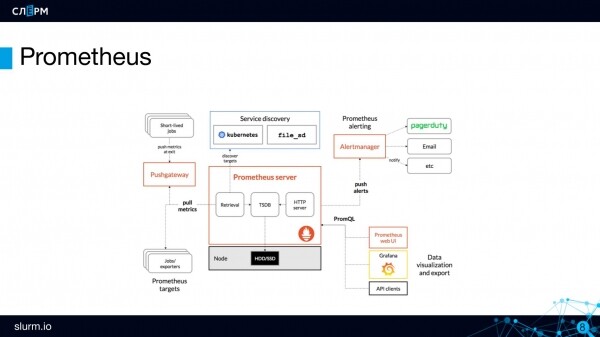
Prometheus Server — ez a szerveroldali rész, a Prometheus agya. Itt tárolják és dolgozzák fel a metrikákat.
A metrikákat time series database (TSDB) tárolja. A TSDB nem egy külön adatbázis, hanem egy Go nyelvű csomag, amely be van építve a Prometheusba. Durván szólva, minden egyetlen bináris fájlban található.
Ne tárolj adatokat sokáig a TSDB-ben.
A Prometheus infrastruktúra nem alkalmas hosszú távú metrikák tárolására. Alapértelmezés szerint a megőrzési idő 15 nap. Ezt a korlátozást lehet túllépni, de figyelembe kell venni: minél több adatot tárol a TSDB-ben, és minél hosszabb ideig, annál több erőforrást fog fogyasztani. A történeti adatok Prometheusban való tárolása rossz gyakorlatnak számít.
Ha hatalmas forgalma van, és a metrikák száma számos százezerre rúg másodpercenként, akkor jobban teszi, ha korlátozza a tárolást lemezméret vagy időtartam alapján. Általában a TSDB-ben "forró adatokat" tárolnak, amelyeket csak néhány óra alatt gyűjtenek. Hosszabb távú tárolásra külső tárolókat használnak olyan adatbázisokban, amelyek valóban alkalmasak erre, például InfluxDB, ClickHouse és így tovább. Több jó véleményt láttam a ClickHouse-ról.
A Prometheus Server a következő modellen működik pull: ő maga megy a metrikákért a megadott végpontokhoz. Azt mondtuk: "menj az API Serverhez", és ő n egy adott másodpercenként odamegy és lekéri a metrikákat.
Rövid életű objektumok (job vagy cron job) esetén, amelyek a lekérdezési időszakok között jelentkezhetnek, létezik egy Pushgateway nevű komponens. Itt tolódnak be a metrikák a rövid távú objektumoktól: a job elindul, végrehajt egy műveletet, elküldi a metrikákat a Pushgateway-be, majd befejeződik. Néhány idő múlva a Prometheus a saját ritmusában elmegy és lekéri ezeket a metrikákat a Pushgateway-ből.
A Prometheusban az értesítések beállításához külön komponens áll rendelkezésre - Alertmanager. És az értesítési szabályok - alerting rules. Például, ha 0 a API szerverek száma, akkor figyelmeztetést kell létrehozni. Amikor az esemény bekövetkezik, a figyelmeztetés továbbítódik az alert managerhez a további küldés érdekében. Az alert manager meglehetősen rugalmas routing beállításokat kínál: egy csoport figyelmeztetéseit küldheti a rendszergazdák Telegram csevegésébe, egy másikat a fejlesztők csevegésébe, a harmadikat az infrastruktúra-hallgatók csevegésébe. Az értesítések érkezhetnek Slackre, Telegramra, emailre és más csatornákra.
Végül szeretnék mesélni a Prometheus killer funkciójáról - Felfedezés. A Prometheussal való munka során nem kell konkrét címeket megadni a figyeléshez, elegendő csak a típusukat megadni. Azaz nem kell azt írni, hogy "itt az IP-cím, itt a port - figyeld", hanem meg kell határozni, milyen elvek szerint találhatók ezek az objektumok (targets — célok). A Prometheus maga, attól függően, hogy mely objektumok aktívak, lehúzza a szükségeseket és hozzáad a figyeléshez.
Ez a megközelítés jól illeszkedik a Kubernetes struktúrájához, ahol szintén mindent mozgatunk: ma 10 szerver, holnap 3. Hogy ne kelljen minden alkalommal megadni a szerver IP-címét, egyszer megírtuk, hogyan találjuk meg — és a Discovering ezt meg fogja tenni.
A Prometheus nyelve PromQL. Ezzel a nyelvvel konkrét metrikák értékeit lehet lekérdezni, majd azokat átalakítani, elemzéseket készíteni belőlük.
https://prometheus.io/docs/prometheus/latest/querying/basics/

Egyszerű lekérdezés

    container_memory_usage_bytes

Matematikai műveletek

    container_memory_usage_bytes / 1024 / 1024

Beépített funkciók

    sum(container_memory_usage_bytes) / 1024 / 1024

Lekérdezés finomítása

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
A Prometheus webes felülete
A Prometheusnak van egy meglehetősen minimalista webes felülete. Csak hibakereséshez vagy bemutatókhoz alkalmas.
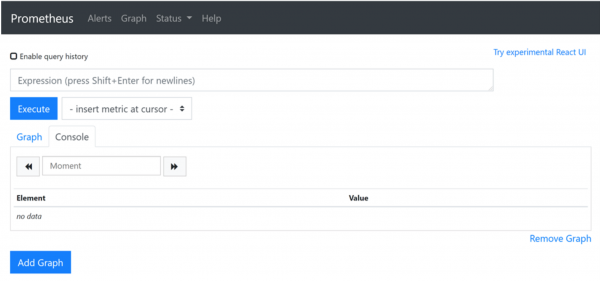
Az Expression sorban PromQL nyelven írhatók a lekérdezések.
Az Alerts fülön találhatók az alerting rules szabályai, és ezeknek három státusza van:
- inactive — ha az alert éppen nem aktív, azaz minden rendben van vele, és nem működött;
- pending — akkor lép ez érvénybe, ha az alert már aktiválódott, de az értesítés még nem ment ki. A késleltetés azért van, hogy kompenzálja a hálózati ingadozásokat: ha egy perc alatt a megadott szolgáltatás elindult, akkor még nem szükséges riasztani;
- firing — ez a harmadik státusz, amikor az alert aktiválódik és üzeneteket küld.
A Status menüben hozzáférést talál a Prometheus állapotához. Itt van átjáró a célokhoz (targets), amikről korábban beszéltünk.
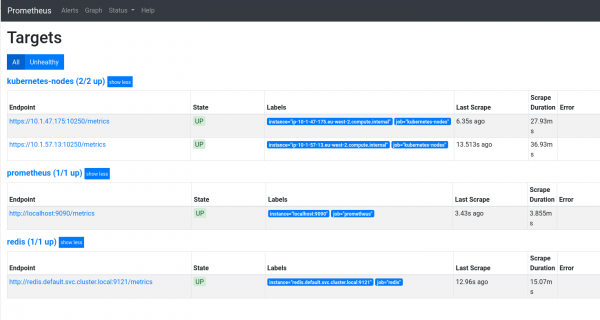
A Prometheus interfész részletesebb áttekintését megtalálja .
Integráció Grafanával
A Prometheus webes felületén nem talál szép és érthető grafikonokat, amelyekből következtetéseket vonhat le a klaszter állapotáról. A grafikonok készítéséhez a Prometheust Grafanával integrálják. Ezekből ilyen műszerfalak készülnek.
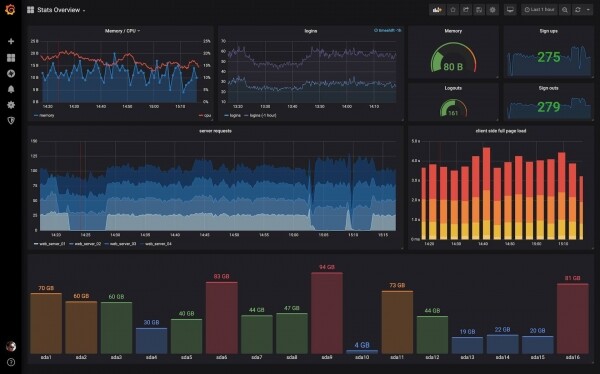
A Prometheus és Grafana integrálása nem bonyolult, az útmutatót a dokumentációban találja: , de ezzel most befejezem.
A következő cikkekben folytatjuk a monitorozás témáját: beszélünk a naplógyűjtésről és -elemzésről a Grafana Loki és más alternatív eszközök segítségével.
Szerző: Marsel Ibraev, Kubernetes tanúsítvánnyal rendelkező adminisztrátor, gyakorló mérnök a , előadó és a Slurm kurzusok fejlesztője.
Forrás: habr.com
