

Az elmúlt körülbelül fél évben egy csalásellenes rendszer létrehozásával foglalkoztam, kezdeti infrastruktúra nélkül. A mai napig összegyűjtött és megvalósított ötleteink segítenek felfedezni számos csalást és elemezni azokat. Ebben a cikkben szeretném bemutatni azokat az elveket, amelyeket követtünk, és azt, hogy mit tettünk a jelenlegi állapotunk eléréséhez, anélkül, hogy mélyebben belemerülnénk a technikai részletekbe.
Rendszerünk elvei
Amikor olyan kifejezéseket hallasz, mint az „automatikus” és a „csalás”, valószínűleg a gépi tanulásra, az Apache Sparkra, a Hadoopra, a Pythonra, az Airflow-ra és az Apache Foundation ökoszisztémájának más technológiáira és a Data Science területére gondolsz. Úgy vélem, hogy van egy aspektusa ezeknek az eszközöknek a használatának, amelyről általában nem beszélnek: ezek bizonyos előfeltételeket igényelnek a vállalati rendszeredben, mielőtt elkezded őket használni. Röviden, szükséged van egy vállalati adatplatformra, amely tartalmaz egy adatkutatót és egy tárolót. De mi van, ha nincs ilyen platformod, és mégis szükséged van ennek a gyakorlásnak a fejlesztésére? Az alábbi elvek, amelyekről most beszélek, segítettek elérni azt a pillanatot, amikor a gondolataink javítására tudtunk összpontosítani, nem pedig a működő megoldások keresésére. Mindazonáltal ez nem a projekt „platója”. Még sok minden van a tervek között technikai és termék szempontból.
1. Elv: elsődlegesen üzleti érték
Minden erőfeszítésünk élén az „üzleti érték” áll. Általánosságban bármilyen automatikus elemző rendszer a magas szintű automatizáltsággal és technikai komplexitással rendelkező összetett rendszerek csoportjába tartozik. Egy kész megoldás létrehozása sok időt venne igénybe, ha azt a nulláról építed fel. Mi úgy döntöttünk, hogy elsődlegesen az üzleti értékre, másodlagosan pedig a technológiai teljességre helyezzük a hangsúlyt. A valós életben ez azt jelenti, hogy nem tekintjük a fejlett technológiákat dogmaként. Olyan technológiát választunk, amely jelenleg a legjobban működik számunkra. Idővel elképzelhető, hogy bizonyos modulokat újra kell építenünk. Ez a kompromisszum, amit elfogadtunk.
2. Elv: Kiterjesztett emberi intelligencia
Fogadom, hogy a legtöbb ember, aki nincs mélyen bevonva a gépi tanulási megoldások fejlesztésébe, azt gondolja, hogy az emberek helyettesítése a cél. Valójában a gépi tanulási megoldások messze nem tökéletesek, és csak bizonyos területeken lehetséges a helyettesítés. Ezt az elképzelést az elejétől fogva elvetettük, több okból is: a csalási tevékenységről szóló kiegyensúlyozatlan adatok és a gépi tanulási modellekhez szükséges funkciók kimerítő listájának megadásának lehetetlensége miatt. Ezzel szemben mi egy kiterjesztett intelligencia megoldást választottunk. Ez egy alternatív mesterséges intelligencia koncepció, amely az AI támogató szerepére összpontosít, hangsúlyozva, hogy a kognitív technológiák a humán intelligencia javítására, nem pedig helyettesítésére szolgálnak. [1]
Figyelembe véve ezt, egy teljes gépi tanulási megoldás kifejlesztése a kezdetektől óriási erőfeszítéseket igényelt volna, amelyek késleltették volna az üzletünk számára érték létrehozását. Úgy döntöttünk, hogy egy iteratívan növekvő gépi tanulási aspektussal rendelkező rendszert építünk a szakértőink irányításával. Az ilyen rendszer fejlesztésének bonyolult része az, hogy a rendszereknek nemcsak az a fontos, hogy az adott eset csalási tevékenység-e vagy sem. Általánosságban bármilyen anomália az ügyfelek viselkedésében gyanús esetnek számít, amelyet a szakembereknek ki kell vizsgálniuk és valamilyen módon reagálniuk kell. Csak ezen rögzített esetek egy része tartozik valóban a csalás kategóriájába.
3. Elv: átfogó analitikai adatplatform
A rendszerünk legbonyolultabb része a munkafolyamatok átfogó ellenőrzése. Az elemzőknek és fejlesztőknek könnyen hozzáférhetők kell legyenek a múltbeli időszakok adatcsomagjai, amelyek tartalmazzák az összes méretet, amelyeket az elemzéshez használtak. Ezenkívül az adatplatformnak egyszerű módot kell biztosítania az új mutatók hozzáadására a meglévő mutatók készletéhez. Az általunk létrehozott folyamatok, amelyek nem csupán szoftveres folyamatok, lehetővé kell, hogy tegyék a korábbi időszakok újraszámítását, új méretek hozzáadását és az adatok előrejelzésének módosítását. Ezt úgy valósíthatnánk meg, hogy felhalmozzuk az összes adatot, amelyet a gyártási rendszerünk generál. Ebben az esetben az adatok fokozatosan zavaróvá válnának. Növekvő mennyiségű, fel nem használt adatot kellene tárolnunk és védenünk. Egy ilyen forgatókönyv esetén az adatok idővel egyre irrelevánsabbá válnának, de továbbra is időt igényelnének a kezelésükhöz. Számunkra az adatok felhalmozása nem volt vonzó, ezért úgy döntöttünk, hogy más megközelítést alkalmazunk. A döntésünk az volt, hogy valós idejű adatbázisokat szervezünk a célszemélyek köré, amelyeket osztályozni szeretnénk, és csak azokat az adatokat tároljuk, amelyek lehetővé teszik a legfrissebb és legaktuálisabb időszakok ellenőrzését. Ezeknek az erőfeszítéseknek a bonyolultsága abban rejlik, hogy a rendszerünk heterogén, több adatbázissal és szoftvermodullal rendelkezik, amelyek összhangjának biztosításához gondos tervezés szükséges.
Rendszerünk konstruktív koncepciói
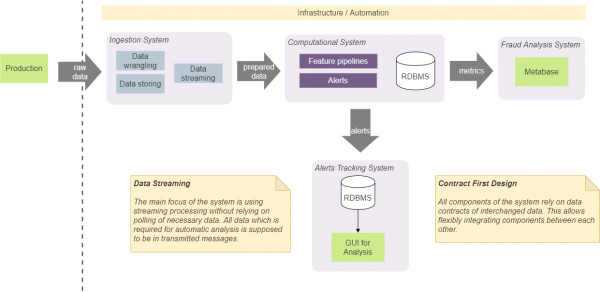
Négy alapvető összetevőnk van a rendszerünkben: bevitel (ingestion system), számítástechnika (computational), elemzés (BI analysis) és nyomonkövetési rendszer (tracking system). Ezek konkrét, izolált célokat szolgálnak, és azokat elkülönítve tartjuk, egy meghatározott fejlesztési megközelítést követve.
Szerződéseken alapuló design
Először is megállapodtunk abban, hogy az összetevőknek kizárólag meghatározott adatszerkezetekre (szerződésekre) kell támaszkodniuk, amelyeket egymás között továbbítanak. Ez lehetővé teszi az egyszerű integrációt közöttük, és nem kényszerít konkrét összetételt (és sorrendet) az összetevők számára. Például bizonyos esetekben közvetlenül integrálhatjuk a riasztásfogadó rendszert a riasztások követésére szolgáló rendszerrel. Ilyen esetben ez a riasztásokkal kapcsolatos megállapodásnak megfelelően fog történni. Ez azt jelenti, hogy mindkét összetevő a szerződés alapján integrálva lesz, amelyet bármely más összetevő is használhat. Nem fogunk hozzáadni további szerződést a riasztások nyomkövető rendszerbe való beillesztésére a bevitt rendszerből. Ez a megközelítés előre meghatározott minimális számú szerződés használatát igényli, és egyszerűsíti a rendszert és a kommunikációt. Lényegében egy "Szerződés Először Tervezés" megközelítést alkalmazunk, és ezt a folyamatban lévő adatokra vonatkozó szerződésekre alkalmazzuk. [2]
Streaming mindenhol
Az állapot megőrzése és kezelése a rendszerben elkerülhetetlenül bonyolultá teszi annak megvalósítását. Általában az állapotnak hozzáférhetőnek kell lennie bármely komponens számára, összhangban kell lennie és a legfrissebb értéket kell biztosítania minden komponens számára, és megbízhatónak kell lennie a helyes értékekkel. Továbbá, a tartós tárolóra tett hívások a legutolsó állapot megszerzésére megnövelik a bemeneti/kimeneti műveletek számát és a bonyolultságot az algoritmusokban, amelyeket a valós idejű csővezetékekben alkalmazunk. Ennek következtében úgy döntöttünk, hogy amennyire csak lehetséges, elhagyjuk az állapot tárolását a rendszerből. Ez a megközelítés megköveteli, hogy minden szükséges adat belekerüljön az átadott adatblokkba (üzenet). Például, ha meg kell számolnunk bizonyos megfigyelések összes számát (műveletek vagy esetek számát meghatározott jellemzőkkel), azt memóriában számoljuk ki, és ilyen értékek áramát generáljuk. A függő modulok a szétválasztást (partition) és a csomagolást (batch) fogják használni az áram szétbontására entitások szerint és az utolsó értékek kezelésére. Ez a megközelítés megszüntette annak szükségességét, hogy állandó lemezes tárolóra legyen szükség ilyen adatokhoz. A rendszerünk a Kafka-t használja, mint üzenetközvetítőt, és ez használható adatbázisként a KSQL segítségével. [3] De annak használata erősen összekapcsolná a megoldásunkat a Kafka-val, és úgy döntöttünk, hogy nem használjuk. Az általunk választott megközelítés lehetővé teszi, hogy a Kafka-t más üzenetközvetítőre cseréljük komoly belső rendszerbeli változtatások nélkül.
Ez a koncepció nem jelenti azt, hogy ne használnánk lemezes tárolókat és adatbázisokat. A rendszer teljesítményének ellenőrzéséhez és elemzéséhez jelentős mennyiségű adatot kell lemezen tárolnunk, amelyek különböző mutatókat és állapotokat képviselnek. Fontos szempont itt az, hogy a valós idejű algoritmusok nem függenek az ilyen adatoktól. A legtöbb esetben a tárolt adatokat autonóm elemzéshez, hibakereséshez és a rendszer által előidézett konkrét esetek és eredmények nyomon követéséhez használjuk.
Rendszerünk problémái
Vannak bizonyos problémák, amelyeket bizonyos szintig megoldottunk, de átgondoltabb megoldásokra van szükség. Jelenleg csak szeretném említeni ezeket itt, mivel mindegyik pont külön cikket érdemel.
- Még mindig meg kell határoznunk azokat a folyamatokat és politikákat, amelyek elősegítik értékes és releváns adatok felhalmozását automatikus elemzésünk, adatfeltárásunk és kutatásunk számára.
- Az emberi élmény elemzési eredményeinek automatizált rendszerfrissítésekbe történő integrálása. Ez nemcsak a modellünk frissítése, hanem a folyamatok frissítése és adataink jobb megértése is.
- Egyensúly megtalálása a determinisztikus IF-ELSE megközelítés és a gépi tanulás között. Valaki azt mondta: „A gépi tanulás a reménytelenek eszköze”. Ez azt jelenti, hogy a gépi tanulást akkor szeretné használni, amikor már nem tudja, hogyan optimalizálja és javítja az algoritmusait. Másrészt a determinisztikus megközelítés nem teszi lehetővé az előre nem látott anomáliák észlelését.
- Egyszerű módra van szükségünk hipotéziseink vagy a metrikák közötti korrelációk ellenőrzésére az adatokban.
- A rendszernek több szinten kell valós pozitív (true positive) eredményeket tartalmaznia. A csalások csak egy része minden olyan esetnek, amely pozitívnak tekinthető a rendszer számára. Például az elemzők minden gyanús esetet szeretnének megkapni ellenőrzésre, és ezek közül csak egy kis rész a csalás. A rendszernek hatékonyan kell biztosítania az összes esetet az elemzők számára, függetlenül attól, hogy az valódi csalás vagy egyszerűen gyanús viselkedés.
- Az adatplatformnak lehetővé kell tennie az adatállományok lekérdezését korábbi időszakokra, valós idejű számításokkal, amelyeket használat során készítettek és számoltak ki.
- Egyszerű és automatizált telepítést kell biztosítani bármely rendszerkomponens számára legalább három különböző környezetben: termelési, kísérleti (béta) és fejlesztői.
- Végül, de nem utolsósorban, szükségünk van egy átfogó teljesítménymérési platform létrehozására, amelyen elemezhetjük modelljeinket. [4]
Hivatkozások
Forrás: habr.com
