

Üdvözöljük.
Úgy döntöttem, hogy megosztom a felfedezésemet — a gondolkozás, kísérletezés és tévedések gyümölcsét.
Igazából: ez egyáltalán nem új felfedezés, természetesen — mindez már régóta ismert kell, hogy legyen azok számára, akik alkalmazott statisztikai adatfeldolgozással és különböző rendszerek optimalizálásával foglalkoznak, nem feltétlenül kifejezetten adatbázisokkal.
És: igen, tudnak róla, érdekes cikkeket írnak a saját kutatásaikról, (UPD.: a kommentekben felhívták a figyelmemet egy nagyon érdekes projektre: )
Másrészről: első pillantásra nem látom, hogy széles körben említést nyernének, elterjednének ezek a megközelítések az interneten, az IT-szakemberek és DBA-k között.
Tehát, térjünk a lényegre.
Tegyük fel, hogy itt van egy feladatunk: beállítani egy szolgáltatási rendszert, amely valamilyen munkafolyamatot támogat.
A munkafolyamatról — tudjuk: milyen az, mivel mérjük a munkának a minőségét és mi a minőség mérésének kritériuma.
Továbbá feltételezhetjük, hogy többé-kevésbé ismert, hogy pontosan hogyan hajtják végre a munkát (vagy ezzel a szolgáltatási rendszerrel).
"Többé-kevésbé" — ezt jelenti, hogy van lehetőség arra, hogy előkészítsünk (vagy valahonnan beszerezzünk) egy eszközt, utilitást, szolgáltatást, amellyel szintetizálhatjuk és a rendszerre egy tesztelt terhelést adhatunk, amely elég közel áll ahhoz, ami a termelésben lesz, megfelelő körülmények között.
Nos, és feltételezhetjük, hogy ismerjük a szolgáltatási rendszer beállító paramétereinek készletét, amelyeken keresztül a rendszer teljesítményét lehet állítani.
És, mi a probléma — nincs elegendő átfogó megértésünk ezzel a szolgáltatási rendszerrel kapcsolatban, amely lehetővé tenné, hogy szakértői szinten beállítsuk ezt a rendszert a jövőbeli terheléshez, és elérjük a szükséges teljesítményt.
Nos, ez szinte mindig így van.
Mit lehet tenni itt.
Az első dolog, ami eszembe jut: nézzük meg a rendszer dokumentációját. Megérteni — mik a megengedett értékhatárok a beállító paraméterekre vonatkozóan. És például a koordinátaelmélet módszerével kiválasztani a paraméterek értékeit a tesztek során.
Vagyis a rendszernek egy konfigurációt kell adni, konkrét beállító paraméterek értékének sorozataként.
Terhelést adni rá, ezzel az eszközzel-utilitással, terhelésgenerátorral.
És figyelni, hogy mekkora a válaszidő, vagy a rendszer működésének minőségét mérő mutató.
A második gondolat az lehet, hogy ez nagyon hosszú idő.
Tehát: ha sok beállítási paraméter van, ha a lehetséges értékkörök szélesek, ha mindegyik külön terhelési teszt sokáig tart, akkor: igen, ez mind elég sok időt vehet igénybe.
Akkor itt arról van szó, amit megérthetünk és felidézhetünk.
Meg lehet határozni a szolgáltatási rendszer beállítási paramétereinek értékkészletében egy vektort, mint bizonyos értékek sorozatát.
Minden egyes ilyen vektornak, más egyenlő feltételek mellett (ha ez a vektor nem érinti), van egy teljesen meghatározott értéke a metrikának — a rendszer teljesítményének mutatójának a teszteléssel kapcsolatos terhelés alatt.
Tehát.
Jelöljük a rendszer konfigurációs vektorát, mint  , ahol
 ; ahol
 — a rendszer konfigurációs paramétereinek száma, mennyi is ezekből a paraméterekből.
A metrikának a fent említett vektorhoz tartozó értékét pedig  jelöljük, mint
 , így megkapjuk a függvényt:

Nos, akkor minden azonnal visszavezethető, az én esetemben: szinte elfeledett egyetemi algoritmusokra az optimumkereséshez.
Jó, de itt felmerül egy szervezési és gyakorlati kérdés: milyen algoritmust használjunk.
- Úgy értem — hogy minél kevesebbet kelljen nekem kódolnom.
- És hogy működjön, azaz találja meg az optimumot (ha van), legalábbis — gyorsabban, mint a koordinátadeszcens.
Az első pont arra utal, hogy érdemes megnézni valamilyen közeg felé, ahol ezek az algoritmusok már megvalósítva vannak, és valamilyen formában készen állnak a használatra a kódban.
Nos, nekem ismertek python és cran-r
A második szempont azt jelenti, hogy érdemes olvasni magukról az algoritmusokról, hogy milyen típusok léteznek, milyen követelményeik vannak, milyen jellemzőik vannak a működés során.
És hogy mit adnak, lehetnek hasznos mellékhatások — eredmények, akár közvetlenül az algoritmusból.
Vagy ezeket az algoritmus működésének végső eredményein is elérhetjük.
Itt sok minden a belépési feltételektől függ.
Például, ha valamilyen okból gyorsabban kell kapni az eredményt, akkor érdemes a gradiens deszcens algoritmusok felé nézni, és kiválasztani egyet közülük.
Vagy ha nem annyira fontos az idő, akkor például alkalmazhatjuk a sztokasztikus optimalizálás módszereit, például a genetikai algoritmust.
Javaslom, hogy vegyük fontolóra egy ilyen módszer működését a rendszer konfigurációjának kiválasztásához, genetikai algoritmus alkalmazásával, a következő, úgy mond, laboratóriumi munkában.
Források:
- Tegyük fel, hogy van, mint szolgáltató rendszer:
oracle xe 18c - Legyen szó arról, hogy ez a tranzakciós aktivitást szolgálja, és a célja: minél nagyobb átviteli kapacitást elérni az adatbázis számára, tranzakciónként másodpercenként.
- A tranzakciók nagyon különbözőek lehetnek, az adatokkal való munkájuk és a munkakörnyezetük szempontjából.
Tegyük úgy, hogy ezek olyan tranzakciók, amelyek nem dolgoznak fel nagy mennyiségű táblázati adatot.
Abban az értelemben, hogy nem generálnak több undo adatot, mint redo, és nem dolgoznak fel nagy százalékát a nagy táblázatok sorainak.
Ezek olyan tranzakciók, amelyek egy sort módosítanak egy nagyobb táblázatban, kevés indexel a táblázat felett.
Ilyen körülmények között a tranzakciók feldolgozásának teljesítménye az adatbázisban a redo adatok feldolgozásának minőségétől függ.
Megjegyzés — ha kifejezetten az adatbázis beállításairól beszélünk.
Mert általánosságban lehetnek például tranzakciós blokkolások az SQL munkamenetek között, a felhasználói táblázatos adatokkal való munkavégzés tervezése és/vagy a táblázatos modell miatt.
Ezek természetesen negatívan hatnak a tps mutatókra, ami egy exogén tényező az adatbázis szempontjából: így tervezték meg a táblázatos modellt és az adatokkal végzett munkát, hogy blokkolások lépnek fel.
Ezért a kísérlet tisztasága érdekében kizárjuk ezt a tényezőt, lentebb pontosítom, hogyan pontosan.
- Tegyük fel, a világosság kedvéért, hogy a 100%-ban a rendszerbe benyújtott SQL parancsok: DML parancsok.
Tegyük fel, hogy a felhasználói munka jellemzői az adatbázisban: azonosak a tesztekben.
Nevezetesen: az SQL munkamenetek száma, a táblázatos adatok, ahogyan a SQL munkamenetekkel dolgoznak. - Az adatbázis az alábbi üzemmódokban működik:
FORCE LOGGING,ARCHIVELOGmódokban. A flashback adatbázis mód ki van kapcsolva, az adatbázis szintjén. - A redo naplók: egy külön fájlrendszerben találhatók, egy külön "lemezen";
Az adatbázis többi fizikai komponense: egy másik, külön fájlrendszerben, egy külön "lemezen":
Részletesebben a laboratóriumi adatbázis fizikai komponensének felépítéséről
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "/db/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Eredetileg az előírt terheléshez tranzakciós adatbázist szerettem volna használni
Van egy csodálatos tulajdonsága, idézem a szerzőt:
A SLOB szívében a SLOB módszer\u0019 áll. A SLOB módszer célja, hogy tesztelje a platformokat
alkalmazáskontroll nélkül. Nem lehet maximális hardver teljesítményt elérni
olyan alkalmazáskód használatával, amely például alkalmazászár megkötésekkel vagy akár
az Oracle Database blokkok megosztásával van korlátozva. Igen, van többlet a megosztáskor
az adatblokkokban! De a SLOB – alapértelmezett telepítésekor – immunis az ilyen összefonódásra.
Ez a nyilatkozat: igaz és az így van.
Kényelmesen beállítható a párhuzamossági fok a SLOB-sessionok között, ez kulcs - folyamatosan „pingelni” (a leállításhoz nyomjuk meg a Ctrl+C kombinációt) az eszköz indításához runit.sh a SLOB becslésén belül
Szabályozza a DML parancsok arányát, abban a mennyiségben, amit a SLOB-sessionok küldenek az adatbázisba, minden egyes SLOB-session esetében, a paraméter UPDATE_PCT
Különösen kényelmes: A SLOB maga, a terhelési session előtt és után – statspaket vagy AWR pillanatképeket készít (amit beállítottak előkészíteni).
Bár kiderült, hogy A SLOB nem támogatja a SLOB-sessionok működését 30 másodpercnél rövidebb időtartamra.
Ezért először kódoltam egy dolgozós változatot a terhelő programból, amely aztán így maradt használatban.
Pontosan tisztázom a terhelő program működését, hogy világos legyen.
Valójában a terhelő program így néz ki:
A worker kódja
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotrace/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
A workereket így indítják:
A workerek indítása
echo "teszt indítása, időtartam: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "várakozás..." >> "$v_logfile"
wait
A munkaterv táblák így készülnek:
Táblák létrehozása
function createtable() {
source "\/home\/oracle\/testingredotracе\/config.conf"
$ORACLE_HOME\/bin\/sqlplus -S system\/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
\/\n
create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
Tehát minden munkához (gyakorlatilag: külön SQL-sesszió a DB-ben) külön táblát hoznak létre, amellyel a munkás dolgozik.
Ez a tranzakciós blokkolások hiányát biztosítja a munkás SQL-sessziói között.
Minden munkás: ugyanazt végzi a saját táblájával, a táblák mind azonosak.
A munkások mind végzik a feladatukat ugyanannyi ideig.
Ráadásul elegendő időtartamú, hogy például pontosan bekövetkezzen, és ne egyszeri log-switching.
Így és ennek megfelelően ezzel összefüggő költségek és hatások keletkeznek.
Az én esetemben – a munkások munkájának időtartamát 8 percre állítottam be.
Egy statspack-jelentés részlete, amely leírja az adatbázis működését terhelés alatt.
Adatbázis    DB azonosító    Példány     Példány száma  Indítási idő   Kiadás     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 2020. szept. 07. 23:12 18.0.0.0.0  NEM

Gazdagép neve             Platform                CPU Magok Foglalatok   Memória (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-bites           2     2       1         15.6

Képkocka       Kép azonosító     Kép idő      Ülések Kérdések/Ülés Megjegyzés
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Kép eleje:       1630 2020. szept. 07. 23:12:27       55        .7
  Kép vége:       1631 2020. szept. 07. 23:20:29       62        .6
   Eltelt idő:       8.03 (perc) Átlagos aktív ülések:       8.4
   DB idő:      67.31 (perc)      DB CPU:      15.01 (perc)

Gyorsítótár méretei            Kezdő        Vége
~~~~~~~~~~~       ---------- ----------
    Puffermemória:     1,392M              Alapértelmezett blokk méret:         8K
     Megosztott tároló:       288M                  Napló pufferméret:   103,424K

Terhelési profil              Másodpercenként    Tranzakciónként    Futtatásonként    Hívásonként
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      DB idő(s):                8.4                0.0        0.00        0.20
       DB CPU(s):                1.9                0.0        0.00        0.04
       Átírás mérete:        7,685,765.6              978.4
   Logikai olvasások:           60,447.0                7.7
   Blokk változások:           47,167.3                6.0
  Fizikai olvasások:                8.3                0.0
 Fizikai írások:              253.4                0.0
      Felhasználói hívások:               42.6                0.0
          Elemzések:               23.2                0.0
     Nehéz elemzések:                1.2                0.0
W/A MB feldolgozva:                1.0                0.0
          Bejelentkezések:                0.5                0.0
        Futtatások:           15,756.5                2.0
       Visszagondolások:                0.0                0.0
    Tranzakciók:            7,855.1
Visszatérve a laboratóriumi munka feladatához.
Az egyéb tényezők mellett az alábbi paraméterek értékeinek változtatása:
- Az adatbázis naplócsoportjainak mérete. Értékek tartománya: [32, 1024] MByte;
- Az adatbázis naplócsoportjainak száma. Értékek tartománya: [2,32];
log_archive_max_processesértékek tartománya: [1,8];commit_loggingkét érték megengedett:batch|immediate;commit_waitkét érték megengedett:wait|nowait;log_bufferértékek tartománya: [2,128] MByte.log_checkpoint_timeoutértékek tartománya: [60,1200] másodpercdb_writer_processesértékek tartománya: [1,4]undo_retentionértékek tartománya: [30;300] másodperctransactions_per_rollback_segmentértékek tartománya: [1,8]disk_asynch_iokét érték megengedett:true|false;filesystemio_optionsaz alábbi értékek megengedettek:none|setall|directIO|asynch;db_block_checkingaz alábbi értékek megengedettek:OFF|LOW|MEDIUM|FULL;db_block_checksumaz alábbi értékek megengedettek:OFF|TYPICAL|FULL;
Aki tapasztalattal rendelkezik az oracle adatbázisok kezelésében, az biztosan most már tudja, hogy mely paramétereket és azok megengedett értékeit kell beállítani az adott adatokkal végzett munka érdekében, hogy a lehető legnagyobb teljesítményt érjük el.
De.
A laboratóriumi munka célja megmutatni, hogy az optimalizáló algoritmus viszonylag gyorsan, önállóan képes ezt megerősíteni.
Csak annyit kell tennünk, hogy belenézzünk a dokumentációba a testreszabott rendszerről, éppen annyira, amennyire szükséges ahhoz, hogy kiderüljön: mely paramétereket és milyen tartományokban kell módosítani.
Valamint: kódot kell írni, amellyel a választott optimalizáló algoritmus testreszabott rendszerével való munka megvalósul.
Tehát most a kódokról beszéljünk.
Fentebb említettem a cran-r, vagyis: minden manipuláció a testreszabott rendszeren — R-skriptek formájában koordinálódik.
Magában a feladatban, az elemzésben, a metrikák, állapotvektorok kiválasztásában: egy csomag van, GA ()
A csomag, ebben az esetben, nem igazán megfelelő, mert az vektorok (kromoszómák, ha a csomag terminológiáját nézzük) megadását várja, valós számokkal.
A vektorom, a beállítási paraméterek értékeiből, 14 db nagyságból áll — egész számok és karakterlánc értékek.
A probléma természetesen könnyen megoldható, ha a karakterlánc értékekhez egyes meghatározott számokat rendelünk.
Tehát, a végén, az R-script legfőbb része így néz ki:
GA::ga hívás
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "GA-session is done" , file=v_logfile, sep="n", append=T)
gam@solution
Itt, a lower és upper attribútumok segítségével a ga alprogram arra szolgál, hogy meghatározza lényegében a keresési tér határait, ahol azokat a vektorokat (vagy vektorokat) fogják keresni, amelyek maximalizálják a fitness-funkció értékét.
A ga-alprogram maximalizálja a fitness-funkciót.
Tehát, lényegében, biztosítani kell, hogy a fitness-funkció, a vektort úgy értelmezve, mint a szubd bizonyos paramétereinek értékkészlete, visszaadja a szubd metrikáját.
Vagyis: mennyi tranzakciót kezel a szubd másodpercenként a megadott szubd beállítással és a szubd terhelésével.
Tehát, ki kell fejteni, hogy a fitness-funkción belül egy ilyen soklépcsenyű folyamatnak kell lezajlania:
- A bemeneti vektor számok feldolgozása — azokat értékekké kell alakítani a szubd paramétereire.
- Megpróbálni létrehozni a megadott számú redo-csoportot, a megadott méretben. A próbálkozás viszont: lehet, hogy nem lesz sikeres.
A már meglévő naplócsoportokat, bizonyos mennyiségben és méretben, a kísérlet tisztasága érdekében el kell távolítani. - A korábbi lépés sikerével: a konfigurációs paraméterek értékeinek beállítása (ismét: lehet hiba).
- A korábbi lépés sikerével: a DBMS leállítása, a DBMS újraindítása, hogy az újonnan megadott paraméterértékek érvénybe lépjenek. (ismét: lehet hiba).
- A korábbi lépés sikerével: végrehajtani a terheléses tesztet. A DBMS-től metrikák gyűjtése.
- A DBMS-t visszaállítani az eredeti állapotába, azaz a kiegészítő naplócsoportok eltávolítása, és az eredeti DBMS konfiguráció helyreállítása.
Fitness funkció kódja
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," try to evaluate vector: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"make_additional_rgroups failed",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Tehát minden munka a fitnesz funkcióban történik.
ga-alprogram, amely a vektorok feldolgozását végzi, vagy inkább helyesebb azt mondani - kromoszómákat.
Amelyben számunkra a legfontosabb: kromoszómák szelektálása olyan génekkel, amelyeknél a fitnesz funkció nagyobb értékeket ad.
Ez lényegében az optimális kromoszómakészlet megtalálásának folyamata egy N-dimenziós keresési térben.
Nagyon világos, részletes , R-kód példákkal, a genetikai algoritmus működéséről.
Külön szeretném megjegyezni két technikai pontot.
Segédhívások, a evaluatefüggvényből, például leállítás-indítás, a db paraméter értékének beállítása, a cran-r függvény system2
Segítségével: egy bash-skripthez vagy parancshoz hívják.
Például:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
A második pont - a sor, evaluate a függvény, a konkrét metrika értékének megőrzésével és a megfelelő beállító vektornak a naplófájlba történő írásával:
cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)Ez fontos, mert ebből az adatmátrixból kiegészítő információt nyerhetünk arról, hogy a beállító vektor mely eleme befolyásolja jobban, vagy kevésbé a metrika értékét.
Tehát: végezhetünk attribútum-kiemelés elemzést.
Nos, mi is születhet belőle.
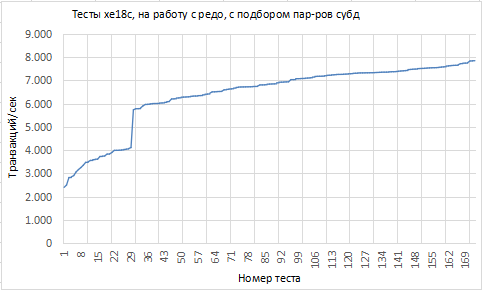
Grafikonban, ha a teszteket a metrika növekvő sorrendjében rendezzük, a kép így néz ki:
Néhány adat, a metrika szélső értékeivel összhangban:
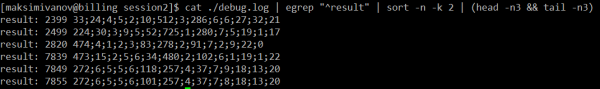
Itt, az eredmények képernyőfelvételén szeretném pontosítani: a beállító vektor értékeit a fitnesz funkció kódjának kifejezései adják, nem az általam fentebb megfogalmazott mutatószám-paraméterek/értékek tartományának listájában.
Nos. Ez sok vagy kevés, ~8 ezer tps: egy külön kérdés.
A laboratóriumi munka keretein belül - ez a szám nem fontos, a dinamika a lényeg, hogy ez az érték hogyan változik.
Itt a dinamika jó.
Nyilvánvaló, hogy legalább egy tényező jelentősen befolyásolja a metrikát, a ga-algoritmus, miközben a vektorok-kromoszómák között válogat.
A dinamikák élénk fejlődéséből ítélve van még legalább egy tényező, amely, bár jelentősen kisebb, de hatással van.
Itt szükség van attribute-importance elemzésre, hogy megértsük: mely attribútumok (ebben az esetben a beállítási vektor komponensei) és mennyire befolyásolják a metrika értékét.
Ehhez az információhoz: megérteni - hogy mely tényezők érintettek a lényeges attribútumok változásaiban.
Végrehajtani attribute-importance különböző módokon lehet.
Számomra ez a célra tetszik a randomForest azonos nevű R csomag (mint ahogy úgy értem, hogy az összesített munkáját és az attribútumok fontosságának értékelésére vonatkozó megközelítését nézve, egy modellt alakít ki a válaszváltozó attribútumaitól függően.)
randomForestAz esetünkben a válaszváltozó a metrika, amelyet az adatbázis kezelő rendszer ad, a terhelési tesztekben:
tps Az attribútumok pedig - a beállítási vektor komponensei.;
értékeli a modell minden attribútumának fontosságát két számmal:
Tehát randomForest %IncMSE — hogy a modellben lévő attribútum jelenléte/teljes hiánya, hogyan befolyásolja a modell MSE-minőségi mutatóját (Mean Squared Error); És az IncNodePurity - egy szám, amely azt mutatja, hogy az adott attribútum értékei alapján mennyire lehet jól megosztani az adatmintát megfigyelésekkel, annak érdekében, hogy az egyik részében olyan adatok legyenek, amelyeknek egy adott magyarázott metrikájuk van, míg a másik részében más metrikával találkozunk.
Tehát: mennyire osztályozó attribútum ez (a random forest kapcsán a legérthetőbb orosz nyelvű magyarázatot hallottam
Munkás-paraszt R kód, a terhelési tesztek eredményeit tartalmazó adatminták feldolgozására: ).
x=NULL v_data_file=paste('tmp/data1.dat',sep="") x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE) colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7)) idxNotTrain=which(! 1:nrow(x) %in% idxTrain ) TrainDS=x[idxTrain,] ValidateDS=x[idxNotTrain,]library(randomForest) #mtry=as.integer( sqrt(dim(x)[2]-1) ) rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F) ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response") sum((ValidateDS$metric-ValidateDS$predicted)^2) rf$importance
Kézzel is be lehet állítani az algoritmus hiperparamétereit, és a modell minőségét figyelembe véve, választhatunk egy pontosabb modellt, amely előrejelzéseket ad a validációs adatmintán.Lehet írni egy funkciót ehhez a munkához (egyébként - szintén valamilyen optimalizáló algoritmus alapján).
Használhatjuk az R csomagot
caret , nem lényeges., nem lényeges.
A végén tehát az eredmény így alakul, a tulajdonságok fontosságának értékeléséhez:
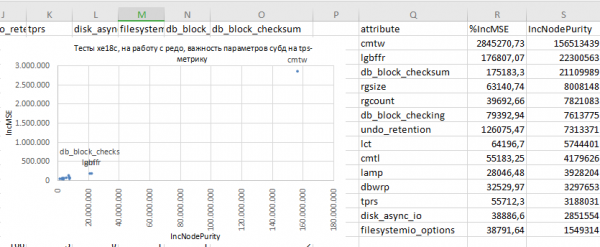
Nos. Így tehát, nekiállhatunk a globális megfontolásoknak:
- Úgy tűnik, hogy a legjelentősebb tényező a tesztelési körülmények között a paraméter lett
commit_wait
Technikailag ez határozza meg az io-műveletek végrehajtásának módját a redo-adatok log-bufferekből a current naplócsoportba: szinkron vagy aszinkron.
Valuenowaitamely esetben gyakorlatilag függőleges, többszörös növekedést eredményez a tps-metrikában: ez az io aszinkron módjának aktiválása a redo-csoportokban.
Egy külön kérdés – szükséges vagy nem szükséges így csinálni a termelési adatbázisban. Itt csak annyira szorítkozom, hogy ez egy jelentős tényező. - Logikus, hogy a log-buffer mérete: jelentős tényezőnek bizonyul.
Minél kisebb a log-buffer mérete, annál kisebb a pufferteljesítménye, annál gyakrabban lépnek fel túlcsordulások és/vagy nem lesz lehetőség szabad területet fenntartani új redo-adatok számára.
Ezért a log-bufferben a hely biztosításával és/vagy a redo-adatok kiürítésével kapcsolatos késlekedések.
Ezek a késlekedések természetesen befolyásolják és be is befolyásolják az adatbázis tranzakciós kapacitását. - A parameter
db_block_checksum: nos, szintén, általában érthető – a tranzakciók feldolgozása dorombblokkot eredményez a log-buffer gyorsítótárában.
Amelyeket, ha aktív a checksum ellenőrzés a data blokkokon, a rendszernek feldolgoznia kell – ki kell számolnia a checksumokat a data blokk tartalmából, és össze kell hasonlítania azokat azzal, ami a data blokk fejlécében van: egyeznek/nem egyeznek.
Ez a munka pedig, ismét, nem tudja nem késleltetni az adatok feldolgozását, és ennek következtében a paraméter és a mechanizmus, ami ezt a paramétert beállítja – jelentősnek bizonyul.
Ezért a gyártó javasolja a dokumentációjában ennek a paraméternek különböző értékeit, és megjegyzi, hogy igen, lesz hatása, de különböző értékek, egészen az 'ki' állapotig, és különböző hatások, választhatóak.
Nos, és a globális megállapítás.
Az általános megközelítés, úgy tűnik, kifejezetten működőképes.
Ez lehetővé teszi, hogy a terhelési tesztelés korai szakaszaiban a rendszer optimális konfigurációjának kiválasztásához anélkül merüljünk el a rendszer terhelés alatti beállításaiba.
De nem zárja ki teljesen — legalábbis a "beállító karok" és a karok forgatási tartományainak megértésének szintjén ismernie kell a rendszert.
A megközelítés viszonylag gyorsan optimalizálhatja a rendszer konfigurációját.
A tesztelés eredményei alapján információt nyerhetünk a rendszer teljesítményének minőségi mutatója és a rendszer beállító paramétereinek értékei közötti összefüggésről.
Ez természetesen hozzájárul a rendszer mélyebb megértésének kialakulásához, legalábbis az adott terhelés mellett.
Gyakorlatilag ez annyit jelent, hogy a költségeket a testreszabott rendszer megértésének költségére és a rendszer működésének tesztelésének költségeire osztjuk.
Különösen fontos megjegyezni, hogy ebben a megközelítésben kritikus a tesztelés adekvát mértékének a valódi üzemeltetési körülményekhez való alkalmazkodása.
Köszönöm a figyelmet és az időt.
Forrás: habr.com
