

A Kubernetes klaszterben futó alkalmazások adatainak tárolását többféleképpen lehet beállítani. Néhány módszer elavult, míg mások nemrégiben jelentek meg. Ebben a cikkben a három tárolócsatlakozási lehetőség koncepcióját vizsgáljuk meg, köztük a legújabbat — a Container Storage Interface-en keresztüli csatlakozást.
1. módszer: PV megadása a pod manifesztjében
Tipikus manifeszt, amely egy podot ír le a Kubernetes klaszterben:
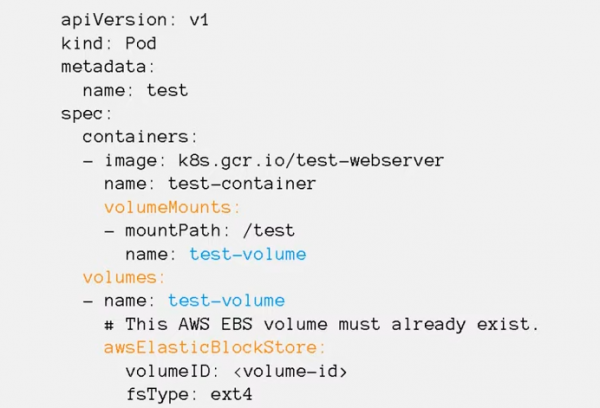
A manifeszt azon részei, ahol meg van határozva, hogy melyik kötet kerül csatlakoztatásra és hová, színkódolva vannak.
A részben volumeMounts megadja a csatlakozási pontokat (mountPath) — hogy melyik könyvtárba kerül a tartós kötet a konténeren belül, valamint a kötet nevét.
A részben x felsorolják az összes kötetet, amelyek a podban használatban vannak. Megadják mindegyik kötet nevét, valamint a típusát (ebben az esetben: awsElasticBlockStore) és a csatlakozási paramétereket. Az, hogy pontosan mely paraméterek kerülnek megadásra a manifesztben, a kötet típusától függ.
Ugyanaz a kötet egyidejűleg több konténerben is csatlakoztatható a podban. Így az alkalmazás különböző folyamatai hozzáférhetnek ugyanazokhoz az adatokhoz.
Ezt a csatlakozási módot a kezdetekkor találták ki, amikor a Kubernetes még kialakulóban volt, és manapság elavultnak számít.
Használatakor több probléma merül fel:
- minden kötetet kézzel kell létrehozni, a Kubernetes nem tud semmit létrehozni helyettünk;
- minden kötet hozzáférési paraméterei egyediek, és ezeket minden pod manifesztjében meg kell adni, amely használja a kötetet;
- ha meg szeretnénk változtatni a tárolórendszert (például, ha át szeretnénk költözni az AWS-ből a Google Cloudra), akkor a csatlakoztatott kötetek beállításait és típusait minden manifesztben meg kell változtatni.
Mindez nagyon kényelmetlen, ezért a gyakorlatban ezt a módszert csak néhány speciális típusú kötet csatlakoztatására használják: configMap, secret, emptyDir, hostPath:
configMap és secret — szolgáltató kötetek, amelyek lehetővé teszik, hogy a Kubernetes manifesztjeiből fájlokkal rendelkező kötetet hozzunk létre a konténerben.
emptyDir — ideiglenes kötet, amely csak a pod élettartama alatt létezik. Kényelmes használni teszteléshez vagy ideiglenes adatok tárolásához. Amikor a pod eltávolításra kerül, az emptyDir típusú kötet is eltávolításra kerül, és minden adat eltűnik.
A hostPath lehetővé teszi, hogy egy alkalmazás konténerébe bármelyik helyi lemezmeghajtó mappát csatlakoztassunk, amelyen az alkalmazás fut, beleértve az /etc/kubernetes-t is. Ez egy nem biztonságos lehetőség, ezért általában a biztonsági politikák megtiltják az ilyen típusú kötetek használatát. Ellenkező esetben a támadó alkalmazás csatlakozhat a saját konténerében található HTC Kubernetes mappához, és ellophatja az összes klasztert. Általában a hostPath kötetek használatát csak olyan rendszerszintű alkalmazások számára engedélyezik, amelyek a kube-system névtérben futnak.
megtalálható a dokumentációban.
2. módszer. Csatlakozás a podokhoz SC/PVC/PV
Egy alternatív csatlakozási mód a Storage class, PersistentVolumeClaim, PersistentVolume koncepció.
Storage class tárolja az adatkezelő rendszerhez való csatlakozási paramétereket.
PersistentVolumeClaim leírja az alkalmazás által igényelt kötet követelményeit.
PersistentVolume tárolja a kötet elérési paramétereit és állapotát.
Az ötlet lényege: a pod manifestben a PersistentVolumeClaim típusú kötetet adjuk meg, és a claimName paraméterben megadjuk e lényeg nevét.
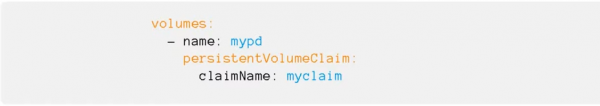
A PersistentVolumeClaim manifestben leírjuk az alkalmazáshoz szükséges adatok kötetének követelményeit, beleértve:
- a lemez mérete;
- a hozzáférési módszer: ReadWriteOnce vagy ReadWriteMany;
- hivatkozás a Storage class-ra — melyik adatkezelő rendszerben szeretnénk létrehozni a kötetet.
A Storage class manifestben tárolódik a tárhelyrendszerhez való csatlakozás típusa és paraméterei. Ezek a kubelet számára szükségesek, hogy csatlakoztassa a kötetet a csomópontjához.
A PersistentVolume manifestekben meg van adva a Storage class és a hozzáférési paraméterek egy adott kötethez (kötet azonosítója, útvonal stb.).
A PVC létrehozásakor a Kubernetes megvizsgálja, hogy mekkora és mely Storage class-ból szükséges kötet, és kiválaszt egy szabad PersistentVolume-t.
Ha ilyen PV-k nincsenek a rendelkezésre álló készleten, a Kubernetes elindíthat egy külön programot — Provisionert (ennek a nevét a Storage class-ban adják meg). Ez a program csatlakozik az adattároló rendszerhez, létrehoz egy szükséges méretű kötetet, megszerzi az azonosítót és létrehozza a Kubernetes klaszterben a PersistentVolume manifestet, amely összekapcsolódik a PersistentVolumeClaim-nel.
Ez a sok absztrakció lehetővé teszi az információk eltávolítását arról, hogy mely adattároló rendszerrel dolgozik az alkalmazás, a megjelenítési szinttől az adminisztrációs szintig.
Minden tárolórendszerhez való csatlakozási paraméter a Storage class-ban található, amelyért a klaszter adminisztrátorai felelnek. Az AWS-ból a Google Cloudba való átállás során mindössze annyit kell tenni, hogy a PVC mappákban megváltoztatjuk a Storage class nevét. A tartós volume-ok a klaszterben automatikusan létrejönnek a Provisioner program segítségével.
3. módszer: Container Storage Interface
Az összes kód, amely különböző tárolórendszerekkel lép interakcióba, a Kubernetes magjának része. A hibajavítások vagy új funkciók kiadása új kiadásokhoz van kötve, így a kódot minden támogatott Kubernetes verzióban módosítani kell. Ez nehezen karbantartható, és új funkciók hozzáadásának is akadályt jelent.
A probléma megoldása érdekében a Cloud Foundry, a Kubernetes, a Mesos és a Docker fejlesztői létrehozták a Container Storage Interface-t (CSI) — egy egyszerű egységesített interfészt, amely leírja a konténerkezelő rendszer és egy adott tárolórendszert kezelő specializált meghajtó (CSI Driver) közötti interakciót. Az összes tárolóval való interakciós kódot a Kubernetes magjából egy külön rendszerbe helyezték át.
.
Általánosságban a CSI Driver két összetevőből áll: Node Plugin és Controller plugin.
A Node Plugin minden csomóponton elindul, és felelős a kötetek csatolásáért és az azokkal végzett műveletekért. A Controller plugin a tárolórendszerrel lép kapcsolatba: köteteket létrehoz vagy töröl, jogosultságokat rendel hozzá stb.
A Kubernetes magjában még mindig maradtak a régi meghajtók, de használatukat már nem javasolják, és mindenki számára ajánlják a CSI Driver telepítését, kifejezetten azzal a rendszerrel, amellyel dolgozni kell.
Az újítás megijesztheti azokat, akik már megszokták, hogy a Storage class-on keresztül állítják be az adatokat, de valójában semmi ijesztő nem történt. A programozók számára biztosan semmi nem változik — ahogy eddig is csak a Storage class nevével dolgoztak, úgy folytatják tovább. Az adminisztrátorok számára pedig egy helm chart telepítése került bevezetésre, és megváltozott a beállítások struktúrája. Korábban a beállításokat közvetlenül a Storage class-ban adták meg, most viszont először a helm chart-ban kell megadni, majd pedig a Storage class-nál. Ha jobban megértjük, valójában semmi ijesztő nem történt.
Nézzük meg például, milyen előnyöket lehet szerezni a Ceph tárolórendszer CSI meghajtón keresztüli csatlakoztatásával.
A Ceph használata során a CSI plugin több lehetőséget biztosít a tárolórendszerekkel való munkára, mint a beépített meghajtók.
- Dinamikus lemezkészítés. A RBD disks are usually used only in RWO mode, while CSI for Ceph allows them to be used in RWX mode. Multiple pods on different nodes can mount the same RBD disk to their nodes and work with them in parallel. To be fair, it’s not all sunshine — this disk can only be connected as a block device, meaning you’ll need to adapt the application to work with it in multi-access mode.
- Snapshot creation. In a Kubernetes cluster, you can create a manifest requesting a snapshot. The CSI plugin will see it and take a snapshot of the disk. Based on this, a backup or a copy of the PersistentVolume can be made.
- Increasing the size of the disk on the storage system and PersistentVolume in the Kubernetes cluster.
- Quotas. Built-in Kubernetes CephFS drivers do not support quotas, while fresh CSI plugins with fresh Ceph Nautilus can enable quotas on CephFS partitions.
- Metrics. The CSI plugin can provide many metrics to Prometheus about which volumes are connected, what interactions are happening, etc.
- Topology aware. Allows specifying in manifests how geographically distributed the cluster is, avoiding connections to pods in London with storage systems located in Amsterdam.
To connect Ceph to the Kubernetes cluster via CSI, see . You can also subscribe to , which will start on October 15.
Author of the article: Sergey Bondarev, practicing architect at Southbridge, Certified Kubernetes Administrator, one of the developers of kubespray.
A little post scriptum not for advertising, but for the sake of usefulness...
P.S. Sergey Bondarev is conducting two intensive courses: the updated September 28-30, and the advanced október 14-16.
Forrás: habr.com
