

Üdv mindenkinek. Ez a cikk azoknak készült, akik még mindig a virtualizációs platformok választása között tétovázik, és a „Feltettük a Proxmoxot, és minden tökéletes, 6 év üzemidő egyetlen megszakítás nélkül” című cikk elolvasása után vannak. De miután telepítették az egyik vagy másik dobozos megoldást, felmerül a kérdés, hogyan lehetne itt valamennyit finomítani, hogy a monitorozás érthetőbb legyen, és itt, hogy a biztonsági mentéseket lehessen ellenőrizni... Aztán eljön az idő, amikor rájön, hogy valami funkcionálisabbra vágyik, vagy szeretné, ha a rendszerén belül minden világos lenne, és ne az a fekete doboz, vagy valami többet akar használni, mint a hypervisor és a virtuális gépek sokasága. A cikkben néhány gondolat és gyakorlat következik az OpenNebula platform alapján – ezt választottam, mert nem igényel sok erőforrást és az architektúrája nem olyan bonyolult.
Tehát, ahogy látjuk, sok felhőszolgáltató KVM-en dolgozik, és külső keretrendszert hoznak létre a gépek kezelésére. Nyilvánvaló, hogy a nagyobb hoszting szolgáltatók saját keretrendszereiket írják a felhőinfrastruktúrához, például a YANDEX. Valaki OpenStacket használ, és erre alapozva készít keretrendszert - SELECTEL, MAIL.RU. De ha saját hardvered van és egy kis csapatod, általában a kész megoldások közül választanak - VMWARE, HYPER-V, vannak ingyenes és fizetős licencváltozatok, de most nem erről van szó. Beszéljünk azokról az érdeklődőkről, akik nem félnek újat kínálni és kipróbálni, annak ellenére, hogy a cég világosan jelezte: „Ki fogja ezt majd karbantartani utánad?”, „Ezt mi később termelni fogjuk? Félelmetes.” De hiszen kezdetben ezeket a megoldásokat tesztkörnyezetben lehetne alkalmazni, és ha mindenkinek tetszik, akkor fel lehet vetni a további fejlesztés és komolyabb környezetekben való használat kérdését.
Itt egy link az előadásra az aktív résztvevőtől, aki ennek a platformnak a fejlesztésében vesz részt.
Előfordulhat, hogy ebben a cikkben van néhány felesleges információ, ami egy tapasztalt szakember számára már egyértelmű, és bizonyos esetekben nem fogok mindent részletezni, mivel hasonló parancsok és leírások elérhetők az interneten. Csak a saját tapasztalataimat osztom meg ezzel a platformmal kapcsolatban. Remélem, hogy az aktív résztvevők kiegészítik a megjegyzésekben, hogy miben lehetne javítani és hogy milyen hibákat követtem el. Mindezt három, különböző jellemzőkkel bíró PC-ből álló otthoni tesztkörnyezetben hajtottam végre. Ezenkívül szándékosan nem írtam le, hogyan működik ez a szoftver vagy hogyan kell telepíteni. Csak az adminisztrációs tapasztalataimat és a felmerült problémákat osztom meg. Talán valakinek hasznos lesz a választásában.
Nos, kezdjük. Rendszergazdaként számomra a következő pontok fontosak, amelyek nélkül valószínűleg nem fogom használni ezt a megoldást.
1. Telepítési ismételhetőség
Rengeteg útmutató található az opennebula telepítéséről, itt nem kellene problémának lennie. Verzióról verzióra új funkciók jelennek meg, amelyek nem mindig működnek megfelelően a verzióváltás során.
2. Monitorozás
Monitorozni fogjuk magát a csomópontot, a kvm-et és az opennebula-t. Szerencsére már van kész megoldás. A linux hosztok monitorozására rengeteg lehetőség létezik, például a Zabbix vagy a Node Exporter – mindenkinek a saját ízlése szerint. Jelenleg úgy definiálom, hogy a rendszer metrikák monitorozása (hőmérséklet, ahol az mérhető, a lemezmeghajtó tömb konzisztenciája) Zabbix-n keresztül, míg az alkalmazások monitorozását exporter-en keresztül Prometheus-ra bízzuk. Például KVM monitorozására használhatjuk a és a rendszerindítást systemd-n keresztül állítjuk be, jól működik és megjeleníti a KVM metrikákat, továbbá van kész irányítópult is, .
Például, itt van az én fájlom:
/etc/systemd/system/libvirtd_exporter.service
[Unit]
Description=Node Exporter

[Service]
User=node_exporter
ExecStart=/usr/sbin/prometheus-libvirt-exporter --web.listen-address=":9101"

[Install]
WantedBy=multi-user.target
Tehát van egy exporterünk, szükség van egy másikra az opennebula monitorozásához, ezt használtam:
Hozzáadhatjuk a szokásos rendszer monitorozáshoz az alábbiakat.
A node_exporter fájlban a szolgáltatást így módosítjuk:
ExecStart=/usr/sbin/node_exporter --web.listen-address=":9102" --collector.textfile.directory=/var/lib/opennebula_exporter/textfile_collectorKönyvtár létrehozása: mkdir -p /var/lib/opennebula_exporter
A fenti bash scriptet először a konzolon ellenőrizzük, ha az megjeleníti a szükséges információkat (ha hibát ad, telepítjük az xmlstarlet-t), másoljuk át a /usr/local/bin/opennebula_exporter.sh fájlba.
Hozzáadunk egy cron feladatot minden egyes percre:
*\/1 * * * * (\/usr\/local\/bin\/opennebula_exporter.sh > \/var\/lib\/opennebula_exporter\/textfile_collector\/opennebula.prom)A metrikák kezdenek megjelenni, ezeket Prometheusszal lehet lekérni, grafikonokat készíteni és riasztásokat beállítani. A Grafanában például készíthetünk egy ilyen egyszerű irányítópultot.
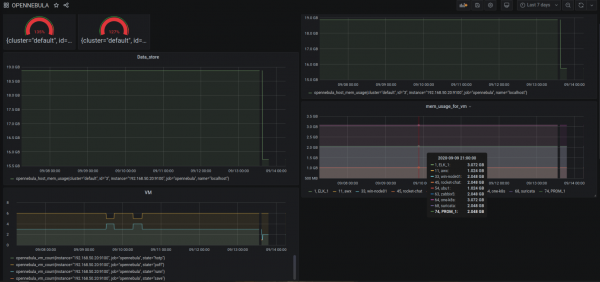
(látni, hogy itt overcommit cpu-t, ram-ot csináltam)
Aki szereti és használja a Zabbixot, annak van
Monitoringból ennyi, a fő, hogy van. Persze a beépített virtuális gépeket figyelő eszközöket is használva is lehet adatokat kinyerni a billinghez, itt mindenkinek megvan a maga elképzelése, eddig nem foglalkoztam ezzel mélyebben.
A naplózáshoz még nem kezdtem el igazán. A legegyszerűbb megoldás az lenne, ha a td-agentet hozzáadnánk a \/var\/lib\/one könyvtár parserezéséhez reguláris kifejezésekkel. Például a sunstone.log fájl a regexp nginx-nek megfelelő, és más fájlok, amelyek a platformmal való interakciók történetét mutatják – mi ennek az előnye? Például egyértelműen nyomon követhetjük a „Hiba, hiba” számát és gyorsabban meghatározhatjuk, hol és milyen szinten van a hiba.
3. Biztonsági mentések
Van néhány fizetős, továbbfejlesztett projekt is – például a sep :OpenNebula_Backup. Itt meg kell értenünk, hogy csak a gép képének biztonsági mentése ebben az esetben nem elegendő, hiszen a virtuális gépeinknek teljes integrációval kell működniük (ugyanaz a kontextusfájl, amelyben a hálózati beállítások, a vm neve és az alkalmazásainkra vonatkozó egyéni beállítások szerepelnek). Ezért meg kell határoznunk, hogy mit és hogyan fogunk biztonsági menteni. Bizonyos esetekben jobb a vm-en belül található dolgok másolása. És lehet, hogy csak egy lemezt kell biztonsági másolatot készíteni a gépről.
Például úgy döntöttünk, hogy minden gép állandó képekkel indul, tehát elolvasva
először a vm-ből leválaszthatjuk a képet:
onevm disk-saveas 74 3 prom.qcow2
Image ID: 77

Nézzük meg, milyen néven mentettük el

oneimage show 77
\/var\/lib\/one\/\/datastores\/100\/f9503161fe180658125a9b32433bf6e8

És másoljuk a szükséges helyre. Persze, nem a legjobb mód. Csak azt akartam megmutatni, hogy az opennebula eszközeivel hasonló megoldásokat építhetünk.
A hálózatban találtam és van még , de itt csak qcow2 tárolásra.
De ahogy mindannyian tudjuk, eljön az a pillanat, amikor szükség van az inkrementális biztonsági mentésekre. Ez összetettebb, és lehet, hogy a vezetőség pénzt különít el egy fizetős megoldásra, vagy másik irányt választunk, és megértjük, hogy itt csak az erőforrásokat pazaroljuk, a biztonsági mentéseket az alkalmazások szintjén kell végezni, új csomópontok és virtuális gépek hozzáadásával. Igen, itt azt mondom, hogy az felhőt tisztán az alkalmazás klaszterek indítására használjuk, míg az adatbázisokat egy másik platformon futtatjuk, vagy kész megoldást veszünk be a szolgáltatótól, ha van ilyen lehetőség.
4. Használhatóság
Ebben a pontban azokat a problémákat írom le, amelyekkel én találkoztam. Például a képek esetében, ahogy tudjuk, van persistent — amikor ezt a képet egy VM-hez csatoljuk, minden adat ebbe a képbe kerül. Ha non-persistent, akkor a kép másolódik a tárolóra, és az adatok abba íródnak, ami a forrástól másolt kép. Így működnek a sablonok előkészítése. Többször okoztam magamnak problémákat azzal, hogy elfelejtettem megadni a persistent opciót, és a 200 GB-os kép másolódott. A probléma az, hogy ezt a folyamatot valószínűleg érvényteleníteni nem lehet, el kell menned a csomóponthoz, és le kell állítanod a jelenlegi 'cp' folyamatot.
Egy fontos hátrány — ezeket a műveleteket nem lehet visszavonni egyszerűen a GUI használatával. Vagyis visszavonod őket, és látod, hogy semmi nem történik, majd újra elindítod, visszavonod, és a valóságban már két 'cp' folyamat lesz, amely másolja a képet.
Itt jön az a megértés, hogy miért számolja az opennebula minden új példányt új azonosítón. Például a proxmoxban létrehozol egy VM-et 101-es ID-vel, eltávolítod, majd újra létrehozod és az ID 101 marad. Az opennebula esetében ez nem fog megtörténni, minden új példány új azonosítóval jön létre, és ennek megvan a maga logikája - például a régi adatok vagy a sikertelen telepítések törlése.
Ugyanez vonatkozik a tárolóra, ez a platform leginkább a központosított tárolókra összpontosít. Vannak kiegészítők a helyi használatra, de ebben az esetben nem erről van szó. Szóval gondolom, hogy a jövőben valaki írni fog egy cikket arról, hogyan sikerült helyi tárolót használni a csomópontokban és azt sikeresen használni a termelésben.
5. Maximális egyszerűség
Természetesen itt, minél tovább mész, annál kevesebben lesznek, akik megértenek téged.
A tesztkörnyezetemben — 3 node NFS tárolóval — minden rendben működik. De ha kísérleteket végzünk az áramkiméréssel, például egy pillanatkép indításakor és a node áramtalanításakor, a beállításaink megmaradnak az adatbázisban, hogy van pillanatkép, viszont valójában nincs (mivel mindannyian tudjuk, hogy eredetileg beírtuk a SQL adatbázisba ezt a műveletet, de maga a művelet nem sikerült). Plusz abban az, hogy a pillanatkép létrehozásakor egy külön fájl keletkezik és van „szülő”, így problémák esetén, és még ha az GUI-n keresztül nem működik is, el tudjuk vinni a qcow2 fájlt és külön helyreállíthatjuk.
Sajnos a hálózatokkal nem minden olyan egyszerű. Legalábbis egyszerűbb, mint az OpenStack, csak VLAN-t (802.1Q) használtam — működik, de ha a template hálózatban módosításokat eszközölsz, a beállítások nem fognak érvényesülni a már működő gépeken, tehát törölni és újra hozzá kell adni a hálózati kártyát, így az új beállítások érvényesítésre kerülnek.
Ha össze szeretnénk hasonlítani az OpenStack-tel, akkor elmondhatjuk, hogy az OpenNebulában nincs egyértelmű meghatározás, hogy milyen technológiákat használjunk az adatok tárolására, a hálózat kezelésére és az erőforrások kezelésére — minden adminisztrátor maga dönt, hogy számára mi a kényelmesebb.
6. Kiegészítő pluginok és telepítések
Mint tudjuk, a felhőplatform nemcsak KVM-et, hanem VMware ESXi-t is kezelhet. Sajnos nekem nem volt VCenter poolom, ha valaki próbálta, írjon.
Egyéb felhőszolgáltatók támogatásában ezt nyilatkozták
AWS, AZURE.
A Selectel VMware Cloud beépítését is próbáltam, de nem sikerült — összességében nem foglalkoztam vele, mert sok tényező van, és nincs értelme írni a host szolgáltató technikai támogatásának.
Jelenleg az új verzióban van Firecracker — ez microVM-ek indítása, egy fajta KVM-burkolás a Dockeren, ami még nagyobb univerzális használatot, biztonságot és teljesítménynövelést biztosít, mivel nem kell erőforrást pazarolni a hardveremulációra. Csak előnyöket látok a Dockerhez képest abban, hogy nem használ fel további folyamatokat és nem foglal el aljzatokat ennek az emulációnak a használatakor, tehát nyugodtan használható terheléselosztóként (de erről talán érdemes lenne külön cikket írni, amíg teljes mértékben nem végeztem el az összes tesztet).
7. Pozitív tapasztalatok és hibák debugolása
Szerettem volna megosztani a tapasztalataimat a munkával kapcsolatban, részben írtam fent, szeretnék még többet írni. Valójában valószínűleg nem vagyok egyedül azzal a gondolattal, hogy először úgy érzem, hogy ez nem az a rendszer, és hogy minden nagyon ügyetlen — hogy is lehet ezzel dolgozni? De aztán jön a megértés, hogy minden teljesen logikus. Természetesen nem lehet mindenkinek kedvezni, és néhány dolog finomításra szorul.
Például egy egyszerű művelet, a lemezkép átmásolása egy adat tárolóból a másikba. Az én esetemben két nfs node van, képet küldök — a másolás az opennebula frontendjén történik, bár mindannyian hozzászoktunk ahhoz, hogy az adatoknak közvetlenül a hosztok között kellene átmásolódniuk — ugyanúgy, mint a vmware-ben vagy hyper-v-ben, de itt máshogy működik. Itt más megközelítés és más ideológia van, és az 5.12-es verzióban eltávolították a "migrate to datastore" gombot — csak magát a gépet lehet átkonfigurálni, de nem a tárolót, mivel központosított tárolásra van szükség.
Ezután egy népszerű hiba, különféle okokkal: "Error deploying virtual machine: Could not create domain from /var/lib/one//datastores/103/10/deployment.5". Lent lesz egy lista arról, hogy mit érdemes megnézni.
- Jogosultságok a képre oneadmin felhasználónak;
- Jogosultságok oneadmin számára a libvirtd elindításához;
- Jól van-e csatolva az adat tároló? Menj és ellenőrizd az utat a noden, lehet, hogy valami eltört;
- Hibásan konfigurált hálózat, jobban mondva a frontend beállításainál a network beállításoknál, hogy a vlan alapértelmezett interfészeként br0 van beállítva, míg a node-on bridge0 van megadva — egységesnek kell lennie.
A system datastore tárolja a metainformációkat a vm-hez, ha persistent image-szal indítod a vm-t, akkor a vm-nek hozzáféréssel kell rendelkeznie ahhoz a konfigurációhoz, amelyet azon a tárolón hoztál létre, ahol a vm-t létrehoztad — ez nagyon fontos. Ezért, amikor a vm-et egy másik adat tárolóra helyezed, mindent újra kell ellenőrizni.
8. Dokumentáció, közösség. További fejlődés
És más dolog, jó dokumentáció, közösség és fontos, hogy a projekt a jövőben is folytatódjon.
Itt összességében minden jól van dokumentálva, és még hivatalos forrás alapján is könnyen telepítheted és megtalálhatod a válaszokat a kérdésekre.
Aktív közösség. Sok kész megoldást publikálnak, amelyeket felhasználhatsz a saját telepítéseidhez.
Jelenleg az 5.12-es verzióval változtak a vállalat egyes politikái Érdekes lesz megtudni, hogyan fejlődik a projekt. Kezdetben szándékosan megemlítettem néhány szolgáltatót, akik a saját megoldásaikat és az ipar kínálatát használják. Nincs egyértelmű válasz arra, hogy mit használjon, ez természetesen így van. De kis szervezetek számára a saját kis privát felhő támogatása nem kerül annyiba, mint amennyire az tűnik. A legfontosabb, hogy pontosan tudja, hogy erre szüksége van.
Összességében, függetlenül attól, hogy mit választott mint felhőalapú rendszert, nem érdemes egyetlen termékre támaszkodni. Ha van időd, érdemes megnézni más, nyitottabb megoldásokat is.
Van egy jó kis chat. aktívan segítenek, és nem azt mondják, hogy keresd meg a megoldást a Google-ben. Csatlakozz.
Forrás: habr.com
