

Ma nincs semmiféle bonyolult eset vagy bonyolult SQL algoritmus. Minden nagyon egyszerű lesz, a Nyilvánvaló Kapitány szintjén — csináljuk. eseménynapló megtekintése idő szerinti rendezés szerint.
Tehát itt van egy táblázat az adatbázisban, events, és van egy mezője, ts — pontosan az az idő, amely alapján ezeket a bejegyzéseket rendezetten szeretnénk megjeleníteni:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Evidens, hogy ott nem tíz bejegyzésünk lesz, ezért valamilyen formában szükség lesz oldalankénti navigációra..
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
Majdhogynem nem vicc — ritkán, de előfordul a vadonban. Néha, miután ORM-mel dolgoztunk, nehéz visszaállni a "közvetlen" SQL munkára.
De nézzük meg a gyakrabban előforduló és kevésbé nyilvánvaló problémákat.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - bejegyzés egy oldalon, $1 - az oldal eleje
Honnan jött ez a 26-os szám? Ez körülbelül annyi bejegyzés, amennyi egy képernyőt kitölt. Pontosabban 25 megjelenített bejegyzés, plusz 1, ami jelzi, hogy a választékban van még valami és érdemes tovább lépni.
Természetesen ezt az értéket nem szükséges "beleégetni" a lekérdezésbe, hanem átadhatjuk paraméterként. De ebben az esetben a PostgreSQL tervezője nem tud támaszkodni arra a tudásra, hogy a bejegyzések száma viszonylag alacsony lesz, — és könnyen választ egy hatástalan tervet.
És amíg az alkalmazás felületén az eseménynapló megtekintését vizuális "oldalak" közötti váltásként valósítják meg, senki sem észlel semmi gyanúsat. Pontosan addig, amíg a UI/X felhasználás kényelme érdekében nem döntenek úgy, hogy a felületet "végtelen scroll" -ra alakítják át — vagyis az összes bejegyzés a naplóban egyetlen listában jelenik meg, amit a felhasználó felfelé és lefelé görgethet.
Így a következő teszteléskor rajtakapnak a bejegyzések megduplázódásán a naplóban. Miért, hiszen a táblán van egy normális index, (ts), amelyre a lekérdezésed támaszkodik?
Pontosan ezért, mert nem vetted figyelembe, hogy ts nem egy egyedi kulcs ebben a táblázatban. Valójában, és értékei sem egyediek., mint a „valós idejű” bármely „idő” esetében — ezért ugyanaz a rekord könnyen „áthidalható” az oldalak között a kulcs értékeinek azonos sorrendje miatt.
Valójában itt egy második probléma is rejtőzik, amit sokkal nehezebb észlelni — egyik vagy másik rekord nem jelenik meg egyáltalán! Mivel a „duplikált” rekordok elfoglalták valaki helyét. Részletes magyarázat szép ábrákkal .
Index bővítése
A ravasz fejlesztő ismeri, hogy a kulcsot egyedivé kell tenni, a legegyszerűbb mód pedig, ha egy egyedileg választott mezőt használunk, amely kitűnően megfelel a PK-nak:
CREATE UNIQUE INDEX ON events(ts DESC, id DESC);A lekérdezés átalakul:
SELECT
  ...
ORDER BY
  ts DESC, id DESC
LIMIT 26 OFFSET $1;
#2. Переход на «курсоры»
Néhány idő múlva megérkezik az DBA, és „örömmel” közli, hogy a lekérdezéseid , és egyáltalán itt az ideje, hogy áttérjünk a legutoljára megjelenített érték alapján történő navigációra. A lekérdezésed újra átalakul:
SELECT
  ...
WHERE
  (ts, id) < ($1, $2) -- az előző lépésben kapott legutolsó értékek
ORDER BY
  ts DESC, id DESC
LIMIT 26;
Megkönnyebbülten fellélegeztél, amíg be nem következett…
#3. Чистка индексов
Mert egyszer csak az DBA-od olvasott egy és rájött, hogy a „nem legutolsó” timestamp nem helyénvaló. És újra hozzád jött — most azzal a gondolattal, hogy az a bizonyos indexnek mégiscsak vissza kellene térnie (ts DESC).
De akkor mi a teendő az eredeti „ugráló” rekord-problémával?.. Nos, az egyszerű — olyan blokkokat kell választani, amelyek nincsenek rögzítve a rekordok számában!
Valójában ki tilthatja meg nekünk, hogy ne „pontosan 26”-ot, hanem „legalább 26”-ot olvassunk? Például úgy, hogy a következő blokkba kerüljön rekordok, amelyek nyilvánvalóan más értékekkel rendelkeznek ts — akkor nem lesz probléma az „ugráló” rekordokkal sem a blokkok között!
Itt van, hogyan lehet ezt elérni:
SELECT
  ...
WHERE
  ts = coalesce((
    SELECT
      ts
    FROM
      events
    WHERE
      ts < $1
    ORDER BY
      ts DESC
    LIMIT 1 OFFSET 25
  ), '-infinity')
ORDER BY
  ts DESC;
Mi történik itt egyáltalán?
- Lépjünk 25 rekordot „le” és kapunk egy „határértéket”
ts. - Ha ott már nincs semmi, akkor a NULL-értéket cseréljük
-infinity-ra. - A kapott érték és az interfészből átadott $1 paraméter (megelőző „utolsó” megjelenített érték) közötti értékek teljes szegmenseit kivonjuk.
tsés az interfészből átadott paraméter $1 (az előző "utolsó" kirajzolt érték). - Ha a blokk kevesebb mint 26 bejegyzést tartalmazott, akkor az az utolsó.
Vagy ugyanez képben:
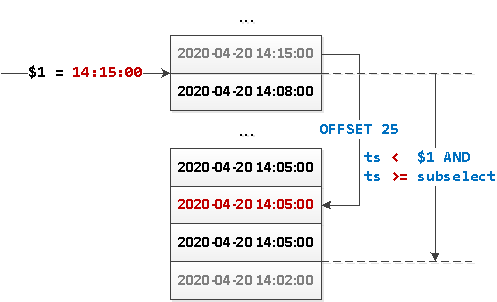
Mivel mostantól a mintavételnek nincs meghatározott "kezdet", semmi nem akadályozza meg, hogy "visszafelé" bővítsük ezt a lekérdezést, és dinamikusan betöltsük az adatblokkokat az "alappontról" mindkét irányba – lefelé és felfelé.
Megjegyzés
- Igen, ilyen esetben kétszer hívjuk meg az indexet, de minden "tiszta index szerint". Ezért a beágyazott lekérdezés csak egy további Index Only Scan-hoz vezet..
- Nyilvánvaló, hogy ezt a módszert csak akkor lehet használni, ha az értékek
tsvéletlenszerűen kereszteződnek, és kevés van belőlük.. Ha azonban a tipikus eseted a "millió bejegyzés 00:00:00.000" formátumban, akkor ezt nem érdemes csinálni. Úgy értem, nem érdemes ilyen eseteket engedni. De ha mégis így alakult, használj kiterjesztett indexet.
Forrás: habr.com
