

A tartalom alapú adatklasszifikáció nyílt feladat. A hagyományos adatvesztés-megelőző rendszerek (DLP) ezt a problémát úgy oldják meg, hogy lenyomatokat készítenek a megfelelő adatokról és figyelik a végpontokat a lenyomatok gyűjtésére. Figyelembe véve a Facebook folyamatosan változó adatforrásainak nagy mennyiségét, ez a megközelítés nemcsak hogy nem skálázható, de hatástalan is az adatok lokációjának meghatározásában. Ez a cikk egy átfogó rendszerre összpontosít, amely a Facebookon érzékeny szemantikai típusok automatikus felfedezésére, adatkezelésére és hozzáférés-ellenőrzésére lett kifejlesztve.
A cikkben bemutatott megközelítés a mi első átfogó adatvédelmi rendszerünk, amely megpróbálja megoldani ezt a problémát az adatjelek, gépi tanulás és hagyományos lenyomatos módszerek integrálásával az összes Facebook-on található adat megjelenítésére és klasszifikálására. A bemutatott rendszer gyártási környezetben működik, elérve a 0,9+ F2 pontszámot a különböző adatvédelmi osztályokban, miközben nagy mennyiségű adatforrást kezel több tucat tárolóban. Bemutatjuk a Facebook ArXiv-on megjelent átfogó adatklasszifikációs rendszer fordítását, amely a gépi tanulásra épít a biztonság és adatvédelem érdekében.
Bevezetés
A mai vállalatok óriási mennyiségű adatot gyűjtenek és tárolnak különböző formátumokban és helyeken [1], ezeket az adatokat gyakran több helyen használják fel, néha többször is lemásolják vagy gyorsítótárazák, ami miatt értékes és bizalmas üzleti információk szétszóródnak a vállalat különböző adattárolóiban. Amikor egy szervezettől megkövetelik jogi vagy szabályozási kötelezettségek teljesítését, például a polgári eljárás során a jogszabályoknak való megfelelést, szükségessé válik az adatok helyének azonosítása. Ha a titoktartási határozat előírja, hogy a szervezetnek el kell takarnia az összes társadalombiztosítási számot (SSN), amikor személyes információt továbbítanak illetéktelen feleknek, az első lépés természetesen az, hogy a vállalat összes adattárolójában megtaláljuk az összes SSN-t. Ilyen körülmények között az adatklasszifikáció kritikus fontosságúvá válik [1]. Az osztályozási rendszer lehetővé teszi a szervezetek számára, hogy automatikusan biztosítsák a titoktartási és biztonsági irányelvek betartását, például a hozzáféréskezelési politika bevezetését és az adatok megőrzését. A Facebook egy olyan rendszert mutat be, amelyet mi építettünk a Facebookon, és amely számos adatjelzést, skálázható rendszermodelleket és gépi tanulást használ az érzékeny szemantikai adatfajták észlelésére.
Az adatok észlelése és osztályozása az, amikor adatokat keresünk és címkézünk úgy, hogy ha szükséges, gyorsan és hatékonyan lehessen kivonni a vonatkozó információkat. A jelenlegi folyamat inkább kézi jellegű, és abból áll, hogy megismerjük a vonatkozó törvényeket vagy szabályozásokat, meghatározzuk, hogy mely információkat kell érzékenynek tekinteni, és mik a különböző érzékenységi szintek, majd ennek megfelelően felépítjük az osztályokat és a klasszifikációs politikát [1]. Az adatvesztés elleni védelem (DLP) rendszere eltávolítja az adatlenyomatokat, és nyomon követi az adatvégpontokat az utóbbiak meghatározására. Egy olyan tárolónál, amely hatalmas mennyiségű vagyonnal és petabájt adatával rendelkezik, ez a megközelítés egyszerűen nem skálázható.
Célunk, hogy olyan adatklasszifikációs rendszert építsünk, amely skálázható mind a tartós, mind az átmeneti felhasználói adatok számára, anélkül, hogy bármilyen további korlátozást alkalmaznánk az adatok típusára vagy formátumára. Ez egy merész cél, és természetesen nehézségekkel jár. Bármely adatbejegyzés akár ezer karakter hosszú is lehet.
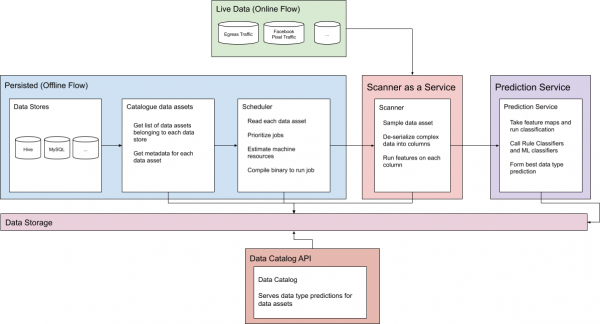
1. ábra. Online és offline előrejelzési áramlatok
Ezért hatékonyan kell reprezentálnunk, közös jellemzők használatával, amelyeket később összekapcsolhatunk és könnyen átmozgathatunk. Ezeknek a jellemzőknek nemcsak pontos klasszifikálást kell biztosítaniuk, hanem flexibilitást és bővíthetőséget is, hogy a jövőben új adatfajták könnyen hozzáadhatók és felfedezhetők legyenek. Másodszor, foglalkozni kell nagyméretű autonóm táblákkal. A tartós adatok akár sok petabájtos táblákban is tárolhatók. Ez csökkentheti a beolvasási sebességet. Harmadszor, szigorú SLA klaszterelést kell tartanunk az átmeneti adatokra vonatkozóan. Ez a rendszert magas hatékonyságúnak, gyorsnak és pontosnak kell lennie. Végül alacsony késleltetésű adatok klaszterelését kell biztosítanunk az átmeneti adatok számára, hogy valós idejű klaszterelést végezhessünk, valamint internetes felhasználásokhoz.
Ez a cikk azt írja le, hogyan kezeltük a fent említett problémákat, és bemutat egy gyors és skálázható klasszifikáló rendszert, amely az adatbázisok minden típusát, formátumát és forrását klasztereli egy közös jellemzőkészlet alapján. Kiterjesztettük a rendszerek architektúráját, és létrehoztunk egy külön alkalmazást gépi tanulásra az offline és online adatok gyors klaszterelésére. Ez a cikk az alábbiak szerint van felépítve: a 2. fejezetben a rendszer általános tervezését mutatjuk be. A 3. fejezet a gépi tanulás rendszerei részleteit tárgyalja. A 4. és 5. fejezet a kapcsolódó munkákat részletezi és a jövőbeli irányokat foglalja össze.
Architektúra
A tartós és online adatok Facebook-szintű kihívásainak kezelésére a klasszifikáló rendszer két különálló áramlatot használ, amelyeket részletesen megvitatunk.
Tartós adatok
A rendszernek először is tudomást kell szereznie a Facebook számos információs eszközéről. Minden adattárolónak összegyűjtik a szükséges alapinformációkat, például azokat a adatközpontokat, ahol ezek az adatok találhatók, a rendszert, amely ezeket az adatokat kezeli, és az eszközöket, amelyek egy adott adattárolón helyezkednek el. Ez képezi a metaadatok katalogizálását, amely lehetővé teszi a rendszer számára, hogy hatékonyan vonja le az adatokat anélkül, hogy leterhelné az ügyfeleket és a más mérnökök által használt erőforrásokat.
Ez a metaadatok katalógusa megbízható forrást biztosít az összes beolvasott eszköz számára, és lehetővé teszi a különböző eszközök állapotának nyomon követését. Ezen információk alapján prioritási sorrendet határoznak meg a gyűjtött adatok és a rendszer belső információi, például az eszköz utolsó sikeres beolvasásának ideje és létrehozásának időpontja, valamint a korábbi memóriára és processzorra vonatkozó követelmények, ha az eszköz korábban be lett olvasva. Ezután minden egyes adatforráshoz (ahogy az erőforrások elérhetővé válnak) meghívják a tényleges adatforrás beolvasási feladatát.
Minden egyes feladat egy lefordított bináris fájl, amely Bernoulli-választást végez a legfrissebb adatok alapján, amelyek az egyes eszközökhöz elérhetők. Az eszköz különálló oszlopokra van bontva, ahol minden oszlop osztályozási eredménye függetlenül kerül feldolgozásra. Ezen kívül a rendszer beolvassa a mezőkben található bármilyen sűrített adatot is. JSON, tömbök, kódolt struktúrák, URL-címek, base 64 kódolt adatok és sok más — mindez beolvasható. Ez jelentősen megnövelheti a beolvasási időt, mivel egy tábla több ezer beágyazott oszlopot tartalmazhat egy nagy bináris objektumban. json.
Minden egyes sor esetében, amely az adatforrásban van kiválasztva, a besorolási rendszer a tartalomból kiemeli a lebegő és szöveges objektumokat, és minden objektumot visszakapcsol az oszlophoz, ahonnan származik. Az objektumok kinyerési fázisának eredménye egy térkép az összes objektumról, amelyet a beolvasott adatforrás oszlopában találtak.
Miért fontosak a jellemzők?
A jellemzők fogalma kulcsfontosságú tényező. A float és text jellemzők helyett nyers string mintákat adhatunk át, amelyek közvetlenül minden adatforrásból származnak. Továbbá, a gépi tanulási modellek közvetlenül minden mintán képesek tanulni, nem pedig száz számítási jellemzőn, amelyek csak próbálnak közelíteni a mintákhoz. Ennek több oka van:
- A magánélet mindenekelőtt: a legfontosabb, hogy a jellemzők fogalma lehetővé teszi számunkra, hogy csak azokat a mintákat tartsuk a memóriában, amelyeket kinyerünk. Ez garantálja, hogy a mintákat kizárólag egyetlen célra tároljuk, és soha nem naplózzuk őket a saját erőfeszítéseinkkel. Ez különösen fontos a változó adatok esetében, mivel a szolgáltatásnak fenntartania kell valamiféle osztályozási állapotot, mielőtt előrejelzést kínálna.
- Memória: néhány minta hosszúsága több ezer karakter lehet. Az ilyen adatok tárolása és a rendszeren belüli átadása anélkül, hogy szükség lenne rá, sok további bájtot fogyaszt. Két tényező összeadódhat az idő múlásával, tekintettel arra, hogy sok adatforrás létezik, több ezer oszloppal.
- A jellemzők aggregálása: a jellemzők által a gyűjteményük révén egyértelműen megjelennek minden egyes szkennelés eredményei, ami lehetővé teszi a rendszer számára, hogy egy kényelmes módon összevonja az ugyanazon adatforrás korábbi szkennelési eredményeit. Ez hasznos lehet az adatforrás egyes szkennelési eredményeinek aggregálására több futtatás során.
Ezután a jellemzők a prognózis szolgáltatásba kerülnek, ahol szabályalapú osztályozást és gépi tanulást használunk az egyes oszlopok adatcímkéinek előrejelzésére. A szolgáltatás mind a szabályosztályozókra, mind a gépi tanulásra támaszkodik, és kiválasztja a legjobb előrejelzést az egyes előrejelzési objektumokból.
A szabályosztályozók manuális heurisztikákat alkalmaznak, számításokat és arányokat használnak az objektum normalizálására 0 és 100 között. Amint egy ilyen kezdeti pontszámot generálunk minden adattípushoz és a kapcsolódó oszlop neveihez, amely nem esik a 'prohibíciós listák' alá, a szabályosztályozó a legmagasabb normalizált pontszámot választja az összes adattípus közül.
A klasszifikáció összetettsége miatt a kizárólag manuális heurisztika alkalmazása alacsony klasszifikálási pontossághoz vezet, különösen a struktúrázatlan adatok esetében. Emiatt fejlesztettünk ki egy gépi tanulási rendszert, amely a struktúrázatlan adatok, például felhasználói tartalmak és címek klasszifikálására összpontosít. A gépi tanulás lehetővé tette, hogy eltávolodjunk a manuális heurisztikától, és további adatforrásokat alkalmazzunk (például oszlopnevek, adatok származása), amely jelentősen növeli a felfedezés pontosságát. Később részletesebben is foglalkozunk a gépi tanulási architektúránkkal.
A prognosztikai szolgáltatás minden oszlop eredményeit tárolja az azokhoz kapcsolódó metainformációkkal, beleértve a szkennelés időpontját és állapotát. Bármely felhasználó és alacsonyabb szintű folyamat, amelyek ezekre az adatokra támaszkodnak, ezekből az adatokat napi rendszerességgel közzétett adathalmaszból olvashatják. Ez az összességében tartalmazza az összes szkennelési feladat eredményeit, illetve az adatközpont valós idejű API-ját. A közzétett előrejelzések képezik az automatikus adatvédelmi és biztonsági politika alkalmazásának alapját.
Végül, miután a prognosztikai szolgáltatás rögzíti az összes adatot és megőrzi az összes előrejelzést, az adatközpont API-ja képes visszaadni az erőforrás típusaihoz minden előrejelzést valós időben. A rendszer naponta közzétesz egy adathalmaszt, amely tartalmazza az összes legfrissebb előrejelzést minden eszközre vonatkozóan.
Változékony adatok
Bár a fent leírt folyamat a tartós eszközökre vonatkozik, a nem állandó forgalom szintén az szervezet adatai közé tartozik, és fontos lehet. Emiatt a rendszer valós idejű klaszterezési előrejelzés-generáló online API-t biztosít bármilyen instabil forgalom számára. A valós idejű előrejelző rendszer széleskörűen alkalmazzák a kimenő forgalom, a bejövő forgalom gépi tanulási modellekbe történő osztályozásában és a hirdetők adataiban.
Itt az API két fő argumentumot fogad: a csoportosító kulcsot és a feldolgozatlan adatokat, amelyeket előre kell jelezni. A szolgáltatás elvégzi azt az objektumkiemelést, amelyet fentebb ismertettünk, és csoportosítja az objektumokat azonos kulcs alapján. Ezek a jellemzők szintén támogatottak a tárolt cache-ben a hibaelhárítás után történő helyreállításhoz. Minden csoportosító kulcs esetében a szolgáltatás garantálja, hogy a predikciós szolgáltatás meghívása előtt elegendő mintát látott az előbb ismertetett folyamat szerint.
Optimalizálás
Néhány tároló beolvasásához olvasási optimalizáló könyvtárakat és módszereket használunk a forró tárolóból [2], és garantáljuk, hogy nincsenek zavarok más felhasználók által, akik hozzáférnek ugyanahhoz a tárolóhoz.
Rendkívül nagy táblák (50+ petabájt) esetén, a legjobb optimalizációk és memoriahatékonyság ellenére a rendszer a teljes memória kimerülése előtt dolgozik a beolvasáson és a számításon. Végül a beolvasás teljes mértékben számít a memóriában, és nem kerül mentésre a beolvasás során. Ha a nagy táblák több ezer oszlopot tartalmaznak strukturálatlan adatcsomókkal, a feladat memóriaforrások hiánya miatt meghiúsulhat a teljes táblázat előrejelzésekor. Ez a lefedettség csökkenéséhez vezet. Ennek kezelésére a rendszert úgy optimalizáltuk, hogy a beolvasási sebességet mint közvetítőt használjuk az aktuális terhelés kezelésének mértékére. A sebességet előrejelzési mechanizmusként használjuk, hogy lássuk a memória problémákat, és anticipációs számításokat végezzünk az objektumtérképen. Ezzel kevesebb adatot használunk, mint általában.
Adatjelek
A klasszifikáló rendszer annyira jó, amennyire az adatok jelei. Itt áttekintjük azokat a jeleket, amelyeket a klasszifikáló rendszer használ.
- A tartalom alapján: természetesen az első és legfontosabb jel a tartalom. Bernoulli mintavétel történik minden adatforráson, amelyet átvizsgálunk, és jellemzőket vonunk ki az adatokból. Számos jellemző a tartalomból származik. Bármilyen számú lebegő objektum képviselheti azt a számításokat, hogy hányszor észleltek egy adott típusú mintát. Például lehetnek a mintában észlelt elektronikus levelek számának jelei, vagy jelek arra, hány emojit észleltek a mintában. Ezeket a jellemzőszámításokat normalizálni és aggregálni lehet a különböző átvizsgálások során.
- Az adatok származása: fontos jel, amely segíthet, amikor a tartalom megváltozott a szülőtáblában. A leggyakoribb példa a hashelt adatok. Amikor az adatok a gyermek táblában hashelődnek, gyakran az szülőtáblából származnak, ahol nyíltan megmaradnak. A származási adatok segítenek azonosítani a bizonyos típusú adatokat, amikor azok nem olvashatók világosan, vagy a táblából felfelé kerültek átkonvertálásra.
- Annotációk: egy másik magas szintű jel, amely segít az struktúráltalan adatok azonosításában. Valójában az annotációk és a származási adatok kombinálhatóak az adatok különböző eszközök közötti attribútumainak terjesztésére. Az annotációk segítenek azonosítani a struktúráltalan adatok forrását, míg a származási adatok segíthetnek nyomon követni ezen adatok áramlását a tárolón.
- Adatbefecskendezés egy olyan módszer, amikor szándékosan ismeretlen, olvashatatlan karaktereket juttatnak be ismert forrásokba, ismert típusú adatokkal. Ezután, amikor a tartalmat ugyanazzal az olvashatatlan karakterlánccal átvizsgáljuk, arra lehet következtetni, hogy a tartalom ebből a jól ismert adatforrásból származik. Ez egy másik minőségi adatjel, hasonló az annotációkhoz. Kivéve, hogy a tartalom alapú észlelés segít felfedezni a bevezetett adatokat.
Metodikák mérése
Fontos elem a pontos mérési módszertan. Az iterációs osztályozás fejlesztésének fő metrikái a címkék pontossága és visszahívása, ahol az F2 értékelés a legfontosabb.
Ezeknek a mutatóknak a kiszámításához független adatjelölési módszertan szükséges, amely nem függ magától a rendszertől, de közvetlenül összehasonlítható vele. Lent leírjuk, hogyan gyűjtjük össze a Facebookról származó alapvető igazságot, és hogyan használjuk azt a klasszifikáló rendszerünk tanítására.
Megbízható adatok gyűjtése
Mi minden egyes forrástól, amely lent található, saját táblázatában gyűjtjük a megbízható adatokat. Minden táblázat felelős a legutóbb megfigyelt értékek aggregálásáért az adott forrásból. Minden forrás rendelkezik adatminőségi ellenőrzéssel, hogy garantálja, hogy az egyes forráshoz tartozó megfigyelt értékek kiváló minőségűek és a legfrissebb típusú adatok címkéit tartalmazzák.
- A naplózási platform konfigurációi: a táblázatok bizonyos mezői olyan adatokkal vannak kitöltve, amelyek egy bizonyos típushoz kapcsolódnak. Ezeknek az adatoknak a használata és terjesztése megbízható forrást jelent a megbízható adatok számára.
- Kézi címkézés: a rendszert támogató fejlesztők, valamint külső címkézők képzettek arra, hogy címkézzék a oszlopokat. Ez általában jól működik az adatbázisban található minden típusú adatnál, és egyes strukturálatlan adatok, például üzenetadatok vagy felhasználói tartalom esetén az alapvető megbízhatóság forrása lehet.
- A szülőtáblák oszlopai megjelölhetők vagy annotálhatók mint az adott adatok tartalmazói, és nyomon követhetjük ezeket az adatokat az alsóbb táblákban.
- Futtatási folyamok mintavételezése: a Facebook futtatási folyamatai adott típusú adatokat hordoznak. A szolgáltatásarchitektúraként működő szkennerünkkel mintázhatjuk az ismert adattípusokat tartalmazó folyamatokat, és továbbadhatjuk őket a rendszeren. A rendszer megígéri, hogy nem tárolja ezeket az adatokat.
- Mintavételi táblázatok: a nagy táblák, amelyekről tudjuk, hogy az összes adatot tartalmazzák, szintén felhasználhatók tanító adatokként, és a szkenneren keresztül szolgáltatásként továbbíthatók. Ez kiválóan alkalmas olyan táblák esetében, amelyek teljes tartományú adatokkal rendelkeznek, így az oszlop véletlenszerű mintavételezése egyenértékű az adott adattípus teljes halmazának mintavételezésével.
- Szinonim adatok: még könyvtárakat is használhatunk, amelyek folyamatban generálnak adatokat. Ez jól működik egyszerű, nyilvános adatokhoz, mint például cím vagy GPS.
- Adatfelügyelők: a magánéletet védő programok jellemzően adatfelügyelőket használnak a politikák manuális hozzárendelésére az adatok egyes részeihez. Ez egy nagyon pontos forrása a hitelességnek.
Minden fő hitelesítési forrást egy testbe integrálunk ezekkel az adatokkal. A hitelességgel kapcsolatban a legnagyobb probléma annak biztosítása, hogy az reprezentatív legyen az adathalmozó számára. Ellenkező esetben a klaszterező motorok túlképzettek lehetnek. A fent említett forrásokat azért használják fel, hogy egyensúlyt biztosítsanak a modellek tanítása vagy a metrikák kiszámítása során. Ezenkívül az emberek címkézők egyenletesen válogatnak különböző oszlopokat az adathalmozóban, és megfelelően címkézik az adatokat, hogy a hiteles értékek gyűjtése pártatlan maradjon.
Folyamatos integráció
A gyors iteráció és javítás biztosítása érdekében fontos, hogy mindig valós időben mérjük a rendszer teljesítményét. Minden javítást a mai rendszerhez viszonyítva mérhetünk, így taktikai szempontból irányíthatjuk az adatokat a további fejlesztésekhez. Itt megnézzük, hogyan zárja le a rendszer a visszacsatolási ciklust, amelyet hiteles adatok biztosítanak.
Amikor a tervező rendszer olyan eszközzel találkozik, amelyet egy hiteles forrás címkézett, két feladatot tervezünk. Az első a gyártási szkennerünket használja, ezzel a gyártási lehetőségeinket. A második feladat a legfrissebb jellemzőkkel rendelkező legutolsó összesítőt használja. Minden feladat a saját táblájába írja az eredményeit, megjelölve az verziókat és a klasszifikációs eredményeket.
Így valós időben hasonlítjuk össze a jelölt kiadás és a termelési modell klasszifikálási eredményeit.
Amíg az adathalmazok összehasonlítják az RC és PROD jellemzőket, számos változatot loggol a prediktív szolgáltatás ML klasszifikáló motorjából. A legfrissebb eltárolt gépi tanulási modell, az aktuális gyártásban lévő modell és bármely kísérleti modell. Ugyanez a megközelítés lehetővé teszi számunkra, hogy "daraboljuk" a különböző modellváltozatokat (a szabályaink agnosztikus klasszifikátorait), és valós időben összecombináljuk a metrikákat. Így könnyen meghatározható, mikor érett a ML kísérlet a gyártásba való bevezetésre.
Minden éjjel az adott napra kiszámított RC-jellemzők elküldésre kerülnek az ML oktatási csővezetékbe, ahol a modell a legújabb RC-jellemzők alapján tanul, és értékeli teljesítményét egy megbízható adathalmazon.
Minden reggel a modell befejezi az oktatást, és automatikusan publikálva lesz kísérletiként. Automatikusan bekerül a kísérleti listába.
Néhány eredmény
Több mint 100 különböző adattípus van címkézve magas pontossággal. A jól strukturált típusok, mint az e-mailek és telefonszámok, 0,95-ös f2 értékkel vannak klasszifikálva. A szabad típusú adatok, mint a felhasználói tartalom és a név, szintén nagyon jól teljesítenek, 0,85 feletti f2 pontszámokkal.
Naponta számos különálló oszlopot klasszifikálunk állandó és változó adatokkal minden tárolóban. Naponta több mint 500 terabájtot vizsgálunk át több mint 10 adatbázisban. E tárolók többségének lefedettsége meghaladja a 98%-ot.
Idővel a klasszifikáció nagyon hatékonnyá vált, mivel az autonóm áramlásban tárolt klasszifikáló feladatok átlagosan 35 másodpercet vesznek igénybe az aktíva beolvasásától a minden oszlopra vonatkozó előrejelzések kiszámításáig.
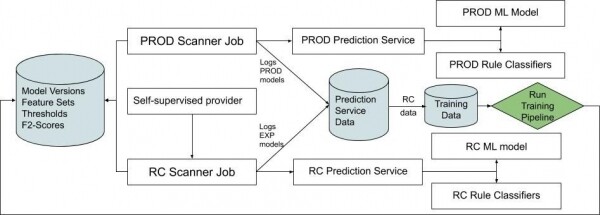
Ábra 2. A folytonos integrációs áramlás leírására szolgáló diagram, hogy megértsük, hogyan generálódnak az RC-objektumok és hogyan küldik el őket a modellnek.
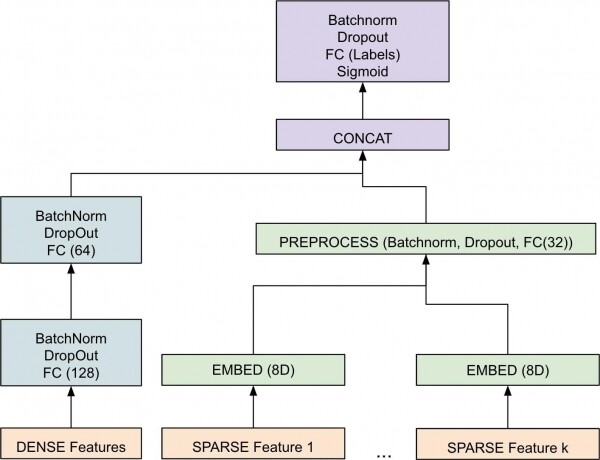
Ábra 3. Magas szintű diagram a gépi tanulási komponensről.
A gépi tanulási rendszer komponense
A korábbi részben mélyrehatóan foglalkoztunk az egész rendszer architektúrájával, kiemelve a méretet, az optimalizálást és az adatok áramlását autonóm és online üzemmódban. Ebben a részben megvizsgáljuk a prediktív szolgáltatást és leírjuk az ML rendszert, amely biztosítja a prediktív szolgáltatás működését.
Több mint 100 adattípussal és néhány struktúrázatlan tartalommal, mint például üzenetadatok és felhasználói tartalom, a kizárólag kézi heurisztika alkalmazása alulparaméterezett osztályozási pontosághoz vezet, különösen a struktúrázatlan adatok esetében. Emiatt gépi tanulási rendszert is kifejlesztettünk a struktúrázatlan adatok bonyolultságainak kezelésére. A gépi tanulás alkalmazása lehetővé teszi, hogy elkezdjünk eltávolodni a kézi heurisztikától, és a jellemzőkkel és a további adatszegmensekkel (például az oszlopnevekkel és az adatok származásával) dolgozzunk a pontosság növelése érdekében.
A megvalósított modell külön-külön tanulmányozza a sűrű és ritka objektumok vektorképviseleteit. Ezeket ezután összekapcsolják, hogy egy vektort alkossanak, amely egy sor batch normalizálási és nemlineáris lépésen keresztül halad az végső eredmény elérése érdekében. A végső eredmény egy lebegőpontos szám [0-1] intervallumban minden címkéhez, amely a valószínűséget jelzi, hogy a példa adott érzékenységi típushoz tartozik. A PyTorch használata a modell számára lehetővé tette, hogy gyorsabban haladjunk, és a csapaton kívüli fejlesztők is gyorsan módosíthattak és tesztelhettek változtatásokat.
Az architektúra tervezésekor fontos volt a ritka (például szöveges) és sűrű (például numerikus) objektumok külön modelljezésére, az azok közötti belső különbség miatt. A végső architektúra esetében szintén fontos volt a paraméterek kiértékelése az optimális tanulási sebesség, a batch méret és más hiperparaméterek megtalálása érdekében. Az optimalizáló kiválasztása szintén fontos hiperparaméter volt. Megállapítottuk, hogy a népszerű optimalizáló Adamgyakran túltanuláshoz vezet, míg a SGD-vel ellátott modell stabilabb. Voltak további árnyalatok, amelyeket közvetlenül a modellbe kellett integrálnunk. Például statikus szabályok, amelyek garantálták, hogy a modell determinisztikus előrejelzést készít, amikor a jellemző egy adott értéket ölt. Ezeket a statikus szabályokat ügyfeleink határozták meg. Felfedeztük, hogy ezek közvetlen modellbe való beemelése egy önállóbb és megbízhatóbb architektúra létrehozásához vezetett, szemben a posztfeldolgozási lépés végrehajtásával, amely ezeknek a speciális határok eseteknek a kezelésére irányult. Ezenkívül vegye figyelembe, hogy az edzés során ezeket a szabályokat kikapcsoltuk, hogy ne zavarják a gradiens csökkenés edzési folyamatát.
Problems
Az egyik probléma a magas minőségű, megbízható adatok összegyűjtése volt. A modellnek pontosnak kell lennie minden osztály számára, hogy meg tudja tanulni az összefüggéseket az objektumok és a címkék között. Az előző részben az adatgyűjtési módszereket tárgyaltuk, mind a rendszer mérésére, mind a modellek tanulmányozására. Az elemzés azt mutatta, hogy olyan adatcsoportok, mint a hitelkártyák és bankszámlaszámok nem nagyon elterjedtek az adattárunkban. Ez megnehezíti a megbízható adatok nagy mennyiségű összegyűjtését a modellek tanulásához. Ennek a problémának a megoldására szintetikus megbízható adatokat generáló folyamatokat dolgoztunk ki ezekhez a csoportokhoz. Ezeket érzékeny típusokhoz generáljuk, beleértve SSN, hitelkártya számok és IBAN-számokat, amelyek előrejelzését a modell korábban nem tudta elvégezni. Ez a megközelítés lehetővé teszi, hogy érzékeny típusú adatokat dolgozzunk fel anélkül, hogy a valós érzékeny adatokkal kapcsolatos biztonsági kockázatot jelentenénk.
A megbízható adatokkal kapcsolatos problémákon kívül nyitott architekturális problémákon is dolgozunk, mint például a változások elszigetelése és korai leállítás. A változások elszigetelése fontos, hogy különböző változtatások esetén a hálózat különböző részeiben a hatás a konkrét osztályoktól függetlenül izolált legyen, és ne gyakoroljon széleskörű hatást az előrejelzés összteljesítményére. A korai leállítás kritériumának javítása szintén alapvető fontosságú ahhoz, hogy stabil ponton tudjuk leállítani az edzési folyamatot minden osztály számára, és ne abban a pillanatban, amikor egyes osztályok túltanulják, míg mások nem.
A jellemző fontossága
Amikor új jellemzőt vezetünk be a modellbe, szeretnénk tudni, hogy annak mekkora az általános hatása a modellre. Azt is szeretnénk biztosítani, hogy a jóslatok érthetők legyenek az emberek számára, így pontosan megérthetjük, hogy mely jellemzők kerülnek használatra az egyes adat típusoknál. Ennek érdekében kidolgoztuk és bevezettük osztály szerinti a jellemzők fontosságát a PyTorch modellhez. Fontos megjegyezni, hogy ez eltér az általános jellemző fontosságától, amely általában támogatva van, mivel nem mondja meg, hogy mely jellemzők fontosak egy adott osztály számára. Az objektum fontosságát a jóslat hibájának növekedésével mérjük az objektum értékeinek keverése után. A jellemző "fontos", ha az értékek keverése növeli a modell hibáját, mivel ebben az esetben a modell a jellemzőre támaszkodott a jóslás során. A jellemző "nem fontos", ha annak értékeinek keverése nem változtatja meg a modell hibáját, amikor ebben az esetben a modell figyelmen kívül hagyta azt [5].
A jellemző fontossága minden osztály számára lehetővé teszi a modell értelmezhetőségét, így láthatjuk, mire figyel a modell a címkék előrejelzésekor. Például, amikor elemezzük ADDR, biztosítjuk, hogy a címhez kapcsolódó jellemző, mint például AddressLinesCount, magas helyet foglaljon el a jellemzők fontossági táblázatában minden osztály számára, hogy emberi intuícióink jól egybeesjenek azzal, amit a modell tanult.
Értékelés
Fontos meghatározni egy egységes sikermérőt. Mi az F2 — egyensúly a visszahívás és a pontosság között (a visszahívás kissé nagyobb eltolódása). A visszahívás fontosabb a bizalmasság használati esetéhez, mint a pontosság, mivel a csapat számára rendkívül fontos, hogy ne hagyjon ki semmilyen bizalmas adatot (miközben ésszerű pontosságot biztosít). A modellünk teljesítményértékelésének tényleges adatai meghaladják a jelen cikk kereteit. Ennek ellenére alapos finomítás mellett elérhetünk magas (0,9+) F2 pontszámot a legfontosabb érzékeny osztályok számára.
Kapcsolódó munka
Számos algoritmus létezik a struktúrázatlan dokumentumok automatikus osztályozására különböző módszerek alkalmazásával, mint például mintázatillesztés, dokumentumok hasonlóságának keresése és különböző gépi tanulási módszerek (bayes-iek, döntési fák, k-legközelebbi szomszédok és sok más) [6]. Ezek bármelyike használható az osztályozás részeként. A probléma azonban a skálázhatóság. A cikkben szereplő osztályozási megközelítés a rugalmasság és a teljesítmény irányába terelődik. Ez lehetővé teszi számunkra, hogy a jövőben új osztályokat támogassunk, és alacsony késleltetést biztosítsunk.
Számos munka létezik az adatok ujjlenyomatának levételére is. Például a szerzők [7] olyan megoldást írtak le, amely a titkos adatok kiszivárgásának problémájára összpontosít. A fő előfeltevés az adatok ujjlenyomatának lehetősége, hogy azt egy ismert titkos adatcsoportra illeszthessük. A szerzők [8] egy hasonló problémát írnak le a magánélet kiszivárgásával kapcsolatban, de az ő megoldásuk egy konkrét Android-architektúrára épül, és csak akkor osztályozható, ha a felhasználó tevékenysége személyes adatok küldéséhez vezetett, vagy ha az alap alkalmazás adatokat szivárogtatott. A helyzet itt valamivel eltérő, mivel a felhasználói adatok is erősen struktúrázatlanok lehetnek. Ezért bonyolultabb technikára van szükség, mint az ujjlenyomat levétele.
Végül, hogy kezeljük az adatok hiányát egyes típusú titkos adatok esetében, szintetikus adatokat vezettünk be. Nagy mennyiségű irodalom létezik az adatok augmentálásáról, például a szerzők [9] a zaj injekciójának szerepét vizsgálták a tanulás során, és pozitív eredményeket figyeltek meg a felügyelt tanulásban. A mi megközelítésünk a magánéletvédelem szempontjából eltérő, mivel a zajos adatok bevezetése kontraproduktív lehet, így a magas minőségű szintetikus adatokra összpontosítunk.
Zárás
Ebben a cikkben bemutattuk azt a rendszert, amely az adatfragmentumok osztályozására képes. Ez lehetővé teszi számunkra a magánélet védelmét és a biztonsági politikák betartásának biztosítását. Megmutattuk, hogy a skálázható infrastruktúra, a folyamatos integráció, a gépi tanulás és a magas minőségű, megbízható adatok kulcsszerepet játszanak számos magánélet védelmét célzó kezdeményezésünk sikerében.
Számos irányba mutat a jövőbeli munka. Ez magában foglalhatja a nem strukturált adatok (fájlok) támogatásának biztosítását, nemcsak az adatok típusának, hanem az érzékenységi szintjük osztályozását, valamint az önellenőrző tanulás alkalmazását közvetlenül a tanulás során, pontos szintetikus példák generálásával. Ezek a példák segíthetnek csökkenteni a modell veszteségeit a legnagyobb mértékben. A jövőbeli munka a nyomozási munkafolyamatra is összpontosíthat, ahol túllépünk a felfedezésen és a különböző magánélet-lejárásokról szóló ok-okozati elemzést nyújtunk. Ez segíthet olyan esetekben, mint az érzékenységi elemzés (pl. az adatok érzékenysége magas (például a felhasználó IP-címe) vagy alacsony (például a Facebook belső IP-címe)).
Bibliográfia
- David Ben-David, Tamar Domany és Abigail Tarem. Vállalati adatklasszifikáció szemantikus webtechnológiák alkalmazásával. Peter F. Patel-Schneider, Yue Pan, Pascal Hitzler, Peter Mika, Lei Zhang, Jeff Z. Pan, Ian Horrocks és Birte Glimm, szerkesztők, A Szemantikus Web – ISWC 2010, 66–81. oldal, Berlin, Heidelberg, 2010. Springer Berlin Heidelberg.
- Subramanian Muralidhar, Wyatt Lloyd, Sabyasachi Roy, Cory Hill, Ernest Lin, Weiwen Liu, Satadru Pan, Shiva Shankar, Viswanath Sivakumar, Linpeng Tang és Sanjeev Kumar. f4: A Facebook meleg BLOB tárolási rendszere. In 11. USENIX Szimpózium az Operációs Rendszerek Tervezéséről és Megvalósításáról (OSDI 14), 383–398. oldal, Broomfield, CO, 2014. október. USENIX Egyesület.
- Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg S Corrado és Jeff Dean. Szavak és kifejezések elosztott reprezentációi és azok kompozicionalitása. C. J. C. Burges, L. Bottou, M. Welling, Z. Ghahramani és K. Q. Weinberger, szerkesztők, A Neurális Információfeldolgozási Rendszerek 26. előrelépései, 3111–3119. oldal. Curran Associates, Inc., 2013.
- Sergey Ioffe és Christian Szegedy. Csoportos normalizálás: a mélyhálózati képzés felgyorsítása a belső variábilis eltolódás csökkentésével. Francis Bach és David Blei, szerkesztők, A 32. Nemzetközi Gépi Tanulási Konferencia anyagai, 37. kötetében A Gépi Tanulás Kutatásának Anyagai, 448–456. oldal, Lille, Franciaország, 2015. július 7–9. PMLR.
- Leo Breiman. Véletlen erdők. Mach. Learn., 45(1):5–32, 2001. október.
- Thair Nu Phyu. A klasszifikálási technikák felmérése az adatok bányászatában.
- X. Shu, D. Yao és E. Bertino. Érzékeny adatok kiszivárgásának védett észlelése. IEEE Transactions on Information Forensics and Security, 10(5):1092–1103, 2015.
- Zhemin Yang, Min Yang, Yuan Zhang, Guofei Gu, Peng Ning és Xiaoyang Wang. Appintent: Érzékeny adatok továbbításának elemzése Androidon a magánéletvédelmi szivárgások észlelésére. Oldalak: 1043–1054, 2013. november.
- Qizhe Xie, Zihang Dai, Eduard H. Hovy, Minh-Thang Luong és Quoc V. Le. Felügyelet nélküli adatnövelés.
Tudja meg, hogyan szerezhet keresett szakmát a nulláról, vagy lépjen szintet a készségekkel és a fizetéssel, ha elvégzi a SkillFactory online tanfolyamait:
- (12 hónap)
- (12 hét)
- (20 hét)
- (20 hét)
További kurzusok
- (9 hónap)
- (8 hónap)
- (9 hónap)
- (12 hónap)
- (18 hónap)
- (12 hónap)
- (9 hónap)
- (7 hónap)
Forrás: habr.com
