

DataHub nyílt forráskódú: a LinkedIn metaadatok kereső és felfedező platformja
A gyors adatkeresés alapvető fontosságú bármely vállalat számára, amely nagymértékben támaszkodik az adatokra a döntéshozatal során. Ez nemcsak a felhasználók (beleértve az elemzőket, a gépi tanulás fejlesztőit, az adatfeldolgozó szakembereket és az adatkutatókat) produktivitására van hatással, hanem közvetlenül befolyásolja azokat a végtermékeket is, amelyek a minőségi gépi tanulási (ML) csatornától függenek. Ezen kívül a gépi tanulási platformok bevezetésének vagy létrehozásának tendenciája természetesen felveti a kérdést: mi a belső funkciókeresési, modell-, mutató-, adat- és egyéb készletek módszere?
Ebben a cikkben beszámolunk arról, hogyan tettük közzé az adatforrást nyílt licenc alatt. a metadaták keresésére és felfedezésére szolgáló platformunkban, a projekt első napjaitól kezdve. . A LinkedIn a DataHub saját verzióját támogatja a nyílt forráskódú verziótól elkülönítve. Elmagyarázzuk, miért van szükségünk két különböző fejlesztési környezetre, majd áttekintjük az első megközelítéseinket, hogy miként használjuk a nyílt forráskódú WhereHowst, és összehasonlítjuk a belső (termelési) verziónkat a nyílt forráskódú verzióval. . Emellett megosztjuk új automatizált megoldásunk részleteit, amely frissítések küldésére és fogadására szolgál a nyílt forráskódú környezetben, hogy szinkronizálhassuk a két tárolót. Végül útmutatást adunk arról, hogyan lehet elkezdeni a DataHub nyílt forráskódú használatát, és röviden megvitatjuk annak architektúráját.
A WhereHows mostantól DataHub!
A LinkedIn metadatacsapata korábban bemutatta (a WhereHows utódja), a LinkedIn metadaták keresésére és felfedezésére szolgáló platformot, és megosztotta terveit annak nyitására. Nem sokkal ezután kiadtuk a DataHub alfa verzióját, és megosztottuk a közösséggel. Azóta folyamatosan hozzájárultunk a tárolóhoz, és együtt dolgoztunk az érdeklődő felhasználókkal, hogy hozzáadjuk a legkeresettebb funkciókat és megoldjuk a problémákat. Most örömmel jelentjük be a hivatalos kiadást. .
Nyílt forráskódú megközelítések
A WhereHows, az LinkedIn eredeti portálja az adatok keresésére és származására, belső projektként indult; a metadatacsapat 2016-ban nyitotta meg a forráskódját. . Azóta a csapat mindig két különböző kódalapot támogatott — egyet a nyílt forráskód számára, és egyet a LinkedIn belső használatához, mivel nem minden termékfunkció, amelyet a LinkedIn esetleges használati lehetőségeihez fejlesztettek, volt alkalmazható a tágabb közönség számára. Továbbá, a WhereHows-nak van néhány belső függősége (infrastruktúra, könyvtárak stb.), amelyeknek a forráskódja nem nyilvános. Az ezt követő években a WhereHows számos iteráción és fejlesztési cikluson ment keresztül, ami a két kódalap szinkronizálását nagy problémává tette. A metadaták csapata évek óta különböző megközelítéseket próbál alkalmazni azzal a céllal, hogy próbálja szinkronizálni a belső fejlesztést és a nyílt forráskódú fejlesztést.
Első próbálkozás: «Először nyílt forráskód»
Kezdetben a «először nyílt forráskód» fejlesztési modellt követtük, ahol a fő fejlesztés a nyílt forráskódú tárolóban zajlik, és a változtatásokat a belső telepítéshez végezzük el. Ennek a megközelítésnek a problémája az, hogy a kódot mindig először a GitHub-ra küldik, mielőtt teljesen ellenőriznék belsőleg. Amíg a nyílt forráskódú tárolóból el nem végzik a változtatásokat és nem hajtanak végre új belső telepítést, nem fogunk észlelni termelési problémákat. Rossz telepítés esetén szintén nagyon nehéz volt megállapítani a felelőst, mert a változásokat csomagokban végezték.
Ezen kívül ez a modell csökkentette a csapat produktivitását az új funkciók fejlesztésében, amelyek gyors iterációkat igényeltek, mivel azt követelte meg, hogy minden változtatást először a nyílt forráskódú tárolóban helyezzenek el, majd továbbítsák a belső tárolónak. Az időfeldolgozást csökkentendő, a szükséges javítást vagy változtatást először a belső tárolóban lehetett elvégezni, de ez hatalmas problémát okozott, amikor az ilyen változtatások visszaintegrálása jött a nyílt forráskódú tárolóba, mert a két tároló már nem volt szinkronban.
Ez a modell sokkal könnyebben megvalósítható általános platformok, könyvtárak vagy infrastruktúra projektek számára, mint teljes funkcionalitású felhasználói webalkalmazások esetében. Ezenkívül ez a modell tökéletesen alkalmas olyan projektekhez, amelyek nyílt forráskódú alapként indulnak, azonban a WhereHows teljesen belső webalkalmazásként készült. Nagyon nehéz volt teljesen eltávolodni az összes belső függőségtől, ezért fenn kellett tartanunk a belső ágat, de a belső ág fenntartása és a nagyrészt nyílt forráskódú fejlesztés nem igazán működött.
Második kísérlet: "Belső először"
** Második kísérletként átálltunk a "belső először" fejlesztési modellre, ahol a fő fejlesztés a cégen belül zajlik, és a változtatások rendszeresen beépülnek a nyílt forráskódba. Bár ez a modell a legjobban illeszkedik a használati esetünkhöz, problémákkal jár. Az összes eltérés közvetlen küldése a nyílt forráskódú tárolóba, majd a konfliktusok későbbi megoldása egy lehetőség, de ez időigényes. A fejlesztők általában szeretnék elkerülni ezt a kódellenőrzés során. Ennek következtében sokkal ritkábban fog megtörténni, csoportosan, így megnehezíti a későbbi konfliktusok feloldását.
Harmadik alkalommal minden sikerült!
A fent említett két sikertelen kísérlet miatt a WhereHows GitHub tároló hosszú ideig elavult maradt. A csapat továbbra is fejlesztette a termék funkcióit és architektúráját, így a LinkedIn számára készült belső WhereHows verzió egyre tökéletesebb lett, mint a nyílt forráskódú verzió. Még új neve is lett — DataHub. Az előző sikertelen kísérletek alapján a csapat úgy határozott, hogy egy skálázható, hosszú távú megoldást fejleszt.
Bármilyen új nyílt forráskódú projekt esetén a LinkedIn nyílt forráskódú fejlesztői csapata konzultál és támogatja azt a fejlesztési modellt, amelyben a projekt moduljai teljesen nyílt forráskódúként készülnek. A verziótámogatással rendelkező artefaktumokat egy nyilvános tárolóban telepítik, majd visszahelyezik a LinkedIn belső artefaktjába Ez a fejlesztési modell nemcsak az open source felhasználók számára kedvező, hanem egy moduláris, bővíthető és integrálható architektúra kialakításához is vezet.
Azonban ennek az állapotnak az eléréséhez, egy érett belső alkalmazás, mint a DataHub esetében, jelentős időráfordításra lesz szükség. Ez kizárja egy teljesen működő open source megvalósítás lehetőségét addig, amíg az összes belső függőséget teljesen nem absztrahálják. Ezért olyan eszközöket fejlesztettünk ki, amelyek segítenek gyorsabban és sokkal kevésbé fájdalmasan hozzájárulni az open source-hoz. Ez a megoldás előnyös a metadát csapat (DataHub fejlesztője) és az open source közösség számára is. A következő részekben ezt az új megközelítést fogjuk tárgyalni.
Open source kiadás automatizálása
A metadát csoport utolsó megközelítése a DataHub open source-hoz az, hogy egy olyan eszközt fejlesztenek ki, amely automatikusan szinkronizálja a belső kódalapot és az open source tárolót. Ennek az eszközkészletnek a magas szintű funkciói a következők:
- LinkedIn kódjának szinkronizálása open source-ba / open source-ból, hasonlóan .
- Licenccím generálása, hasonlóan .
- Automatikus commit logok létrehozása open source-ból a belső commit logokból.
- A belső változásoknak az open source kiépítését megzavaró megelőzése .
A következő alfejezetekben részletezve lesznek a fent említett funkciók, amelyek érdekes kihívásokat jelentenek.
Forráskód szinkronizálása
A DataHub open source verziójához képest, amely egyetlen GitHub tároló, a LinkedIn DataHub verziója több tároló kombinációja (a cégen belül úgynevezett ). A DataHub interfésze, a metadóminta könyvtár, a metadómény szolgáltatás és a streaming feladatok különböző tárolókban találhatók a LinkedIn-en. Azonban az open source felhasználók munkájának megkönnyítése érdekében egyetlen tárolónk van az open source DataHub verzióhoz.
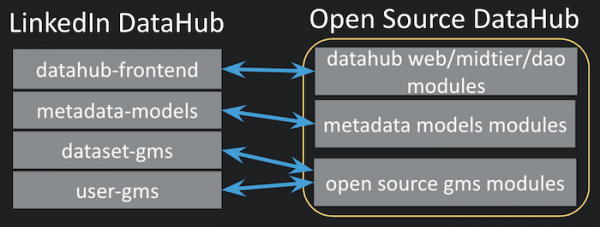
Ábra 1: Szinkronizálás a tárolók között LinkedIn DataHub és egyetlen tároló DataHub nyílt forráskódú
Az automatikus összeszerelési, küldési és kinyerési munkafolyamatok támogatásához új eszközünk automatikusan létrehozza a fájl szintű leképezést, amely megfelel minden forrásfájlhoz. Azonban az eszközhöz elsődleges konfigurációra van szükség, és a felhasználóknak magas szintű modul leképezést kell biztosítaniuk, ahogy az alább látható.
{
  "datahub-dao": [
    "${datahub-frontend}/datahub-dao"
  ],
  "gms/impl": [
    "${dataset-gms}/impl",
    "${user-gms}/impl"
  ],
  "metadata-dao": [
    "${metadata-models}/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}/metadata-builders"
  ]
}
A modul szintű leképezés egy egyszerű JSON, ahol a kulcsok a célmodulok a nyílt forráskódú tárolóban, az értékek pedig a LinkedIn tárolók forrásmoduljainak listája. Bármely célmodul a nyílt forráskódú tárolóban táplálható bármennyi forrásmodul által. A forrásmodulokban belső tárolónév megjelölésére használják A modul szintű leképezés fájl szintű leképezést készít, átvizsgálva az összes fájlt a kapcsolódó könyvtárakban.
{
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Foo.java":
"metadata-builders/src/main/java/com/linkedin/Foo.java",
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Bar.java":
"metadata-builders/src/main/java/com/linkedin/Bar.java",
  "${metadata-models}/metadata-builders/build.gradle": null,
}
A fájl szintű leképezés automatikusan létrejön az eszközök által; azonban a felhasználó kézzel is frissítheti. Ez a leképezés 1:1 a LinkedIn forrásfájl és a nyílt forráskódú tároló fájlja között. Számos szabály kapcsolódik ehhez az automatikus fájl leképezéshez:
- Ha több forrásmodul van a nyílt forráskódú célmodulhoz, akkor ütközések léphetnek fel, például ha ugyanaz a , több mint egy forrásmodulban létezik. Az ütközések feloldásának stratégiájaként eszközeink alapértelmezés szerint az 'utolsó nyer' lehetőséget használják.
- "null" azt jelenti, hogy a forrásfájl nem része a nyílt forráskódú tárolónak.
- Minden egyes közzététel vagy visszavonás után ez az összepárosítás automatikusan frissül, és létrejön egy pillanatfelvétel. Ez szükséges a forráskód legutolsó módosítása utáni hozzáadások és eltávolítások meghatározásához.
Commit naplók létrehozása
A nyílt forráskódú commitok naplóit automatikusan létrehozzák a belső tárolók commit naplóinak összekapcsolásával. Az alábbiakban egy példa a commit naplóra, amely bemutatja a mi eszközünkkel létrehozott commit napló struktúráját. A commit egyértelműen megjelöli, hogy mely forrás tárolók verziói vannak csomagolva ebbe a commitba, és összefoglaló információt nyújt a commit naplóról. Ellenőrizze ezt egy valós commit napló példán, amelyet az eszközünkkel készítettek.
metadata-models 29.0.0 -> 30.0.0
    Hozzáadott aspektus modell foo
    Hibajavítás bar

dataset-gms 2.3.0 -> 2.3.4
    Hozzáadott rest.li API a foo aspektus kiszolgálásához

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Függőség tesztelése
A LinkedIn rendelkezik , amely segít biztosítani, hogy a belső multiproduktum változtatásai ne zavarják meg a függő multiproduktumok építését. A nyílt forráskódú DataHub tároló nem multiproduktum, és nem lehet közvetlen függősége semmilyen multiproduktumnak, de a multiproduktum héj segítségével, amely a nyílt forráskódú DataHub forráskódját vonja be, még mindig használhatjuk ezt a függőség tesztelő rendszert. Így bármely változtatás (amely később nyilvánosságra kerülhet) a DataHub nyílt forráskódú tárolót tápláló multiproduktumok bármelyikében egy építési eseményt indít el a héj multiproduktumában. Következésképpen bármely olyan változtatás, amely nem engedi építeni a multiproduktumhéjat, nem halad át a teszteken az eredeti multiproduktumnak a commit előtt, és vissza kell lépnie.
Ez egy hasznos mechanizmus, amely segít megakadályozni bármely belső commitot, amely megsérti a nyílt forráskódú építést, és észleli azt a commit létrehozásakor. Enélkül meglehetősen nehéz lenne meghatározni, hogy mely belső commit vezetett a nyílt forráskódú tároló építési hibájához, mivel a csomagolt belső változtatásokat a nyílt forráskódú DataHub tárolóba helyezzük.
A DataHub nyílt forráskódú verziója és gyártási verziónk közötti különbségek
Eddig a DataHub két verziójának szinkronizálására vonatkozó megoldásunkat tárgyaltuk, de eddig még nem határoztuk meg, miért van szükségünk két különböző fejlesztési folyamatra. Ebben a részben felsoroljuk a DataHub nyilvános verziója és a LinkedIn szerverein futó gyártási verzió közötti különbségeket, valamint megmagyarázzuk ezen különbségek okait.
Az eltérések egyike abból adódik, hogy a gyártási verziónk olyan kódokkal rendelkező függőségeket alkalmaz, amelyek még nem nyilvánosak, mint például a LinkedIn Offspring (a LinkedIn belső függőség-kezelési struktúrája). Az Offspring széles körben használatos a belső kódalapban, mert ez a dinamikus konfiguráció kezelésének preferált módja. De ez nem nyílt forráskódú; ezért kellett alternatívákat találnunk a DataHub nyílt forráskódú verziójához.
Más okok is vannak. Ahogy a LinkedIn igényeihez készült metaadat-modellek kiterjesztéseit fejlesztjük, ezek a kiterjesztések általában nagyon specifikusak a LinkedIn számára, és nem feltétlenül alkalmazhatók más környezetekre. Például nagyon specifikus címkéink vannak a résztvevő azonosítókhoz és más típusú megfeleltetések metaadataihoz. Jelenleg ezért ezeket a kiterjesztéseket kizártuk a DataHub nyílt forráskódú metaadat-modelleből. Ahogy interakcióba lépünk a közösséggel és megértjük az igényeiket, dolgozni fogunk a szükséges nyílt forráskódú kiterjesztések közös verzióin.
A nyílt forráskódú közösség számára való könnyű használat és alkalmazkodás is inspirálta a DataHub két verziója közötti különbségeket. A streaming infrastruktúrában bekövetkező különbségek jó példa erre. Míg a belső verziónk a kezelt streaming infrastruktúrát alkalmazza, úgy döntöttünk, hogy a nyílt forráskódú verzióhoz beépített (önálló) streaminget használunk, mivel ez elkerüli egy újabb infrastruktúra-függőség létrehozását.
Egy másik példa a különbségre az, hogy a nyílt forráskódú megvalósításban egy GMS (Általános Metaadat-tároló) található, nem pedig több. A GMA (Általános Metaadat-architektúra) a DataHub belső architektúrájának elnevezése, míg a GMS a metaadatok tárolója a GMA kontextusában. A GMA egy nagyon rugalmas architektúra, amely lehetővé teszi, hogy minden adatstruktúrát (például adathalmazokat, felhasználókat stb.) a saját metaadat-tárolójába osszunk szét, vagy több adatstruktúrát tároljunk egyetlen metaadat-tárolóban, amíg a GMS-ben található adatstruktúra térképét frissítjük. A felhasználás egyszerűsítése érdekében egy GMS példányt választottunk, amely minden különböző adatstruktúrát tárol a nyílt forráskódú DataHubban.
A két megvalósítás közötti különbségek teljes listáját az alábbi táblázat tartalmazza.
Termék Jellemzők
LinkedIn DataHub
Nyílt Forráskódú DataHub
Támogatott Adatstruktúrák
1) Adathalmazok 2) Felhasználók 3) Metrikák 4) ML Jellemzők 5) Diagramok 6) Műszerfalak
1) Adathalmazok 2) Felhasználók
Támogatott Metaadat Források Adathalmazokhoz
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Folyamfeldolgozás
Kezelt
Beágyazott (önálló)
Függőségi Injektálás & Dinamikus Konfiguráció
LinkedIn Utódok
Build Eszközök
Ligradle (LinkedIn belső Gradle csomagkezelője)
CI/CD
CRT (LinkedIn belső CI/CD)
és
Metaadat Tárak
Elosztott több GMS: 1) Adat GMS 2) Felhasználó GMS 3) Metrika GMS 4) Jellemző GMS 5) Diagram/Műszerfal GMS
Egyetlen GMS: 1) Adathalmazok 2) Felhasználók
Mikroszolgáltatások Docker konténerekben
egyszerűsíti az alkalmazások telepítését és terjesztését Minden DataHub nyílt forráskódú szolgáltatás része, beleértve az infrastruktúra komponenseit, mint például a Kafka, , és , saját Docker-képpel rendelkezik. A Docker konténerek orchestrationjához .
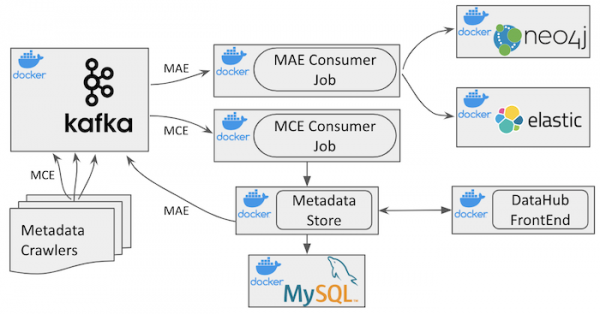
2. ábra: Architektúra DataHub *nyílt forráskódú*
A fenti képen megtekintheti a DataHub magas szintű architektúráját. Az infrastruktúra komponenseken kívül négy különböző Docker konténer található:
datahub-gms: metaadat-tároló szolgáltatás
datahub-frontend: alkalmazás , amely a DataHub felületét szolgáltatja.
datahub-mce-consumer: alkalmazás , amely a metaadatok változásának eseményeit (MCE) zúdítja, és frissíti a metaadat-tárolót.
datahub-mae-consumer: alkalmazás , amely a metaadatok audit eseményeit (MAE) használja, és létrehozza a keresési index és gráf adatbázist.
Dokumentáció a nyílt forráskódú repositoryhoz és több részletes információt tartalmaz a különböző szolgáltatások funkcióiról.
CI / CD a DataHub-ban nyílt forráskódú
A DataHub nyílt forráskódú tárolója használja folyamatos integrációra és folyamatos telepítésre. Mindkettő jól integrálódik a GitHub-bal és könnyen beállítható. A közösség vagy magánvállalatok által kifejlesztett nyílt forráskódú infrastruktúra többsége (például ), Docker képek készülnek, és a Docker Hub-on kerülnek telepítésre a közösség könnyű használata érdekében. Bármely Docker kép, amelyet a Docker Hub-on találnak, könnyen használható egy egyszerű paranccsal .
Minden egyes commit során a DataHub nyílt forráskódú tárolójában minden Docker kép automatikusan létrejön és a Docker Hub-ra kerül telepítésre a „latest” címmel. Ha a Docker Hub-ban meg van határozva néhány , akkor minden címke a nyílt forráskódú tárolóban is a megfelelő címkékkel jelenik meg a Docker Hub-on.
A DataHub használata
nagyon egyszerű, és három egyszerű lépésből áll:
- Klónozza a nyílt forráskódú tárolót, és indítsa el az összes Docker konténert a docker-compose segítségével a gyors induláshoz biztosított docker-compose szkript használatával.
- Töltse le a tárolóban bemutatott adatmintákat a szintén biztosított parancssori eszközzel.
- Nézze meg a DataHub-ot a böngészőjében.
Aktívan követett is be van állítva a gyors kérdésekhez. A felhasználók közvetlenül a GitHub tárolóban is létrehozhatják a problémáikat. A legfontosabb, hogy üdvözöljük és értékeljük minden visszajelzést és javaslatot!
Jövőbeli tervek
Jelenleg a DataHub nyílt forráskódú infrastruktúrája vagy mikroszolgáltatása Docker konténerré épül, és az egész rendszert orchestrálja a . Figyelembe véve a népszerűségét és széleskörű elterjedését , szeretnénk a közeljövőben Kubernetes alapú megoldást is biztosítani.
Tervezzük, hogy kész megoldást biztosítunk a DataHub telepítésére nyilvános felhőszolgáltatásokon, mint például , vagy . Figyelembe véve a LinkedIn Azure-ra való átállásának legújabb bejelentését, ez megfelel a metadat csoport belső prioritásainak.
És végül, de nem utolsósorban: köszönet minden DataHub első felhasználójának az open source közösségben, akik értékelték a DataHub alfa verzióját, és segítettek nekünk a problémák feltárásában és a dokumentáció fejlesztésében.
Forrás: habr.com
