

— egy nagyon hatékony és kényelmes mechanizmus, ha az összefüggő adatokon ugyanazokat a műveleteket hajtják végre "mélyen". De a kontrollálatlan rekurzió a gonosz, ami akár végtelen végrehajtást is eredményezhet, vagy (ami gyakrabban előfordul) a „teljesen elnyeli” az összes elérhető memóriát.
A DBMS-ek ebben a tekintetben hasonló elveken működnek — "ha azt mondták, hogy ásson, én is ások". A lekérdezésed nemcsak lelassíthatja a szomszédos folyamatokat, folyamatosan elfoglalva a CPU erőforrásait, hanem az egész adatbázist is „lerombolhatja”, elnyelve az összes elérhető memóriát. Ezért a végtelen rekurzió elleni védelem a fejlesztő kötelessége.
A PostgreSQL-ben a rekurzív lekérdezések használatának lehetősége már a régi 8.4-es verzióban is megjelent, de még mindig rendszeresen találkozni lehet potenciálisan sebezhető "védtelen" lekérdezésekkel. Hogyan lehet megszabadulni az ilyen problémáktól?
Ne írj rekurzív lekérdezéseket
Hanem írj nem rekurzívakat. Tisztelettel, Ön K.O.
Valójában a PostgreSQL elegendő funkciót biztosít, amelyeket felhasználhatsz ahhoz, hogy nem alkalmazza a rekurziót.
Alapvetően más megközelítést alkalmazz a feladathoz
Néha csak más szemszögből kell megvizsgálni a feladatot. Egy ilyen helyzet példáját a című cikkemben ismertettem — a számok halmazának szorzása felhasználói aggregáló függvények nélkül:
WITH RECURSIVE src AS (
  SELECT '{2,3,5,7,11,13,17,19}'::integer[] arr
)
, T(i, val) AS (
  SELECT
    1::bigint
  , 1
UNION ALL
  SELECT
    i + 1
  , val * arr[i]
  FROM
    T
  , src
  WHERE
    i <= array_length(arr, 1)
)
SELECT
  val
FROM
  T
ORDER BY -- az utolsó eredmény kiválasztása
  i DESC
LIMIT 1;
Ezt a lekérdezést helyettesítheted a matematikai szakértők verziójával:
WITH src AS (
  SELECT unnest('{2,3,5,7,11,13,17,19}'::integer[]) prime
)
SELECT
  exp(sum(ln(prime)))::integer val
FROM
  src;
Használj generate_series-t ciklusok helyett
Tegyük fel, hogy az a feladatunk, hogy generáljuk az összes lehetséges előtagját a szónak 'abcdefgh':
WITH RECURSIVE T AS (
  SELECT 'abcdefgh' str
UNION ALL
  SELECT
    substr(str, 1, length(str) - 1)
  FROM
    T
  WHERE
    length(str) > 1
)
TABLE T;
Tényleg szükség van itt rekurzióra?.. Ha helyette alkalmazod a LATERAL és generate_series-t, akkor még CTE-re sincs szükség:
SELECT
  substr(str, 1, ln) str
FROM
  (VALUES('abcdefgh')) T(str)
, LATERAL(
    SELECT generate_series(length(str), 1, -1) ln
  ) X;
Módosítsd az adatbázis szerkezetét
Például van egy fórumbeszélgetések táblád, amely a válaszadás kapcsolatát mutatja, vagy a szálat :
CREATE TABLE message(
  message_id
    uuid
      PRIMARY KEY
, reply_to
    uuid
      REFERENCES message
, body
    text
);
CREATE INDEX ON message(reply_to); 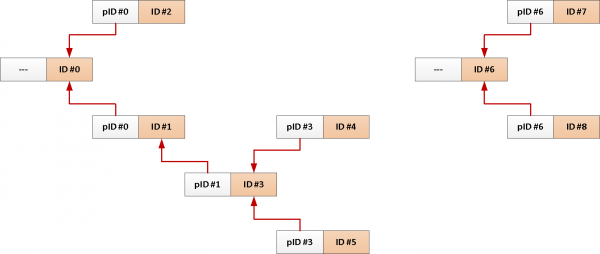
A tipikus lekérdezés, amely betölti az összes üzenetet egy témában, körülbelül így néz ki:
WITH RECURSIVE T AS (
  SELECT
    *
  FROM
    message
  WHERE
    message_id = $1
UNION ALL
  SELECT
    m.*
  FROM
    T
  JOIN
    message m
      ON m.reply_to = T.message_id
)
TABLE T;
De mivel mindig szükségünk van az egész témára a gyökérüzenettől, miért ne tennénk hozzá az azonosítóját minden egyes bejegyzéshez automatikusan?
-- adjunk hozzá egy mezőt a téma közös azonosítójával és indexet rá
ALTER TABLE message
  ADD COLUMN theme_id uuid;
CREATE INDEX ON message(theme_id);

-- inicializáljuk a téma azonosítóját egy triggerrel beszúráskor
CREATE OR REPLACE FUNCTION ins() RETURNS TRIGGER AS $$
BEGIN
  NEW.theme_id = CASE
    WHEN NEW.reply_to IS NULL THEN NEW.message_id -- vegyük az indító eseményből
    ELSE ( -- vagy a válaszolt üzenetből
      SELECT
        theme_id
      FROM
        message
      WHERE
        message_id = NEW.reply_to
    )
  END;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;

CREATE TRIGGER ins BEFORE INSERT
  ON message
    FOR EACH ROW
EXECUTE PROCEDURE ins(); 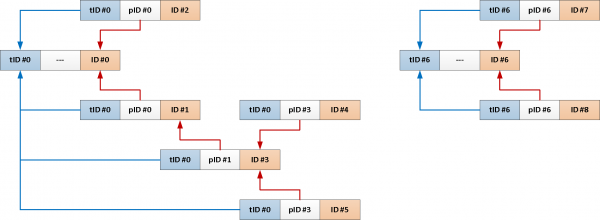
Most a teljes rekurzív lekérdezésünk így egyszerűsödhet:
SELECT
  *
FROM
  message
WHERE
  theme_id = $1;
Használjunk alkalmazási „határokat”
Ha valamilyen okból nem tudjuk megváltoztatni az adatbázis struktúráját, nézzük meg, mire támaszkodhatunk, hogy még a hibás adatok megléte se vezessen végtelen rekurzióhoz.
A rekurzió „mélység” számlálója
Egyszerűen minden rekurziós lépésnél növeljük a számlálót egy egységgel, amíg el nem érjük a sokat sürgetett határt, amelyet nyilvánvalóan nem megfelelőnek tartunk:
WITH RECURSIVE T AS (
  SELECT
    0 i
  ...
UNION ALL
  SELECT
    i + 1
  ...
  WHERE
    T.i < 64 -- a határ
)
Pro: Ciklusba lépés kísérletekor sem végzünk többet az előírt iterációk számánál „mélységben”.
Contra: Nincs garancia arra, hogy nem dolgozunk fel ismét egy ugyanazon bejegyzést — például 15-ös és 25-ös mélységnél, na és aztán minden +10-nél. De a „szélességre” senki sem ígért semmit.
Formailag ez a rekurzió nem lesz végtelen, de ha minden lépésnél exponenciálisan növekszik a bejegyzések száma, mindannyian jól tudjuk, hogy ez mivel végződik…
A „út” őrzője
Fokozatosan felírjuk mindazokat az objektumazonosítókat, amelyekkel a rekurzió során találkozunk, egy tömbbe, amely egyedi „út” hozzánk:
WITH RECURSIVE T AS (
  SELECT
    ARRAY[id] path
  ...
UNION ALL
  SELECT
    path || id
  ...
  WHERE
    id  ALL(T.path) -- nem egyezik egyikkel sem
)
Pro: Ha a dátumban ciklus van, akkor biztosan nem fogunk ugyanazt a bejegyzést újra feldolgozni egy adott útvonalon belül.
Contra: De közben szó szerint bejárhatunk minden bejegyzést, anélkül, hogy megismételnénk őket.
Útvonalhossz-korlátozás
Az "elveszett" rekurzió elkerülése érdekében, amely érthetetlen mélységben jár, kombinálhatjuk a két előző módszert. Vagy ha nem szeretnénk felesleges mezőket fenntartani, kiegészíthetjük a rekurzió folytatásának feltételét az útvonal hosszának értékelésével:
WITH RECURSIVE T AS (
  SELECT
    ARRAY[id] path
  ...
UNION ALL
  SELECT
    path || id
  ...
  WHERE
    id  ALL(T.path) AND
    array_length(T.path, 1) < 10
)
Válaszd ki a számodra tetsző módot!
Forrás: habr.com
