

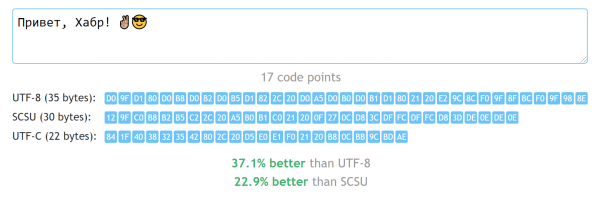
Ha fejlesztő vagy, és előttad áll a karakterkódolás kiválasztásának feladata, szinte mindig a Unicode a helyes megoldás. A konkrét megjelenítési mód a kontextustól függ, de a leggyakrabban itt is van egy univerzális válasz — UTF-8. Ez azért jó, mert lehetővé teszi a Unicode összes karakterének használatát, anélkül, hogy túl sok byte-ot költenénk a legtöbb esetben. Az igaz, hogy a nemcsak latin betűs nyelvek esetében a "nem túl sok" az legalább két byte karakterenként. Van ennél jobb megoldás, anélkül, hogy visszatérnénk a prehistorikus kódolásokhoz, amelyek csupán 256 elérhető karakterrel korlátoznak minket?
Alább javaslom, hogy ismerkedj meg azzal az próbálkozásommal, hogy választ adjak erre a kérdésre, és egy viszonylag egyszerű algoritmus megvalósításával, amely lehetővé teszi a szövegek tárolását a világ legtöbb nyelvén, anélkül, hogy azt a felesleges többletet hozzáadnánk, ami az UTF-8-ban van.
Nyilatkozat. Azonnal szeretnék néhány fontos pontosítást tenni: a megoldás nem javasolt univerzális helyettesítőként az UTF-8 számára, csupán egy szűk esetek listájára alkalmazható (erről lentebb), és semmiképpen sem használható harmadik féltől származó API-kkal való interakcióra (amelyek nem is tudnak róla). Legtöbbször a nagy mennyiségű szöveges adat kompakt tárolásához általános célú tömörítési algoritmusok, például a deflate, jobban megfelelnek. Ezen kívül, már a megoldásom kidolgozása során találtam egy létező szabványt magában a Unicode-ban, amely ugyanazt a feladatot oldja meg — valamivel bonyolultabb (és gyakran rosszabb), de mindenképpen egy elfogadott standard, nem egy összerakott kezdeti megoldás. Erről is beszélni fogok.
A Unicode-ról és az UTF-8-ról
Először is — néhány szó arról, hogy mi is az a Unicode és UTF-8.
Mint tudjuk, korábban a 8 bites kódolások népszerűek voltak. Itt minden egyszerű volt: 256 karaktert lehetett számozni 0-tól 255-ig, a 0-tól 255-ig terjedő számok nyilvánvalóan egy byte-ban ábrázolhatók. Ha visszatérünk a legősibb gyökerekhez, akkor az ASCII kódolás valóban csak 7 bitre korlátozódik, így a legfelső bit a byte-jának ábrázolásában nulla, és a legtöbb 8 bites kódolás kompatibilis vele (csak a "felső" részen különböznek, ahol a legfelső bit egy).
Mi különbözteti meg tehát ezeket a kódolásokat a Unicode-tól, és miért kapcsolódik hozzájuk azonnal számos konkrét megjelenítés — UTF-8, UTF-16 (BE és LE), UTF-32? Vizsgáljuk meg lépésről lépésre.
A Unicode alapvető szabványa csak a karakterek (és bizonyos esetekben a karakterek külön komponensei) és azok számának megfelelőségét írja le. És a szabványban a lehetséges számok száma nagyon nagy — 0x00 tól 0x10FFFF (1 114 112 darab). Ha egy ilyen tartományban akarnánk számot tárolni egy változóban, sem 1, sem 2 bájt nem lenne elegendő. Mivel a három bájtos számokkal való munka nem igazán optimalizált a processzoraink számára, kénytelenek lennénk négy bájtot használni egyetlen karakterre! Ez a UTF-32, de éppen emiatt a „pazarlás” miatt ez a formátum nem népszerű.
Szerencsére a Unicode-on belüli karakterek rendezése nem véletlenszerű. Az összes karakter 17 „síkravan felosztva, amelyek mindegyike 65536 (0x10000) «kódpontot). A „kódpont” kifejezés itt egyszerűen a karakter száma, amelyet a Unicode rendelt hozzá. De, ahogy már említettem, a Unicode-ban nemcsak a különálló karakterek, hanem azok komponensei és segédjelek számozva vannak (és néha semmi nem felel meg a számnak — lehet, hogy egy időre, de ez számunkra nem lényeges), ezért helyesebb mindig a számok számáról beszélni, nem a karakterek számáról. Azonban a továbbiakban a tömörség kedvéért gyakran fogom használni a „karakter” szót, utalva a „kódpontra”.
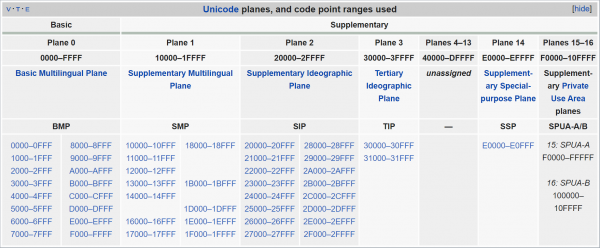
A Unicode síkjai. Ahogy látható, a legtöbb (4-13. sík) még mindig nem használva.
A legérdekesebb az, hogy az alapvető „mag” a nulladik síkon helyezkedik el, amelyet "Basic Multilingual Plane"-nak hívnak. Ha a sor tartalmaz szöveget egy modern nyelven (beleértve a kínait is), nem lép ki ennek a síknak a határain. De a Unicode többi részéről sem lehet eltávolítani — például az emojik főként a következő sík végén találhatók, "Supplementary Multilingual Plane" (amely kiterjed 0x10000 tól 0x1FFFF). Ezért az UTF-16 úgy működik, hogy minden karakter, amely beleesik ide, „ahogy van” van kódolva, a megfelelő kódját használva. Azonban a számok egy része ebben a tartományban egyáltalán nem konkrét karaktereket jelöl, hanem arra utal, hogy a páros bájt után még egyet kell figyelembe venni — ha ezeket a négy bájtot együtt kombinálva, a Unicode teljes engedélyezett tartományát lefedő számot kapunk. Ezt a formátumot „szurrogátpároknak” nevezik — lehet, hogy hallott már róluk. Basic Multilingual Plane, a "ténylegesen" kódolják, a megfelelő kéttáblás számmal. Azonban a számok egy része ebben a tartományban nem képvisel konkrét karaktereket, hanem arra utal, hogy az ezen bájt-pár után egy másikat is figyelembe kell venni — az értékek négy bájt összevonásával egy olyan számot kapunk, amely lefedi a Unicode megengedett teljes tartományát. Ezt a reprezentációt "szurreális pároknak" hívják — lehet, hogy hallottál róluk.
Így a UTF-16 két vagy (nagyon ritka esetekben) négy bájtot igényel egy „kódpont” esetén. Ez jobb, mint folyamatosan négy bájt használni, de a latin ábécé (és más ASCII karakterek) ezen a kódoláson fél helyet foglal el zérókkal. A UTF-8 célja ennek orvoslása: az ASCII itt csupán egy bájt; a kódok 0x80 tól 0x7FF — két bájt; a 0x800 tól 0xFFFF — három, míg a 0x10000 tól 0x10FFFF — négy. Egyrészt a latin ábécé jól járt: visszanyerte az ASCII-kompatibilitást, és az eloszlás egyenletesebben „elkenődik” 1 és 4 bájt között. De más ábécék, sajnos, nem profitálnak a UTF-8-ból a UTF-16-hoz képest, és sok esetben már három bájtot igényelnek a két helyett — a kétbájtos rögzítés által lefedett tartomány 32-szer zsugorodott, 0xFFFF tól 0x7FF, és ebbe most már nem fér bele sem a kínai, sem például a grúz. A cirill és további öt ábécé — hurrá — szerencsés, 2 bájt egy karakterért.
Miért van ez így? Nézzük meg, hogyan képviseli a UTF-8 a karakterkódokat:
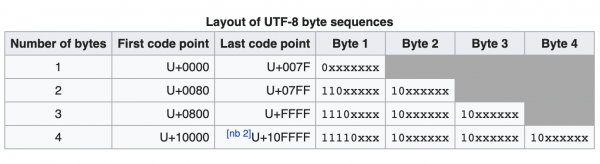
Közvetlenül a számok reprezentálásához itt biteket használnak, amelyeket a xjelöl. Látható, hogy a kétbájtos rögzítésben csupán 11 bit van (a 16-ból). A vezető bitek itt csak segédfunkciót látnak el. A négybájtos rögzítés esetében pedig a kódpont száma számára 21 bit van fenntartva a 32-ből — első ránézésre elegendő lenne a három bájt (amely összesen 24 bitet ad), de a segédjelölők túl sok helyet foglalnak el.
Rossz ez? Valójában nem annyira. Egyrészt — ha nagyon érdekel minket a helymegtakarítás, vannak tömörítési algoritmusaink, amelyek könnyedén megszüntetik az összes felesleges entrópiát és redundanciát. Másrészt — a Unicode célja a lehető leguniverzálisabb kódolás biztosítása volt. Például, egy UTF-8-ban kódolt szöveget bizalommal adhatunk át egy olyan kódnak, amely korábban csak ASCII-val működött, és nem kell félnünk, hogy olyan karaktert lát, amely az ASCII tartományában valójában nincs jelen (mivel a UTF-8-ban minden bájt, amely a nulladik bittel kezdődik — az pontosan ASCII). És ha hirtelen el akarunk vágni egy kis farok részt egy nagyobb szövegből, anélkül, hogy az elejétől dekódolnánk (vagy helyreállítanánk egy rész információt a sérült részből) — nem nehéz megtalálni azt az eltolást, ahol egy karakter kezdődik (elég, ha kihagyjuk azokat a bájtokat, amelyek bit prefixszel kezdődnek. 10).
Miért is kellene valami újat kitalálni?
Ugyanakkor időnként előfordulnak olyan helyzetek, amikor a deflate-hez hasonló tömörítési algoritmusok rosszul alkalmazhatók, de szeretnénk a szavakat tömörített formában tárolni. Személy szerint találkoztam ezzel a feladattal, amikor a éreztem, hogy egy nagy szótárhoz, amely tetszőleges nyelvű szavakat tartalmaz. Egyrészt minden szó nagyon rövid, így a tömörítése nem lesz hatékony. Másrészt az általam vizsgált fa megvalósítására az volt jellemző, hogy a tárolt sztring minden egyes byte-ja külön csúcsot generál, így nagyon hasznos volt minimalizálni a számukat. A könyvtáramban (ahogyan a , amire épül) ilyen probléma egyszerűen megoldódik - a -szótárban tárolt sztringek . De, mint tudjuk, ez csak korlátozott ábécé esetén működik jól - egy kínai szót ilyen szótárba már nem lehet beletenni.
Külön megemlítenék még egy kellemetlen aspektust, amely a UTF-8 használatakor merül fel ilyen adatstruktúrákban. A fenti képen látható, hogy amikor egy karaktert két byte-ként tárolunk, a hozzá tartozó bitek nem követik egymást, hanem feszültek egy pár bit 10 a közepén: 110xxxxx 10xxxxxx. Emiatt, amikor a karakter kódjában a második byte alsó 6 bitjei túlcsordulnak (azaz átlépik a 10111111 → 10000000), akkor az első byte is megváltozik. Így a 'п' betű byte-okkal van jelölve 0xD0 0xBF, míg utána a 'р' már 0xD1 0x80. A prefixfa esetében ez a szülőcsúcs kettéválásához vezet - az egyik a prefix számára, 0xD0a másik pedig 0xD1 (bár az összes cirill betűt csak a második byte-ban lehetne kódolni).
Mit sikerült elérnem
Ezzel a feladattal találkozva úgy döntöttem, hogy egy kicsit játszom a bitekkel, és egyúttal jobban megismerem a Unicode struktúráját általában. Az eredmény egy UTF-C kódolási formátum lett (a „C” a tömörített), amely nem tölt el több mint 3 byte-ot egy kódpontnál, és nagyon gyakran lehetővé teszi, hogy az egész kódolt sztringhez csak egy plusz byte-ot használjunk. Ez oda vezet, hogy sok nem-ASCII ábécén ez a kódolás 30-60%-kal tömörebb, mint a UTF-8.
A kódolási és dekódolási algoritmusok megvalósítása példákat állítottam , szabadon használhatja őket a kódjában. De szeretném hangsúlyozni, hogy bizonyos értelemben ez a formátum továbbra is anélkül, hogy tudnánk, mire van szükségünk. Ez inkább kísérlet, mint komoly
az UTF-8 javítása. Mindazonáltal a kód rendezett, tömör, sok kommentárral és teszteléssel van ellátva.
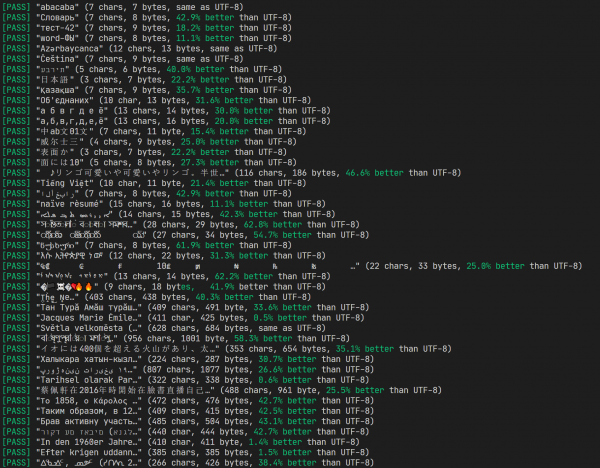
Továbbá készítettem , ahol értékelheti az algoritmus munkáját, és ezek után részletesebben beszélek az elveiről és a fejlesztési folyamatáról.
Túlzott bitek eltávolítása
Alapként természetesen az UTF-8-at vettem. Az első és legnyilvánvalóbb dolog, amit meg lehet változtatni — csökkenteni a vezérlő bitek számát minden bájtban. Például az első bájt az UTF-8-ban mindig azzal kezdődik, hogy 0vagy a 11 — és a prefix 10 csak a következő bájtoknál található. Lecseréljük a prefixet 11 Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata 1, az alábbi bájtoknál pedig teljesen eltávolítjuk a prefixeket. Mi történik?
0xxxxxxx — 1 bájt
10xxxxxx xxxxxxxx — 2 bájt
110xxxxx xxxxxxxx xxxxxxxx — 3 bájt
Várjunk, hol van a négy bájtos előírás? Az már nem szükséges — három bájtnál 21 bit elérhető, és ez bőven elegendő minden számhoz, amely 0x10FFFF.
Mivel mondtunk le itt? A legfontosabb a karakterhatárok észlelésének lehetősége bárhol a pufferből. Nem tudunk rámutatni egy tetszőleges bájt helyére, hogy onnan megtaláljuk a következő karakter kezdetét. Ez a formátumunk korlátja, de a gyakorlatban erre az igény nem merül fel gyakran. Általában képesek vagyunk a puffert a legeslegelejéről átfutni (különösen rövid sorok esetén).
A 2 bájtos nyelvek lefedettsége is javult: most a kétrészes formátum 14 bit tartományt ad, ami a kódokig terjed 0x3FFF. A kínaiaknak nem könnyű (a hieroglifáik főként a tartományban találhatók 0x4E00 tól 0x9FFF), de a grúzoknak és sok más népnek sokkal szórakoztatóbb lett — a nyelveik is beleférnek a 2 bájtba karakterenként.
Folytatjuk az enkóder állapotának bevezetését
Most gondoljunk a sorok tulajdonságaira. A szótárakban általában olyan szavak találhatók, amelyek egy ábécé karaktereivel íródtak, és sok más szövegnél is ez igaz. Jó lenne egyszer megadni ezt az ábécét, majd csak a betű számát megadni benne. Nézzük meg, segít-e nekünk a karakterek elhelyezkedése a Unicode táblában.
Ahogy fent említettük, a Unicode síkokra van osztva maximum of 65536 codes each. However, this division is not very useful (as mentioned, we are mostly in the zero plane). A more interesting division is into blocks. These ranges no longer have fixed lengths and carry more meaning — as a rule, each unites characters of the same alphabet.
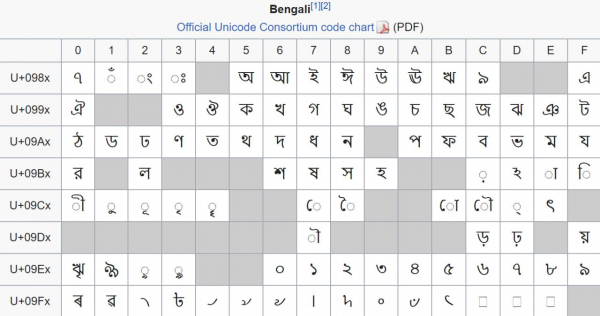
A block containing characters from the Bengali alphabet. Unfortunately, due to historical reasons, this is an example of not very dense packing — 96 characters are randomly scattered across 128 code points of the block.
The starting points of the blocks and their sizes are always multiples of 16 — this is simply done for convenience. In addition, many blocks start and end at values that are multiples of 128 or even 256 — for example, the main Cyrillic occupies 256 bytes from 0x0400 tól 0x04FF. This is quite convenient: if we save the prefix once 0x04, then any Cyrillic character can be recorded in one byte. However, this way we lose the ability to return to ASCII (and to any other characters at all). Therefore, we do it like this:
- Two bytes
10yyyyyy yxxxxxxxnot only denote the character with the numberyyyyyy yxxxxxxx, but also change the current alphabet Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használatayyyyyy y0000000(i.e., we remember all bits except the least significant 7 bits); - One byte
0xxxxxxxis a symbol from the current alphabet. It just needs to be added to the offset we remembered in step 1. As long as we haven't changed the alphabet, the offset is zero, so we maintained compatibility with ASCII.
Similarly for codes requiring 3 bytes:
- Three bytes
110yyyyy yxxxxxxx xxxxxxxxdenote the character with the numberyyyyyy yxxxxxxx xxxxxxxx, change the current alphabet Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használatayyyyyy y0000000 00000000(we remembered everything except the least significant 15 bits), and set a flag that we are now in long mode (when switching the alphabet back to two-byte, we will reset this flag); - Two bytes
0xxxxxxx xxxxxxxxin long mode this is a symbol from the current alphabet. Similarly, we add it to the offset from step 1. The only difference is that now we read two bytes (because we switched to this mode).
Sounds good: now as long as we need to encode characters from the same 7-bit Unicode range, we spend 1 extra byte at the start and only 1 byte for each character.
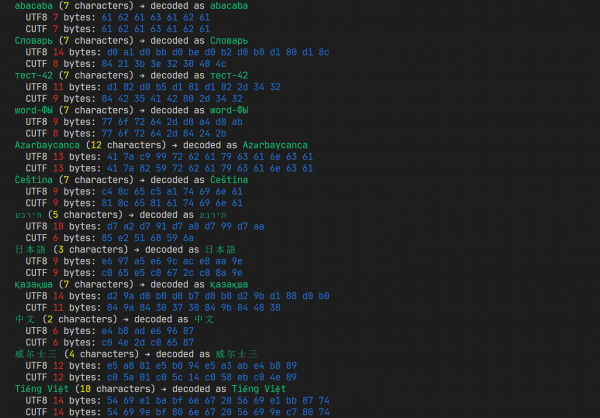
The work of one of the early versions. It already often surpasses UTF-8, but there is still room for improvement.
What has gotten worse? Firstly, we have a state, namely the offset of the current alphabet and the flag of long modeEz kiegészítőleg korlátoz minket: most már ugyanazok a karakterek különböző kontextusokban eltérően kódolhatók. Például a részstringek keresése már figyelembe kell, hogy vegye ezt, nem csak a byte-ok összehasonlítása alapján. Másodsorban, amint megváltoztattuk az ábécét, az ASCII karakterek kódolása problémássá vált (ez nemcsak a latin írás, hanem az alapvető írásjeleket is, beleértve a szóközöket) — ezek ismételt ábécs-váltást igényelnek 0-ra, tehát újabb felesleges byte-ra (aztán egy újabb arra, hogy visszatérjünk az alapunkhoz).
Egy ábécé jó, kettő — jobb
Próbáljunk kicsit változtatni a bitek előtagjain: hozzáadunk egyet a három előzőleg említetthez:
0xxxxxxx — 1 byte normál módban, 2 hosszú módban
11xxxxxx — 1 bájt
100xxxxx xxxxxxxx — 2 bájt
101xxxxx xxxxxxxx xxxxxxxx — 3 bájt
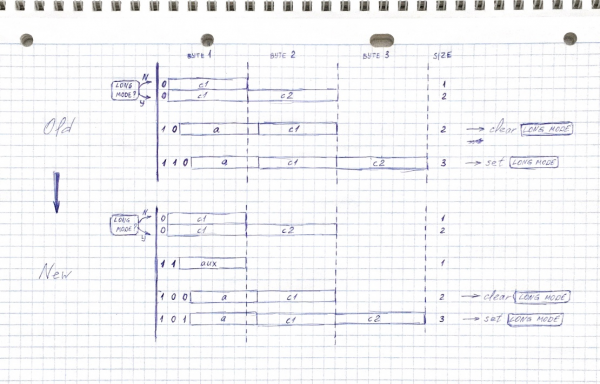
Most kétbyte-os kódolásban egy elérhető bittel kevesebb lett — a kódpontok egészen addig férnek el 0x1FFF, nem pedig 0x3FFF. Azonban még mindig érzékelhetően több, mint a kétbyte-os UTF-8 kódokban, a legtöbb elterjedt nyelv még mindig belefér, a legszembetűnőbb veszteség — kiesett és , a japánok szomorúak.
Mi ez az új kód 11xxxxxx? Это небольшой «загашник» размером в 64 символа, он дополняет наш основной алфавит, поэтому я назвал его вспомогательным (auxiliary) ábécé. Amikor váltunk a jelenlegi ábécéről, a régi ábécé egy része segédábécsé válik. Például, ha ASCII-ról cirillre váltunk — a „tárolóban” most 64 karakter van, amelyek tartalmazzák a latin betűket, számokat, szóközt és vesszőt (a leggyakoribb beszúrások nem-ASCII szövegekben). Visszaváltva ASCII-ra — a segédábécsé a cirill fő része válik.
Két ábécéhez való hozzáféréssel többféle szöveggel elboldogulhatunk, minimális üzemeltetési költségekkel az ábécsváltásnál (a szófoglalás gyakran visszavezet az ASCII-ra, de ezt követően sok nem-ASCII karaktert már a segédábécséből képesek leszünk kinyerni, anélkül, hogy újból váltanánk).
Bónusz: a segédábécsé megjelölésével előtaggal 11xxxxxx és az inicializáló eltolásának beállításával 0xC0, részleges kompatibilitást kapunk a CP1252-vel. Más szóval, sok (de nem minden) nyugat-európai szöveg, amely CP1252-ben van kódolva, ugyanúgy fog kinézni UTF-C-ben.
Itt viszont felmerül egy nehézség: hogyan lehet a fő ábécéből segédábécét létrehozni? A pontos eltolást meghagyhatjuk, de — sajnos— itt a Unicode szerkezete már ellenünkre játszik. Nagyon gyakran a fő ábécé része nem a blokk elején található (például az orosz nagybetűs „A” kódja) 0x0410, bár a cirill blokk a 0x0400). Így ha az első 64 karaktert a „tartalékba” vesszük, lehet, hogy elveszítjük a betűrend hátsó részéhez való hozzáférést.
A probléma megoldásához manuálisan végigmentem néhány blokkra, amelyek különböző nyelvekhez tartoznak, és megadtam számukra a segédábcshiftet a főben. A latin betűsort, kivételként, teljesen újrarendeztem, mint a base64.
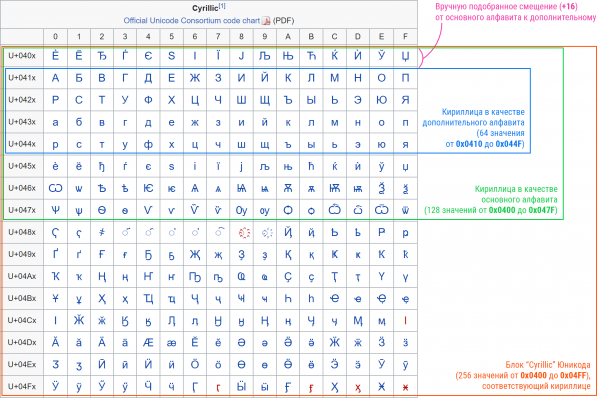
Befejezési simítások
Nézzük meg végül, hol tudunk még valamin javítani.
Észrevesszük, hogy a formátum 101xxxxx xxxxxxxx xxxxxxxx lehetővé teszi a számok kódolását egészen 0x1FFFFF, míg a Unicode hamarabb véget ér, nálunk pedig 0x10FFFF. Más szóval, az utolsó kódpontot így fogjuk megjeleníteni, mint 10110000 11111111 11111111. Így mondhatjuk, hogy ha az első bájt a következőképpen néz ki 1011xxxx (ahol — hexadecimális számjegy). Ez a hexadecimális ábrázolás a Unicode kódpontjaira a xxxx nagyobb 0), akkor valami mást jelent. Például még 15 karaktert is hozzáadhatunk, amelyek folyamatosan kódolhatók egy bájton, de én másképp döntöttem.
Nézzük a Unicode azon blokkjait, amelyek jelenleg három bájtot igényelnek. Főleg, mint már említettük, ezek kínai karakterek — de velük nehéz bármit is kezdeni, hiszen 21 ezer van belőlük. De a hiragana és katakana is elment odáig — belőlük már nem sok van, kevesebb mint kétszáz. És ha már említjük a japánokat — itt találhatók az emoji-k is (valójában sok helyen szétszórva a Unicode-ban, de az alap blokkok a tartományban 0x1F300 – 0x1FBFF). Ha arra gondolunk, hogy jelenleg léteznek olyan emoji-k, amelyek azonnal több kódpontból állnak össze (például az emoji összesen 7 kódból áll!), akkor tényleg szomorú, hogy mindegyikre három bájtot pazaroljunk (7×3 = 21 bájt egy karakterért, rémálom).
Ezért választunk ki néhány kiválasztott tartományt, amelyek az emoji-k, a hiragana és katakana számára vonatkoznak, újraszámozzuk őket egy folytonos listában és kódoljuk őket két bájtként a három helyett:
1011xxxx xxxxxxxx
Jó: a fent említett emoji 7 kódpontból áll, az UTF-8-ban 25 bájt, míg mi két bájtra sűrítettük őt 14 ( pontosan két bájt minden kódpontra). Egyébként a Habr nem volt hajlandó feldolgozni (sem a régi, sem az új szerkesztőben), ezért kép formájában kellett beilleszteni.
Próbáljuk meg javítani egy másik problémát is. Amint emlékszünk, a fő ábécé lényegében a legmagasabb 6 bit, amelyeket észben tartunk, és minden egyes dekódolt karakterhez hozzárendelünk a kód során. A kínai írásjegyek esetén, amelyek egy blokkban találhatók, 0x4E00 – 0x9FFF, ez vagy 0, vagy 1. Ez nem túl kényelmes: folyamatosan váltanunk kell az ábécét e két érték között (azaz három byte-ot kell használnunk). De vegyük észre, hogy hosszú üzemmódban a kódból le tudjuk vonni a karakterek számát, amelyet a rövid üzemmódban kódoltunk (ez 10240, miután a fent említett trükköket alkalmaztuk) — így a írásjegyek tartománya eltolódik 0x2600 – 0x77FF, és ebben az esetben az egész tartományban a legfelső 6 bit (21-ből) 0 lesz. Így az írásjegy-sorozatok minden írásjegyhez két byte-ot használnak (ami optimális egy ekkora tartományhoz), elkerülve az ábécé váltásait.
Alternatív megoldások: SCSU, BOCU-1
A Unicode szakemberei, miután elolvasták a cikk címét, valószínűleg sietve emlékeztetni fogják, hogy a Unicode szabványai között (SCSU), amely egy nagyon hasonló kódolási módot ír le, mint amit a cikkben bemutatnak.
Bevallom őszintén: a létezéséről csak mélyebben a saját megoldásom kidolgozásába merülve értesültem. Ha tudtam volna róla az elejétől fogva, valószínűleg megpróbáltam volna a megvalósítását írni a saját megközelítésem helyett.
Ami érdekes, hogy az SCSU olyan ötleteket használ, amelyek nagyon hasonlítanak azokra, amelyeket én magam is eljutottam (az »ábécék« fogalma helyett »ablakokat« használnak, és ezekből több is elérhető, mint nálam). Ugyanakkor ennek a formátumnak is vannak hátrányai: egy kicsit közelebb áll a tömörítési algoritmusokhoz, mint a kódoláshoz. Különösen a szabvány számos reprezentációs módot ad, de nem mondja el, hogyan válaszd ki a legjobbat — ehhez az encodernek valamilyen heuristikát kell alkalmaznia. Így az SCSU-encoder, amely jó csomagolást ad, bonyolultabb és terjedelmesebb lesz, mint az én algoritmusom.
Összehasonlítás végett egy viszonylag egyszerű SCSU-implementációt vittem át JavaScriptbe — a kód mennyisége összehasonlítható volt az én UTF-C-mmel, de bizonyos esetekben tízszázalékosan rosszabb eredményt mutatott (néha akár meghaladja is, de nem sokkal). Például héber és görög szövegeknél az UTF-C-t 60%-kal jobban kódolta, mint az SCSU (valószínűleg az ő kompakt ábécéik miatt). (valószínűleg a kompakt ábécéik miatt).
Meg kell említenem, hogy az SCSU mellett létezik egy másik, a Unicode tömörített reprezentálására szolgáló módszer — , de ennek célja a MIME kompatibilitás (amire nekem nem volt szükségem), és a kódolásra más megközelítést alkalmaz. Az hatásfokát nem értékeltem, de úgy gondolom, hogy valószínűleg nem lesz magasabb, mint az SCSU-é.
Lehetséges fejlesztések
Az általam bemutatott algoritmus nem univerzális tervezés alapján (ebben talán a céljaim a leginkább eltérnek a Unicode konzorcium céljaitól). Már említettem, hogy elsősorban egy feladatra (többnyelvű szótár prefixel elágazó fában történő tárolására) fejlesztették ki, és bizonyos jellemzői nem feltétlenül alkalmasak más feladatokra. De az a tény, hogy nem standard, akár előny is lehet — könnyen testreszabhatja az igényeihez.
Például nyilvánvalóan megszabadulhat a állapottól, stateless kódolást végezve — egyszerűen nem frissítve a változókat levél, auxOffs és is21Bit a kódolóban és dekódolóban. Ebben az esetben nem lehet hatékonyan csomagolni egy ábécé karaktereinek sorozatait, viszont biztosítva van, hogy ugyanaz a karakter mindig ugyanazokkal a bájtokkal van kódolva, függetlenül a kontextustól.
Ezen kívül, a kódolót egy adott nyelvhez is csiszolhatjuk, megváltoztatva az alapértelmezett állapotot — például orosz szövegek esetén beállíthatja a kódoló és dekódoló elején. offs = 0x0400 és auxOffs = 0. Különösen érdemes figyelembe venni ezt stateless módban. Összességében ez hasonló lesz a régi nyolcbites kódolás használatához, csak nem zárja ki a Unicode összes karakterének szükség szerinti beszúrását.
Egy másik korábban említett hátrány — a UTF-C-ben kódolt nagy mennyiségű szöveg esetében nincs gyors mód a legközelebbi karakter határának megtalálására egy tetszőleges bájthoz. Ha levág a kódolt pufferből mondjuk az utolsó 100 bájtot, akkor veszélybe sodorhatja magát, hogy hulladékot kap, amivel semmit sem tud kezdeni. A több gigabájtos naplók tárolására a kódolás nem lett kifejlesztve, de általában ezt lehet javítani. A bájt 0xBF soha nem lehet az első bájt, de lehet második vagy harmadik. Tehát kódolás során be lehet illeszteni a sorozatot 0xBF 0xBF 0xBF mondjuk, 10 Kb-ként — ebben az esetben elegendő a választott részletet átvizsgálni, amíg meg nem találjuk a megfelelő jelölőt. A legutolsó után 0xBF garantáltan a karakter kezdete lesz. (Dekódoláskor ezt a három bájtot figyelmen kívül kell hagyni.)
Összefoglalva
Ha eddig eljutottál — gratulálok! Remélem, te is, akárcsak én, tanultál valami újat (vagy felidézted a régit) a Unicode rendszeréről.
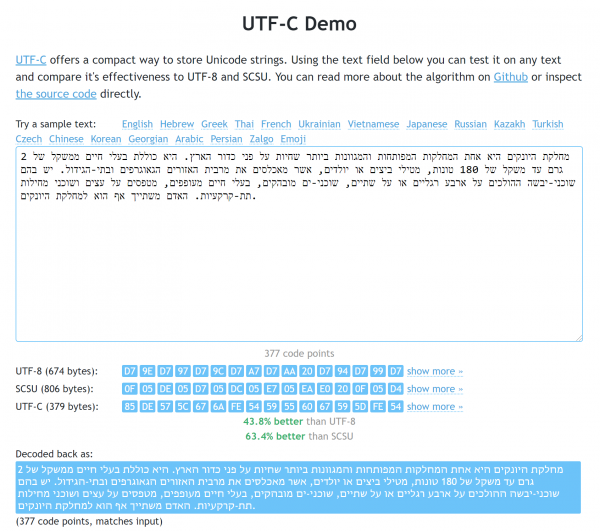
Demonstrációs oldal. A héber példáján láthatóak az UTF-8 és SCSU előnyei is.
Ne tekintsd a fent leírt kutatást a standardok megsértésének. Én azonban összességében elégedett vagyok az eredményeimmel, ezért örömmel : például a JS könyvtár tömörített formában mindössze 1710 bájt súlyú (és természetesen nincs függősége). Ahogy már említettem, a működésével megismerkedhetsz a (ott szövegek is találhatók, amelyek alapján összehasonlíthatod az UTF-8-cal és SCSU-val).
Végezetül még egyszer felhívom a figyelmet az UTF-C használatának eseteire. nem érdemes:
- Ha a soraid elég hosszúak (100-200 karaktertől). Ebben az esetben érdemes megfontolni a tömörítési algoritmusok, például a deflate alkalmazását.
- Ha szükséged van ASCII átjárhatóságra, azaz fontos számodra, hogy a kódolt szekvenciákban ne jelenjenek meg olyan ASCII kódok, amelyek nem voltak az eredeti sorban. Ezt a szükségletet elkerülheted, ha harmadik féltől származó API-kkal (például adatbázisokkal dolgozva) az eredmény kódolását absztrakt bájt halmazként adod át, nem pedig karakterláncként. Ellenkező esetben előre nem látható sebezhetőségek merülhetnek fel.
- Ha gyorsan szeretnéd megtalálni a karakterek határait tetszőleges eltolás szerint (például egy sor részének megsérülése esetén). Ezt meg lehet tenni, de csak a sor elejétől történő átvizsgálás útján (vagy a korábban említett kiegészítés alkalmazásával).
- Ha szükséged van gyors műveletek végrehajtására a karakterláncok tartalmával (sorolás, részstringek keresése, összefűzés). Ehhez a karakterláncokat először dekódolni kell, ezért az UTF-C lassabb lesz az UTF-8-nál ezekben az esetekben (de gyorsabb a tömörítő algoritmusoknál). Mivel ugyanaz a karakterlánc mindig ugyanúgy kódolódik, a pontos dekódolás összehasonlítása nem igényel, byte-onként végezhető.
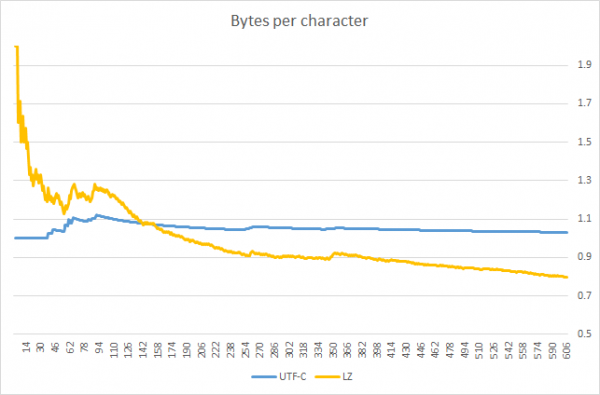
Frissítés: a felhasználó közzétettem egy ábrát, amely kiemeli az UTF-C alkalmazhatósági határait. Ezen látható, hogy az UTF-C hatékonyabb, mint a általános célú tömörítési algoritmus (LZW változatai), amíg a tömörítendő szöveg rövidebb ~140 karakter (igaz, megjegyzem, hogy az összehasonlítást egyetlen szövegen végeztük; más nyelveknél az eredmény eltérhet).
Forrás: habr.com
