

Az ASCII szabványt 1963-ban fogadták el, és ma valószínűleg senki sem használja a kódolást, amelynek első 128 karaktere eltérne az ASCII-tól. Mindazonáltal a múlt század végéig aktívan használták az EBCDIC-et – az IBM mainframe-ek és azok szovjet klónjainak, az ES EVEM-nek a szabványos kódolását. Az EBCDIC továbbra is az alapértelmezett kódolás a z/OS számára – az IBM Z modern mainframe-ek szabványos operációs rendszere.
Amit az EBCDIC-re pillantva azonnal észre lehet venni – hogy a betűk nem sorban követik egymást: a I és J és a R és S között üres pozíciók maradtak (az ES EVEM-en ezek közé a cirill karaktereket). Ki gondolt volna arra, hogy a betűket egyenlőtlen távolságokkal kódolják egymás között?
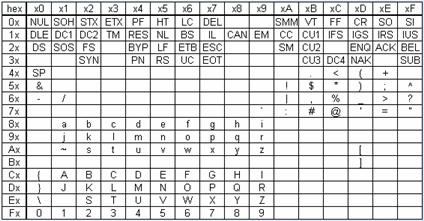
A EBCDIC név („Extended BCDIC”) arra utal, hogy ez a kódolás – a ASCII-tól eltérően – nem üres zajból született, hanem a BCDIC hat bites kódolás alapján, amelyet már használtak az (1954):
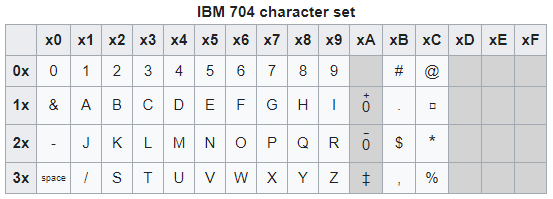
Közvetlen visszafelé kompatibilitás nincs: a BCDIC kényelmes jellemzője, amelyet az EBCDIC-re való átállás során elveszítettek, az volt, hogy a számokhoz 0—9 a 0-9 kódok tartoznak. Mindazonáltal már a BCDIC-ben is voltak hézagos pozíciók, a I és J és nyolc kód a R és S között. Honnan származnak ezek?
A (E)BCDIC története egyidős az IBM történetével – jóval az elektronikus számítógépek előtt. Az IBM négy vállalat egyesüléséből jött létre, amelyek közül a legtechnológiailag fejlettebb volt a „Tabulating Machine Company”, amelyet 1896-ban Hermann Hollerith alapított – a . Az első tabulátorok egyszerűen számolták a perforált kártyák számát, amelyek egy adott helyen perforáltak; de 1905-ben Hollerith megkezdte a tízalapú tabulátorok gyártását. Minden kártya a tízalapú tabulátorhoz változó hosszúságú mezőkből állt, és a mezőkben hagyományos tízes számrendszerben rögzített számok összeadták az egész pakliban. A kártya mezőire való felosztást a tabulátor kapcsolópultjára vezetett drótok összekapcsolásával határozták meg. Például ezen a perforált kártyán Hollerith a Kongresszus Könyvtárában, nyilvánvalóan ki van ütve a 23456789012345678 szám, ismeretlen módon osztva mezőkre:
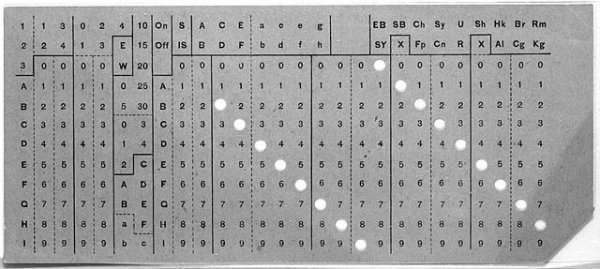
A legfigyelmesebbek észrevehették, hogy a Hollerith kártyán 12 sor van a lyukak számára, bár a számokhoz elegendő lenne tíz; míg a BCDIC-ben minden érték két legmagasabb bitje csak 12 kódot használ a 16-ból.
Természetesen ez nem véletlen egybeesés. Eredetileg Hollerith további sorokat szánt "különleges jelölések" számára, amelyeket nem összegeztek, hanem egyszerűen megszámoltak – mint a legelső táblázatkezelők esetében. (Ma úgy hívnánk őket, hogy „bitmezők”.) Ezenkívül a "különleges jelölések" között meg lehetett határozni csoportjelzőket: ha a tabulálás során nemcsak végső összegekre volt szükség, hanem közbensőkre is, a táblázat megállt, amikor észlelte bármelyik csoportjelző változását, és az operátornak át kellett írnia a közbenső összegeket a digitális táblákról papírra, nulláznia kellett a táblát, és folytatnia kellett a tabulálást. Például egy könyvelési mérleg összeállításánál a csoportoknak megfeleltetett kártyák egy dátumnak vagy egy partnernek felelhettek meg.
1920-ra, amikor Hollerith már nyugdíjba vonult, megjelentek a „nyomtató tabulátorok”, amelyek csatlakoztak a távíróhoz és önállóan tudták nyomtatni a közbenső összegyűjtéseket, anélkül, hogy az operátor beavatkozására lett volna szükség. A nehézség most az volt, hogy meghatározzuk, melyik nyomtatott számhoz mi tartozik. 1931-ben az IBM úgy döntött, hogy „különleges jelölésekkel” jelöli a betűket: a 12. sorban lévő jelölés egy betűt jelzett. A tól I, a 11. sorban egy másikat J tól R, a nulladik sorban pedig egy harmadikat S tól Z. Az új „alfabetikus tabulátor” minden kártyacsoport nevét képes volt nyomtatni a közbenső összegekkel együtt; emellett a meg nem ütött oszlop szóközzé alakult a karakterek között. Vegye észre, hogy S a 0+2 lyukak kombinációjával van jelölve, míg a 0+1 kombinációt eredetileg nem használták, félve attól, hogy két szomszédos lyuk egy oszlopban mechanikai problémákat okozhat a leolvaszóban.
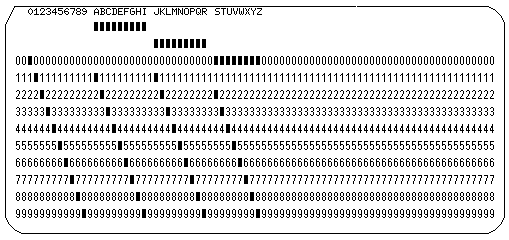
Most a BCDIC táblázatra egy kicsit más szemszögből is ránézhetünk:
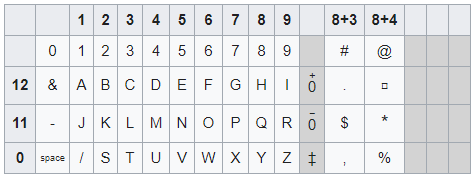
Egy kivétellel, hogy a 0 és a szóköz felcserélődött, a legmagasabb két bit megadja a „különleges jelölést”, amelyet 1931 óta ütöttek a perforált kártyába a megfelelő karakterhez; a legalsó négy bit pedig a számot határozza meg, amely a kártya fő részébe kerül. Az alábbiak szerint: & - / Az IBM táblázataiban az 1930-as években jelent meg, és ezeknek a karaktereknek a BCDIC kódolása megfelel a lyukakban lévő kombinációknak. Amikor még több karakter támogatására volt szükség, akkor a megerősítés érdekében egy extra 'speciális jelölést' alakítottak ki, amely lehetővé tette, hogy egy oszlopban akár három lyuk található legyen. Ez a perforált kártyák formátuma gyakorlatilag változatlan maradt a század végéig. A Szovjetunióban az IBM latin karaktereinek és írásjeleinek kódolását megtartották, míg a cirill betűk esetében több 'speciális jelölést' is lyukasztottak a 12-es, 11-es és 0-ás sorokban - nem korlátozva magukat három lyukra egy oszlopban.
Amikor az IBM 704 számítógép készült, nem foglalkoztak sokáig a karakterek kódolásával: egyszerűen átvették a már akkor a perforált kártyákban használt kódolást, és csak a 0-t 'helyére tették'. 1964-ben, amikor a BCDIC-ről EBCDIC-ra váltottak, a karakterek alsó négy bitje változatlan maradt, bár a felső bitek némileg megváltoztak. Így a Hollerith által a múlt század elején kiválasztott perforált kártya formátuma hatással volt az összes IBM számítógép architektúrájára, beleértve az IBM Z-t is.
Forrás: habr.com
