

A magas teljesítmény a nagy adatokkal való munkavégzés egyik kulcsfontosságú követelménye. A Sber adatok betöltésének kezelésével foglalkozó csapatában szinte minden tranzakciót az Hadoop alapú Adatfelhőnkbe irányítunk, ezért valóban nagy információs áramlatokkal dolgozunk. Természetesen folyamatosan keressük a teljesítmény növelésének módjait, és most elmondjuk, hogyan sikerült javítani az HBase RegionServer és az HDFS-ügyfél teljesítményét, aminek köszönhetően jelentősen megnöveltük az olvasási műveletek sebességét.
Mielőtt azonban a módosítások lényegére térnénk, érdemes megemlíteni a korlátokat, amelyeket nem lehet kikerülni, ha HDD-n dolgozunk.
Miért inkompatibilis a HDD a gyors véletlenszerű olvasásokkal
A köztudott, hogy az HBase és sok más adatbázis blokkba tárolja az adatokat, több tízkilobájtos méretben. Alapbeállítás szerint ez körülbelül 64 KB. Most képzeljük el, hogy mindössze 100 bájtot szeretnénk lekérni, és megkérjük az HBase-t, hogy adja meg nekünk ezeket az adatokat egy kulcs alapján. Mivel az HFiles blokk mérete 64 KB, 640-szer annyit kell kérnünk, mint amennyi szükséges.
Ezen kívül, mivel a kérés az HDFS-en keresztül és a metaadatok gyorsítótár mechanizmusán át fog zajlani ShortCircuitCache (amely lehetővé teszi a fájlokhoz való közvetlen hozzáférést), ez már 1 MB leolvasásához vezet a lemezről. Ezt a paramétert azonban lehet szabályozni dfs.client.read.shortcircuit.buffer.size és sok esetben érdemes csökkenteni ezt az értéket, például 126 KB-ra.
Tegyük fel, hogy megcsináljuk ezt, de amikor elkezdünk adatokat olvasni a java API-n keresztül, olyan funkciókkal, mint a FileChannel.read, és megkérjük az operációs rendszert, hogy olvassa el a megadott mennyiségű adatot, az 'óvatosságból' 2-szer annyit olvas, azaz 256 KB-ot a mi esetünkben. Ez azért történik, mert a java-ban nincs egyszerű lehetőség a FADV_RANDOM zászló beállítására, amely megakadályozza ezt a viselkedést.
Ennek következtében, hogy megkapjuk a 100 bájtunkat, a háttérben 2600-szor többet olvasnak be. Úgy tűnik — a megoldás nyilvánvaló, csökkentsük a blokk méretét egy kilobájt-ra, állítsuk be a már említett zászlót, és elérjük a nagyobb sebességet. De a probléma az, hogy ha a blokk méretét a felére csökkentjük, azzal az egyszerre kiolvasott bájtok számát is a felére csökkentjük.
A bizonyos nyereséget, amely a FADV_RANDOM zászló kihelyezéséből származhat, csak nagy párhuzamosítás esetén érhetjük el, és a blokk mérete minimum 128 Kb legyen, de ez maximum néhány tizedszázalék:
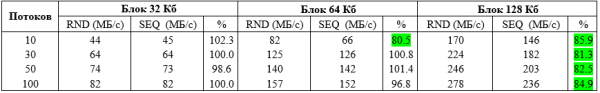
A teszteket 100 fájlon végezték, mindegyik 1 GB méretű és 10 HDD lemezen tárolva.
Nézzük meg, mire számíthatunk ilyen sebességgel:
Tegyük fel, hogy 10 lemezről 280 MB/s sebességgel olvasunk, azaz 3 millió alkalommal 100 byte-ot. De ahogy emlékszünk, az adataink 2600-szor ritkábban fordulnak elő, mint ahányat leolvasunk. Tehát 3 milliót elosztunk 2600-zal, és kapunk 1100 bejegyzést másodpercenként.
Szomorú, nem igaz? Ilyen a természet véletlenszerű hozzáférés az adatokhoz HDD-n — függetlenül a blokk méretétől. Ez a véletlenszerű hozzáférés fizikai határa, és ilyen körülmények között egyetlen adatbázis sem tud többet kihozni belőle.
Hogyan érhetik el tehát a adatbázisok sokkal magasabb sebességet? Ennek a kérdésnek a megválaszolásához nézzük meg, mi történik a következő ábrán:
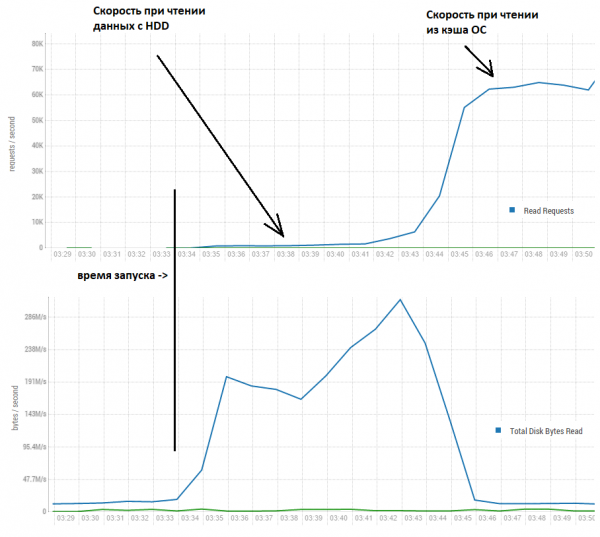
Itt látjuk, hogy az első néhány percben a sebesség valóban körülbelül ezer bejegyzés másodpercenként. Azonban később, annak köszönhetően, hogy sokkal többet olvasunk ki, mint amennyit kérjük, az adatok a buff/cache memóriába (Linux) jutnak, és a sebesség 60 ezerre nő másodpercenként.
Ezért a továbbiakban csak a memóriában kapható adatok gyorsabb hozzáférésével foglalkozunk, amelyek már a rendszer cache-jében találhatók, vagy hasonló sebességű tárolóeszközök, mint például SSD/NVMe.
A mi esetünkben a teszteket 4 szerverből álló konfiguráción végezzük, mindegyik a következőképpen van felszerelve:
CPU: Xeon E5-2680 v4 @ 2.40GHz 64 szál.
Memória: 730 GB.
Java verzió: 1.8.0_111
És itt van a kulcsmomentum — az adatok mennyisége a táblázatokban, amelyeket olvasni kell. Az a helyzet, hogy ha az adatokat olyan táblázatból olvassuk, amely teljes egészében elfér a HBase cache-jében, akkor a buff/cache-a az operációs rendszerből egyáltalán nem fog leolvasni. Ugyanis a HBase alapértelmezés szerint a memória 40%-át a BlockCache nevű struktúra számára tartja fenn. Ez tulajdonképpen egy ConcurrentHashMap, ahol a kulcs a fájl neve + blokk offset, míg az érték maga az adatok az adott eltolódáshoz.
Ezért, amikor az olvasás csak ebből a struktúrából történik, mi , minte egy millió lekérdezés másodpercenként. De képzeljük el, hogy nem adhatunk át több száz gigabájtnyi memóriát csak az adatbázisok szükségletei miatt, mert ezeken a szervereken sok más hasznos dolog is fut.
Például az esetünkben a BlockCache mérete egy RS-nél körülbelül 12 GB. Két RS-t telepítettünk egy node-ra, tehát a BlockCache-re összesen 96 GB áll rendelkezésre az összes node-on. Az adatok pedig sokszorosan nagyobbak, például legyen négy tábla, 130 régióval, ahol a fájlok mérete 800 MB, FAST_DIFF tömörítéssel, tehát összesen 410 GB (ez tiszta adat, a replikációs tényező figyelembevételével nélkül).
Így a BlockCache csak körülbelül 23%-át teszi ki az összes adat térfogatának, és ez sokkal közelebb áll a BigData valós körülményeihez. És itt kezdődik a legérdekesebb rész — nyilvánvaló, minél kevesebb találat van a cache-ben, annál rosszabb a teljesítmény. Mert ha hibázunk, hatalmas munkát kell elvégezni — tehát le kell hívni a rendszerfunkciókat. De ezt nem lehet elkerülni, így nézzük meg egy teljesen más aspektust — mi történik az adatokkal a cache-en belül?
Egyszerűsítsük a helyzetet, és tegyük fel, hogy van egy cache, amelybe csak egy objektum fér el. Itt egy példa arra, hogy mi történik, ha a cache méretének háromszorosával próbálunk dolgozni:
1. Az 1-es blokk behelyezése a cache-be
2. Az 1-es blokk eltávolítása a cache-ből
3. A 2-es blokk behelyezése a cache-be
4. A 2-es blokk eltávolítása a cache-ből
5. A 3-as blokk behelyezése a cache-be
Öt műveletet hajtottunk végre! Azonban ezt a helyzetet normálisnak nem nevezhetjük, valójában arra kényszerítjük az HBase-t, hogy rengeteg teljesen haszontalan munkát végezzen. Folyamatosan olvassa ki az adatokat az operációs rendszer cache-ből, behelyezi azokat a BlockCache-be, majd szinte azonnal kidobja őket, mert újabb adatcsomag érkezett. A poszt elején található animáció szemlélteti a probléma lényegét — a Garbage Collector túlterhelődik, a légkör felmelegszik, a kicsi Greta, Svédország távoli és forró részén, csalódott. Mi, informatikai szakemberek nem szeretjük, amikor a gyerekek szomorúak, ezért elkezdünk gondolkodni rajta, mit lehetne tenni ezzel.
Mi lenne, ha nem minden blokkot helyeznénk be a cache-be, hanem csak egy bizonyos százalékot belőlük, úgy, hogy a cache ne telítődjön? Kezdésként egyszerűen csak adjunk hozzá néhány sort a BlockCache-be való adatbehelyezés funkció elejéhez:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
A lényeg az, hogy az offset a blokk elhelyezkedése a fájlban, és az utolsó számjegyek véletlenszerűen és egyenletesen oszlanak el 00 és 99 között. Így csak azokat fogjuk kihagyni, amelyek a kívánt tartományba esnek.
Például állítsuk be a cacheDataBlockPercent értékét 20-ra, és nézzük meg, mi történik:
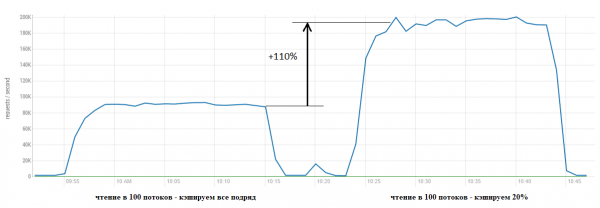
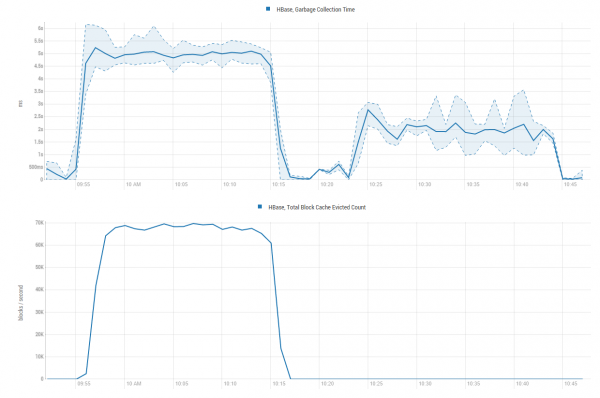
Az eredmény nyilvánvaló. Az alábbi grafikonokon világossá válik, hogy mi okozza ezt a sebességnövekedést — rengeteg GC erőforrást takarítunk meg azzal, hogy nem végezzük el a sziszifuszi munkát az adatok gyorsítótárba helyezésével, csak azért, hogy aztán azokat gyorsan kidobjuk a marsi kutyák alá:
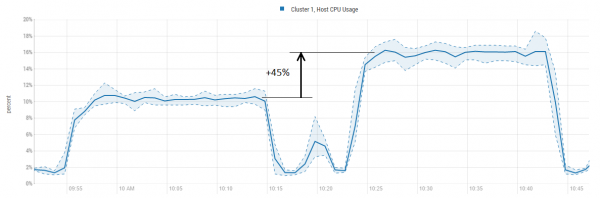
A CPU kihasználtsága ezzel együtt nő, de jóval kisebb mértékben, mint a teljesítmény:
Itt érdemes megemlíteni, hogy a BlockCache-ben tárolt blokkok különbözőek lehetnek. A blokkok körülbelül 95%-a ténylegesen adatok. A fennmaradó rész metainformációk, például Bloom szűrők vagy LEAF_INDEX és . Ezek az adatok kevésbé számottevők, de nagyon hasznosak, mivel mielőtt közvetlenül elérjük az adatokat, az HBase a meta adatokhoz fordul, hogy megértse, szükséges-e tovább keresni, és ha igen, akkor pontosan hol található a keresett blokk.
Ezért a kódban látjuk, hogy van egy feltételes ellenőrzés buf.getBlockType().isData() és ennek köszönhetően a meta adatok bármikor a gyorsítótárban maradnak.
Most növeljük a terhelést, és egy kicsit feltuningoljuk a funkciót is. Az első tesztben a vágási százalék = 20 volt, és a BlockCache kicsit alulhasznált volt. Most állítsuk be 23%-ra, és 5 percenként 100 szálat fogunk hozzáadni, hogy lássuk, mikor következik be a telítődő állapot:
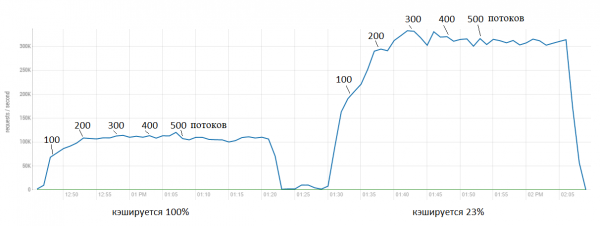
Itt látjuk, hogy az eredeti verzió szinte azonnal a körülbelül 100 ezer lekérdezés másodpercenkénti plafonjába ütközik. Ezzel szemben a patch 300 ezerig gyorsít. Ugyanakkor világos, hogy a további gyorsítás már nem annyira „ingyenes”, a CPU kihasználtsága is növekszik.
Viszont ez nem túl elegáns megoldás, mivel előre nem tudjuk, hogy hány százalék blokkokat kell gyorsítótárazni, ez a terhelési profiltól függ. Ezért egy automatikus beállító mechanizmust valósítottunk meg, amely az olvasási műveletek aktivitása alapján állítja be ezt a paramétert.
Ehhez három paramétert adtunk hozzá:
hbase.lru.cache.heavy.eviction.count.limit — meghatározza, hányszor kellene elindítani a blokkok eltávolítási folyamatát a gyorsítótárból, mielőtt elkezdenénk használni az optimalizálást (azaz átugrani a blokkokat). Alapértelmezés szerint MAX_INT = 2147483647, ami lényegében azt jelenti, hogy ez a funkció soha nem fog működni ilyen értéknél. Mivel a blokkok eltávolítása 5-10 másodpercenként történik (ez a terheléstől függ), és 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 év. Azonban beállíthatjuk ezt a paramétert 0-ra, és azonnal működésbe hozhatjuk a funkciót.
Mindazonáltal van hasznos információ ebben a paraméterben. Ha a terhelésünk olyan típusú, hogy folyamatosan váltakoznak a rövid távú olvasások (mondjuk nappal) és a hosszú távúak (éjszaka), akkor lehetőség van arra, hogy a funkció csak akkor induljon el, amikor hosszú távú olvasási műveletek zajlanak.
Például tudjuk, hogy a rövid távú olvasások általában körülbelül 1 percig tartanak. Nem kellene elkezdenünk eltávolítani a blokkokat, mivel a gyorsítótár nem fog elavulni, és például beállíthatjuk ezt a paramétert 10-re. Ez azt eredményezi, hogy az optimalizálás csak akkor kezdődne el, amikor megkezdődnek a hosszú távú aktív olvasások, azaz 100 másodperc múlva. Így, ha rövid távú olvasásunk van, akkor az összes blokk a gyorsítótárba kerül, és elérhetővé válik (kivéve azokat, amelyeket a szabványos algoritmus eltávolít). Amikor hosszú távú olvasásokat végzünk, a funkció bekapcsol és sokkal magasabb teljesítményt érünk el.
hbase.lru.cache.heavy.eviction.mb.size.limit — meghatározza, hány megabájtot szeretnénk elhelyezni a gyorsítótárban (és természetesen eltávolítani) 10 másodperc alatt. A funkció megpróbálja elérni és fenntartani ezt az értéket. Az a lényeg, hogy ha gigabájtokat töltenek a gyorsítótárba, akkor gigabájtokat is kell eltávolítanunk, ami, mint láttuk, meglehetősen költséges. Azonban nem kellene túl kicsire beállítani, mert ez korai kilépéshez vezethet a blokkok átugrási módjából. Erősebb szerverek esetén (20-40 fizikai mag) optimálisan 300-400 MB körüli értéket célszerű megadni. Középkategóriás rendszerek (~10 mag) esetén 200-300 MB. Gyenge rendszerek (2-5 mag) esetén 50-100 MB elfogadható lehet (ezeken nem teszteltük).
Nézzük meg, hogyan működik: tegyük fel, hogy beállítottuk a hbase.lru.cache.heavy.eviction.mb.size.limit = 500 értéket, van valamilyen terhelés (olvasás), és akkor körülbelül 10 másodpercenként kiszámítjuk, hány bájtot szabadítottunk fel a következő képlettel:
Overhead = Szabad Bytes Összeg (MB) * 100 / Limit (MB) — 100;
Ha a valóságban 2000 MB-t szabadítottunk fel, akkor az Overhead értéke a következő lesz:
2000 * 100 / 500 — 100 = 300%
Az algoritmusok próbálnak úgy működni, hogy ne legyen több, mint néhány tucat százalék, így a funkció csökkenti a gyorsítótárazott blokkok százalékát, ezzel megvalósítva az automatikus hangolás mechanizmusát.
Ha azonban a terhelés csökkent, tegyük fel, hogy csak 200 MB-t szabadítottunk fel, és az Overhead negatívvá vált (úgynevezett overshooting):
200 * 100 / 500 — 100 = -60%
Akkor a funkció éppen ellenkezőleg, növelni fogja a gyorsítótárazott blokkok százalékát, amíg az Overhead pozitívvá nem válik.
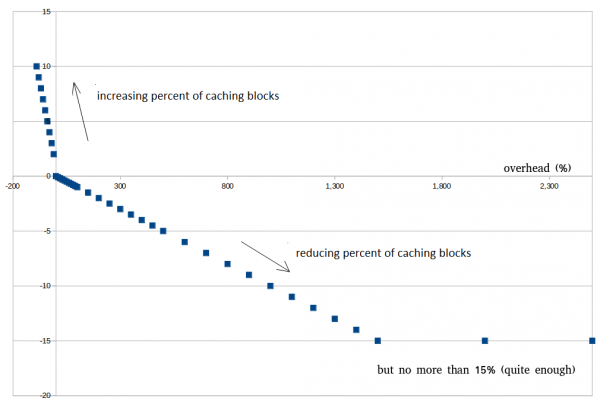
Az alábbi példa megmutatja, hogyan néz ki ez valós adatokkal. Ne próbáljunk meg 0%-ot elérni, ez lehetetlen. Nagyon jó, ha körülbelül 30 — 100% között van, ez segít elkerülni az optimalizálási mód előző időben való megszűnését rövid távú csúcslépéskor.
hbase.lru.cache.heavy.eviction.overhead.coefficient — beállítja, milyen gyorsan szeretnénk eredményeket kapni. Ha biztosan tudjuk, hogy az olvasásaink többsége hosszú ideig tart, és nem akarunk várni, növelhetjük ezt a koefficienst, hogy gyorsabban érjünk el nagy teljesítményt.
Például beállítottuk ezt a koefficienst = 0.01. Ez annyit jelent, hogy az Overhead (lásd fent) ezt a számot szorozva csökkenti a gyorsítótárazott blokkok százalékát. Tegyük fel, hogy az Overhead = 300%, és a koefficiens = 0.01, akkor a gyorsítótárazott blokkok százaléka 3%-kal csökken.
Hasonló logika «Backpressure» — megvalósítva van a negatív Overhead értékekre (overshooting). Mivel mindig lehetségesek rövid távú ingadozások az olvasási-kiürítési volumenben, ez a mechanizmus lehetővé teszi az optimalizálási mód előrehozott megszűnésének elkerülését. A Backpressure fordított logikát alkalmaz: minél erősebb az overshooting, annál több blokk kerül gyorsítótárazásra.
A megvalósító kód
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict() / 1024 / 1024;
        /*
        * Néha több adatot olvasunk, mint amit a BlockCache elbír,
        * ez a magas elutasítási arányt eredményezi.
        * Ez pedig intenzív Garbage Collector munkát igényel.
        * Sok blokk kerül a BlockCache-be, de soha nem olvassák el,
        * ugyanakkor sok CPU-erőforrást fogyasztanak.
        * Itt elemezni fogjuk, hogy hány byte szabadult fel, és döntenünk kell,
        * hogy eljött-e az idő, hogy csökkentsük a cache blokkjainek számát.
        * Ez segít elkerülni, hogy túl sok blokk kerüljön a BlockCache-be,
        * amikor az evict() nagyon aktív és megtakarítja a CPU-t más feladatokra.
        * További részletek: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // Először is ellenőriznünk kell, hogy mennyi idő telt el
        // az előző evict() végrehajtása óta.
        // Ennek szinte ugyanannyi időnek kell lennie (+/- 10s)
        // mert minden alkalommal összehasonlítható mennyiségű szabad byte-ot kapunk.
        // 10s, mert ez az alapértelmezett időszak az evict() futtatására (lásd fentebb this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Itt ki kell számolnunk, hogy milyen helyzetben vagyunk.
          // Van a "hbase.lru.cache.heavy.eviction.bytes.size.limit" határértékünk,
          // és kiszámíthatjuk a túlterhelést.
          // Ezt az információt fogjuk használni a döntéshez,
          // hogy hogyan változtassuk meg a cache blokkjainek arányát.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Most abban a helyzetben vagyunk, hogy meghaladtuk a határt.
            // De lehet, hogy figyelmen kívül hagyjuk, mert ez hamarosan véget ér.
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // Ez már régóta tart, és most csökkentenünk kell a cache
              // blokkjainek számát. Itt kiszámoljuk, hogy hány blokkot szeretnénk kihagyni.
              // Ez a következőktől függ:
              // 1. Túlterhelés - ha a túlterhelés nagy, akkor agresszívabban
              // csökkenthetjük a cache blokkjainek számát.
              // 2. Milyen gyorsan szeretnénk elérni az eredményt. Ha tudjuk, hogy a
              // nehéz olvasás hosszú ideje tart, nem akarunk várni, és növelhetjük
              // a tényezőt, és viszonylag gyors teljesítményt érhetünk el.
              // De ha nem vagyunk biztosak benne, hogy ezt lassan tehetjük, és ez megakadályozhatja
              // a korai kilépést ebből a módból. Szóval, amikor a tényező
              // magasabb, jobb teljesítményt érhetünk el, amikor a nehéz olvasás stabil.
              // De amikor az olvasás változik, alkalmazkodhatunk ehhez, és beállíthatjuk
              // a tényezőt alacsonyabb értékre.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // De a gyakorlat azt mutatja, hogy a 15%-os csökkentés elég.
              // Nem vagyunk kapzsik (ez korai kilépést eredményezhet).
              change = Math.min(15, change);
              change = Math.max(0, change); // Gondolom, ez soha nem fog megtörténni, de ellenőrizzük.
              // Szóval ez a kulcspont, itt csökkentjük a cache blokkjainek arányát.
              cache.cacheDataBlockPercent -= change;
              // Ha túlságosan lemegyünk, itt meg kell állnunk, 1% mindenképp legyen.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Nos, túlléptük az értéket.
            // Lehet, hogy ez csak rövid távú ingadozás, és maradhatunk ebben a módban.
            // Ez segít elkerülni a korai kilépést rövid távú ingadozás esetén.
            // Ha a túllépés kevesebb mint 90%, próbálunk növelni a cache blokkjainek
            // arányát, és reméljük, hogy ez elegendő lesz.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Egyszerű logika: minél nagyobb a túllépés, annál több cache blokk (visszaáramlás)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // De nem lehet ez több mint 100%, szóval ellenőrizzük.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Úgy tűnik, hogy a nehéz olvasás véget ért.
              // Csak lépjünk ki ebből a módból.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache elutasítva (MB): {}, túlterhelés (%): {}, " +
            "nehéz elutasítási számláló: {}, " +
            "jelenlegi cache DataBlock (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Most nézzük meg mindezt egy valós példán. Van egy következő tesztelési forgatókönyvünk:
- Kezdjük el a Scan-t (25 szál, batch = 100)
- 5 perc elteltével hozzáadjuk a multi-gets-t (25 szál, batch = 100)
- 5 perc elteltével kikapcsoljuk a multi-gets-t (újra csak a scan marad)
Két futtatást végzünk, először hbase.lru.cache.heavy.eviction.count.limit = 10000 (ami lényegében kikapcsolja a funkciót), majd beállítjuk a limit = 0 (ami bekapcsolja).
Az alábbi naplókban látjuk, hogyan kapcsolódik be a funkció, és az Overshooting 14-71%-ra csökken. Időnként a terhelés csökken, ami aktiválja a Backpressurét, és az HBase újra több blokkot cache-el.
RegionServer napló
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 2170, ratio 1.09, overhead (%): 985, heavy eviction counter: 1, current caching DataBlock (%): 91 < start
evicted (MB): 3763, ratio 1.08, overhead (%): 1781, heavy eviction counter: 2, current caching DataBlock (%): 76
evicted (MB): 3306, ratio 1.07, overhead (%): 1553, heavy eviction counter: 3, current caching DataBlock (%): 61
evicted (MB): 2508, ratio 1.06, overhead (%): 1154, heavy eviction counter: 4, current caching DataBlock (%): 50
evicted (MB): 1824, ratio 1.04, overhead (%): 812, heavy eviction counter: 5, current caching DataBlock (%): 42
evicted (MB): 1482, ratio 1.03, overhead (%): 641, heavy eviction counter: 6, current caching DataBlock (%): 36
evicted (MB): 1140, ratio 1.01, overhead (%): 470, heavy eviction counter: 7, current caching DataBlock (%): 32
evicted (MB): 913, ratio 1.0, overhead (%): 356, heavy eviction counter: 8, current caching DataBlock (%): 29
evicted (MB): 912, ratio 0.89, overhead (%): 356, heavy eviction counter: 9, current caching DataBlock (%): 26
evicted (MB): 684, ratio 0.76, overhead (%): 242, heavy eviction counter: 10, current caching DataBlock (%): 24
evicted (MB): 684, ratio 0.61, overhead (%): 242, heavy eviction counter: 11, current caching DataBlock (%): 22
evicted (MB): 456, ratio 0.51, overhead (%): 128, heavy eviction counter: 12, current caching DataBlock (%): 21
evicted (MB): 456, ratio 0.42, overhead (%): 128, heavy eviction counter: 13, current caching DataBlock (%): 20
evicted (MB): 456, ratio 0.33, overhead (%): 128, heavy eviction counter: 14, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 15, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 16, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.31, overhead (%): 71, heavy eviction counter: 17, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.3, overhead (%): 14, heavy eviction counter: 18, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.29, overhead (%): 14, heavy eviction counter: 19, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.27, overhead (%): 14, heavy eviction counter: 20, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.25, overhead (%): 14, heavy eviction counter: 21, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.24, overhead (%): 14, heavy eviction counter: 22, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.22, overhead (%): 14, heavy eviction counter: 23, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.21, overhead (%): 14, heavy eviction counter: 24, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.2, overhead (%): 14, heavy eviction counter: 25, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.17, overhead (%): 14, heavy eviction counter: 26, current caching DataBlock (%): 19
eltávolítva (MB): 456, arány 0.17, többlet (%): 128, magas eltávolítási számláló: 27, aktuális cachelési DataBlock (%): 18 < hozzáadott szerzések (de a táblázat ugyanaz)
eltávolítva (MB): 456, arány 0.15, többlet (%): 128, magas eltávolítási számláló: 28, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 342, arány 0.13, többlet (%): 71, magas eltávolítási számláló: 29, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 342, arány 0.11, többlet (%): 71, magas eltávolítási számláló: 30, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 342, arány 0.09, többlet (%): 71, magas eltávolítási számláló: 31, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 228, arány 0.08, többlet (%): 14, magas eltávolítási számláló: 32, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 228, arány 0.07, többlet (%): 14, magas eltávolítási számláló: 33, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 228, arány 0.06, többlet (%): 14, magas eltávolítási számláló: 34, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 228, arány 0.05, többlet (%): 14, magas eltávolítási számláló: 35, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 228, arány 0.05, többlet (%): 14, magas eltávolítási számláló: 36, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 228, arány 0.04, többlet (%): 14, magas eltávolítási számláló: 37, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 109, arány 0.04, többlet (%): -46, magas eltávolítási számláló: 37, aktuális cachelési DataBlock (%): 22 < vissza nyomás
eltávolítva (MB): 798, arány 0.24, többlet (%): 299, magas eltávolítási számláló: 38, aktuális cachelési DataBlock (%): 20
eltávolítva (MB): 798, arány 0.29, többlet (%): 299, magas eltávolítási számláló: 39, aktuális cachelési DataBlock (%): 18
eltávolítva (MB): 570, arány 0.27, többlet (%): 185, magas eltávolítási számláló: 40, aktuális cachelési DataBlock (%): 17
eltávolítva (MB): 456, arány 0.22, többlet (%): 128, magas eltávolítási számláló: 41, aktuális cachelési DataBlock (%): 16
eltávolítva (MB): 342, arány 0.16, többlet (%): 71, magas eltávolítási számláló: 42, aktuális cachelési DataBlock (%): 16
eltávolítva (MB): 342, arány 0.11, többlet (%): 71, magas eltávolítási számláló: 43, aktuális cachelési DataBlock (%): 16
eltávolítva (MB): 228, arány 0.09, többlet (%): 14, magas eltávolítási számláló: 44, aktuális cachelési DataBlock (%): 16
eltávolítva (MB): 228, arány 0.07, többlet (%): 14, magas eltávolítási számláló: 45, aktuális cachelési DataBlock (%): 16
eltávolítva (MB): 228, arány 0.05, többlet (%): 14, magas eltávolítási számláló: 46, aktuális cachelési DataBlock (%): 16
eltávolítva (MB): 222, arány 0.04, többlet (%): 11, magas eltávolítási számláló: 47, aktuális cachelési DataBlock (%): 16
eltávolítva (MB): 104, arány 0.03, többlet (%): -48, magas eltávolítási számláló: 47, aktuális cachelési DataBlock (%): 21 < megszakított szerzések
eltávolítva (MB): 684, arány 0.2, többlet (%): 242, magas eltávolítási számláló: 48, aktuális cachelési DataBlock (%): 19
eltávolítva (MB): 570, arány 0.23, többlet (%): 185, magas eltávolítási számláló: 49, aktuális cachelési DataBlock (%): 18
eltávolítva (MB): 342, arány 0.22, többlet (%): 71, magas eltávolítási számláló: 50, aktuális cachelési DataBlock (%): 18
eltávolítva (MB): 228, arány 0.21, többlet (%): 14, magas eltávolítási számláló: 51, aktuális cachelési DataBlock (%): 18
eltávolítva (MB): 228, arány 0.2, többlet (%): 14, magas eltávolítási számláló: 52, aktuális cachelési DataBlock (%): 18
eltávolítva (MB): 228, arány 0.18, többlet (%): 14, magas eltávolítási számláló: 53, aktuális cachelési DataBlock (%): 18
eltávolítva (MB): 228, arány 0.16, többlet (%): 14, magas eltávolítási számláló: 54, aktuális cachelési DataBlock (%): 18
eltávolítva (MB): 228, arány 0.14, többlet (%): 14, magas eltávolítási számláló: 55, aktuális cachelési DataBlock (%): 18
eltávolítva (MB): 112, arány 0.14, többlet (%): -44, magas eltávolítási számláló: 55, aktuális cachelési DataBlock (%): 23 < vissza nyomás
eltávolítva (MB): 456, arány 0.26, többlet (%): 128, magas eltávolítási számláló: 56, aktuális cachelési DataBlock (%): 22
eltávolítva (MB): 342, arány 0.31, többlet (%): 71, magas eltávolítási számláló: 57, aktuális cachelési DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 58, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 59, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 60, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 61, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 62, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 63, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.32, overhead (%): 71, nagy terhelésű eltávolítási számláló: 64, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 65, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 66, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.32, overhead (%): 71, nagy terhelésű eltávolítási számláló: 67, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 68, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.32, overhead (%): 71, nagy terhelésű eltávolítási számláló: 69, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.32, overhead (%): 71, nagy terhelésű eltávolítási számláló: 70, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 71, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 72, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 73, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 74, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 75, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 342, arány 0.33, overhead (%): 71, nagy terhelésű eltávolítási számláló: 76, jelenlegi cache DataBlock (%): 22
eltávolított (MB): 21, arány 0.33, overhead (%): -90, nagy terhelésű eltávolítási számláló: 76, jelenlegi cache DataBlock (%): 32
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
A szkennelés célja az volt, hogy bemutassa ugyanazt a folyamatot egy grafikon formájában, amely a cache két részének arányát mutatja – single (ahova azok a blokkok kerülnek, amelyeket még senki nem kért) és multi (itt tárolják az "egyszer már kért" adatokat):
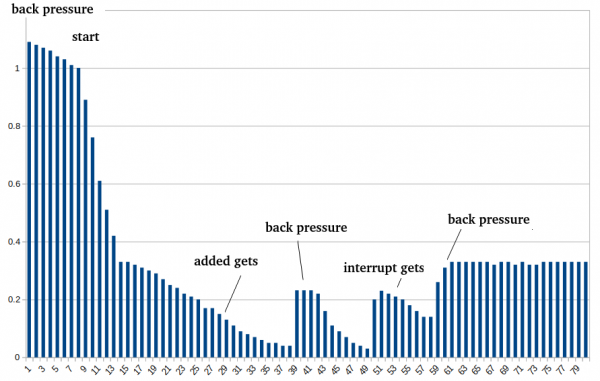
Végül így néz ki a paraméterek működése grafikon formájában. Összehasonlításképpen, a cache teljesen ki volt kapcsolva az elején, majd elindult az HBase cache-eléssel és 5 perces optimalizálási késedelmet állítottak be (30 eltávolítási ciklus).
A teljes kód a Pull Request-ben található a githubon.
azonban a 300 ezer olvasás másodpercenként nem minden, amit ki lehet hozni ezen a hardveren ezekben a körülmények között. Az a helyzet, hogy amikor az adatokhoz HDFS-en keresztül kell hozzáférni, a ShortCircuitCache ( SSC ) mechanizmus használatban van, ami lehetővé teszi az adatok közvetlen elérését, elkerülve a hálózati interakciókat.
A profilálás azt mutatta, hogy ez a mechanizmus ugyan nagy nyereséget ad, de valamikor szűk keresztmetszetté válik, mert szinte minden nehéz művelet a lock belsejében zajlik, ami a blokkolásokhoz vezet az idő nagy részében.
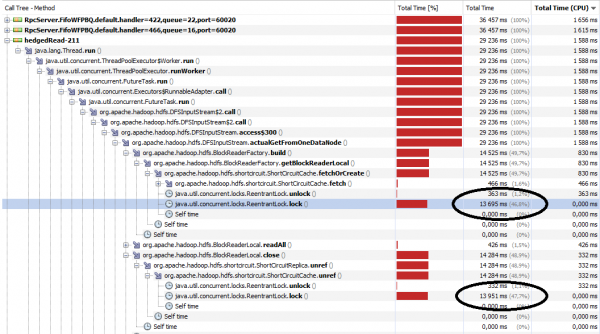
Ennek tudatában rájöttünk, hogy a problémát meg lehet kerülni, ha létrehozunk egy független SSC tömböt:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
Ezután ezzel fogunk dolgozni, kizárva a keresztmetszeteket az offset utolsó számjegye alapján is:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Most már indulhatunk a tesztekkel. Ehhez egyszerű, többlépcsős alkalmazással olvassuk a fájlokat HDFS-ből. Beállítjuk a paramétereket:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // alapértelmezés = 1 MB, ami jelentősen lelassítja az olvasást, ezért jobb a valós igényekhez igazítani
conf.set("dfs.client.short.circuit.num", num); // 1-től 10-ig
És egyszerűen csak olvassuk a fájlokat:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Ez a kód külön szálakban fut, és növelni fogjuk a párhuzamosan olvasott fájlok számát (10-től 200-ig – vízszintes tengely) és a cache-ek számát (1-től 10-ig – grafikonok). A függőleges tengely a SSC növelésének gyorsulását mutatja ahhoz képest, amikor csak egy cache van.
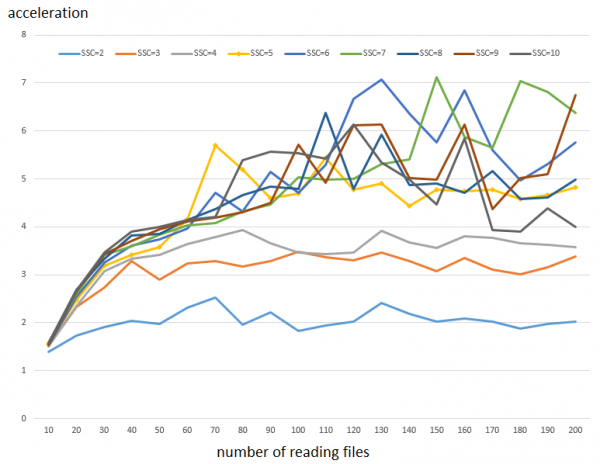
A grafikon olvasása: 100 ezer olvasás 64 KB-os blokkokban egy cache-sel 78 másodpercet igényel. Ezzel szemben 5 cache-vel ez 16 másodperc alatt megvalósítható. Tehát körülbelül 5-szörös gyorsulás tapasztalható. A grafikonból látható, hogy kisebb párhuzamos olvasásoknál a hatás nem annyira észlelhető, ez akkor kezd jelentősen számítani, amikor az olvasó szálak száma meghaladja az 50-et. Az is megfigyelhető, hogy a SSC számának 6-ra és afölé növelése lényegesen kevesebb teljesítménynövekedést eredményez.
Megjegyzés 1: Mivel a tesztelési eredmények elég volatilisek (lásd alább), 3 futást végeztünk, és az eredményeket átlagoltuk.
Megjegyzés 2: A véletlenszerű hozzáférés beállításából származó teljesítménynövekedés hasonló, bár maga a hozzáférés kicsit lassabb.
Fontos azonban megjegyezni, hogy az HBase esetével ellentétben ez a gyorsulás nem mindig ingyenes. Itt inkább "felszabadítjuk" a CPU lehetőségeit a feladat végrehajtására, ahelyett, hogy a zárolások miatt leállnánk.
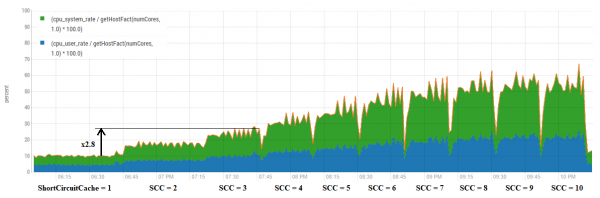
Megfigyelhető, hogy általában a cache-ek számának növelése körülbelül arányos növekedést eredményez a CPU kihasználtságában. Ugyanakkor vannak még néhány kedvezőbb kombináció.
Például nézzük meg alaposabban az SSC = 3 beállítást. A teljesítménynövekedés körülbelül 3,3-szoros. Az alábbiakban az összes három különböző futás eredményeit láthatjuk.
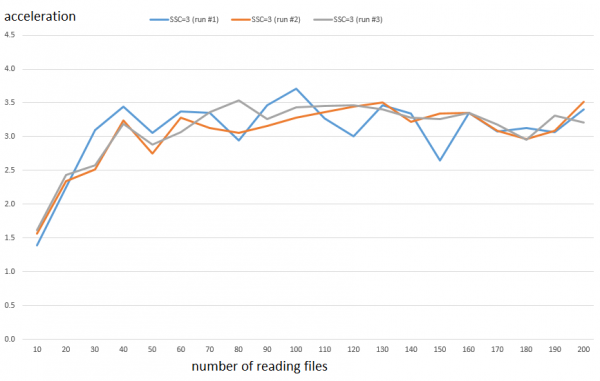
Miközben a CPU fogyasztás körülbelül 2,8-szor növekszik. A különbség nem túl nagy, de a kis Greta már örül neki, és talán lesz ideje iskolába járni és órákra menni.
Így ez kedvező hatással lesz bármilyen eszközre, amely tömeges hozzáférést használ a HDFS-hez (például Spark stb.), feltéve, hogy az alkalmazási kód könnyű (azaz a bottleneck a HDFS kliens oldalán van), és vannak szabad CPU kapacitások. Ellenőrzésképpen teszteljük, hogy milyen hatása lenne a BlockCache optimalizálásának és az SSC finomhangolásának együttes alkalmazásának az HBase-ből való olvasáskor.
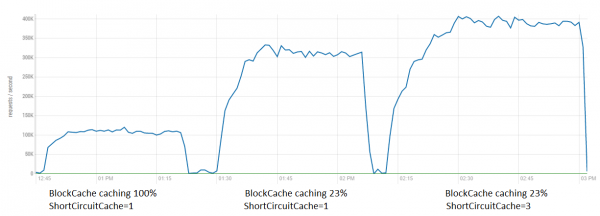
Itt látható, hogy ilyen körülmények között a hatás nem olyan nagy, mint a finomtesztek során (olvasás bármilyen feldolgozás nélkül), de még így is ki lehet hozni plusz 80K-t. Együtt mindkét optimalizálás akár négyszeres gyorsulást is nyújt.
Ezen optimalizálás kapcsán PR készült , amelyet be is olvasztottak, és ez a funkció elérhető lesz a következő kiadásokban.
És végül érdekes volt összehasonlítani a Cassandra hasonló wide-column adatbázisának és az HBase-nek az olvasási teljesítményét.
Ehhez a standard YCSB terhelésgenerátor eszköz példányait futtatták két hoszton (összesen 800 szál). A szerveroldalon 4 RegionServer és Cassandra példány volt 4 hoszton (nem azon, ahol az ügyfelek futnak, hogy elkerüljük a hatásukat). Az olvasások a következő méretű táblákból zajlottak:
HBase — 300 GB HDFS-en (100 GB tiszta adat)
Cassandra — 250 GB (replikációs tényező = 3)
Azaz a mennyiség körülbelül azonos volt (az HBase-ben egy kicsit nagyobb).
HBase paraméterek:
dfs.client.short.circuit.num = 5 (HDFS kliens optimalizálás)
hbase.lru.cache.heavy.eviction.count.limit = 30 — ez azt jelenti, hogy a patch 30 kiűzés után (~5 perc) kezd el működni
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — a célzott cache és kiűzés mérete
A YCSB naplódatokat feldolgozták és Excel grafikonokká alakították:
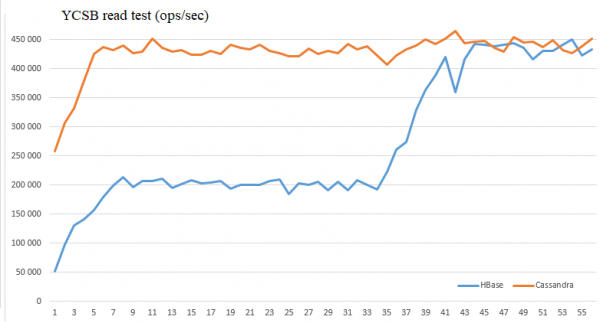
Ahogy látható, az optimalizálási adatok lehetővé teszik, hogy ezen körülmények között a teljesítmény ezeket az adatbázisokat egyenlővé tegyük, és elérjük a másodpercenkénti 450 ezer olvasást.
Reméljük, hogy ez az információ hasznos lehet valakinek az izgalmas teljesítményharc során.
Forrás: habr.com
