

A munkám során gyakran találkozom új technikai megoldásokkal/szoftvertermékekkel, amelyekről viszonylag kevés információ található a magyar nyelvű interneten. Ezzel a cikkel megpróbálom pótolni az egyik ilyen hiányosságot, egy közelmúltbeli tapasztalatom példáján keresztül, amikor szükség volt CDC-események küldésének beállítására két népszerű adatbázisból (PostgreSQL és MongoDB) a Kafka klaszterbe a Debezium segítségével. Remélem, hogy ez a szakmai cikk, amely a végzett munka eredményeként jött létre, mások számára is hasznos lesz.
Mi az a Debezium és egyáltalán mi az a CDC?
— a CDC () szoftvertermékek kategóriájának képviselője, ami pontosan annyit jelent, hogy ez különböző adatbázisokhoz készült csatlakozók gyűjteménye, amely kompatibilis az Apache Kafka Connect keretrendszerrel.
Ez amely az Apache License v2.0 licenc alatt működik, és a Red Hat támogatásával valósul meg. A fejlesztés 2016 óta zajlik, és jelenleg a következő adatbázisok hivatalos támogatása érhető el: MySQL, PostgreSQL, MongoDB, SQL Server. Léteznek csatlakozók a Cassandra és az Oracle számára is, de ezek jelenleg "korai hozzáférés" státuszban vannak, és az új kiadások nem garantálják a visszafelé kompatibilitást.
Ha a CDC-t a hagyományos megközelítéssel (amikor az alkalmazás közvetlenül olvassa az adatokat az adatbázisból) hasonlítjuk össze, akkor a fő előnyeik közé tartozik az alacsony késleltetésű adatváltozások soronkénti streaming megvalósítása, amely magas megbízhatósággal és elérhetőséggel bír. Az utolsó két pontot a Kafka klaszter CDC-események tárolására történő felhasználása biztosítja.
Továbbá előnyként emelhető ki, hogy az események tárolására egységes modellt használunk, így a végtermék alkalmazásának nem kell aggódnia különböző adatbázisok üzemeltetésének finomságai miatt.
Végül, a üzenetkezelő használatának köszönhetően lehetőségek nyílnak a horizontális skálázásra az adatokban történő változásokat figyelő alkalmazások számára. Eközben a hatás az adatforrásra minimálisra csökken, mivel az adatokat nem közvetlenül az adatbázisból, hanem a Kafka klaszterből szerezzük be.
A Debezium architektúrájáról
A Debezium használata egy ilyen egyszerű sémát követ:
Adatbázis (mint adatforrás) → csatlakozó a Kafka Connect-en → Apache Kafka → fogyasztó
Illusztrációként megemlítem a projekt webhelyéről származó sémát:
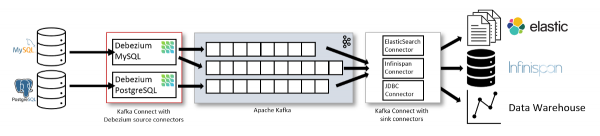
Ezen rendszer nem igazán tetszik, mert az a benyomásom, hogy csak a sink-connector használata lehetséges.
A valóságban azonban a helyzet eltérő: a Data Lake feltöltése (az ábrán lévő utolsó láncszem) — nem az egyetlen alkalmazási módja a Debezium-nak. Az Apache Kafka-ba küldött eseményeket alkalmazásai különböző helyzetek megoldására használhatják. Például:
- elavult adatok törlése a cache-ből;
- értesítések küldése;
- keresési indexek frissítése;
- valamilyen audit naplózás;
- …
Ha Java alkalmazásod van, és nincs szükséged/lehetőséged Kafka klaszter használatára, akkor van lehetőség embedded-connector használatára is. A cikkben a fejlesztők által javasolt architektúrát tárgyaljuk, amely biztosítja a hibabiztosságot és a skálázhatóságot.
A connector konfigurációja
Ahhoz, hogy a legfontosabb érték, az adatok, változásait nyomon követhessük, szükségünk lesz:
adatforrásra, amely lehet MySQL 5.7-től, PostgreSQL 9.6+-tól, MongoDB 3.2+-tól (
- teljes lista);
- Kafka Connect példányra (1.x, 2.x verziók);
- konfigurált Debezium connector-ra.
- Az első két pont, azaz az adatbázis és az Apache Kafka telepítése, túllép a cikk keretein. Azonban azok számára, akik mindent szeretnének beállítani egy sandboxban, a hivatalos példatárban van egy kész
docker-compose.yaml .
0. Kafka Connect
Ebben a cikkben minden konfigurációs példa a Debezium fejlesztői által forgalmazott Docker-kép kontextusában kerül bemutatásra. Ez tartalmazza az összes szükséges plugin fájlt (connectorok) és lehetővé teszi a Kafka Connect konfigurálását környezeti változókon keresztül.
Ha a Confluent által nyújtott Kafka Connect használata a terv, a szükséges connector pluginokat saját magadnak kell hozzáadnod a megadott könyvtárba
plugin.path vagy a CLASSPATH környezeti változón keresztül.. A Kafka Connect worker és a csatlakozók beállításait konfigurációs fájlokon keresztül határozzák meg, amelyeket a munkavégzés indítási parancsának paramétereiként adunk át. További részletekért lásd .
Az Debezium csatlakozós verziójának beállítása két lépésben történik. Tekintsük át mindkettőt:
1. A Kafka Connect keretrendszer beállítása
Az adatok Apache Kafka klaszterbe történő streameléséhez a Kafka Connect keretrendszerhez specifikus paramétereket kell beállítani, például:
- a klaszterhez való csatlakozási paraméterek,
- a témák nevei, amelyekben a csatlakozó konfigurációi találhatóak,
- a csatlakozót futtató csoport neve (a megosztott üzemmód használata esetén).
A projekt hivatalos Docker képe támogatja a konfigurációt környezeti változók segítségével — ezt fogjuk kihasználni. Tehát töltsük le a képet:
docker pull debezium/connectA csatlakozó indításához szükséges minimális környezeti változók a következőképpen néznek ki:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— a Kafka klaszter kezdő szervereinek listája a klaszter összes tagjának eléréséhez; -
OFFSET_STORAGE_TOPIC=connector-offsets— a csatlakozó aktuális pozícióinak tárolására szolgáló téma; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— a csatlakozó és feladatai állapotának tárolására szolgáló téma; -
CONFIG_STORAGE_TOPIC=connector-config— a csatlakozó és feladatai konfigurációs adatait tároló téma; -
GROUP_ID=1— a csatlakozói feladatok végrehajtására alkalmas munkacsoportok azonosítója; szükséges megosztott üzemmódban (distributed) üzemmódhoz.
Indítsuk el a konténert ezekkel a változókkal:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Megjegyzés az Avro-ról
Alapértelmezés szerint a Debezium JSON formátumban írja a data, ami elfogadható sandbox környezetben és kis mennyiségű adat esetén, de problémát jelenthet nagy terhelésű adatbázisokban. Az JSON konverter alternatívája az üzenetek Avro formátumban történő binárisra is. ezáltal csökkentve a terhelést az Apache Kafka I/O alrendszerében.
Az Avro használatához külön (a séma tárolására). A konverterhez szükséges változók a következőképpen alakulnak:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Az Avro használatáról és a registry beállításáról szóló részletek túllépnek a cikken — a világosabb érthetőség kedvéért JSON-t fogunk használni.
2. A csatlakozó beállításai
Most áttérhetünk a csatlakozó tényleges konfigurálására, amely az adatokat az forrásból olvassa.
Két adatbázis-kezelő rendszer (DBMS) csatlakozóját fogjuk megvizsgálni példaként: PostgreSQL és MongoDB — ezekben van tapasztalatom, és van néhány különbség is (bár kicsi, de bizonyos esetekben jelentős!).
A konfiguráció JSON jelölésben van megadva és a Kafka Connecthez POST kérésen keresztül kerül betöltésre.
2.1. PostgreSQL
A PostgreSQL csatlakozó példa konfigurációja:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
A csatlakozó működése ezen beállítás után viszonylag egyszerű:
- Első indításkor csatlakozik az adatbázishoz, amelyet a konfigurációban megadtunk, és elindul az initial snapshot, elküldve a Kafka-nak az első készlet adatot, amelyet egy feltételes
SELECT * FROM table_name. - lekérdezéssel kaptunk.
A kezdeti beállítása után a csatlakozó átvált a PostgreSQL WAL fájlokból származó változások olvasásának módjába.
-
nameA használt opciók: -
— a csatlakozó neve, amelyhez a lentebb ismertetett konfigurációt használják; ezt a nevet a csatlakozóval való munkára használják (pl. állapot ellenőrzésére / újraindítására / konfiguráció frissítésére) a Kafka Connect REST API-n keresztül;connector.class -
— a konfigurálható csatlakozó által használt DBMS csatlakozó osztály;plugin.name— a WAL fájlokból történő logikai dekódolásához szükséges plugin neve. Két lehetőség közül lehet választani:,wal2jsonésdecoderbuffspgoutput.decoderbuffsAz első két esetben a megfelelő kiterjesztések telepítése szükséges az DBMS-ben, míg -
a PostgreSQL 10-es és újabb verziójához nem szükséges további műveletek elvégzése;database.*— a DB-hez való csatlakozás opciói, ahol— a PostgreSQL példány neve, amely a Kafka klaszterben a téma nevének kialakításához használatos; -
table.include.list— azoknak a tábláknak a listája, amelyekben a változásokat nyomon akarjuk követni; formátumként megadvaschema.table_name; nem használható együtt atable.exclude.list; -
heartbeat.interval.ms— az intervallum (milliszegundumban), amellyel a csatlakozó heartbeat üzeneteket küld egy speciális témába; -
heartbeat.action.query— az a lekérdezés, amely minden egyes heartbeat üzenet küldésekor végrehajtásra kerül (opció a 1.1 verzió óta); -
slot.name— a replikációs slot neve, amelyet a csatlakozó használ; publication.name— a neve PostgreSQL-ben, amelyet a csatlakozó használ. Ha nem létezik, a Debezium megpróbálja létrehozni. Ha a csatlakozás alatt álló felhasználónak nincs elegendő joga ehhez, a csatlakozó hibával megszakítja a működést;-
transformsmeghatározza, hogy pontosan hogyan kell módosítani a cél téma nevét:-
transforms.AddPrefix.typemegadhatja, hogy reguláris kifejezéseket fogunk használni; -
transforms.AddPrefix.regex— a maszk, amely alapján felülírjuk a cél téma nevét; -
transforms.AddPrefix.replacement— közvetlenül az, amivé felülírjuk.
-
További információ a heartbeat-ről és a transforms-ról
Alapértelmezés szerint a csatlakozó adatokat küld a Kafka-nak minden egyes lekommitált tranzakció esetén, és az LSN-t (Log Sequence Number) egy szolgáltatási témába rögzíti offset. De mi történik, ha a csatlakozó nem az egész adatbázis olvasására van beállítva, hanem csak annak egyes tábláira (ahol az adatok frissítése nem történik gyakran)?
- A csatlakozó a WAL fájlokat fogja olvasni, és nem fogja észlelni a tranzakciók lekommitálását azokban a táblákban, amelyeket figyel.
- Ezért nem fogja frissíteni a jelenlegi pozícióját sem a témában, sem a replikációs slotban.
- Ez viszont a WAL fájlok `tartásához` vezet a lemezen, és valószínűleg kimeríti a teljes lemezterületet.
Itt jönnek segítségünkre az opciók. heartbeat.interval.ms és heartbeat.action.queryEzeknek az opcióknak a párhuzamos használata lehetővé teszi, hogy minden alkalommal a heartbeat üzenet küldésekor adatváltozási lekérdezést hajtsunk végre egy külön táblában. Ezzel folyamatosan frissítjük az LSN-t, amelyen a csatlakozó jelenleg tartózkodik (a replikációs slotban). Ez lehetővé teszi az adatbázis számára, hogy törölje a már nem szükséges WAL fájlokat. A működésükről részletesebben a .
Egy másik opció, amely fokozott figyelmet érdemel, — ez a transforms. Bár inkább a kényelemről és a szépségről szól...
Alapértelmezés szerint a Debezium a következő névmegjelölési politika alapján hoz létre témákat: serverName.schemaName.tableName. Ez nem mindig kényelmes. A lehetőségekkel transforms szabályos kifejezésekkel meg lehet határozni a táblák listáját, amelyek eseményeit egy adott nevű témába kell irányítani.
A konfigurációnk szerint a A PostgreSQL csatlakozó konfigurációs leírásának végén érdemes elmondani a működésének következő sajátosságait/korlátozásait: Így betöltjük a konfigurációnkat a csatlakozóba: Ellenőrizzük, hogy a betöltés sikeres volt, és a csatlakozó működik: Remek: be van állítva és készen áll a munkára. Most eljátszuk a fogyasztót, és csatlakozunk a Kafkához, majd hozzáadunk és módosítunk egy bejegyzést az adatbázisban: Ez a témánkban így fog megjelenni: Nagyon hosszú JSON a változtatásainkkal Mindkét esetben a bejegyzések a módosított bejegyzés kulcsából (PK) állnak, valamint a módosítások lényegéből: mi volt a bejegyzés előtte és mi lett utána. Ez a csatlakozó a MongoDB szabványos replikációs mechanizmusát használja, olvasva az információt az adatbázis főcsomópontjának oplog-jából. Hasonlóan a már említett PgSQL csatlakozóhoz, itt is az első indításkor egy elsődleges adatsnapshot készül, majd ezután a csatlakozó áttér az oplog olvasási üzemmódjára. Példa konfiguráció: Mint látható, itt nincsenek új opciók a korábbi példához képest, de csökkent a DB kapcsolódásáért felelős opciók számának mennyisége. Beállítások A hibatűrés és a magas rendelkezésre állás kérdése ma már soha nem volt ennyire aktuális — különösen, amikor az adatokról és tranzakciókról beszélünk, és az adatváltozások nyomon követése nem marad ki ebből a kérdésből. Nézzük meg, hogy alapvetően mi mehet rosszul, és mi történik a Debezium-mal minden esetben. Háromféle meghibásodási lehetőség van: . Ugyanakkor vannak kivételek. Ha a csatlakozó hosszú ideig inaktív állapotban volt (vagy nem tudott kapcsolatba lépni a MongoDB példányával), és az oplog időközben rotálódott, akkor a kapcsolat helyreállításakor a csatlakozó nyugodtan folytatja az adatok olvasását az első elérhető pozíciótól, ami miatt egyes adatok a Kafka nem . fognak kerülni. A Debezium - az első tapasztalatom a CDC rendszerekkel, és összességében nagyon pozitív. A projekt a főbb adatbázisok támogatásával, a konfiguráció egyszerűségével, a klaszterezés támogatásával és az aktív közösséggel vonzó. Az érdeklődőknek ajánlom, hogy ismerkedjenek meg a és . A Debezium fő előnye a Kafka Connect JDBC-kapcsolójával szemben az, hogy a változások a DBMS naplóiból kerülnek kiolvasásra, lehetővé téve az adatok minimális késleltetéssel történő megszerzését. A JDBC Connector (a Kafka Connect részeként) fix időközönként kérdéseket intéz a nyomon követett táblához, és emiatt nem generál üzeneteket az adatok törlésekor (hogyan lehet kérni a nem létező adatokat?). Hasonló feladatok megoldására érdemes figyelembe venni a következő megoldásokat (a Debezium mellett): Olvasson további információkat a blogunkban: Forrás: habr.comtransforms következő történik: az összes CDC-esemény a nyomon követett adatbázisból a data.cdc.dbnamenevű témába kerül. Ellenkező esetben (ezek nélkül a beállítások nélkül) a Debezium alapértelmezés szerint minden táblához egy témát hozott volna létre, a következő formában: pg-dev.public..
A csatlakozó korlátai
A konfiguráció alkalmazása
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date: Thu, 17 Sep 2020 20:19:40 GMT
Content-Type: application/json
Content-Length: 175
Server: Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERT: az érték előtte (before) egyenlő null, utána pedig a beillesztett szöveg. UPDATE: az payload.before a bejegyzés előző állapotát jeleníti meg, míg a payload.after — az új, a módosítások lényegével.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms ezúttal a következőket végzi: átalakítja a cél-topic nevét a sémából <server_name>.<db_name>.<collection_name> be. data.cdc.mongo_<db_name>.Hibatűrés
Zárás
P.S.
