

Két divatos kifejezés, amelyek a Data Science-hez kapcsolódnak, sok embert összezavarnak. A Data Mining gyakran tévesen az adatok kinyerésére és megszerzésére vonatkozik, de valójában a helyzet sokkal bonyolultabb. Ebben a bejegyzésben tisztázzuk a Mining fogalmát, és nézzük meg a különbséget a Data Mining és a Data Extraction között.
Mi az a Data Mining?
A data mining, más néven az adatbázisokban történő tudásfelfedezés (KDD), egy olyan módszer, amelyet gyakran alkalmaznak nagy adatállományok elemzésére statisztikai és matematikai módszerekkel, rejtett összefüggések vagy trendek keresésére és érték kinyerésére.
Mit lehet elérni a Data Mining segítségével?
A folyamat automatizálásával képesek átnézni adatbázisokat, és hatékonyan feltérképezni a rejtett összefüggéseket. A vállalatok számára a data mining gyakran használatos a minták és összefüggések felfedezésére az adatokban, amelyek segítik az optimális üzleti döntések meghozatalát.
Alkalmazási példák
Miután az 1990-es években a data mining széles körben elterjedt, a vállalatok számos iparágban, beleértve a kiskereskedelmet, a pénzügyeket, az egészségügyet, a szállítást, a távközlést, az elektronikus kereskedelmet stb., elkezdték alkalmazni a data mining módszereit adatokon alapuló információk megszerzésére. A data mining segíthet az ügyfélsegmentationben, csalások észlelésében, értékesítések előrejelzésében és sok másban.
- Ügyfélszegmentáció
A vásárlói adatok elemzésével és a célcsoport jellemzőinek azonosításával a vállalatok külön csoportokba sorolhatják őket, és speciális ajánlatokat tehetnek, amelyek megfelelnek az igényeiknek. - Kosáranalízis
Ez a módszer azon az elven alapul, hogy ha egy bizonyos termékcsoportot vásárol, valószínűleg megvásárol egy másik termékcsoportot is. Egy jól ismert példa: amikor az apák pelenkát vásárolnak a kisbabáiknak, általában sört is vásárolnak a pelenkával együtt. - Értékesítés előrejelzése
Ez hasonlónak tűnhet a kosáranalízishez, de ezúttal az adatelemzést arra használják, hogy megjósolják, mikor vásárol újra a vevő egy terméket a jövőben. Például egy edző vásárol egy doboz fehérjét, amely kilenc hónapra elegendő. Az üzlet, amely ezt a fehérjét árusítja, tervezi, hogy kilenc hónap múlva új verziót ad ki, hogy az edző újra megvásárolja. - Csalás-észlelés
Az adatbányászat segít a csalások észlelésére szolgáló modellek kiépítésében. A csalárd és valódi jelentések mintáinak gyűjtésével a vállalatok képesek meghatározni, hogy mely tranzakciók gyanúsak. - Minták észlelése a gyártásban
A feldolgozóiparban az adatbányászat segítséget nyújt a rendszerek tervezésében azáltal, hogy feltárja a kapcsolatokat a termék architektúrája, a profil és a vásárlói igények között. Az adatbányászat előre jelezheti a termékfejlesztési határidőket és költségeket is.
Ezek csak néhány példa az adatbányászat alkalmazására.
Az adatbányászat lépései
Az adatbányászat egy átfogó folyamat, amely magában foglalja az adatok gyűjtését, kiválasztását, tisztítását, átalakítását és kiértékelését a minták megállapítása érdekében, végső célként pedig az érték kiemelését.
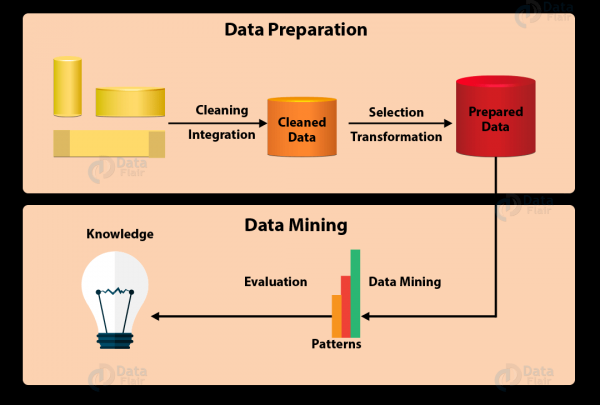
Általában az adatbányászat folyamata 7 lépésre összegződik:
- Az adatok tisztítása
A valós világban az adatok nem mindig tiszták és strukturáltak. Gyakran zajosak, hiányosak, és hibákat tartalmazhatnak. Annak érdekében, hogy az adatbányászat eredménye pontos legyen, először az adatokat tisztítani kell. A tisztítási módszerek közé tartozik a hiányzó értékek kitöltése, automatikus és manuális ellenőrzés stb. - Adatok integrálása
Ez azon a lépésen zajlik, ahol az adatok különböző forrásokból kiemelésre, kombinálásra és integrálásra kerülnek. A források lehetnek adatbázisok, szöveges fájlok, táblázatok, dokumentumok, többdimenziós adathalmazok, az internet stb. - Adatok lekérése
Általában nem minden integrált adat szükséges az adatbányászat során. Az adatok mintavételezése azon a lépésen történik, ahol egy nagy adatbázisból csak a hasznos adatok kerülnek kiemelésre. - Az adatok átalakítása
Miután az adatokat kiválasztották, azokat az adatbányászat számára megfelelő formákra alakítják. Ez a folyamat magába foglalja a normalizálást, aggregálást, általánosítást stb. - Intelligens adatelemzés
Itt következik az adatbányászat legfontosabb része — intelligens módszerek alkalmazása a minták felfedezésére. A folyamat tartalmaz regressziót, klasszifikációt, előrejelzést, klaszterezést, asszociációk tanulmányozását és még sok mást. - A modell értékelése
Ez a lépés arra irányul, hogy kiderítse a potenciálisan hasznos, könnyen érthető mintázatokat, valamint azokat a mintázatokat, amelyek megerősítik a hipotéziseket. - A tudás bemutatása
A végső szakaszban az beszerzett információ vonzó módon jelenik meg a tudásmegjelenítési és vizualizációs módszerek alkalmazásával.
A Data Mining hátrányai
- Nagy idő- és munkaigény
Mivel az adatbányászat egy hosszadalmas és bonyolult folyamat, ezért jelentős munka értelemben és szakképzett emberekre van szükség. Az adatelemző szakemberek nagy teljesítményű adatbányászati eszközöket használhatnak, azonban nekik szakértőkre van szükségük az adatok előkészítéséhez és az eredmények megértéséhez. Ennek eredményeként az összes információ feldolgozása időigényes lehet. - Adatok védelme és biztonsága
Mivel az adatbányászat piaci módszerekkel gyűjti az ügyfelek információit, ez sértheti a felhasználók titkosságát. Ezen kívül a hackerek hozzáférhetnek az adatbányászat során tárolt adatokhoz. Ez fenyegetést jelent az ügyfelek adatainak biztonságára. Ha az ellopott adatokat nem célzottan használják, az könnyen kárt okozhat másoknak.
A fentiekben rövid bevezetést adtunk az adatbányászatba. Ahogyan már említettem, az adatbányászat magában foglalja az adatok gyűjtésének és integrálásának folyamatát, amely tartalmazza az adatok kinyerésének (data extraction) folyamatát is. Itt határozottan elmondható, hogy az adatok kinyerése egy hosszú távú adatbányászati folyamat része lehet.
Mi az adatkinyerés?
Más néven «webadatok kinyerése» és «web scraping», ez a folyamat azt jelenti, hogy adatokat nyernek ki (általában strukturálatlan vagy rosszul strukturált) adatforrásokból, és központosítják azokat egy helyen tárolás vagy további feldolgozás céljából. Különösen a strukturálatlan adatforrások közé tartoznak a weboldalak, e-mailek, dokumentumok, PDF fájlok, beolvasott szövegek, mainframe jelentések, tekercsfájlok, hirdetések stb. A központosított tárolók lehetnek helyi, felhő alapú vagy hibrid. Fontos megjegyezni, hogy az adatkinyerés nem tartalmaz feldolgozást vagy más elemzést, ami később történhet.
Mit lehet tenni az adatkinyerés segítségével?
Legfőképpen az adatkinyerés céljai 3 kategóriára oszthatók.
- Archívum készítése
Az adatok kinyerése fizikális formátumokból, például könyvekből, újságokból, számlákból digitális formátumokká alakíthatja, mint például adatbázisok a tárolás vagy biztonsági mentés érdekében. - Adatformátum változtatás
Amikor át akarja helyezni az adatokat a jelenlegi weboldaláról az új, fejlesztés alatt állóra, összegyűjtheti az adatokat a saját weboldaláról, kivonva azokat. - Adatainak elemzése
Kiegészítő elemzés gyakran terjedelmes az extracted data révén, hogy rálátást nyerjünk. Ez hasonlónak tűnhet az adatelemzéshez a data mining során, de vegyük figyelembe, hogy az adatelemzés a kinyerés célja, de nem része. Továbbá, az adatok eltérő módon kerülnek elemzésre. Egyik példa: az online bolt tulajdonosai információt nyernek ki a termékről az elektronikus kereskedelmi weboldalakról, például az Amazonról, a versenytársak valós idejű stratégiáinak figyelemmel kísérése érdekében. Mint a data mining, az data extraction egy automatizált folyamat, amely számos előnnyel jár. korábban az emberek kézzel másolták át az adatokat egy helyről a másikra, ami nagyon időigényes volt. Az adatok kinyerése felgyorsítja az összegyűjtést és jelentősen növeli a kinyert adatok pontosságát.
Néhány példa az Adat Kinyerés alkalmazására
Hasonlóan a data mininghoz, az adat kinyerése széles körben alkalmazható különböző iparágakban. Az online kereskedelem árfigyelése mellett az adat kinyerése segíthet a saját kutatásokban, hírek aggregálásában, marketingben, ingatlanüzletágban, utazásban és turizmusban, tanácsadásban, pénzügyekben, és sok más területen.
- Leadgenerálás
A vállalatok adatokat nyerhetnek ki katalógusokból: Yelp, Crunchbase, Yellowpages, és leadeket generálhatnak az üzlet fejlesztéséhez. Megtekintheti az alábbi videót, hogy megtudja, hogyan nyerheti ki az adatokat a Yellowpages-ból a . - Tartalom és hírek aggregációja
A tartalmat aggregáló weboldalak rendszeres adatáramlásokat kaphatnak több forrásból, és naprakészen tarthatják weboldalaikat. - Hangulati elemzés
Miután kivonták a véleményeket, kommentárokat és értékeléseket közösségi médiákból, mint az Instagram és a Twitter, a szakemberek elemezhetik a mögöttes véleményeket, és betekintést nyerhetnek abba, hogy milyen képet alkotnak a márkáról, termékről vagy egy jelenségről.
Az Adat Kinyerés lépései
Az adatok kinyerése - az ETL (Extract, Transform, Load: kinyerés, átalakítás, betöltés) és ELT (kinyerés, betöltés és átalakítás) első lépése, és ezen folyamatok része a teljes adatintegrációs stratégia. Más szóval, az adatok kinyerése lehet a nyerésük része.
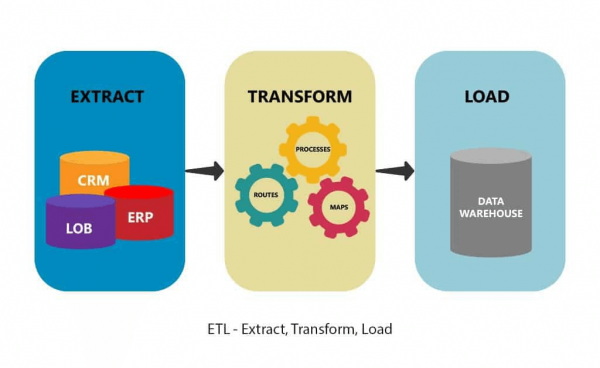
Kinyerés, átalakítás, betöltés
Míg az adatbányászat nagy adathalmazokból való információszerzést jelent, az adatok kinyerése sokkal rövidebb és egyszerűbb folyamat. Ezt három lépésre lehet redukálni:
- Az adatok forrásának kiválasztása
Válassza ki azt a forrást, ahonnan adatokat szeretne kinyerni, például egy weboldalt. - Adatgyűjtés
Küldjön egy 'GET' kérést az oldalnak, és elemezze az HTML dokumentumot programozási nyelvek, mint például Python, PHP, R, Ruby stb. segítségével. - Adattárolás
Mentse el az adatokat a helyi adatbázisába vagy felhőtárolójába a jövőbeni felhasználás céljából. Ha tapasztalt programozó vagy, aki adatokat szeretne kinyerni, a fenti lépések egyszerűnek tűnhetnek. Azonban, ha nem programozik, van egy rövidebb út - használjon adatkinyerő eszközöket, például . Az adatkinyerő eszközök, akárcsak az adatbányászati eszközök, azért lettek kifejlesztve, hogy energiát spóroljanak és megkönnyítsék az adatok feldolgozását mindenki számára. Ezek az eszközök nemcsak költséghatékonyak, hanem a kezdők számára is könnyen használhatók. Lehetővé teszik a felhasználók számára, hogy néhány perc alatt adatokat gyűjtsenek, tárolják azokat a felhőben, és exportálják különböző formátumokba: Excel, CSV, HTML, JSON vagy adatbázisokba az API-n keresztül.
Az adatkinyerés hátrányai
- Szerverhiba
Nagy léptékű adatkinyerés során a célweboldal szervere túlterhelődhet, ami a szerver leállásához vezethet. Ez kárt okozhat a weboldal tulajdonosának érdekeiben. - IP-bann
Amikor egy személy túl gyakran gyűjt adatokat, a weboldalak blokkolhatják az IP-címét. Az erőforrás teljesen letilthatja az IP-címet, vagy korlátozhatja a hozzáférést, ezzel hiányos adatokat eredményezve. Az adatok kinyeréséhez és a blokkolás elkerüléséhez mértékkel kell eljárni, és alkalmazni kell bizonyos anti-blokkoló módszereket. - Jogi problémák
Az adatok webes kinyerése a törvényesség szürke zónájába esik. Olyan nagy oldalak, mint a Linkedin és a Facebook, világosan kijelentik használati feltételeikben, hogy bármilyen automatikus adatkinyerés tilos. Számos per volt a cégek között a botok tevékenysége miatt.
A Data Mining és a Data Extraction közötti kulcskülönbségek
- A data mining ismeretfelfedezést jelent az adatbázisokban, tudáskiemelést, adat- vagy mintaanalízist, információgyűjtést is. A data extraction kifejezést felváltva használják a webadatok kinyerésével, weboldalak bejárásával, adatok gyűjtésével és így tovább.
- A data mining vizsgálatai főként strukturált adatokra épülnek, míg az adatok kinyerése általában strukturálatlan vagy rosszul strukturált forrásokból történik.
- A data mining célja, hogy az adatokat hasznosabbá tegye az elemzéshez. A data extraction a adatok egy helyre gyűjtését jelenti, ahol azok tárolhatóak vagy feldolgozhatóak.
- A data mining során az elemzés matematikai módszereken alapul, amelyek a minták vagy tendenciák felfedezésére irányulnak. A data extraction programozási nyelveken vagy adatkinyerő eszközökön alapul, hogy bejárja a forrásokat.
- A data mining célja, hogy olyan tényeket találjon, amelyeket korábban nem ismertek vagy figyelmen kívül hagytak, míg a data extraction a meglévő információkkal foglalkozik.
- A data mining bonyolultabb és nagyobb beruházásokat igényel az emberek képzésébe. A megfelelő eszköz használatával a data extraction rendkívül egyszerű és költséghatékony lehet.
Segítünk a kezdőknek eligibilálni az adatokat. Kifejezetten a h hubra látogatóknak készítettünk egy promóciós kódot HABR, amely 10% kedvezményt ad a banneren feltüntetett kedvezményhez képest.
További kurzusok
Ajánlott cikkek
Forrás: habr.com
