

Helló mindenkinek! A nevem Oleg Sidorenkov, az infrastruktúra csapat vezetőjeként dolgozom a DomKlick cégnél. A „Kubik”-ot már több mint három éve üzemeltetjük a termelésben, és ez idő alatt sok érdekes dolgon mentünk keresztül. Ma elmondom nektek, hogyan hozhatjátok ki a „vanília” Kubernetes-ből még több teljesítményt a klaszteretek számára. Készen álltok?
Mindenki jól tudja, hogy a Kubernetes egy skálázható, nyílt forráskódú rendszer a konténerek orchestration-hoz; vagyis 5 bináris fájl, amelyek varázslatot csinálnak, irányítva a mikroszolgáltatások életciklusát a szerver környezetben. Ezenkívül ez egy elég rugalmas eszköz, amelyet Lego építőkészletként össze lehet rakni, hogy a különböző feladatokhoz maximális testreszabhatóságot nyújtson.
Úgy tűnik, minden rendben van: dobd be a szervereket a klaszterbe, mint a hasábokat a tűzbe, és ne is foglalkozz vele. De ha a zöld gondolkodás híve vagy, elgondolkodsz: „Hogyan tarthatom fenn a tüzet a kályhámban, és egyúttal kíméljem az erdőt?”. Más szóval, hogyan találhatók meg a módok az infrastruktúra javítására és a költségek csökkentésére.
1. Figyelj a csapatok és alkalmazások erőforrásaira
Az egyik legegyszerűbb, de hatékony módszer a requests/limits bevezetése. Oszd szét az alkalmazásokat névterekre, és a névtereket a fejlesztő csapatokra. Határozz meg az alkalmazás számára processzoridő, memória és áthidaló tároló fogyasztási értékeket telepítés előtt.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Tapasztalataink alapján arra a következtetésre jutottunk, hogy nem érdemes a kéréseket a korlátoktól több mint kétszeresére növelni. A klaszter mérete a kérések alapján kalkulálódik, és ha az alkalmazásoknak 5-10-szeres eltérést biztosítasz az erőforrásokban, képzeld el, mi történik a csomópontoddal, amikor megtelik podokkal és hirtelen terhelést kap. Semmi jót nem várhatsz. Legalább throttling, de a legrosszabb esetben búcsút inthetsz a munkásnak, és ciklikus terhelést kaphatsz a többi csomóponton, miután a podok elkezdenek vándorolni.
Ezen kívül, a limitranges Kezdéskor megadhatsz a konténer számára erőforrás értékeket — minimumot, maximumot és alapértelmezettet:
➜  ~ kubectl describe limitranges --namespace ops
Név:       limit-range
Névter:    ops
Típus      Erőforrás         Min   Max   Alapértelmezett Kérelem  Alapértelmezett Korlát  Max Korlát/Kérelem Arány
----       ---------         ---   ---   ----------------  ----------------  -----------------------
Tartály    cpu                50m   10    100m             100m           2
Tartály    ephemerális-tároló  12Mi  8Gi   128Mi            4Gi            -
Tartály    memória             64Mi  40Gi  128Mi            128Mi          2
Ne felejtsd el korlátozni a névterek erőforrásait, hogy egy csapat ne tudja elvenni az összes erőforrást a klasztertől:
➜  ~ kubectl describe resourcequotas --namespace ops
Név:                    resource-quota
Névter:                 ops
Erőforrás              Használt        Nehéz
--------               ----           ----
limits.cpu             77250m        80
limits.memory          124814367488  150Gi
podok                  31            45
requests.cpu           53850m        80
requests.memory        75613234944   150Gi
szolgáltatások         26            50
szolgáltatások.terheléskiegyenlítők  0             0
szolgáltatások.nodports   0             0
Ahogy az a leírásból látható resourcequotas, ha az ops csapat további 10 cpu-t fogyasztó podokat akar telepíteni, a ütemező nem engedi ezt végrehajtani és hibaüzenetet ad:
Hiba a létrehozáskor: pods "nginx-proxy-9967d8d78-nh4fs" nem engedélyezett: átlépte a kvótát: resource-quota, kért: limits.cpu=5,requests.cpu=5, használt: limits.cpu=77250m,requests.cpu=53850m, korlátozott: limits.cpu=10,requests.cpu=10Egy ilyen feladat megoldásához írhatunk egy eszközt, például , amely képes tárolni és elkötelezni a csapatok erőforrásainak állapotát.
2. Optimalizáld a fájlmentést
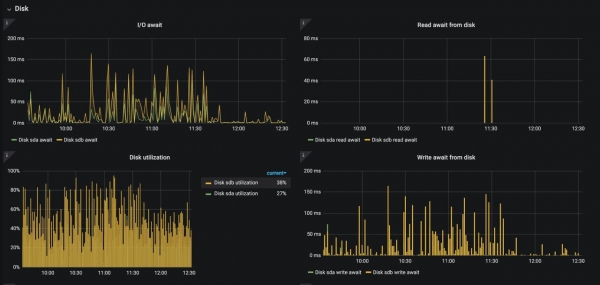
Itt szeretném érinteni a perzisztens kötetek és a Kubernetes worker-nódok lemezes alrendszerének témáját. Remélem, senki nem használ HDD-t a «Kockán» a termelésben, de néha már a szokásos SSD is kevés. Találkoztunk olyan problémával, hogy a naplók elpusztították a lemezt az I/O műveletek miatt, és itt nem nagyon sok lehetőség van a megoldásra:
Használj nagy teljesítményű SSD-t vagy térj át NVMe-re (ha te magad irányítod a hardveredet).
Csökkentsd a naplózási szintet.
Készíts „okos” egyensúlyt a lemezt megterhelő podok között (
podAntiAffinity).
A fenti képen látható, hogy mi történik az nginx-ingress-controllerrel, amikor bekapcsolva van a naplózás access_logs (~12 ezer napló/másodperc). Ez az állapot természetesen a node összes alkalmazásának lelassulásához vezethet.
A PV-vel kapcsolatban sajnos nem próbáltam ki az összes Tartós kötetek. Használja a legjobban illeszkedő megoldást az Ön számára. Történelmileg kisebb részlegeink szükségeltettek RWX kötetekre, és régen az NFS-tárolót kezdték el használni erre a célra. Olcsó és... elegendő. Természetesen, sok problémát okozott nekünk — de megtanultuk optimalizálni, és már nem fáj a fejünk. Ha lehetséges, váltson S3 objektumtárolóra.
3. Gyűjtse össze az optimalizált képeket
A legjobb, ha konténerekhez optimalizált képeket használ, hogy a Kubernetes gyorsabban elérhesse őket és hatékonyabban futtathassa őket.
Az optimalizáltság azt jelenti, hogy a képek:
csak egy alkalmazást tartalmaznak vagy csak egy funkciót hajtanak végre;
kicsi méretűek, mert a nagyobb képek nehezebben továbbíthatók a hálózaton;
vannak végpontjaik az állapot- és készségi ellenőrzéshez, amelyek révén a Kubernetes intézkedhet valamit leállások esetén;
barátságos operációs rendszereket használnak a konténerekhez (például Alpine vagy CoreOS), amelyek jobban ellenállnak a konfigurálási hibáknak;
többfázisú build-el járnak, hogy csak a lefordított alkalmazásokat telepíthesse, ne pedig a kapcsolódó forráskódokat.
Számos eszköz és szolgáltatás érhető el, amelyek lehetővé teszik a képek valós idejű ellenőrzését és optimalizálását. Fontos, hogy mindig naprakészen és biztonságosan tartsuk őket. Végül a következőket kapja:
Csökkentett hálózati terhelés az egész klaszteren.
Csökkentett konténerindítási idő.
Kisebb térfogat az összes Docker registry-jében.
4. Használja a DNS cache-t
Ha magas terhelésekről van szó, akkor DNS-rendszer optimizálás nélkül az élet elég rossz. Régen a Kubernetes fejlesztői támogatták a saját megoldásukat, a kube-dns-t. Ez be lett vezetve nálunk is, de ez a szoftver nem volt különösebben optimalizálva, és nem nyújtott elegendő teljesítményt, bár látszólag a feladat egyszerű. Aztán megjelent a coredns, amelyre áttértünk, és azóta is kiválóan működött, ez lett a K8s alapértelmezett DNS-szolgáltatása. Egy ponton elértük a 40 ezer rps-t a DNS-rendszerhez, és ezt a megoldást sem tartottuk elegendőnek. De szerencsére megjelent a Nodelocaldns, más néven node local cache, más néven .
Miért használjuk ezt? A Linux magjában van egy hiba, amely a conntrack NAT többszörös hivatkozása esetén UDP-nél versenyhelyzetet okoz a conntrack táblák írásánál, ami a NAT-on keresztüli forgalom egy részének elvesztéséhez vezet (minden szolgáltatáshoz való hivatkozás NAT). A nodelocaldns megoldja ezt a problémát azzal, hogy megszabadul a NAT-tól, és TCP-kapcsolatra frissíti az upstream DNS-t, valamint helyi DNS-keresések gyorsítótárazásával az upstreamokhoz (beleértve egy rövid, 5 másodperces negatív gyorsítótárat).
5. Automatikusan vízszintesen és függőlegesen skálázza a podokat
Bízhat abban, hogy minden mikroszolgáltatása készen áll a terhelés két- vagy háromszoros növekedésére? Hogyan lehet a forrásokat helyesen kiosztani az alkalmazásainak? Két pod folyamatos működtetése a terhelés felett feleslegesnek bizonyulhat, míg a szoros működtetés az azonnali forgalomnövekedés miatti leállás kockázatát rejti magában. A helyes középút elérésében segíthetnek olyan szolgáltatások, mint és .
VPA automatikusan állítja be a konténerek requests/limits beállításait a podban a tényleges kihasználtság függvényében. Miben lehet hasznos? Ha olyan podok vannak, amelyeket valamilyen okból nem lehet vízszintesen skálázni (ami nem teljesen megbízható), akkor megpróbálhatja a VPA-t megbízni az erőforrások módosításával. Az ő sajátossága a rendszer ajánlásokra épül a történeti és aktuális adatok alapján a metric-serverből, így ha nem szeretné automatikusan megváltoztatni a requests/limits beállításokat, egyszerűen nyomon követheti a javasolt erőforrásokat a konténereihez és optimalizálhatja a beállításokat a cluster CPU- és memória-megtakarítása érdekében.
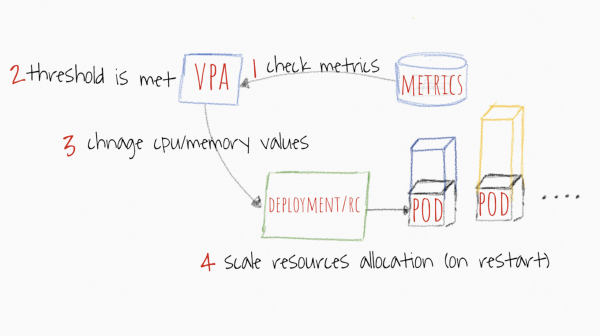 A kép forrása: https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
A Kubernetes ütemező mindig a requests alapján működik. Bármilyen értéket is állítson be, az ütemező a megfelelő node-t fogja keresni ennek alapján. A limits értékek a kubelet számára szükségesek, hogy megértsék, mikor kell throttlingot alkalmazni vagy megölni egy podot. Mivel az egyetlen fontos paraméter a requests érték, a VPA ezzel fog foglalkozni. Valahányszor függőleges skálázást ad meg az alkalmazásának, meghatározza, hogy milyennek kell lennie a requests-nek. De mi lesz akkor a limits értékekkel? Ez a paraméter is arányosan lesz skálázva.
Például, itt vannak a pod szokásos beállításai:
erőforrások:
   igények:
     memória: 250Mi
     cpu: 200m
   korlátok:
     memória: 500Mi
     cpu: 350m
A javaslati mechanizmus megállapítja, hogy az alkalmazásának normális működéséhez 300m CPU és 500Mi szükséges. Az alábbi beállításokat fogja kapni:
erőforrások:
   igények:
     memória: 500Mi
     cpu: 300m
   korlátok:
     memória: 1000Mi
     cpu: 525m
Ahogy az fentebb említve lett, ez arányos skálázás a manifestben megadott igények/korlátok arányából:
CPU: 200m → 300m: arány 1:1.75;
Memória: 250Mi → 500Mi: arány 1:2.
Ami a HPA, itt a működés mechanizmusa átláthatóbb. Küszöbértékeket állítanak be, például a processzor és memória esetében, és ha az összes replikált példány átlagos értéke meghaladja a küszöböt, akkor az alkalmazás +1 példányra skálázódik, amíg az érték vissza nem esik a küszöb alá, vagy amíg el nem érjük a maximális replikák számát.
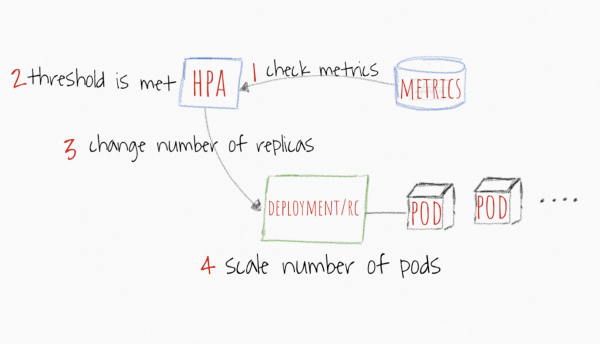 A kép forrása: https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Az általános metrikák mellett, mint például a processzor és memória, beállíthatja a küszöbértékeket a saját egyedi metrikáira a Prometheusból, és azokat használhatja, ha úgy gondolja, hogy ez a legpontosabb meghatározása annak, mikor kell skálázni az alkalmazását. Miután az alkalmazás stabilizálódik a megadott metrikahatár alatt, az HPA elkezdi csökkenteni a példányok számát a minimális replikák számáig, vagy addig, amíg a terhelés megfelel a megadott küszöbértéknek.
6. Ne feledje a Node Affinity és Pod Affinity beállításokat.
Nem minden node egyformán működik, nem minden podnak szükséges intenzív számítási alkalmazásokat futtatni. A Kubernetes lehetőséget ad a node-ok és pod-ok specializálására a következőkkel: Node Affinity és Pod Affinity.
Ha vannak node-ok, amelyek alkalmasak intenzív számítási műveletekre, akkor a maximális hatékonyság érdekében érdemes az alkalmazásokat az adott node-okhoz rendelni. Ehhez használja a nodeSelector a node címkéjével.
Tegyük fel, hogy van két node: az egyik a CPUType=HIGHFREQ gyors magokkal, a másik a MemoryType=HIGHMEMORY nagy mennyiségű memóriával és magasabb teljesítménnyel. A legegyszerűbb módja, hogy a pod telepítést a node-hoz rendelje, HIGHFREQ, hozzáadva az alábbi szelektorhoz: spec … nodeSelector: CPUType: HIGHFREQ
A költségesebb és specifikusabb módja ennek a megvalósítása anodeAffinity használata a a mezőben affinity szakaszban. Két lehetőség van: spec, a következőkkel:
requiredDuringSchedulingIgnoredDuringExecution: szigorú beállítás (a ütemező csak a megadott node-okon telepíti a podokat (másutt nem));preferredDuringSchedulingIgnoredDuringExecution: finomhangolás (a tervező megpróbálja telepíteni a konkrét csomópontokon, és ha nem sikerül, a következő elérhető csomóponton próbálkozik).
Megadhat egy meghatározott szintaxist a csomópontok címkéinek kezelésére, például In, NotIn, Exists, DoesNotExist, Gt vagy Lt. Ne feledje azonban, hogy a bonyolult módszerek hosszú címkelistákban lelassítják a döntéshozatalt kritikus helyzetekben. Más szavakkal, ne bonyolítsa túl.
Ahogy korábban említettük, a Kubernetes lehetőséget ad a jelenlegi podok kötésének megadására. Vagyis megteheti, hogy bizonyos podok együtt működjenek más podokkal ugyanabban a rendelkezésre állási zónában (ez releváns a felhőkben) vagy csomópontokon.
A podAffinity mezők affinity szakaszban. Két lehetőség van: spec az elérhető ugyanazok a mezők, mint a használata a: requiredDuringSchedulingIgnoredDuringExecution és preferredDuringSchedulingIgnoredDuringExecution. Az egyetlen különbség az, hogy matchExpressions a podokat olyan csomópontra köti, ahol már fut egy olyan pod, amelynek ilyen címkéje van.
A Kubernetes emellett kínál egy podAntiAffinitymezőt, amely éppen ellenkezőleg, nem köti a podot meghatározott podokkal rendelkező csomóponthoz.
A kifejezések vonatkozásában használata a ugyanazt a tanácsot adhatjuk: igyekezzen fenntartani a szabályok egyszerűségét és logikáját, ne próbálja meg túlhúzni a pod-specifikációt bonyolult szabályrendszerrel. Nagyon könnyű egy olyan szabályt létrehozni, amely nem felel meg a klaszter követelményeinek, ezzel felesleges terhelést okozva a tervezőnek és csökkentve az összesített teljesítményt.
7. Taints & Tolerations
Van még egy módja a tervező kezelésének. Ha nagy klasztere van, amely több száz csomópontból és ezer mikroszolgáltatásból áll, nagyon nehéz megakadályozni, hogy bizonyos podok meghatározott csomópontokon helyezkedjenek el.
Ebben segít a taint-ek mechanizmusa — tiltó szabályok. Például bizonyos forgatókönyvek esetén megtilthatja bizonyos csomópontoknak, hogy podokat futtassanak. A taint alkalmazásához egy adott csomóponton a következő opciót kell használni: taint a kubectl-ben. Adja meg a kulcsot és az értéket, majd a taint például a következő lehet: NoSchedule vagy NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleEmellett érdemes megjegyezni, hogy a taint mechanizmusa három alapvető hatást támogat: NoSchedule, NoExecute és PreferNoSchedule.
NoScheduleez azt jelenti, hogy amíg a pod specifikációjában nincs megfelelő bejegyzés.tolerations, nem lehet telepíteni egy csomópontokra (ebben a példábannode10).PreferNoSchedule— egyszerűsített változata.NoSchedule. Ebben az esetben a tervező megpróbálja elkerülni azokat a podokat, amelyeknek nincs megfelelő bejegyzése, hogy eloszthassa őket a csomóponton, de ez nem szigorú korlátozás. Ha a klaszterben nem állnak rendelkezésre erőforrások, a podok elkezdenek települni erre a csomópontra.tolerationsEbben az esetben a tervező megpróbál elkerülni a zászlóval nem rendelkező podok terjesztését a csomópontra, de ez nem szigorú korlátozás. Ha a klaszterben nincsenek elérhető erőforrások, a podok el fogják kezdeni a telepítést erre a csomóportra.NoExecute— ez a hatás azonnali evakuálást indít a podok számára, amelyekhez nincs megfelelő bejegyzés.tolerations.
Érdekes módon ez a viselkedés a tolerálások mechanizmusával visszavonható. Ez hasznos, amikor van egy „tiltott” csomópont, és csak infrastruktúra szolgáltatásokat kell elhelyezni rajta. Hogyan kell ezt megtenni? Csak azokat a podokat engedélyezni, amelyekhez megfelelő tolerálás tartozik.
Így fog kinézni a pod specifikációja:
spec:
   tolerations:
     - key: "node-role.kubernetes.io\/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
Ez nem jelenti azt, hogy a következő redeploy során a pod pontosan erre a csomópontára kerül, ez nem a Node Affinity mechanizmusa, és nodeSelector. De több funkció kombinálásával nagyon rugalmas ütemezési beállításokat érhet el.
8. Állítsa be a podok telepítési prioritását
Az, hogy beállította a podok kötését a csomópontokhoz, nem jelenti azt, hogy minden podnak egyforma prioritása lenne. Például lehet, hogy egyes podokat szeretne korábban telepíteni, mint másokat.
A Kubernetes különböző módokat kínál a podok prioritásának beállítására (Pod Priority and Preemption). A beállítás több részből áll: az objektumból PriorityClass és a pod specifikációban található priorityClassName mezőből. Lássunk egy példát:
apiVersion: scheduling.k8s.io\/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Ez a prioritási osztály nagyon fontos podok számára használható csak"
Létrehozunk PriorityClass, megadva neki egy nevet, leírást és értéket. Minél magasabb érték, annál magasabb a prioritás. Az érték lehet bármilyen 32 bites egész szám, legfeljebb 1 000 000 000-ig. Magasabb értékek fenntartva a kritikus fontosságú rendszer podok számára, amelyek alapvetően nem lehetnek kiszorítva. A kiszorításra csak akkor kerül sor, ha a magas prioritású podnak nincs másik hely, ahol elhelyezkedhet, mert egyes podok az adott csomópontból evakuálásra kerülnek. Ha a mechanizmus túl szigorú az Ön számára, hozzáadhatja az opciót preemptionPolicy: Never, és ekkor nem lesz kiszorítás, a pod első lesz a sorban, és várni fog, amíg az ütemező talál neki szabad erőforrásokat.
Ezután létrehozunk egy podot, amelyben megadjuk a nevét priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Bárhány prioritási osztályt létrehozhat, de ajánlott, hogy ne essünk túlzásba (mondjuk, korlátozzuk magunkat alacsony, közepes és magas prioritásra).
Így, ha szükséges, javíthatja a kritikus szolgáltatások, például az nginx-ingress-controller, coredns stb. telepítésének hatékonyságát.
9. Optimalizálja az ETCD klasztert.
Az ETCD-t a klaszter agyának nevezhetjük. Nagyon fontos, hogy ezt az adatbázist magas szinten tartsuk működésben, mivel a „Kockában” végrehajtott műveletek sebessége tőle függ. Egy viszonylag standard és mégis jó megoldás, ha az ETCD klasztert a mester csomópontokon tartjuk, hogy minimális késleltetést érjünk el a kube-apiserverhez. Ha ez nem lehetséges, próbálja az ETCD-t minél közelebb elhelyezni, biztosítva a jó sávszélességet a résztvevők között. Figyeljen arra is, hogy hány ETCD csomópont eshet ki anélkül, hogy kárt okozott volna a klaszterben.
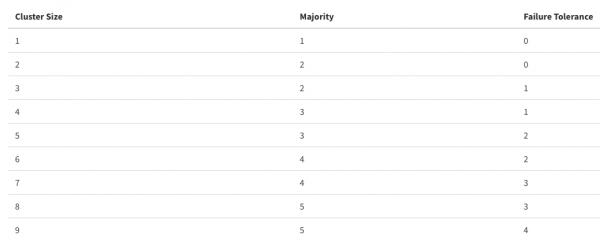
Tartsa észben, hogy a klaszterben résztvevők számának túlzott növelése fokozhatja a hibatűrést a teljesítmény rovására, mindenből a mértékletesség a kulcs.
A szolgáltatás beállításáról, ha a tanácsok kevésbé bőségesek:
Jó hardver, a klaszter méretének figyelembevételével (ezt elolvashatja. ).
Néhány paraméter finomhangolása, ha a klasztert két adatközpont között osztotta el, vagy ha a hálózata és a lemezei nem kielégítőek (ezt elolvashatja. ).
Zárás
Ez a cikk azokat a pontokat írja le, amelyeket csapatunk igyekszik betartani. Ez nem egy lépésről lépésre útmutató, hanem lehetőségek, amelyek hasznosak lehetnek a klaszter költségeinek optimalizálásához. Nyilvánvaló, hogy minden klaszter egyedi a maga módján, és a beállításokkal kapcsolatos döntések jelentősen eltérhetnek, ezért érdekes lenne hallani a véleményét: hogyan figyelemmel kíséri a Kubernetes klaszterét, mivel javítja annak működését. Ossza meg tapasztalatait a megjegyzésekben, érdekes lenne megismerni!
Forrás: habr.com
