

A Kubernetes rendszerének üzemelése alatt számos izgalmas történetet gyűjtöttünk össze, amelyekben a különböző rendszerkomponensek hibái kellemetlen és/vagy érthetetlen következményekhez vezettek, amelyek befolyásolták a konténerek és pod-ok működését. Ebben a cikkben néhány leggyakoribb vagy legérdekesebb ilyen esetet állítottunk össze. Még ha soha nem is fog szembe jönni ilyen helyzetekkel, érdekes olvasni az ilyen rövid nyomozásokról — különösen "első kézből" — nem igaz?
1. történet: Supercronic és a lefagyott Docker
Egyik klaszterünkben időnként "lefagyott" Dockert tapasztaltunk, ami megnehezítette a klaszter normális működését. A Docker naplókban a következőket figyeltük meg:
level=error msg="containerd: start init process" error="exit status 2: "runtime/cgo: pthread_create failed: No space left on device
SIGABRT: abort
PC=0x7f31b811a428 m=0

goroutine 0 [idle]:

goroutine 1 [running]:
runtime.systemstack_switch() /usr/local/go/src/runtime/asm_amd64.s:252 fp=0xc420026768 sp=0xc420026760
runtime.main() /usr/local/go/src/runtime/proc.go:127 +0x6c fp=0xc4200267c0 sp=0xc420026768
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1 fp=0xc4200267c8 sp=0xc4200267c0

goroutine 17 [syscall, locked to thread]:
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1

…
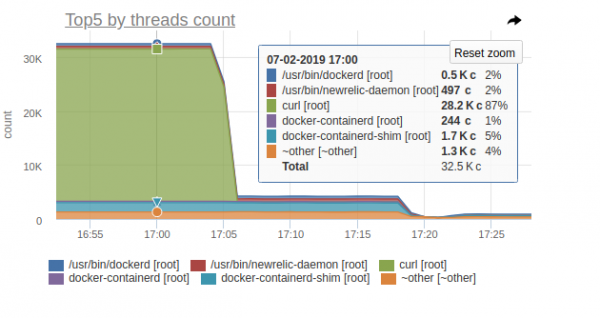
Ebben a hibában leginkább a következő üzenet érdekel minket: pthread_create failed: No space left on device. Gyors áttekintés megmutatta, hogy a Docker nem tud új folyamatot létrehozni, ami miatt időnként "lefagyott".
A folyamatok megfigyelésénél a következő képet kaptuk:
Hasonló helyzetet tapasztaltunk más csomópontoknál is:
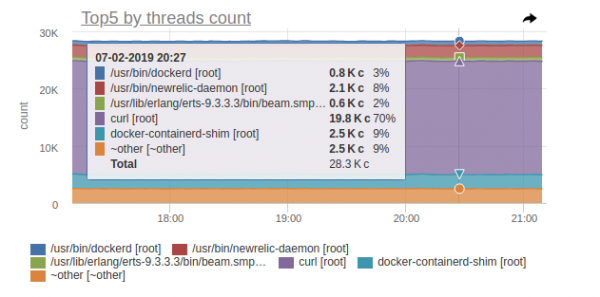
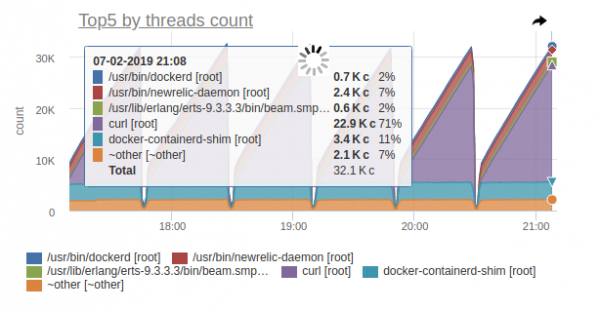
Ezeken a csomópontokon azt látjuk:
root@kube-node-1 ~ # ps auxfww | grep curl -c
19782
root@kube-node-1 ~ # ps auxfww | grep curl | head
root     16688  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     17398  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16852  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      9473  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      4664  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     30571  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     24113  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16475  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      7176  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      1090  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
Kiderült, hogy ez a viselkedés a pod működésének következménye: (Go-ban írt eszköz, amelyet cron-feladatok podokban történő futtatására használunk):
 _ docker-containerd-shim 833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 /var/run/docker/libcontainerd/833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 docker-runc
|   _ /usr/local/bin/supercronic -json /crontabs/cron
|       _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true
|       |   _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true -no-pidfile
|       _ [newrelic-daemon]
|       _ [curl]
|       _ [curl]
|       _ [curl]
…
A probléma a következő: amikor a feladat elindul a supercronic-ban, a létrehozott folyamat nem tud helyesen befejeződni, zombivá válva .
Megjegyzésilyen cikkben .
Ideiglenes megoldásként — növeljük meg a PID-ek számát a rendszerben egyszerre:
- Vagy a feladatok elindítását a supercronic-ban ne közvetlenül, hanem egy olyan eszközzel végezzük, amely képes helyesen befejezni a folyamatokat, és nem generál zombikat.
/proc/sys/kernel/pid_max (since Linux 2.5.34) This file specifies the value at which PIDs wrap around (i.e., the value in this file is one greater than the maximum PID). PIDs greater than this value are not allo‐ cated; thus, the value in this file also acts as a system-wide limit on the total number of processes and threads. The default value for this file, 32768, results in the same range of PIDs as on earlier kernels - 2. Történet. "Zombik" a cgroup eltávolításakor A Kubelet elkezdett nagy mennyiségű CPU-t fogyasztani:
Ez senkinek sem tetszik, ezért felfegyverkeztünk
és elkezdtük megvizsgálni a problémát. A vizsgálat eredménye a következő volt:
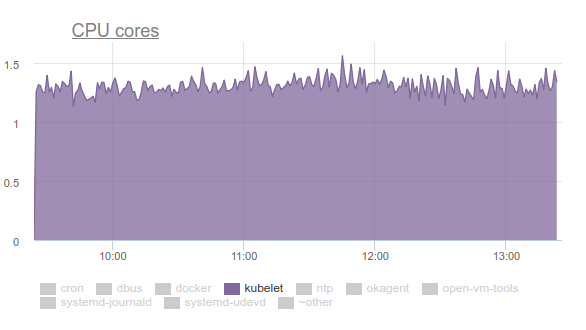
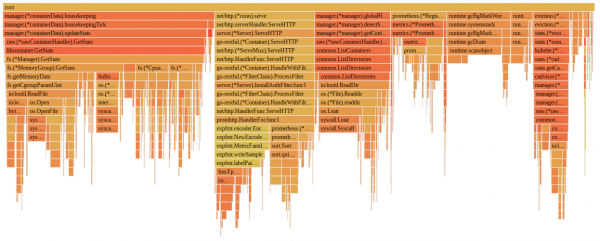
A Kubelet a CPU-idő több mint egyharmadát arra használja, hogy információt nyerjen a memóriáról az összes cgroup-ból: A kernel fejlesztői levelezésében található
- a probléma vitája.

- Röviden: a lényeg az, hogy a cgroup eltávolításakor — úgynevezett memcg zombik maradnak. zombie. Koráncson vagy később ezek a page cache-ből eltávolításra kerülnek, de a szerveren sok memória áll rendelkezésre, így a kernel nem lát értelmet az eltávolításukra való időpazarlásban. Ezért továbbra is felhalmozódnak. Miért történik ez egyáltalán? Ez egy cron-feladatokkal rendelkező szerver, amely folyamatosan új jobokat hoz létre, és velük együtt — új podokat. Így a konténerekhez új cgroupok jönnek létre, amelyek hamarosan eltávolításra kerülnek.
- Miért tölt el annyi időt a cAdvisor a kubeletben? Ezt könnyen észlelhetjük a legegyszerűbb végrehajtással
time cat /sys/fs/cgroup/memory/memory.stat. Ha egy egészséges gépen a művelet 0,01 másodpercet vesz igénybe, akkor a problémás cron02-n 1,2 másodperc. A probléma az, hogy a cAdvisor nagyon lassan olvassa az adatokat a sysfs-ből, próbálva figyelembe venni a használt memóriát és a zombie cgroupokat. - A zombik kényszerített eltávolítása érdekében megpróbáltuk megtisztítani a cache-t, ahogyan az az LKML-ben javasolt:
sync; echo 3 > /proc/sys/vm/drop_caches, — de a kernel bonyolultabbnak bizonyult, és az egész gépet lefagyasztotta.
Mit tegyünk? A probléma javítható (, a leírásat lásd a ) a Linux kernel 4.16 verzióra való frissítésével.
Történet 3. Systemd és a mount
Ismét a kubelet túl sok erőforrást fogyaszt néhány csomóponton, de ezúttal — már memóriát:
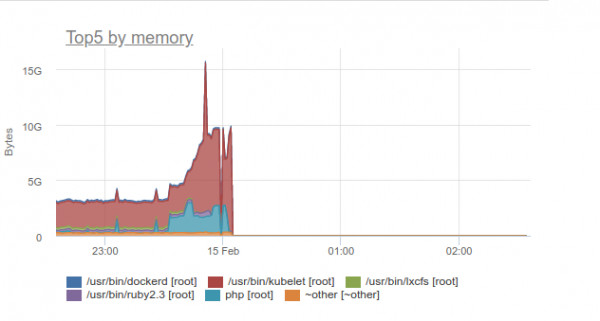
Kiderült, hogy probléma van a Ubuntu 16.04-ben használt systemd-vel, amely a mountok kezelésénél lép fel, amelyek a ConfigMapokból vagy titkokból történő csatlakozáshoz készülnek. subPath A pod leállítása után a systemd szolgáltatás és annak segédmountja a rendszerben maradnak. Idővel hatalmas mennyiség felhalmozódik belőlük. E témában még issues is létezik:
- ;
- .
… a legutolsóban hivatkoznak egy PR-re a systemd-vel kapcsolatban: (issue a systemd-ben — ).
A probléma már nem áll fenn az Ubuntu 18.04-ben, de ha továbbra is szeretné használni az Ubuntu 16.04-et, akkor hasznos lehet a számunkra készített workaround ezzel kapcsolatban.
Tehát a következő DaemonSet-et készítettük el:
---
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  labels:
    app: systemd-slices-cleaner
  name: systemd-slices-cleaner
  namespace: kube-system
spec:
  updateStrategy:
    type: RollingUpdate
  selector:
    matchLabels:
      app: systemd-slices-cleaner
  template:
    metadata:
      labels:
        app: systemd-slices-cleaner
    spec:
      containers:
      - command:
        - /usr/local/bin/supercronic
        - -json
        - /app/crontab
        Image: private-registry.org/systemd-slices-cleaner/systemd-slices-cleaner:v0.1.0
        imagePullPolicy: Always
        name: systemd-slices-cleaner
        resources: {}
        securityContext:
          privileged: true
        volumeMounts:
        - name: systemd
          mountPath: /run/systemd/private
        - name: docker
          mountPath: /run/docker.sock
        - name: systemd-etc
          mountPath: /etc/systemd
        - name: systemd-run
          mountPath: /run/systemd/system/
        - name: lsb-release
          mountPath: /etc/lsb-release-host
      imagePullSecrets:
      - name: antiopa-registry
      priorityClassName: cluster-low
      tolerations:
      - operator: Exists
      volumes:
      - name: systemd
        hostPath:
          path: /run/systemd/private
      - name: docker
        hostPath:
          path: /run/docker.sock
      - name: systemd-etc
        hostPath:
          path: /etc/systemd
      - name: systemd-run
        hostPath:
          path: /run/systemd/system/
      - name: lsb-release
        hostPath:
          path: /etc/lsb-release
… és ebben a szkriptet használják:
#!/bin/bash

# we will work only on xenial
hostrelease="/etc/lsb-release-host"
test -f ${hostrelease} && grep xenial ${hostrelease} > /dev/null || exit 0

# sleeping max 30 minutes to dispense load on kube-nodes
sleep $((RANDOM % 1800))

stoppedCount=0
# counting actual subpath units in systemd
countBefore=$(systemctl list-units | grep subpath | grep "run-" | wc -l)
# let's go check each unit
for unit in $(systemctl list-units | grep subpath | grep "run-" | awk '{print $1}'); do
  # finding description file for unit (to find out docker container, who born this unit)
  DropFile=$(systemctl status ${unit} | grep Drop | awk -F': ' '{print $2}')
  # reading uuid for docker container from description file
  DockerContainerId=$(cat ${DropFile}/50-Description.conf | awk '{print $5}' | cut -d/ -f6)
  # checking container status (running or not)
  checkFlag=$(docker ps | grep -c ${DockerContainerId})
  # if container not running, we will stop unit
  if [[ ${checkFlag} -eq 0 ]]; then
    echo "Stopping unit ${unit}"
    # stoping unit in action
    systemctl stop $unit
    # just counter for logs
    ((stoppedCount++))
    # logging current progress
    echo "Stopped ${stoppedCount} systemd units out of ${countBefore}"
  fi
done
… és ezt ötpercenként indítja el a már említett supercronic. A Dockerfile így néz ki:
FROM ubuntu:16.04
COPY rootfs /
WORKDIR /app
RUN apt-get update &&
    apt-get upgrade -y &&
    apt-get install -y gnupg curl apt-transport-https software-properties-common wget
RUN add-apt-repository "deb [arch=amd64] https://download.docker.com/linux/ubuntu xenial stable" &&
    curl -fsSL https://download.docker.com/linux/ubuntu/gpg | apt-key add - &&
    apt-get update &&
    apt-get install -y docker-ce=17.03.0*
RUN wget https://github.com/aptible/supercronic/releases/download/v0.1.6/supercronic-linux-amd64 -O
    /usr/local/bin/supercronic && chmod +x /usr/local/bin/supercronic
ENTRYPOINT ["/bin/bash", "-c", "/usr/local/bin/supercronic -json /app/crontab"]
4. történet. A podok ütemezésének versengése
Megfigyelték, hogy: ha egy pod hosszú ideig töltődik le egy csomóponton, egy másik pod, amelyik "rákerült" ugyanarra a csomópontra, egyszerűen nem kezdi el letölteni az új pod képét. Ehelyett megvárja, míg a korábbi pod képe le nem töltődik. Ennek következtében a pod, amely már betöltésre került és amelynek a képe egy perc alatt letölthető lett volna, hosszú ideig a következő státuszban marad: containerCreating.
Az események körülbelül a következőket mutatják:
Normal Pulling 8m kubelet, ip-10-241-44-128.ap-northeast-1.compute.internal pulling image "registry.example.com/infra/openvpn/openvpn:master"Ezért a egyetlen, lassú regisztrációból származó kép megakadályozhatja a telepítést a csomóponton.
Sajnos a megoldási lehetőségek nem túl széleskörűek:
- Próbálja meg közvetlenül a Docker Registry-jét használni a klaszterben vagy közvetlen a klaszterrel (például GitLab Registry, Nexus stb.);
- Használja a következő eszközöket, mint például .
5. történet. Csomópontok leállása memóriahiány miatt
Különböző alkalmazások üzemeltetése során olyan helyzetekkel is találkoztunk, amikor a csomópont teljesen elérhetetlenné vált: nem válaszolt az SSH, minden monitorozó demon leállt, és a naplókban később semmi (vagy szinte semmi) szokatlant nem találtunk.
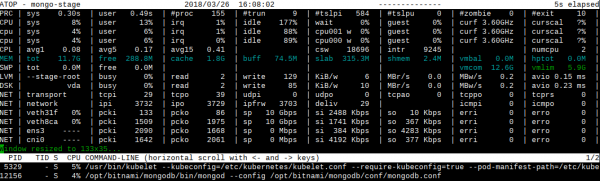
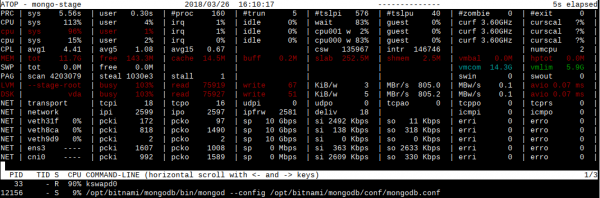
Egy képen keresztül szeretném bemutatni egy csomópont példáját, ahol a MongoDB működött.
Így néz ki az atop tól balesetek:
És így néz ki — a jelenlegi környezet parancsai után balesetek:
A monitorozás során is megfigyelhető egy hirtelen ugrás, amikor a csomópont elérhetetlenné válik:
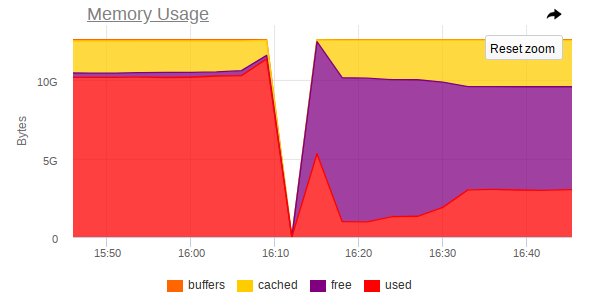
Tehát a képernyőképek alapján látható, hogy:
- A gép memóriája a végéhez közelít;
- Hirtelen ugrás tapasztalható a memóriafogyasztásban, amely után hirtelen megszűnik a hozzáférés az egész géphez;
- A MongoDB-re egy nagy feladat érkezik, amely arra kényszeríti az adatbázis-kezelő folyamatot, hogy több memóriát használjon és aktívan olvasson a lemezről.
Kiderül, hogy ha a Linux alatt elfogy a szabad memória (memory pressure lép fel), és swap hely nincs, akkor tól az OOM killer megérkezése előtt egy egyensúlyi állapot állhat be a lapok page cache-be való betöltése és azok lemezre írása között. Ezt a kswapd végzi, amely bátoran felszabadít minél több memóriát a további kiosztásokhoz.
Sajnos, magas I/O terhelés és kevés szabad memória esetén, a kswapd az egész rendszer szűk keresztmetszete válik, mert rajta múlik mindent a memória oldalainak (page faults) kijelölése a rendszerben. Ez nagyon hosszú ideig tarthat, ha a folyamatok nem akarnak több memóriát használni, és a OOM-killer szakadékának szélén ragadnak.
Jogos a kérdés: miért érkezik az OOM killer ilyen későn? Jelenlegi iterációjában az OOM killer rendkívül buta: csak akkor fog megölni egy folyamatot, amikor kudarcot vall a memóriaoldal kijelölésének megkísérlése, azaz ha a page fault hibával történik. Ez elég sokáig nem történik meg, mert a kswapd bátoran felszabadítja a memóriaoldalakat, visszaírva a page cache-t (a rendszer összes lemez I/O-ját) a lemezre. Részletesebben, a hasonló problémák megoldásához szükséges lépések leírását olvashatja .
Ez a viselkedés a Linux 4.6+ kernellel.
Történet 6. A podok várakozásban állnak
Néhány klaszterben, ahol valóban sok pod működik, kezdtük észlelni, hogy a többségük nagyon sokáig "várakozik" állapotban Várakozik, noha a Docker konténerek már elindultak a csomópontokon, és manuálisan lehet velük dolgozni.
Ekkor describe nincs semmi rossz:
  Típus   Ok                   Kor                Forrás                Üzenet
  ----    ------              ----               ----                  -------
  Normál  Ütemezve           1 perc            default-scheduler      Sikeresen hozzárendelve a sphinx-0 a ss-dev-kub07-hez
  Normál  SikeresHozzákapcsolás  1 perc            attachdetach-controller Hozzákapcsolás sikerült a "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b" kötethez
  Normál  SikeresKöthetőség     1 perc            kubelet, ss-dev-kub07  Sikeresen beállítva a kötet csatlakozása a "sphinx-config"
  Normál  SikeresKöthetőség     1 perc            kubelet, ss-dev-kub07  Sikeresen beállítva a kötet csatlakozása a "default-token-fzcsf"
  Normál  SikeresKöthetőség     49 másodperc (x2 51s alatt) kubelet, ss-dev-kub07  Sikeresen beállítva a kötet csatlakozása a "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normál  Letöltve            43 másodperc       kubelet, ss-dev-kub07  A konténer kép "registry.example.com/infra/sphinx-exporter/sphinx-indexer:v1" már jelen van a gépen
  Normál  Létrehozva          43 másodperc       kubelet, ss-dev-kub07  Konténer létrehozva
  Normál  Indítva            43 másodperc       kubelet, ss-dev-kub07  Konténer indítva
  Normál  Letöltve            43 másodperc       kubelet, ss-dev-kub07  A konténer kép "registry.example.com/infra/sphinx/sphinx:v1" már jelen van a gépen
  Normál  Létrehozva          42 másodperc       kubelet, ss-dev-kub07  Konténer létrehozva
  Normál  Indítva            42 másodperc       kubelet, ss-dev-kub07  Konténer indítva
Megvizsgálva, feltételeztük, hogy a kubelet egyszerűen nem képes időben elküldeni az API szervernek a podok állapotának teljes információját, liveness/readiness próbaként.
Tanulmányozva a segítséget, a következő paramétereket találtuk:
--kube-api-qps - QPS, amit a kubernetes apiserverrel való kommunikáció során használunk (alapértelmezett 5)
--kube-api-burst  - Kitörés, amit a kubernetes apiserverrel való kommunikáció során használunk (alapértelmezett 10)
--event-qps - Ha > 0, limitálja az események másodpercenkénti létrehozását erre az értékre. Ha 0, korlátlan. (alapértelmezett 5)
--event-burst - Az esemény rekordok maximális mérete kitörés esetén, ideiglenesen lehetővé teszi az esemény rekordok kiugrását erre a számra, miközben továbbra is betartja az event-qps-t. Csak akkor használható, ha --event-qps > 0 (alapértelmezett 10)
--registry-qps - Ha > 0, limitálja a registry pull QPS-t erre az értékre.
--registry-burst - A kitörési pullok maximális mérete, ideiglenesen lehetővé teszi a pullok kiugrását erre a számra, miközben továbbra is betartja a registry-qps-t. Csak akkor használható, ha --registry-qps > 0 (alapértelmezett 10)
Mint látható, az alapértelmezett értékek - meglehetősen kicsik, és a 90%-ban fedezik az összes szükségletet... Azonban a mi esetünkben ez nem bizonyult elegendőnek. Ezért a következő értékeket állítottuk be:
--event-qps=30 --event-burst=40 --kube-api-burst=40 --kube-api-qps=30 --registry-qps=30 --registry-burst=40… és újraindítottuk a kubelet-eket, ezután az API-szerverhez való hívások grafikonján a következő képet láttuk:
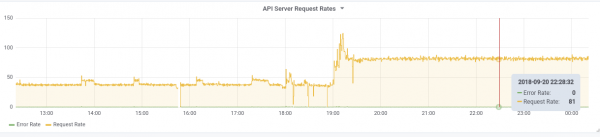
… és igen, minden elkezdett szárnyalni!
P.S.
Szeretnék köszönetet mondani cégünk számos mérnökének a hibák összegyűjtésében és a cikk előkészítésében nyújtott segítségért, különösen kutatási és fejlesztési csapatunk kollégájának, Andrej Klimentjevnek.).
P.P.S.
Olvasson további információkat a blogunkban:
- «».
- Kubernetes tippek és trükkök sorozat:
- «»;
- «»;
- «»;
- «».
Forrás: habr.com
