

Megjegyzés fordítás.: a cikk szerzői egy kis cseh cég, a pipetail mérnökei. Képesek voltak összeállítani egy csodálatos listát az [helyenként banális, de mégis] rendkívül aktuális problémákról és félreértésekről, amelyek a Kubernetes klaszterek üzemeltetésével kapcsolatosak.
A Kubernetes évek óta használva számos klaszterrel dolgoztunk (mind menedzselt, mind nem menedzselt — GCP, AWS és Azure rendszereken). Az idő múlásával észrevettük, hogy egyes hibák folyamatosan ismétlődnek. Azonban ez nem szégyen: mi magunk is elkövettük a legtöbbet közülük!
A cikkben a leggyakoribb hibák gyűjteménye található, valamint szó esik arról, hogyan lehet ezeket kijavítani.
1. Erőforrások: kérések és korlátozások
Ez a pont egyértelműen a legnagyobb figyelmet érdemli, és az első helyet foglalja el a listán.
A CPU kérés általában vagy egyáltalán nincs beállítva, vagy nagyon alacsony értékű (hogy minél több pod-ot tudjunk elhelyezni minden csomóponton). Így a csomópontok túlterhelődnek. Magas terhelés alatt a csomópont CPU teljesítménye teljesen kihasznált, és a konkrét munkaterhelés csak azt kapja, amit 'kért' a CPU throttling. Ez a válaszidők növekedéséhez, időtúllépésekhez és egyéb kellemetlen következményekhez vezet. (További részleteket olvashat a közelmúltban készült másik fordításunkban: '” — ford. megj.)
BestEffort (rendkívül nem ajánlott):
resources: {}Rendkívül alacsony CPU kérés (rendkívül nem ajánlott):
   resources:
      Requests:
        cpu: "1m"
Másrészről, a CPU korlátozásának megléte indokolatlan ciklusok elvetéséhez vezethet a pod-ok által, még akkor is, ha a csomópont CPU-ja nincs teljesen kihasználva. Ez ismét csak a válaszidők növekedéséhez vezethet. Folyamatos viták folynak a CPU CFS kvóta a Linux magban és a CPU throttlingról a beállított korlátozók függvényében, valamint a CFS kvóta letiltásáról… Sajnos a CPU korlátozások több problémát okozhatnak, mint amennyit megoldani képesek. További részletes információkért lásd az alábbi hivatkozást.
Túlzott erőforrás-elosztás (overcommiting) a memória tekintetében nagyobb problémákhoz vezethet. A CPU határ elérése ciklusok elvetésével jár, míg a memória határ elérése a pod 'meggyilkolásához' vezet. Láttad valaha az OOMkill-t? Да, речь идет именно о нем.
Szeretné minimalizálni ennek a valószínűségét? Ne ossza el a túlzott mennyiségű memóriát, és használjon Guaranteed QoS (Quality of Service), beállítva a memory request-ot a limitnek megfelelően (ahogy az alábbi példa mutatja). Erről bővebben olvashat (a Zalando vezető mérnöke).
Burstable (nagyobb valószínűség OOM killed esemény előfordulására):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Guaranteed:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
Mi segíthet a források beállításában?
A segítségével metrics-server meg lehet nézni a podok (és a bennük lévő konténerek) aktuális CPU- és memóriafogyasztását. Valószínűleg már használja ezeket. Csak futtassa a következő parancsokat:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Azonban ezek csak az aktuális használatot mutatják. Segítségükkel körülbelül tájékozódhat a nagyságrendekről, de végül szükség lesz a metrikák időbeli változásának történetére (hogy ilyen kérdésekre válaszolhasson: „Mi volt a CPU csúcsterhelése?”, „Milyen terhelése volt tegnap reggel?” — stb.). Ehhez használhatja Prometheus, DataDog és más eszközöket. Ezek egyszerűen megkapják a metrikákat a metrics-server-től és tárolják azokat, míg a felhasználó kérheti őket és megfelelő grafikonokat készíthet.
MMM-DD-YYYY a konfigurációt ez a folyamat. Nyomon követi a CPU és memória használatának történetét, és az ezen információk alapján állítja be az új kéréseket és korlátokat.
A számítási kapacitások hatékony kihasználása nem egyszerű feladat. Olyan, mintha folyamatosan Tetris-t játszana. Ha túl sokat fizet a számítási kapacitásért alacsony átlagos felhasználás mellett (mondjuk ~10 %), javasoljuk, hogy figyeljen a serverless/pay-per-usage alapú AWS Fargate vagy Virtual Kubelet termékekre. Ezek a modellek olyan körülmények között olcsóbbak lehetnek.
2. Liveness és readiness próbák
Alapértelmezetten a Kubernetes-ben a liveness és readiness állapotellenőrzések nincsenek engedélyezve. És néha el is felejtik engedélyezni őket…
De hogyan lehet mégis kezdeményezni a szolgáltatás újraindítását az elháríthatatlan hiba esetén? És hogyan tudja a terheléselosztó, hogy egy pod készen áll a forgalom fogadására? Vagy hogy képes-e nagyobb forgalmat kezelni?
Gyakran összekeverik ezeket a próbákat:
- Liveness – a „életképes” ellenőrzés, amely újraindítja a podot sikertelen leállás esetén;
- Readiness — a készség ellenőrzése, ha a próbálkozás sikertelen, akkor a pod lekapcsolódik a Kubernetes szolgáltatásról (ezt a következő parancs segítségével ellenőrizheti:
kubectl get endpoints) és a forgalom nem érkezik rá, amíg a következő ellenőrzés sikeresen le nem zárul.
Mindkét ellenőrzés A POD ÉLETTARTAMA FOLYAMÁBAN TÖRTÉNIK. Ez nagyon fontos.
Elterjedt tévhit, hogy a readiness-próbák csak a kezdeti indításkor futnak, hogy a terheléselosztó megtudja, hogy a pod készen áll (Kész) és elkezdheti a forgalom kezelését. Valójában ez csak az alkalmazásuk egyik módja.
A másik lehetőség, hogy megtudjuk, hogy a forgalom a podra túl nagy, és túlterheli azt (vagy a pod erőforrásigényes számításokat végez). Ebben az esetben a readiness-ellenőrzés segít csökkenteni a pod terhelését és 'lehűteni' azt. A sikeres readiness-ellenőrzés a jövőben lehetővé teszi a pod terhelésének növelését. Ilyen körülmények között (ha a readiness-próba meghiúsul) a liveness-ellenőrzés meghiúsulása nagyon ellenérdekeltséget jelentene. Miért indítson újra egy podot, amely egészséges és mindent megtesz?
Ezért bizonyos esetekben a teljes ellenőrzések hiánya jobb, mint a rosszul konfigurált paraméterekkel történő engedélyezésük. Ahogy korábban említettük, ha a liveness-ellenőrzés másolja a readiness-ellenőrzést, akkor nagy bajban van. Egy lehetséges megoldás, hogy , és figyelmen kívül hagyja.
Mindkét ellenőrzési típusnak nem szabad megbuknia a közös függőségek összeomlásakor, különben ez a podok lavinaszerű leállását eredményezi. Más szavakkal, .
3. LoadBalancer minden HTTP-szolgáltatáshoz
Valószínű, hogy a klaszterében vannak HTTP-szolgáltatások, amelyeket szeretne átkonfigurálni a külső világ felé.
Ha a szolgáltatást megnyitja mint type: LoadBalancer, annak vezérlője (szolgáltatótól függően) biztosítja és egyezteti a külső LoadBalancer-t (nem feltétlenül a L7-tel, inkább valószínűleg L4-en), ami megnövelheti a költségeit (külső statikus IPv4 cím, számítási kapacitás, másodperc alapú tarifázás) számos ilyen erőforrás létrehozásának szükségessége miatt.
Ebben az esetben sokkal logikusabb használni egy külső terheléselosztót, szolgáltatásokat megnyitva mint type: NodePort. Vagy még jobb, telepítsen valami ilyesmit, mint a nginx-ingress-controller SysWOW64 traefik), amely egyedülállóként fog működni. NodePort a végpont, amely a külső terheléselosztóval van összekapcsolva, és a forgalmat a klaszteren belül irányítja ingress- Kubernetes-erőforrások.
A többi belső klaszteren (mikroszolgáltatás) szolgáltatás, amelyek kölcsönhatásban állnak egymással, képes «kommunikálni» a ClusterIP és a DNS-en keresztüli beépített szolgáltatás-észlelési mechanizmus segítségével. Csak ne használja nyilvános DNS/IP címüket, mert ez késleltetést okozhat, és növelheti a felhőszolgáltatások költségeit.
4. A klaszter automatikus skálázása annak sajátosságainak figyelmen kívül hagyásával
Amikor csomópontokat ad hozzá a klaszterhez, és azokat eltávolítja, nem szabad alapvető metrikákra, például a CPUs használatára támaszkodni. A pod ütemezését számos amelyek bizonyos Legacy BIOS-ra jellemzőek;, például a podok/csomópontok affinitására, a taintokra és tolerálásokra, az erőforrásigényekre, QoS-ra stb. figyelembe véve kell elvégezni. A külső autoscaler használata, amely nem veszi figyelembe ezeket a szempontokat, problémákhoz vezethet.
Képzelje el, hogy egy pod-ot kell ütemezni, de minden elérhető CPU teljesítmény már lefoglalt,és a pod beragadt az állapotban Várakozik. A külső autoscaler az aktuális CPU terhelést látja (nem a lefoglaltat) és nem kezdeményezi a bővítést (scale-out) - nem ad hozzá egy másik csomópontot. Ennek következtében ez a pod nem lesz ütemezve.
A fordított skálázás (scale-in) - egy csomópont eltávolítása a klaszterből - mindig nehezebben valósítható meg. Képzelje el, hogy van egy stateful pod-ja (csatlakoztatott állandó tárolóval). A persistent volumenek általában egy adott rendelkezésre állási zónához tartoznak és nem replikálódnak a régióban. Így, ha a külső autoscaler eltávolít egy csomópontot ezzel a pod-dal, akkor az ütemező nem tudja ütemezni ezt a pod-ot egy másik csomópontokra, mivel ezt csak abban a rendelkezésre állási zónában lehet megtenni, ahol a tartós tároló található. A pod beragadt az állapotban . A Kubernetes közösség körében nagy népszerűségnek örvend Várakozik.
. Ez működik a klaszterben, támogatja a fő felhőszolgáltatók API-ját, figyelembe veszi az összes korlátozást és képes skálázni a fenti esetekben. Ezenkívül képes a scale-in végrehajtására az összes beállított korlátozás megőrzésével, ezáltal pénzt takarítva meg (amelyet egyébként nem használt erőforrásokra fordítanának). 5. Az IAM/RBAC lehetőségek figyelmen kívül hagyása
Vigyázzon, hogy ne használjon IAM-felhasználókat állandó titkokkal
gépek és alkalmazások számára. gépek és alkalmazásokIdeiglenes hozzáférés biztosítása szerepkörök és szolgáltatásekontekek használatával (szolgáltatási fiókok).
Gyakran szembesülünk azzal, hogy a hozzáférési kulcsok (és titkok) a program konfigurációjában 'hardcode'-olva vannak, valamint a titkok forgatásának elhanyagolásával, annak ellenére, hogy hozzáférés van a Cloud IAM-hoz. Használjon IAM szerepköröket és szolgáltatási fiókokat felhasználók helyett, ahol ez megfelelő.
Felejtsen el mindent, ami kube2iam, és lépjen egyenesen az IAM szerepkörökre a szolgáltatási fiókokhoz (ahogy azt a Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
Csak egy annotáció. Nem túl bonyolult, igaz?
Ezenkívül ne ruházzon fel szolgáltatási fiókokat és példányprofilokat admin és cluster-admin, ha erre nincs szükségük. Ezt kicsit nehezebb megvalósítani, különösen az RBAC K8s-ben, de mindenképpen megérdemli az erőfeszítést.
6. Ne támaszkodjon az automatikus anti-affinity szabályokra a pod-ok számára
Képzelje el, hogy van három replikája egy deploymentnek egy node-on. A node leáll, és vele együtt az összes replikája. Csalódást keltő helyzet, igaz? De miért volt minden replikája egy node-on? Nem kellene a Kubernetes-nek biztosítania a magas rendelkezésre állást (HA)?!
Sajnos a Kubernetes ütemező nem tartja önállóan a pod-ok elkülönített létezésére vonatkozó szabályokat. (anti-affinity) Ezeket kifejezetten meg kell határozni:
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
És ennyi. Most a pod-ok különböző node-okra lesznek ütemezve (ezt a feltételt csak az ütemezés során ellenőrzik, de nem a működésük során — innen requiredDuringSchedulingIgnoredDuringExecution).
Itt különböző node-okra beszélünk: podAntiAffinity topologyKey: "kubernetes.io/hostname" , — nem pedig különböző elérhetőségi zónákra. Az igazi HA megvalósításához kicsit mélyebbre kell ásni.7. A PodDisruptionBudget-ek figyelmen kívül hagyása
Képzelje el, hogy van egy production terhelés a Kubernetes klaszterében. Időről időre a node-okat és magát a klasztert frissíteni kell (vagy kivonni a forgalomból). A PodDisruptionBudget (PDB) egyfajta garanciavállalás az üzemeltetők és a felhasználók között.
A PDB segít elkerülni a szolgáltatások leállását, amelyet a node-ok hiánya okozhat:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
name: zk-pdb
spec:
minAvailable: 2
selector:
matchLabels:
app: zookeeperEbben a példában, mint a klaszter felhasználója, azt mondod az adminisztrátoroknak: "Szia, van egy zookeeper szolgáltatásom, és függetlenül attól, hogy mit teszel, azt szeretném, ha mindig legalább 2 példány ennek a szolgáltatásnak rendelkezésre állna."
Többet erről itt olvashatsz .
8. Több felhasználó vagy környezet egy közös klaszterben
Kubernetes névkörök (namespaces) nem biztosítanak erős elkülönítést.
Elterjedt tévhit, hogy ha egy nem-produktív terhelést egy névkörben indítunk el, a produktív terhelést pedig egy másikban, akkor azok nem befolyásolják egymást... Viszont, bizonyos szintű elkülönítést el lehet érni erőforrás-kérésekkel/korlátozásokkal, kvóták beállításával, priorityClass-ok megadásával. Egyfajta "fizikai" elkülönítést a data plane-ben az affinities, tolerations, taints (vagy nodeselectors) biztosítanak, azonban az ilyen típusú elválasztás meglehetősen nehéz megvalósítani.
Akiknek mindkét típusú terhelést kell együtt futtatniuk egy klaszterben, nehézségekkel kell szembenézniük. Ha viszont ilyen igény nincs, és megengedhető egy további klaszter fenntartása (például egy nyilvános felhőben), akkor talán érdemes ezt tenni. Ez sokkal magasabb szintű elkülönítést tesz lehetővé.
9. externalTrafficPolicy: Cluster
Nagyon gyakran tapasztaljuk, hogy a klaszterbe beérkező forgalom teljes egészében egy NodePort típusú szolgáltatáson keresztül érkezik, amelynél alapértelmezés szerint a externalTrafficPolicy: Clusterpolitika van beállítva. Ez azt jelenti, hogy NodePort minden csomóponton nyitva van a klaszterben, és bármelyiküket használhatjuk a szükséges szolgáltatással (pod-csoporttal) való interakcióra.
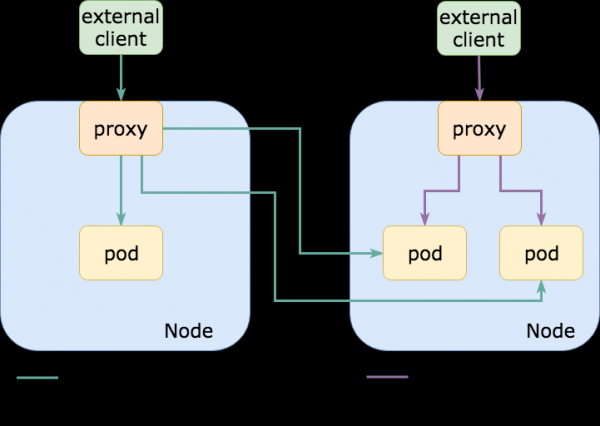
Ugyanakkor a fent említett NodePort szolgáltatáshoz kapcsolódó valós pod-ok általában csak egy szubkészletén találhatók ezeknek a csomópontoknak.Más szavakkal, ha csatlakozom egy olyan csomóponthoz, ahol nincs a szükséges pod, az átirányítja a forgalmat egy másik csomópontra, hozzáadva egy tranzit szakaszt (hop) és növelve a késleltetést (ha a csomópontok különböző elérhetőségi zónákban/adatközpontokban vannak, a késleltetés meglehetősen magas lehet; emellett nőhet az egress forgalom költsége).
Másrészről, ha egy Kubernetes szolgáltatás esetében a externalTrafficPolicy: Localbe van állítva, akkor a NodePort csak azokon a csomópontokon nyílik meg, ahol ténylegesen futnak a szükséges pod-ok. Ha külső terheléselosztót használunk, amely ellenőrzi (healthchecking) az endpointokat (ahogy ezt teszi a AWS ELB), akkor csak a szükséges csomópontokra fogja irányítani a forgalmat., ami kedvezően hat a késleltetésekre, a számítási szükségletekre és az egress költségekre (és a józan ész is ezt diktálja).
Nagy valószínűséggel már használ valamilyen megoldást, traefik vagy nginx-ingress-controller mint végső NodePort pontot (vagy LoadBalancer-t, amely szintén NodePort-ot használ) a HTTP ingress forgalom irányítására, és ennek az opciónak a beállítása jelentősen csökkentheti a késleltetést az ilyen kérések esetén.
A többet megtudhat az externalTrafficPolicy-ról, annak előnyeiről és hátrányairól.
10. Ne ragaszkodjon a klaszterekhez, és ne zsarnokoskodjon a vezérlő réteggel.
A korábbi időkben a szervereket saját nevek alapján szokták hívni: , HAL9000 és Colossus… Ma már véletlenszerűen generált azonosítók váltották fel őket. Azonban a szokás megmaradt, és most már a klaszterek kapják meg a személyes neveket.
Tipikus történet (valós eseményeken alapul): minden a koncepció bizonyításával kezdődött, így a klaszter büszke nevet viselt. tesztelés… Évek teltek el, és még mindig használják production környezetben, és mindenki fél hozzáérni.
Nincs benne semmi vicces, hogy a klaszterek házikedvenccé válnak, így ajánljuk, hogy időnként törölje őket, közben gyakorolva a hibák utáni helyreállítást (ebben segíthet a — a fordító megjegyzése). Emellett érdemes foglalkozni a vezérlő réteggel is, (control plane). A félelem, hogy hozzáérjen, nem túl jó jel. Az Etcd halott? Fiúk, tényleg bajba kerültetek!
Másrészt nem kellene túlzásba vinni a manipulációját. Idővel a vezérlő réteg lassúvá válhat.Valószínű, hogy ez a nagy számú létrehozott objektumok miatti rotálás hiányával van összefüggésben (általános helyzet Helm alapértelmezett beállításainál, mivel az állapot nem frissül a configmap-okban/titkokban — ennek következményeként ezernyi objektum halmozódik fel a vezérlő rétegben) vagy a kube-api objektumok folyamatos szerkesztésével (automatikus skálázás, CI/CD, monitorozás, eseménynaplók, vezérlők stb.).
Ezenkívül érdemes ellenőrizni a managed Kubernetes szolgáltató SLA/SLO megállapodásait és figyelni a garanciákra. A szolgáltató garantálhatja a vezérlő réteg rendelkezésre állását (vagy annak alkotóelemeit), de nem a p99 kérések késleltetését, amelyeket hozzá küld. Más szavakkal, be lehet vezetni kubectl get nodes, de a választ csak 10 perc múlva kapod meg, ami nem sérti a szolgáltatási szerződés feltételeit.
11. Bónusz: a latest címke használata
Ez már klasszikus. Az utóbbi időben ritkábban találkozunk ezzel a technikával, mivel sokan, a keserű tapasztalatok tanulságait levonva, abbahagyták a címke használatát :latest és elkezdték rögzíteni (pin) a verziókat. Ügyes!
ECR ; ajánljuk, hogy ismerkedj meg ezzel a figyelemre méltó tulajdonsággal.
Összefoglaló
Ne várd, hogy minden az ujjaid között működjön: a Kubernetes nem csodaszer. Egy gyenge alkalmazás (és lehet, hogy még rosszabbá válik). A gondatlanság túlzott bonyolultsághoz, lassú és feszült vezérlő réteghez vezet. Ezen kívül kockázatot vállalsz a helyreállítási stratégia hiányával. Ne számíts arra, hogy a Kubernetes „dobozból ki” biztosítani fogja az elszigeteltséget és a magas rendelkezésre állást. Szánj időt arra, hogy az alkalmazásodat valóban cloud native-né tedd.
A különböző csapatok balsikeres tapasztalataival ismerkedhetsz meg Henning Jacobs-tól.
Akik szeretnék kiegészíteni a cikkben felsorolt hibák listáját, kapcsolatba léphetnek velünk Twitteren (, ).
Fejlesztési eszközök, amelyek Kubernetesben futnak
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «» (az előadás áttekintése és videója);
- «».
Forrás: habr.com
