

Július 11-12-én Szentpéterváron konferenciát tartanak , amely a párhuzamos és elosztott rendszerek fejlesztéséről szól. A Hydra sajátossága, hogy összegyűjti a kiváló kutatókat (akiket általában csak a külföldi tudományos konferenciákon lehet megtalálni) és elismert gyakorló mérnököket egy nagy program keretében, a tudomány és a gyakorlat határvonalán.
A Hydra az egyik legfontosabb konferenciánk az elmúlt években. Előzetesen nagyon komoly előkészületek, előadók és előadások kiválasztása előzte meg. A múlt héten megjelent erről JUG.ru Group ügyvezető igazgatójával, Alexei Fedorovval ().
Mi a három fontos résztvevőről, a elosztott rendszerek elméletének megalapozóiról — Leslie Lamport, Maurice Herlihy és Michael Scott. Itt az ideje, hogy részletesebben beszéljünk az egész programról!
Motiváció
Ha programozással foglalkozik, akkor valamilyen formában biztosan találkozik a több szálú feldolgozással és az elosztott számításokkal. A megfelelő területek szakértői közvetlenül dolgoznak ezekkel, de az elosztottság mindenütt jelen van: bármilyen többmagos számítógépben vagy elosztott szolgáltatásban találunk valamit, amely párhuzamosan végez számításokat.
Számos konferencia létezik, amelyek az alkalmazott programozás különböző aspektusait tárják fel. A spektrum másik végén pedig különféle tudományos iskolák vannak, amelyek előadások formájában rengeteg bonyolult elméletet tárgyalnak. Például a Hydra mellett Szentpéterváron . a konferencián a Hydra célja az volt, hogy ötvözze a szigorú gyakorlatot és a tudományt, mindazt, ami ezen a határvonalon található.
Gondolkodjon el ezen: egy csodálatos időben élünk, amikor személyesen találkozhatunk a tudomány és mérnöki terület alapítóival, amelyekkel foglalkozunk. A fizikusok nem találkozhatnak sem Newtonnal, sem Einsteinnel — a vonat elment. De még mindig közöttünk élnek azok, akik megalapozzák elosztott rendszerek elméletét, népszerű programozási nyelveket álmodtak meg, és először valósították meg mindezt működő prototípusokká. Ezek az emberek nem hagyták abba a munkájukat félúton, éppen most is aktuális problémákkal foglalkoznak világszerte ismert egyetemeken és cégeknél, és napjaink legnagyobb tudásforrásai és tapasztalatai.
Másrészt a velük való találkozás lehetősége általában pusztán elméleti marad: alig néhányan tudják folyamatosan figyelni a nyilvános eseményeket bármely rochesteri egyetemen, hogy aztán az Egyesült Államokba rohanjanak, majd vissza az órára Michael Scotthoz. Az összes Hydra résztvevő meglátogatása egy kisebb vagyont érne, nem beszélve az elvesztegetett idő tengeréről (bár ez érdekes küldetésnek hangzik).
Másrészt rengeteg kiváló mérnökünk van, akik éppen most dolgoznak a megosztott rendszerek aktuális problémáin, és biztosan van mondanivalójuk. De itt a probléma: ők dolgozik, és az idejük drága. Igen, ha te a Microsoft, a Google vagy a JetBrains munkatársa vagy, az esélyeid, hogy a híres előadók egyikével egy belső eseményen találkozz, érdemben megnőnek, de valójában — nem minden nap fordul ez elő.
Így a Hydra konferencia egy fontos feladatot lát el, amelyet a legtöbben nem tudnánk saját magunk megvalósítani — egy időben és egy helyen összegyűjti azokat az embereket, akiknek az ötletei, vagy akikkel való kapcsolattartás megváltoztathatja az életedet. El tudom képzelni, hogy nem mindenki számára fontosak a megosztott rendszerek, vagy bizonyos bonyolult alapvető dolgok. Egész életedben kódolhatsz CRUD-okat PHP-ban, és teljesen boldog lehetsz. De akiknek szükségük van rá — ez a te esélyed.
A Hydra konferencia első bejelentése óta, ami a Habrán történt, már eltelt egy kis idő. Ezalatt hatalmas munka zajlott — és íme, itt van a beszédek majdnem teljes listája. Nincsenek döcögős, egy szálon futó algoritmusok, csak tiszta elosztott hardcore! Fejezzük be a közhelyekkel, és nézzük meg, mit tudunk most.
Főelőadások
A főelőadások nyitják és zárják a konferencia napjait. Általában a nyitó főelőadás célja, hogy meghatározza a konferencia általános szellemét és irányát. A záró főelőadás összegzi a tanultakat, és megmagyarázza, hogyan éljünk a konferencia során megszerzett tudással és készségekkel. A kezdet és a vég: ami a legjobban megmarad, és egyáltalán is fokozott jelentőséggel bír.
Cliff Click —
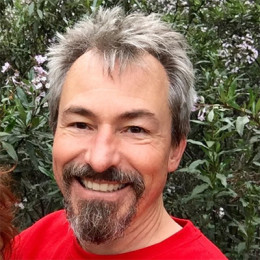 Cliff a Java világának legendája. Az 1990-es évek végén PhD-diszertációja számára írta a "Combining Analyses, Combining Optimizations" című munkát. , amely idővel a HotSpot JVM Server Compiler alapjául szolgált. Két évvel később már a Sun Microsystems-nél dolgozott a JVM-en, és megmutatta a világnak, hogy a JIT-nek van létjogosultsága. Ez a történet arról szól, hogy a Java az egyik leggyorsabb modern futtatókörnyezet, a legokosabb és leggyorsabb optimalizálásokkal, amely éppen Cliff Click-től származik. Kezdetben azt gondolták, hogy ha valami elérhető egy statikus fordító számára, akkor azt nem is érdemes próbálkozni JIT-tel. Cliff és csapata munkájának köszönhetően az összes új nyelv azzal az elképzeléssel kezdett el készülni, hogy a JIT-fordítás alapértelmezett legyen. Természetesen ez egy ember munkája volt, de Cliff nagyon fontos szerepet játszott benne.
A nyitó főelőadásában Cliff a másik kezdeményezéséről fog beszélni — , egy memóriaalapú platform a nagyiként skálázható, elosztott gépi tanuláshoz ipari alkalmazásokhoz. Pontosabban — egy elosztott kulcs-érték tárról beszél majd benne. Ez egy nagyon gyors tároló, rengeteg érdekes tulajdonsággal (a pontos lista elérhető a ), amelyek lehetővé teszik az ilyen megoldások használatát a nagy adatok streaming matematikájában.
Egy másik előadás, amellyel Cliff fellép — . Életrajza másik része — tíz év , ahol sok mindent frissített és javított az Azul hardverén és technológiai stackjén: JIT fordítók, futtatókörnyezet, szálmodell, hiba kezelés, veremkezelés, hardveres megszakítások, osztályok betöltése és így tovább, érted.
A legérdekesebb rész akkor kezdődött, amikor hardvert készítettek a nagy business számára — szuperszámítógép a Java futtatására. Ez egy elég innovatív dolog volt, kifejezetten Java-ra tervezve, amely különleges igényekkel rendelkezik — memóriaolvasási korlátok az alacsony késleltetésű memóriafelszabadításhoz, határellenőrzéses tömbök, virtuális hívások... Az egyik legmenőbb technológia a hardveres tranzakciós memória volt. Az L1 minden 864 magjának részt kellett vennie a tranzakciós írásban, ami különösen fontos a Java-ban a zárolásokkal való munka során (a synchronized blokkok párhuzamosan működhetnek, amíg nincs valódi memóriaütközés). De a szép elképzelés a kemény valósággal ütközött — és ebben az előadásban Cliff elmondja, miért nem illeszkedik jól a HTM és STM a gyakorlati igényekhez a több szálon történő számítások esetében.
Michael Scott —
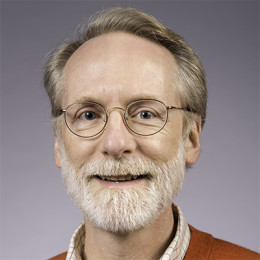 — a Róchester Egyetem számítástechnikai professzora, akivel a sors már 34 éve összekapcsolta, A világ minden táján ismerik Michaelt a
«Programming Language Pragmatics» «Algorithms for scalable synchronization on shared-memory multiprocessors» kapott nyilvánosan elérhető «Simple, Fast, and Practical Non-Blocking and Blocking Concurrent Queue Algorithms» .
java.util.concurrent.ThreadPoolExecutor . Ha előre érdekli, mik is ezek a «Két adatstruktúra», akkor erről vana megfelelő munka .
A blokkláncok és a jövő elosztott számítástechnikája
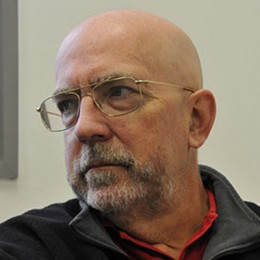 (Brown Egyetem), a második pedig, frissebb, — (Virginia Tech Egyetem). A Dijkstra-díjat azoknak a munkákért adják, amelyek jelentősége és hatása legalább tíz éven át észlelhető, és nyilvánvaló, hogy Maurice a legismertebb szakemberek közé tartozik ezen a téren. Jelenleg a Brown Egyetem professzora, és számos érdeme van egy teljes bekezdés hosszúságban. A záró főelőadásban Maurice a blokkláncok elosztott rendszereinek elméletéről és gyakorlatáról beszél majd a klasszikus elosztott számítástechnika szempontjából, valamint arról, hogyan egyszerűsíti ez számos kapcsolódó problémát. Ez a beszéd kifejezetten a konferencia témájához kapcsolódik — nem a bányászati lázról szól, hanem inkább arról, hogyan használhatjuk tudásunkat elképesztően hatékonyan és relevánsan a legkülönbözőbb feladatokhoz.
2017 júliusában Maurice már járt Oroszországban az SPTDC iskolán, részt vett a JUG.ru meet upon, és a felvételt megnézheti a YouTube-on:
Fő program
A főprogram
Ezután egy rövid áttekintés következik a programba bevont előadásokról. Néhány előadás részletesen van leírva, míg mások röviden. A hosszú leírások főként az angol nyelvű előadásokra vonatkoznak, amelyek tudományos munkákra, Wikipédia-terminológákra stb. utalnak. A teljes lista elérhető . A lista a weboldalon folyamatosan frissül és bővül.
Leslie Lamport —
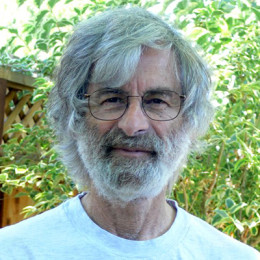 Leslie Lamport a diszkrét számítástechnikában alapvető munkák szerzője. a «Lamport TeX» rövidítése. Ő vezette be először, még 1979-ben a fogalmat , és a cikkét Dijkstra-díjat kapott.
Ez a program legszokatlanabb formátumú része, mert nem is egy előadás, hanem egy kérdés-válasz szekció. Mivel a közönség jelentős része már ismeri (vagy megismerheti) a 'Lamport-elmélet' alapú különféle munkákat, saját cikkeivel és előadásaival, a legfontosabb, hogy minden rendelkezésre álló időt közvetlen kapcsolattartásra fordítsunk.
Az ötlet egyszerű: két előadást néz a YouTube-on: és és készítesz legalább egy kérdést, amire Leslie válaszol.
E két videó közül az elsőt már . Ha nincs egy órád a videó megtekintésére, gyorsan elolvashatod mindezt szöveges formában.
Megjegyzés: a YouTube-on sokkal több videó található Leslie Lamportról. Például van egy remek . A kurzus offline verziója elérhető a , a YouTube-on pedig átkonvertálta, hogy kényelmesebben nézhesd mobilkészülékeken.
Martin Kleppmann —
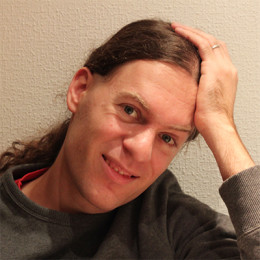 Martin Kleppmann a Cambridge-i Egyetem kutatója, aki CRDT és algoritmusok formális ellenőrzésén dolgozik. Martin könyve , amely 2017-ben jelent meg, nagyon sikeres lett, és a tárolási és feldolgozási adatok terén bestseller listákra került. Kevin Scott, a Microsoft CTO-ja : «Ez a könyv kötelező olvasmány a fejlesztő mérnökök számára. Ez egy ritka forrás, amely ötvözi az elméletet és a gyakorlatot, segítve a fejlesztőket a rendszerek és az adatok feldolgozásának intelligensebb tervezésében és megvalósításában». Hasonlót mondott Kafka megalkotója és a Confluent CTO-ja, Jay Kreps is.
Mielőtt akadémiai kutatásokba kezdett volna, Martin a iparban dolgozott, és két sikeres start-up társalapítója lett:
- a Rapportive, amely a kapcsolataink közötti közösségi profil adatainak megjelenítésére szolgált, amelyet a LinkedIn vásárolt meg 2012-ben;
- a Go Test It, ami egy automatikus webhelyellenőrző szolgáltatás különböző böngészőkben, amelyet a RedGate vásárolt meg 2009-ben.
Összességében Martin, bár kevésbé ismert, mint a keynote előadóink, máris hozzájárult a elosztott számítástechnika és az ipar fejlődéséhez.
Ebben az előadásban Martin egy olyan témáról fog beszélni, amely közelebb áll az akadémiai kutatásaihoz. A Google Docs és a hasonló közös szerkesztési szoftverek esetében a 'közös szerkesztés' feladata a replikáció: minden felhasználónak saját replikája van a közös dokumentumról, amelyet módosítanak, és minden változást a hálózaton keresztül küldenek a többi résztvevőnek. A dokumentumok offline módosítása átmeneti inkonzisztenciát okoz a dokumentumban a többi résztvevőhöz képest, és a reintegrálás konfliktusok feldolgozását igényli. Éppen ezért léteznek (CRDT), lényegében egy viszonylag új dolog, amelynek lényegét mindössze 2011-ben fogalmazták meg. Ebben az előadásban arról lesz szó, hogy mi történt azóta a CRDT világában, mik a legfrissebb eredmények, és arról is, hogy milyen megközelítést alkalmaznak a local-first alkalmazások létrehozásában egyáltalán, és a nyílt forráskódú könyvtár használatával konkrétan.
A jövő héten közzéteszünk egy hosszú interjút Martinnal a Habron, érdekes lesz.
Pedro Ramalhete —
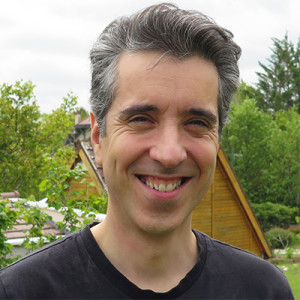 Pedro a Cisco-nál dolgozik, és az elmúlt körülbelül tíz évben párhuzamos algoritmusokat fejleszt, beleértve a szinkronizációs mechanizmusokat, lock-free és wait-free adatstruktúrákat, és mindent, amire csak gondolni lehet e témában. Jelenlegi tudományos és mérnöki érdeklődése a Universal Constructions, Software Transactional Memory, Persistent Memory és hasonló technológiákra összpontosul, amelyek lehetővé teszik a helyes, skálázható és hibabiztos alkalmazások megvalósítását. Emellett ő a szűk körökben széles körben ismert .
A párhuzamos adatszerkezeteken jelenleg a legtöbb párhuzamos alkalmazás működik, kezdve a színészek közötti üzenetsorok használatával és befejezve a kulcs-érték tárolókban található indexelt adatszerkezetekkel. A Java JDK-ban sikeresen működnek évek óta, és a C++-ban is fokozatosan hozzáadódnak.
A legegyszerűbb módja a párhuzamos adatszerkezet megvalósításának a soros (egyszálú) megvalósítás, ahol a metódusok védve vannak mutexekkel. Ezt bármely junior meg tudja valósítani, de nyilvánvalóan problémái vannak a skálázhatósággal és a teljesítménnyel. Ugyanakkor a lock-free és wait-free adatszerkezetek nemcsak hogy jobban kezelik a hibákat, hanem kedvezőbb teljesítmény-profiljuk is van – azonban a fejlesztésükhöz mély szakértelem és a specifikus alkalmazási módra való alkalmazás szükséges. Egyetlen rossz kód sor is elegendő ahhoz, hogy mindent tönkretegyen.
Hogyan lehet elérni, hogy még a nem szakértők is tudjanak ilyen adatszerkezeteket tervezni és megvalósítani? Ismert, hogy bármely szekvenciális algoritmus párhuzamosan biztonságossá tehető, akár , akár tranzakciós memóriával. Mindkettővel csökkenthető a belépési küszöb a probléma megoldásába. Azonban ez a két megoldás általában hatástalan megvalósításhoz vezet. Pedro arról fog beszélni, hogyan sikerült ezeket a szerkezeteket hatékonyabbá tenni, és hogyan használhatók algoritmusainkban.
Heidi Howard —
 Heidi Howard — akárcsak Martin, a Cambridge-i Egyetem disztribútált rendszerek kutatója. Szakterülete a konzisztencia, hibatűrés, teljesítmény és disztribútált konszenzus. Legismertebb a Paxos algoritmusának az általánosításával, amit .
Emlékeztetjük, hogy — a konszenzusproblémák megoldására szolgáló protokollok családja, amely a megbízhatatlan számítógépek hálózatában működik, Leslie Lamport munkáira alapozva. Így a mi előadóink közül többen olyan problémákon dolgoznak, amelyeket az előző előadóink javasoltak — és ez csodálatos.
A lehetőség, hogy konszenzusra jussunk több host között – címezés, vezető kiválasztás, blokkolás vagy koordináció – alapvető kérdés a modern elosztott rendszerekben. A Paxos jelenleg a konszenzuskeresés alapvető módja, és számos kutatás folyik körülötte, amely a algoritmus különböző gyakorlati igényekhez való kiterjesztését és optimalizálását célozza.
Ebben a tanulmányban felülvizsgáljuk a Paxos elméleti alapját, enyhítve az eredeti követelményeket és általánosítva az algoritmust. Láthatjuk, hogy a Paxos lényegében csak az egyik lehetőség a végtelen spektrumú konszenzusmegoldások közül, és hogy a spektrum más pontjai is rendkívül hasznosak lehetnek a jó elosztott rendszerek kiépítésében.
Alex Petrov —
 Alex adatbázis- és tárolórendszer-szakértő, és ami számunkra a legfontosabb — committer a . Jelenleg az O’Reilly-vel dolgozik az 'Adatbázis Belvilág' című könyvén.
A rendszerek számára (a magyar terminológiában – 'végső konzisztencia'), egy csomópont leállása vagy a hálózat szétszakadása után a következő dilemmát kell megoldani: folytassuk a lekérések kezelését, feladva a konzisztenciát, vagy tagadjuk meg a teljesítést, feladva a rendelkezésre állást. Egy ilyen rendszerben a kvórumok, az átfedő csomópontok, amelyek garantálják, hogy legalább egy csomópont rendelkezik a legfrissebb értékkel, jó határmegoldást jelenthetnek. Át lehet vészelni a kieséseket és a kapcsolatvesztést bizonyos csomópontokkal, folytatva a legfrissebb értékekkel való válaszadást.
Mindazonáltal mindennek ára van. A kvórum replikációs séma magasabb tárolási költséget jelent: redundáns adatokat kell tárolni több csomóponton, hogy garantáljuk a megfelelő számú elérhető másolatot a probléma felmerülésekor. Kiderült, hogy nem szükséges minden adatot minden replikán tárolni. Csökkenthetjük a tárolási terhelést, ha az adatokat csak egyes csomópontokon tartjuk, és a hiba kezelésére speciális csomópontokat (Átmeneti Replika) használunk.
A tanulmány során áttekintjük a replikációs sémáját, amelyet a és használ, és ennek a koncepciónak a megvalósítását az Apache Cassandra-ban, a következő nevekkel: .
Dmitry Vyukov —
 Dmitrij — a developer at Google, working on dynamic testing of C/C++ and Go — Address/Memory/ThreadSanitizer, and similar tools for the Linux kernel. He contributed to Go’s scalable goroutine scheduler, network poller, and concurrent garbage collector. He is an expert in multithreading, the author of a dozen new non-blocking algorithms, and holds the Intel.
Now a bit about the report itself. The Go language has built-in support for multithreading in the form of goroutines (lightweight threads) and channels (FIFO queues). Thanks to these mechanisms, users can easily and pleasantly write modern multithreaded applications, and it feels like magic. As we know, there’s no magic here. In this report, Dmitrij will dive into the intricacies of how the Go scheduler works and reveal the secrets of implementing this "magic". He will start with an overview of the scheduler's main components, explaining how it works. Next, we will get to know specific aspects such as parking/unparking strategies and handling blocking system calls. Finally, Dmitrij will talk a little about potential improvements in the scheduler.
Dmitrij Bugajčenko —
 Dmitrij has worked in outsourcing for almost 9 years, while maintaining contact with the university and the academic environment. Analyzing big data at Odnoklassniki provided him with a unique opportunity to combine theoretical training and scientific foundation with the development of real, in-demand products.
Distributed graph analysis has been and remains a challenging task: when there is a need to obtain information about the connections of a neighboring vertex, data often has to be transferred between machines, which increases execution time and load on network infrastructure. In this report, we will see how significant processing acceleration can be achieved using probabilistic data structures or facts like the symmetry of friendship graphs in social networks. All of this will be illustrated with code examples on Apache Spark.
Denis Ryscov —
 Denis is a developer , a model checking expert in consistency models, consensus algorithms, and distributed transactions. He is currently working at Microsoft, and prior to that, he worked on distributed systems at Amazon and Yandex.
In this presentation, we will explore distributed transaction protocols developed over the last few years that can be implemented on the client side over any data store that supports condition-based updates (compare and set). The essence is that life does not end with a two-phase commit; transactions can be added over any databases — at the application level, but different protocols (2PC, Percolator, RAMP) come with different trade-offs and are not provided to us for free.
Alexey Zinovyev —
 Alexey () is our longtime speaker and member of program committees at other conferences. A practicing trainer at EPAM Systems, he has been working with Hadoop/Spark and other big data technologies since 2012.
In this presentation, Alexey will discuss the challenges of adapting classical machine learning algorithms for execution in a distributed mode based on his experience with Apache Spark ML, Apache Mahout, Apache Flink ML, and his experience developing Apache Ignite ML. Alexey will also cover the implementation of distributed ML algorithms in these frameworks.
And to conclude — two presentations from Yandex about Yandex Database.
Vladislav Kuznetsov —
 Vladislav is a developer at Yandex in the distributed platform group. Yandex Database is a horizontally scalable, geo-distributed, fault-tolerant DBMS that withstands failures of disks, servers, racks, and data centers without compromising consistency. To ensure fault tolerance, a proprietary algorithm for achieving distributed consensus is used, along with a number of technical solutions that are discussed in detail in the presentation. This presentation may be of interest to both DBMS developers and developers of application solutions based on DBMS.
Semyon Checherinda —
 Semyon is a developer in the distributed platform group at Yandex, working on the possibility of multi-tenant usage of YDB installations.
A Yandex Database is designed for OLTP queries and meets ACID requirements for transactional systems. The report will cover the transaction planning algorithm underlying the YDB transaction system. We will explore which entities are involved in transactions, who assigns a global order to transactions, and how atomicity, reliability, and a strict level of isolation are achieved. Using a common task as an example, we will discuss transaction implementations employing two-phase commit and deterministic transactions, as well as their differences.
Mi következik?
The conference program continues to be filled with new presentations. In particular, we expect a presentation from Nikita Koval () from JetBrains and Oleg Anastasyev () from Odnoklassniki. Nikita works on algorithms for coroutines in the Kotlin team, while Oleg develops architecture and solutions for high-load systems on the Odnoklassniki platform. Additionally, there is one more conditionally empty slot, which the program committee is currently working on.
The Hydra conference will take place on July 11-12 in Saint Petersburg. Tickets are available . Please note that Online tickets are available—if, for any reason, you cannot make it to St. Petersburg in person on those days.
Találkozunk a Hydrán!
Forrás: habr.com
