

Ez egy mítosz, amely a szerverhardver területén elterjedt. A gyakorlatban azonban a hiperkonvergált megoldások (amikor minden egyben van) sokféle célra szükségesek. Történelmileg az első architektúrákat az Amazon és a Google fejlesztette ki saját szolgáltatásaik számára. Akkor a cél az volt, hogy egy homogén csomópontokból álló számítási farmot hozzanak létre, ahol minden egyes csomópont saját meghajtókkal rendelkezik. Mindez egy rendszeralkotó szoftver (hypervisor) segítségével egyesült, és virtuális gépekre oszlott. A fő cél: a lehető legkevesebb erőfeszítés egy csomópont karbantartására és a problémák minimalizálása a skálázás során: csak vásárolni kellett ezer másik hasonló szervert és csatlakoztatni mellé. A gyakorlatban ezek egyedi esetek, és sokkal gyakrabban a kevesebb csomópont és valamivel eltérő architektúra jön szóba.
De az előny továbbra is ugyanaz – hihetetlen egyszerűség a skálázásban és a kezelésben. Hátrány – a különböző feladatok különböző mértékben használják az erőforrásokat, így például egyes helyeken sok helyi meghajtó, másutt pedig kevés RAM található, tehát különböző feladattípusok esetén csökken a források kihasználtsága.
Így kiderült, hogy 10-15%-kal többet fizet az egyszerű beállításért. Ez okozta a fenti mítoszt. Hosszú ideig kerestük, hol alkalmazható optimálisan a technológia, és megtaláltuk. Az a helyzet, hogy a Cisco-nak nem volt saját tárolórendszere, de meg akarta szerezni a teljes szerverpiacot. Így megszületett a Cisco Hyperflex – egy megoldás helyi tárolókkal a csomópontokon.
És ebből egyszer csak egy nagyon jó megoldás született a tartalék adatközpontok számára (Disaster Recovery). Miért és hogyan – most elmesélem. És bemutatom a klaszter teszteket.
Ahol szükség van rá
A hiperkonvergencia az:
- A meghajtók áthelyezése a számítási csomópontokba.
- Teljes integráció az adattárolási alrendszer és a virtualizációs alrendszer között.
- Áthelyezés/integráció a hálózati alrendszerrel.
Ez a kapcsolat lehetővé teszi számos tárolási funkció megvalósítását a virtualizáció szintjén, mindezt egyetlen kezelőfelületről.
Cégünknél nagyon keresettek a tartalék adatközpontok tervezésére irányuló projektek, és gyakran választanak hiperkonvergált megoldást a sok replikációs lehetőség (a metróklasztertől kezdve) révén, amely alapértelmezettként elérhető.
A tartalék adatközpontok esetében általában egy másik városban lévő távoli objektumról van szó, amely lehetővé teszi a kritikus rendszerek helyreállítását a fő adatközpont részleges vagy teljes leállása esetén. Az adatok folyamatosan replikálódnak a termelési környezetből, és ez a replikáció lehet alkalmazásszintű vagy blokk eszköz szintű (tárolórendszer).
Ezért most elmondom a rendszer felépítését és a teszteket, majd pedig néhány valós használati forgatókönyvet az megtakarítási adatokkal kapcsolatban.
Tesztelés
A példányunk négy szerverből áll, mindegyikben 10 SSD-meghajtóval, 960 GB kapacitással. Van egy dedikált meghajtó az írási műveletek gyorsítótárazásához és a szolgáltató virtuális gép tárolásához. Maga a megoldás a negyedik verzió. Az első nyilvánvalóan gyerekcipőben járt (a vélemények alapján), a második még mindig gyerekes, a harmadik már elég stabil, ezt pedig a nyilvános bétatesztelés befejezése utáni kiadásnak nevezhetjük. A tesztelés során problémát nem tapasztaltam, minden zökkenőmentesen működik.
Változások a v4-benSok hiba javítva lett.
Kezdetben a platform csak a VMware ESXi hipervízorral működött és csak kis számú csomópontot támogattak. A telepítési folyamat nem mindig zárult le sikeresen, bizonyos lépéseket újra kellett indítani, voltak problémák a régebbi verziókból való frissítéssel, az adatok nem mindig jelentek meg helyesen a GUI-ban (bár most sem vagyok elégedett a teljesítménygrafikonok megjelenítésével), néha problémák merültek fel a virtualizációval kapcsolatban.
Most minden gyerekbetegséget kijavítottak, a HyperFlex tudja az ESXi-t és a Hyper-V-t is, ráadásul lehetséges:
- Kiterjesztett klaszter létrehozása.
- Irodák számára klaszter létrehozása Fabric Interconnect használata nélkül, két-től négy csomópontig (csak a szervereket vásároljuk).
- Lehetőség külső tárolórendszerekkel való együttműködésre.
- Konténerek és Kubernetes támogatása.
- Hozzáférhetőségi zónák létrehozása.
- Integráció a VMware SRM-mel, ha a beépített funkció nem megfelelő.
Az architektúra nem különbözik túlságosan a fő versenytársak megoldásaitól, nem alkottak új keréket. Az egész a VMware vagy Hyper-V virtualizációs platformon működik. Hardveresen a Cisco UCS saját fejlesztésű szerverein helyezkedik el. Vannak, akik gyűlölik a platformot a kezdeti konfiguráció viszonylagos bonyolultsága, a sok gomb, a nem triviális sablon- és függőségi rendszer miatt, de vannak olyanok is, akik megértették a lényeget, átérezték az ötletet, és már nem akarnak más szerverekkel dolgozni.
Kifejezetten a VMware megoldásával foglalkozunk, mivel a megoldás eredetileg erre lett kifejlesztve, és nagyobb funkcionalitással bír; a Hyper-V-t menet közben finomították, hogy ne maradjon le a versenytársaktól és megfeleljen a piaci elvárásoknak.
Van egy klaszterünk szerverekből, amelyek tele vannak meghajtókkal. Vannak adatok tárolására szolgáló meghajtók (SSD vagy HDD — az Ön ízlése és igényei szerint), és egy SSD meghajtó a gyorsításhoz. Amikor adatokat írunk a datastore-ba, az adatok a gyorsító rétegen (a dedikált SSD meghajtó és a szolgáltatás VM RAM-ja) kerülnek mentésre. Párhuzamosan egy adatblokk küldésre kerül a klaszter csomópontjaira (a csomópontok száma a klaszter replikációs tényezőjétől függ). Miután minden csomópont megerősítette a sikeres írást, a megerősítés az hypervisorhoz és a VM-hez kerül. A háttérben mentett adatokat deduplikálják, tömörítik és tárolásra kerülnek a meghajtókra. Ennek során a tároló meghajtókra mindig egy nagy blokként írják, sorban, ami csökkenti a tároló meghajtók terhelését.
A deduplikáció és a tömörítés folyamatosan bekapcsolva van, és nem lehet kikapcsolni őket. Az adatok olvasása közvetlenül a tároló meghajtókról vagy a RAM gyorsítóból történik. Ha hibrid konfigurációt használnak, az olvasás szintén az SSD meghajtón van gyorsítva.
Az adatok nincsenek rögzítve a virtuális gép aktuális helyéhez, és egyenletesen oszlanak el a csomópontok között. Ez a megközelítés lehetővé teszi, hogy az összes meghajtót és hálózati interfészt egyenletesen terheljünk. Nyilvánvaló hátrány, hogy nem tudjuk maximálisan csökkenteni az olvasási késleltetést, mivel nincs garancia arra, hogy az adatok helyben vannak. De úgy vélem, hogy ez elhanyagolható áldozat a nyert előnyökhöz képest. Főleg, hogy a hálózati késleltetések olyan értékeket értek el, hogy szinte nem befolyásolják az összesített eredményt.
A disk subsystem's overall functionality is managed by a dedicated service VM, the Cisco HyperFlex Data Platform controller, which is created on each storage node. In our configuration, the service VM was allocated eight vCPUs and 72 GB of RAM, which is quite substantial. Just to remind you, the host itself has 28 physical cores and 512 GB of RAM.
The service VM has direct access to the physical disks through SAS-controller passthrough into the VM. Communication with the hypervisor occurs via a special IOVisor module, which intercepts input-output operations, and through an agent that allows commands to be sent to the hypervisor's API. The agent is responsible for working with HyperFlex snapshots and clones.
In the hypervisor, the disk resources are mounted as NFS or SMB shares (depending on the type of hypervisor, guess which is which). Under the hood, it’s a distributed file system that allows adding features of mature full-fledged storage systems: thin provisioning, compression, deduplication, Redirect-on-Write snapshots, synchronous/asynchronous replication.
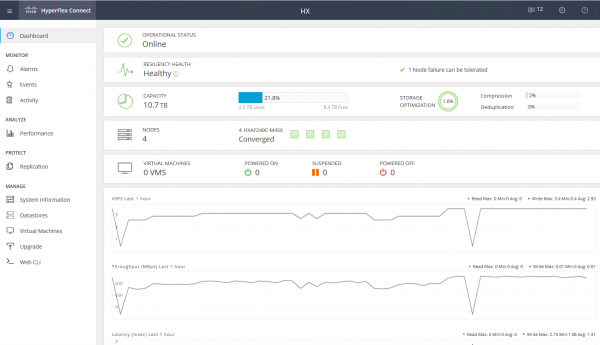
The service VM provides access to the WEB interface for managing the HyperFlex subsystem. There is integration with vCenter, and most everyday tasks can be performed from there, but datastores are more conveniently managed from a separate web interface if you’ve switched to the fast HTML5 interface, or through the full Flash client with complete integration. In the service web interface, you can view system performance and detailed status.
There is another type of node in the cluster—compute nodes. These can be rack-mounted or blade servers without built-in disks. On these servers, you can run VMs whose data is stored on disk servers. From the perspective of data access, there is no difference between the types of nodes, as the architecture abstracts from the physical location of the data. The maximum ratio of compute nodes to storage nodes is 2:1.
Using compute nodes increases flexibility when scaling the cluster's resources: we are not required to purchase nodes with disks if we only need CPU/RAM. Additionally, we can add a blade chassis and save on server rack placement.
As a result, we have a hyper-converged platform with the following features:
- Akár 64 csomópont a klaszterben (akár 32 tárolócsomópont).
- A klaszter minimális csomópontszáma három (kettő az Edge klaszterhez).
- Adat redundancia mechanizmus: tükörképzés 2-es és 3-as replikálási faktornak megfelelően.
- Metro klaszter.
- Aszinkron replikálás másik HyperFlex klaszterre.
- VM-ek átkapcsolásának orchestration-ja távoli adatközpontba.
- Natív pillanatképek Redirect-on-Write technológiával.
- Akár 1 PB hasznos tárhely 3-as replikálási faktornál és deduplikáció figyelembevétele nélkül. A 2-es replikálási faktor nem vehető figyelembe, mivel nem választás komoly kereskedelemhez.
Még egy nagy előny — a kezelés és telepítés egyszerűsége. Az UCS szerverek beállításának minden bonyolultságát egy Cisco mérnökök által elkészített speciális VM vállalja.
Tesztelési környezet konfigurációja:
- 2 x Cisco UCS Fabric Interconnect 6248UP mint irányító klaszter és hálózati komponensek (48 port, 10G Ethernet / 16G FC üzemmódban).
- Négy Cisco UCS HXAF240 M4 szerver.
Szerverek jellemzői:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM / PC4-19200 / duál rangsor / x4 / 1.2v
Hálózat
UCSC-MLOM-CSC-02 (VIC 1227). 2 x 10G Ethernet port
Tárhely HBA
Cisco 12G Modular SAS Pass-through Controller
Tárhely lemezek
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
További konfigurációs lehetőségekA kiválasztott hardveren kívül a következő opciók állnak rendelkezésre:
- HXAF240c M5.
- Egy vagy két CPU Intel Silver 4110-től az Intel Platinum I8260Y-ig. Második generáció készleten.
- 24 memóriahely, modulok 16 GB RDIMM 2600-tól 128 GB LRDIMM 2933-ig.
- 6-23 lemez adatokhoz, egy gyorsítótár lemez, egy rendszer és egy indító lemez.
Kapacitási meghajtók
- HX-SD960G61X-EV 960GB 2.5 inches vállalati érték 6G SATA SSD (1X tartósság) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 inches vállalati érték 6G SATA SSD (1X tartósság) SAS 3.8 TB.
- Gyorsítótár meghajtók
- HX-NVMEXPB-I375 375GB 2.5 inches Intel Optane meghajtó, extrém teljesítmény & tartósság.
- HX-NVMEHW-H1600* 1.6TB 2.5 inches vállalati teljesítmény NVMe SSD (3X tartósság) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 inches vállalati teljesítmény 12G SAS SSD (10X tartósság) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 inches vállalati teljesítmény 12G SAS SED SSD (10X tartósság) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 inches vállalati teljesítmény 12G SAS SSD (3X tartósság).
Rendszer / Napló meghajtók
- HX-SD240GM1X-EV 240GB 2.5 inches vállalati érték 6G SATA SSD (frissítést igényel).
Indító meghajtók
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Kapcsolódás a hálózathoz 40G, 25G vagy 10G Ethernet portokon.
FI-ként HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G) használható.
A teszt magja
A lemezalrendszer teszteléséhez a HCIBench 2.2.1-et használtam. Ez egy ingyenes eszköz, amely lehetővé teszi, hogy automatikusan generáljak terhelést több virtuális gépből. A terhelés normál fio-val generálódik.
A klaszterünk nég csomópontból áll, a replikálási faktor 3, minden lemez Flash.
A teszteléshez négy adatközpontot és nyolc virtuális gépet hoztam létre. A írási tesztek esetében az a forgatókönyv feltételezett, amikor a gyorsítótárazó lemez nem telítődik.
A tesztek eredményei a következők:
100 % Olvasás 100 % Véletlenszerű
0 % Olvasás 100% Véletlenszerű
Blokk/mélységi sor
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
A fél kövér szöveggel jelzett értékek után a teljesítménynövekedés megszűnik, néha még romlás is megfigyelhető. Ez azért van, mert a hálózat/kontrollerek/lemez teljesítményébe ütközünk.
- Folyamatos olvasás 4432 MB/s.
- Folyamatos írás 804 MB/s.
- Egy kontrollert hibásodása esetén (virtuális gép vagy gazdagép hiba) a teljesítmény csökkenése — duplája.
- Ha a tárolólemez hibásodik — a csökkenés 1/3-ra. A lemezek újbóli építése a kontrollerek 5%-át használja.
Kis blokk esetén a vezérlő teljesítményével ütközünk (virtuális gép), a CPU 100%-osan terhelt, a blokk növelésével a portok átviteli sebességébe ütközünk. A 10 Gbit/s nem elegendő az AllFlash rendszerek potenciáljának kihasználásához. Sajnos a megadott bemutató állomás paraméterei nem engedik meg a 40 Gbit/s sebesség ellenőrzését.
A tesztek és az architektúra tanulmányozása alapján úgy vélem, hogy az összes gazdagép közötti adatok elosztását végző algoritmus révén skálázható és kiszámítható teljesítményt kapunk, de ez ugyanakkor korlátozást jelent az olvasásnál, mivel a helyi lemezeken többet is kinyerhetnénk; ezt megoldhatná egy hatékonyabb hálózat, például 40 Gbit/s FI-k állnak rendelkezésre.
Egy lemez a gyorsításhoz és deduplikációhoz szintén korlátozó tényező lehet, mivel ebben a konfigurációban négy SSD lemezre tudunk írni. Jó lenne, ha lehetőség lenne a gyorsítótárazó lemezek számának növelésére, és látnánk a különbséget.
Valódi használat
A biztonsági másolatok elhelyezésére két megközelítést használhatunk (a távoli telephelyre történő biztonsági másolat elhelyezését nem vesszük figyelembe):
- Aktív-Passzív. Minden alkalmazás a fő adatközpontban van elhelyezve. Az replikáció szinkron vagy aszinkron. Ha a fő adatközpont leáll, akkor aktiválnunk kell a tartalékot. Ezt manuálisan/szkriptekkel/orkesztáló alkalmazásokkal lehet elvégezni. Itt kapunk egy RPO-t, amely megegyezik a replikációs frekvenciával, és az RTO a rendszergazda reakciójától és készségeitől, valamint a váltási terv kidolgozottságától/debbugálásától függ.
- Aktív-Aktív. Ebben az esetben csak szinkron replikáció van, az adatközpontok elérhetősége quorum/aritár alapján van meghatározva, amely szigorúan a harmadik helyszínen található. Az RPO = 0, míg az RTO elérheti a 0-t (ha az alkalmazás ezt lehetővé teszi), vagy megegyezik a virtuális klaszterben a nod hibája miatti feldolgozási idővel. A virtualizáció szintjén megnövelt (Metro) klasztert hozunk létre, amely aktív-aktív tárolórendszert igényel.
Általában a klienseknél a klasszikus tárolórendszer architektúráját valósítják meg a fő adatközpontban, ezért tervezünk egy másikat replikációra. Amint említettem, a Cisco HyperFlex aszinkron replikációt és megnövelt virtualizációs klaszter létrehozását kínálja. Ehhez nincs szükség közép- vagy magas szintű dedikált tárolórendszerre, drága replikációs funkciókkal és aktív-aktív hozzáféréssel az adatokhoz a két tárolórendszeren.
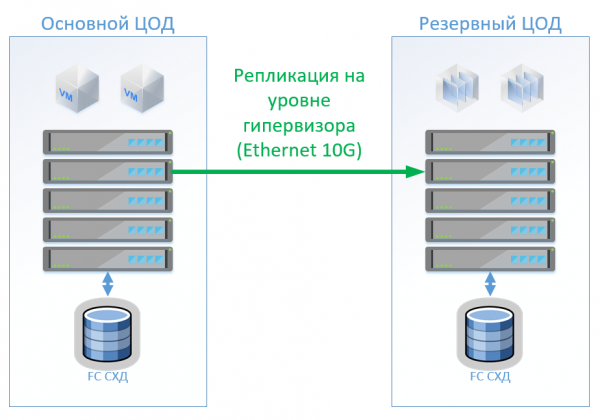
1. Szenárió: Van egy fő és egy tartalék adatközpontunk, a virtualizációs platform VMware vSphere. Minden produktív rendszer a fő adatközpontban található, és a virtuális gépek replikációja a hypervisor szintjén történik, ez lehetővé teszi, hogy a VMs ne maradjanak bekapcsolva a tartalék adatközpontban. Az adatbázisokat és speciális alkalmazásokat beépített eszközökkel replikáljuk, és a VMs-t bekapcsolva tartjuk. Ha a fő adatközpont leáll, akkor elindítjuk a rendszereket a tartalék adatközpontban. Feltételezzük, hogy körülbelül 100 virtuális gépünk van. Amíg a fő adatközpont működik, a tartalék adatközpontban tesztkörnyezeteket és egyéb rendszereket indíthatunk, amelyeket le lehet állítani a fő adatközpont váltása esetén. Lehetséges olyan megoldás is, amikor kétirányú replikációt alkalmazunk. A hardver szempontjából semmi sem változik.
A klasszikus architektúra esetén hibrid tárolórendszert telepítünk minden adatközpontba FibreChannel hozzáféréssel, tieringgel, deduplikációval és tömörítéssel (de nem online), 8 szervert minden helyszínre, 2 FibreChannel és 10G Ethernet switchet. A klasszikus architektúrában a replikáció és az átkapcsolás kezelésére VMware eszközöket (Replication + SRM) vagy egy olcsóbb és időnként kényelmesebb harmadik féltől származó eszközöket is használhatunk.
A képen a séma látható.
Cisco HyperFlex használata esetén a következő architektúra alakul ki:
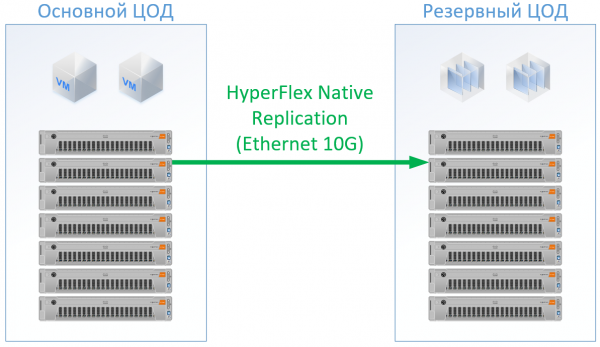
A HyperFlexhez nagy teljesítményű CPU/RAM szervereket használtam, mivel a rendelkezésre álló erőforrások egy része a HyperFlex vezérlőgép virtuális gépéhez megy. CPU és memória szempontjából még egy kicsit túlvállaltam magam a HyperFlex konfigurációban, hogy ne a Cisco irányába terelődjön a dolog, és biztosítsam az erőforrásokat a többi virtuális gép számára. Ezért elhagyhatjuk a FibreChannel switcheket, és nincs szükség Ethernet portokra minden szerverhez, a helyi forgalmat a FI-n belül váltjuk.
Végül a következő konfiguráció jött létre minden adatközpont számára:
Szerverek
8 x 1U Szerver (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Tárolórendszer
Hibrid tárolórendszer FC Front-End-del (20TB SSD, 130 TB NL-SAS)
—
Helyi hálózat
2 x 10G 12 portos Ethernet switch
—
Tárolóhálózat
2 x 32/16Gb 24 portos FC switch
2 x Cisco UCS FI 6332
Licenszek
VMware Ent Plus
Replikáció és/vagy virtuális gépek átkapcsolási orchestrációja
VMware Ent Plus
A Hyperflexhez nem terveztem replikációs szoftverlicenceket, mivel ezek dobozból is rendelkezésre állnak.
A klasszikus architektúra esetében egy olyan beszállítót választottam, amely bizonyította, hogy minőségi és megfizethető gyártó. Mindkét opcióhoz a konkrét megoldásra jellemző kedvezményt alkalmaztam, így valós árat kaptam az eredményre.
A Cisco HyperFlex megoldás 13%-kal olcsóbb lett.
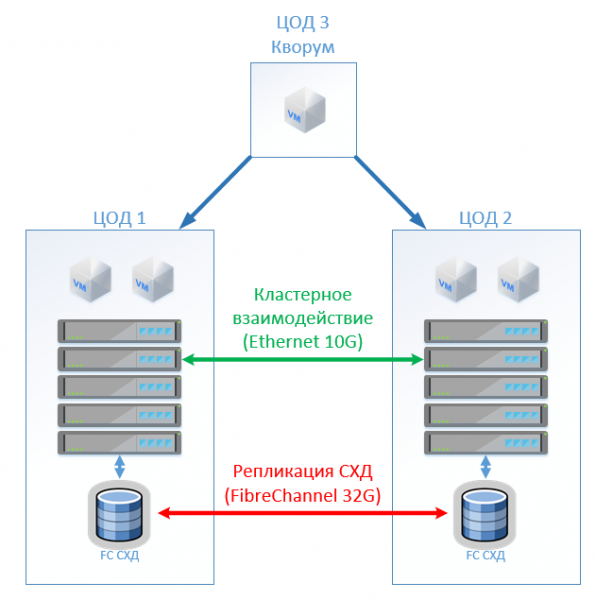
2. szcenárió: két aktív adatközpont létrehozása. Ebben a szcenárióban kiterjesztett klasztert tervezünk a VMware-en.
A klasszikus architektúra virtualizáló szerverekből, SAN-ból (FC protokoll) és két olyan tárolórendszerből áll, amelyek képesek adatokat olvasni és írni azok között, amelyek között vannak. Minden tárolórendszerhez hasznos kapacitást kell terveznünk a helyi hálózaton.
A HyperFlex esetében egyszerűen létrehozunk egy Stretch Cluster-t ugyanannyi node-dal mindkét helyszínen. Ebben az esetben a replikációs faktort 2+2-re használjuk.
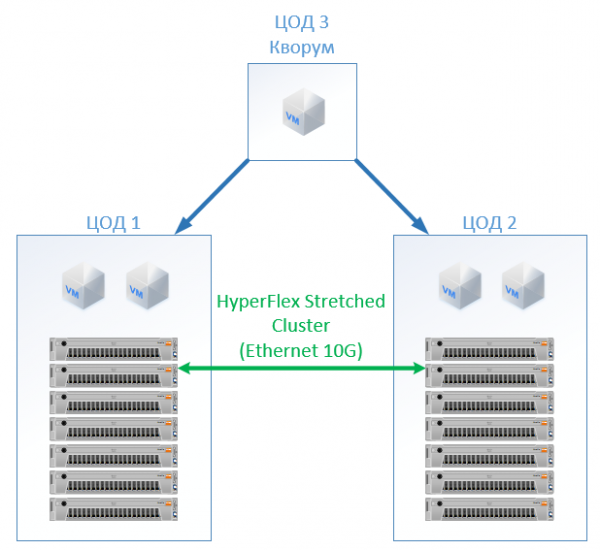
A következő konfiguráció jött létre:
Klasszikus architektúra
HyperFlex
Szerverek
16 x 1U Szerver (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Tárolórendszer
2 x AllFlash tárolórendszer (150 TB SSD)
—
Helyi hálózat
4 x 10G 24 portos Ethernet switch
—
Tárolóhálózat
4 x 32/16Gb 24 portos FC switch
4 x Cisco UCS FI 6332
Licenszek
VMware Ent Plus
VMware Ent Plus
Minden számításomban nem vettem figyelembe a hálózati infrastruktúrát, a datacenter költségeit stb.: ezek azonosak lesznek a klasszikus architektúrával és a HyperFlex megoldással.
A HyperFlex költsége 5%-kal magasabb lett. Itt meg kell jegyezni, hogy a CPU/RAM erőforrásoknál a Cisco esetében eltolódást tapasztaltam, mivel a konfigurációban egyenletesen töltöttem fel a memória vezérlők csatornáit. Az ár kissé magasabb, de nem drasztikusan, ami egyértelműen jelzi, hogy a hiperkonvergencia nem feltétlenül "luxusjáték" a gazdagoknak, hanem versenyképes lehet a standard adatközponti megközelítéssel. Ez érdekes lehet azok számára is, akiknek már vannak Cisco UCS szerverei és a megfelelő infrastruktúrájuk hozzá.
Az előnyök között szerepel a SAN és a tárolórendszer adminisztrációs költségeinek hiánya, az online tömörítés és deduplikáció, egyetlen belépési pont a támogatáshoz (virtualizáció, szerverek, szintén tárolórendszerek), helymegtakarítás (de nem minden forgatókönyvben), az üzemeltetés egyszerűsítése.
A támogatás tekintetében egyetlen gyártótól, a Ciscotól kapja. Ha a Cisco UCS szerverekkel szerzett tapasztalataim alapján ítélek, akkor tetszik a támogatás, a HyperFlex-et soha nem kellett megnyitnom, minden jól működött. Az mérnökök gyorsan válaszolnak, és nemcsak a tipikus problémákat, hanem a bonyolult határhelyzeteket is meg tudják oldani. Néha felkeresem őket kérdésekkel: "Lehet ezt úgy csinálni, hogy ezt csatolom?" vagy "Valamit itt konfiguráltam, és nem akar működni. Segítsen!" - ők türelmesen megtalálják a szükséges útmutatót, és megadják a helyes lépéseket, soha nem válaszolják azt, hogy: "Csak a hardveres problémákat oldjuk meg."
Hivatkozások
- Az e-mail címem: StGeneralov@croc.ru
Forrás: habr.com
