

Üdv, Habr! Ebben a cikkben szeretném bemutatni egy csodálatos eszközt az adatok batch-feldolgozásának fejlesztéséhez, például a vállalati DWH vagy az Ön DataLake infrastruktúrájában. Az Apache Airflow-ról (továbbiakban Airflow) lesz szó. Jogosan el van hanyagolva a Habr-on, és a fő részében megpróbállak meggyőzni arról, hogy a legkevesebb, amit tehetsz, hogy figyelembe veszed az Airflow-t, amikor az ETL/ELT folyamatok ütemezőjét választod.
Korábban írtam egy sor cikket a DWH témájában, amikor a Tinkoff Banknál dolgoztam. Most a Mail.Ru Group csapatának részese lettem, és az adatelemző platformunk fejlesztésével foglalkozom a játékos szegmensben. Amint hírek és érdekes megoldások jelennek meg, a csapatunk erről az adatelemző platformunkról fog beszámolni.
Prológus
Tehát kezdjük. Mi az Airflow? Ez egy könyvtár (vagy ) az üzleti folyamatok kifejlesztéséhez, ütemezéséhez és megfigyeléséhez. Az Airflow alapvető jellemzője, hogy a folyamatok leírásához (fejlesztéséhez) Python nyelven írt kódot használunk. Ez számos előnyt biztosít a projekt szervezéséhez és fejlesztéséhez: a lényeg, hogy az (például) ETL-projekted egyszerűen Python-projekt, és úgy szervezheted, ahogyan szeretnéd, figyelembe véve az infrastruktúra jellemzőit, a csapat méretét és más követelményeket. Az eszközök egyszerűek. Használj például PyCharm-ot + Git-et. Ez csodálatos és nagyon kényelmes!
Most vizsgáljuk meg az Airflow főbb entitásait. Ha megérted azokat, optimálisan szervezheted a folyamatok architektúráját. Talán a legfőbb entitás a Directed Acyclic Graph (DAG).
DAG
A DAG egy értelmes összefoglalója a feladataidnak, amelyeket szigorúan meghatározott sorrendben szeretnél végrehajtani egy adott ütemezés szerint. Az Airflow kényelmes webes felületet kínál a DAG-okkal és más entitásokkal való munkához:
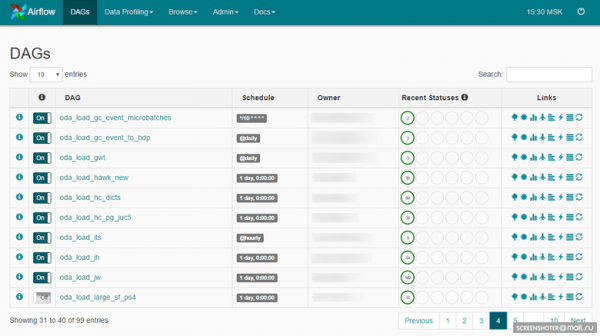
A DAG így nézhet ki:
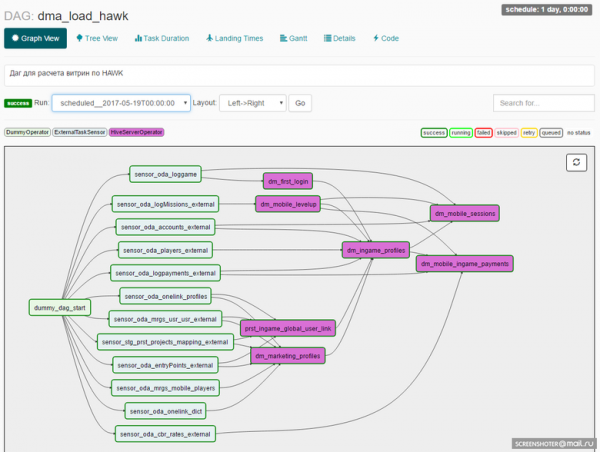
A fejlesztő, amikor a DAG-ot tervez, egy operátorcsoportot határoz meg, amely köré a DAG feladatai épülnek. Itt érkezünk egy másik fontos entitáshoz: az Airflow Operator-hoz.
Operátorok
Az operátor egy entitás, amely alapján feladatpéldányok jönnek létre, ahol le van írva, hogy mi történik a feladatpéldány végrehajtásakor. már tartalmaznak egy kész operátorokból álló készletet. Példák:
- BashOperator — operátor bash parancs végrehajtásához.
- PythonOperator — operátor Python kód hívásához.
- EmailOperator — operátor email küldésére.
- HTTPOperator — operátor http kérések kezelésére.
- SqlOperator — operátor SQL kód végrehajtására.
- Sensor — eseményre váró operátor (a szükséges idő, a szükséges fájl, adatbázisbeli sor, API válasz, stb. megjelenése).
Vannak specifikusabb operátorok is: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
Ön is fejleszthet operátorokat, figyelembe véve saját sajátosságait, és használhatja őket a projektben. Például létrehoztunk egy MongoDBToHiveViaHdfsTransfer operátort, amely dokumentumokat exportál a MongoDB-ből a Hive-ba, valamint több operátort a következőkhöz: CHLoadFromHiveOperator és CHTableLoaderOperator. Alapvetően, amikor a projektben gyakran használt kód jelenik meg, amely alap operátorokon alapul, érdemes megfontolni annak összegyűjtését egy új operátorba. Ez megkönnyíti a további fejlesztést, és bővítheti az operátor könyvtárát a projektben. Most pedig minden egyes feladatpéldányt végre kell hajtani, és most a ütemezőről lesz szó.
Az Airflow feladatütemezője
Scheduler
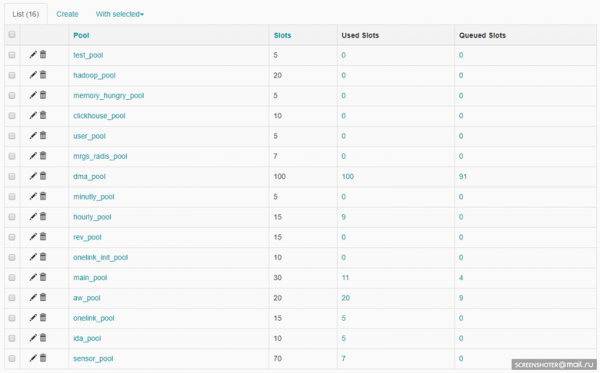
Celery Minden poolnak korlátozása van a slotok számát illetően. A DAG létrehozásakor meg kell adni egy poolt:
ALERT_MAILS = Variable.get("gv_mail_admin_dwh") DAG_NAME = 'dma_load' OWNER = 'Vasya Pupkin' DEPENDS_ON_PAST = True EMAIL_ON_FAILURE = True EMAIL_ON_RETRY = True RETRIES = int(Variable.get('gv_dag_retries')) POOL = 'dma_pool' PRIORITY_WEIGHT = 10start_dt = datetime.today() - timedelta(1) start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)default_args = { 'owner': OWNER, 'depends_on_past': DEPENDS_ON_PAST, 'start_date': start_dt, 'email': ALERT_MAILS, 'email_on_failure': EMAIL_ON_FAILURE, 'email_on_retry': EMAIL_ON_RETRY, 'retries': RETRIES, 'pool': POOL, 'priority_weight': PRIORITY_WEIGHT } dag = DAG(DAG_NAME, default_args=default_args) dag.doc_md = __doc__
A DAG szinten megadott pool felülírható a feladat szintjén.A DAG szinten megadott pool felülírható a feladat szintjén.
Az Airflow összes feladatának tervezéséért egy külön folyamat a Scheduler felel. A Scheduler a feladatok végrehajtására való beállítás mechanikájával foglalkozik. A feladat, mielőtt végrehajtásra kerülne, több lépésen megy keresztül:
- A DAG-ben a korábbi feladatok teljesültek, az újat a sorba lehet állítani.
- A sor a feladatok prioritása szerint van rendezve (a prioritást szintén lehet kezelni), és ha van szabad slot a poolban, a feladat munkára vehető.
- Ha van szabad celery worker, a feladat arra irányul; megkezdődik a munka, amelyet a feladaton programoztál, az adott operator segítségével.
Egyszerűen elég.
A Scheduler számos DAG-ban és a DAG-okban található összes feladaton dolgozik.
Ahhoz, hogy a Scheduler elkezdje a munkát a DAG-gal, a DAG-nak ütemezést kell adni:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Kész készlet áll rendelkezésre: @once, @hourly, @daily, @weekly, @monthly, @yearly.
Cron kifejezéseket is használhatunk:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*\/10 * * * *')Végrehajtási dátum
Ahhoz, hogy megértsük, hogyan működik az Airflow, fontos tudni, mi az Execution Date egy DAG számára. Az Airflow-ban a DAG-nak van egy Execution Date dimenziója, azaz a DAG ütemezésének megfelelően feladatpéldányok jönnek létre minden Execution Date-hoz. Minden Execution Date-hez a feladatokat újra végrehajthatjuk — vagy például a DAG több Execution Date-en is párhuzamosan működhet. Ez itt világosan látható:
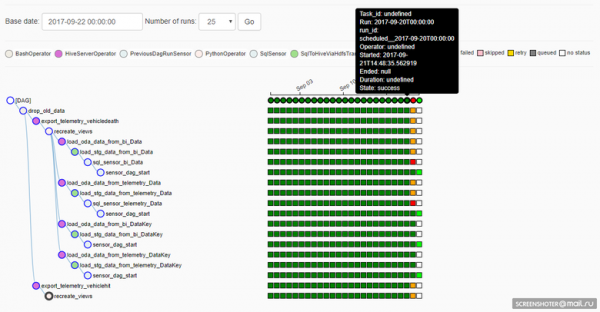
Sajnos (vagy talán szerencsére: a helyzettől függ), ha egy feladat implementációja megváltozik a DAG-ban, akkor a korábbi Execution Date-k végrehajtása már a módosítások figyelembevételével történik. Ez jó, ha át kell számolni az adatokat a múltbeli időszakokban egy új algoritmussal, de rossz, mert így elveszik az eredmény reprodukálhatósága (természetesen senki sem akadályozhatja meg, hogy a Git-ből visszaállítsd a szükséges forrást, és egyszeri számítást végezz, úgy, ahogyan szükséges).
Feladatok generálása
A DAG implementálása Python kód, így nagyon kényelmes módon csökkenthetjük a kód mennyiségét, például shardolt források használata esetén. Legyen három MySQL shardod forrásként, amelyekben el kell érni és adatokat kell begyűjteni. Ráadásul függetlenül és párhuzamosan. A Python kód a DAG-ban így nézhet ki:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='\/data\/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
A DAG így néz ki:
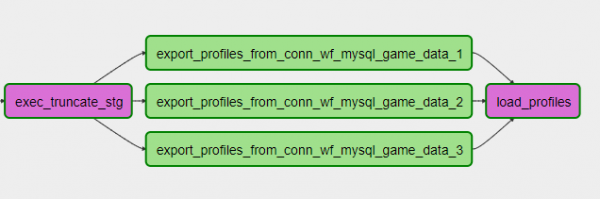
Közben sharded-t hozzáadhatunk vagy eltávolíthatunk, ha csak módosítjuk a beállítást és frissítjük a DAG-ot. Ez kényelmes!
Bonyolultabb kódgenerálást is használhat, például dolgozhat adatbázisok forrásaként vagy leírhat táblázatos struktúrát, azzal a céllal, hogy az adatokkal dolgozás infrastruktúrájának sajátosságaival figyelembe véve generálja a folyamatot, amely N táblát tölt be az adattárába. Vagy például, ha egy API-val dolgozik, amely nem támogatja a listás paraméterek kezelését, akkor ebből a listából N feladatot generálhat a DAG-ban, korlátozhatja az API lekérdezéseinek párhuzamosságát egy pool-lal, és begyűjtheti a szükséges adatokat az API-ból. Rugalmas!
Tárhely
Az Airflow-nak van saját backend tárhelye, adatbázisa (lehet MySQL vagy Postgres, nálunk Postgres), amelyben a feladatok, DAG-ok állapotát, a kapcsolatok beállításait, globális változókat stb. tárolják. Itt azt szeretném megemlíteni, hogy az Airflow tárhelye nagyon egyszerű (kb. 20 táblázat) és kényelmes, ha valamilyen folyamatot szeretne felépíteni köré. Eszembe jutnak az Informatica tárhelyében lévő 100500 táblázat, amelyeket hosszú ideig kellett tanulmányozni, mielőtt megértettem, hogyan kell lekérdezést építeni.
Monitorozás
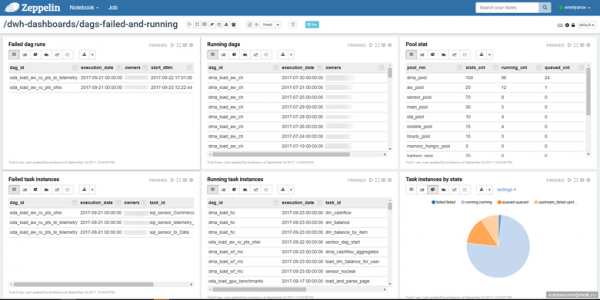
Figyelembe véve a tároló egyszerűségét, saját kényelmes folyamatot építhet a feladatok monitorozására. Mi a Zeppelint használjuk, ahol a feladatok állapotát figyeljük:
Ez lehet magának az Airflow-nak a webes felülete is:
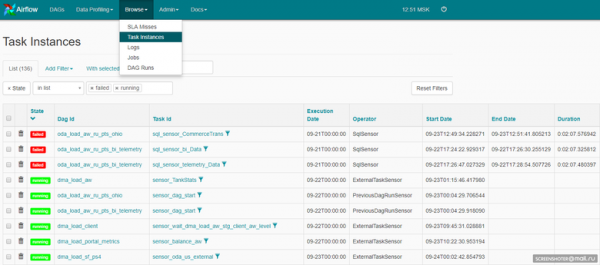
Az Airflow kódja nyilvános, ezért mi beépítettük az értesítést Telegramra. Minden működő feladatpéldány, ha hiba történik, spamolja a csapatunk Telegram csoportját, amelyben a fejlesztői és támogató csapat minden tagja benne van.
A Telegramon keresztül gyors reagálást kapunk (ha szükséges), a Zeppelinen keresztül pedig általános képet kapunk az Airflow-ban lévő feladatokról.
Összesen
Az Airflow elsősorban nyílt forráskódú, és nem kell csodáktól várni tőle. Készüljön fel arra, hogy időt és energiát kell fordítania egy működő megoldás kiépítésére. A cél megvalósítható, higgye el, megéri. A fejlesztési sebesség, a rugalmasság, az új folyamatok könnyű hozzáadása — Ön is fogja kedvelni. Természetesen sok figyelmet kell fordítani a projekt szervezésére és az Airflow stabil működésére: csodák nincsenek.
Jelenleg az Airflow naponta körülbelül 6500 feladatotgyakorol. A jellegük elég különböző. Vannak feladatok, amelyek adatokat töltenek be a fő DWH-ba sok különböző és nagyon specifikus forrásból, vannak feladatok a bemutatható adatok kiszámítására a fő DWH-n belül, vannak feladatok az adatok publikálására a gyors DWH-ba, és sok-sok különböző feladat van — az Airflow mindezeket nap mint nap megoldja. Ha számokban beszélünk, akkor ez 2300 különböző összetettségű ELT feladat a DWH-n belül (Hadoop), körülbelül 250 forrást jelent, ez egy csapatot jelent négy ETL fejlesztőből, akik az ETL adatok folyamatába a DWH-ban és az ELT adatok folyamatába a DWH-n belül oszlanak meg, és természetesen még egy adminisztrátort, aki a szolgáltatás infrastruktúrájával foglalkozik.
Jövőbeli tervek
A folyamatok száma elkerülhetetlenül növekszik, és a fő feladatunk az Airflow infrastruktúrájának terén — a skálázás. Szeretnénk egy Airflow klasztert felépíteni, kiemelni néhány lábat a Celery munkásoknak és létrehozni egy duplicált fejet a feladatok ütemezéséhez és a tárolóhoz.
Epilógus
Ez természetesen messze nem minden, amit szerettem volna megosztani az Airflow-ról, de a főbb pontokat próbáltam megvilágítani. Az étvágy az evés közben jön, próbálja ki — és tetszeni fog 🙂
Forrás: habr.com
