

A kurzus indítása előtt még egy hasznos anyag fordítását készítettük el önöknek.
A Huffman-kódolás egy adatsűrítési algoritmus, amely a fájlok tömörítésének alapvető ötletét fogalmazza meg. Ebben a cikkben a fix és változó hosszúságú kódolásról, az egyértelműen dekódolható kódokról, a prefix szabályokról és a Huffman-fák felépítéséről fogunk beszélni.
Tudjuk, hogy minden egyes karakter egy 0 és 1 sorozat formájában van tárolva, és 8 bitet foglal el. Ezt fix hosszúságú kódolásnak nevezik, mivel minden karakter ugyanannyi fix bitet használ a tároláshoz.
Tegyük fel, hogy van egy szövegünk. Hogyan csökkenthetjük a szükséges teret egy karakter tárolásához?
A fő ötlet a változó hosszúságú kódolás. Felhasználhatjuk azt a tényt, hogy egyes karakterek a szövegben gyakrabban fordulnak elő, mint mások (), hogy kifejlesszünk egy algoritmust, amely ugyanazt a karakterláncot kevesebb bitből képviseli. A változó hosszúságú kódolás során a karakterekhez a megjelenésük gyakorisága alapján változó számú bitet rendelünk. Végül egyes karakterek csk 1 bitet foglalhatnak el, míg mások 2, 3 vagy annál több bitet. A változó hosszúságú kódolás problémája csak a sorozat későbbi dekódolásával kapcsolatos.
Hogyan lehet a bit-sorozat ismeretében egyértelműen dekódolni?
Tekintsük a következő karakterláncot „aabacdab“. 8 karaktert tartalmaz, és fix hosszúságú kódolás esetén 64 bit szükséges a tárolásához. Észrevehetjük, hogy a karakterek frekvenciája „a“, „b“, „c“, és „d“ 4, 2, 1, 1 egyaránt. Próbáljuk meg kevesebb bitből ábrázolni azt a tényt, hogy „aabacdab“ „a“ gyakrabban fordul elő, mint „b“. Kezdjük azzal, hogy a, és Kezdjük azzal, hogy a „b“. «c» és „d“0-ás bitút kódoljuk, gyakrabban fordul elő, mint a kettőbites kódot 11-nek, míg a hárombites kódot 100-nak és 011-nek kódoljuk. Kezdjük azzal, hogy a Végül a következőket kapjuk: «c» és „d“.
Így a karakterláncot
a
0
b
11
c
100
d
011
a fent bemutatott kódok használatával kódoljuk. Az alapvető probléma azonban a dekódolás lesz. Amikor megpróbáljuk dekódolni a karakterláncot, „aabacdab“ ellentmondásos eredményhez jutunk, mivel az a következőképpen is ábrázolható: 00110100011011 (0|0|11|0|100|011|0|11)0|011|0|100|011|0|11 adacdab 0|0|11|0|100|0|11|011 aabacabd 0|011|0|100|0|11|0|11 adacabab 00110100011011érdekes számadatokat és eredményeket mutatnak.
Másrészről az egyes kódok téves értelmezése konfúziót okozhat a dekódolási folyamat során.
…
stb.
A bizonytalanság elkerülése érdekében biztosítanunk kell, hogy a kódolásunk kielégítse azt a fogalmat, mint a prefixszabály, amely a maga részéről azt jelenti, hogy a kódokat egyedül egyetlen módon lehet dekódolni. A prefixszabály biztosítja, hogy egy kód semmilyen más kód prefixe ne legyen. Kód alatt a konkrét karakterek ábrázolásához használt biteket értjük. A fenti példában 0 – egy prefix 011, amely megsérti a prefixszabályt. Tehát, ha a kódjaink megfelelnek a prefixszabálynak, akkor egyértelműen dekódolhatóak (és fordítva).
Nézzük át a fenti példát. Ezúttal karaktereknek „a“, „b“, „c“, és „d“ olyan kódokat rendelünk, amelyek megfelelnek a prefixszabálynak.
a
0
b
10
c
110
d
111
Ezzel a kódolással a sor „aabacdab“ úgy lesz kódolva, mint 00100100011010 (0|0|10|0|100|011|0|10)De a 00100100011010 már egyértelműen dekódolhatjuk, és visszatérhetünk az eredeti sorunkra „aabacdab“.
Huffman-kódolás
Most, hogy foglalkoztunk a változó hosszúságú kódolással és a prefixszabállyal, beszéljünk a Huffman-kódolásról.
A módszer a bináris fák létrehozásán alapul. A fa egy csomópontja lehet végső vagy belső. Kezdetben minden csomópont levélnek (végsőnek) számít, amely az adott karaktert és annak súlyát (azaz gyakoriságát) képviseli. A belső csomópontok a karakter súlyát tartalmazzák, és hivatkoznak két örökölt csomóra. Általános megállapodás szerint a "0" bit "0" a bal ágon való haladást, míg a "1" a jobb ágon való haladást jelenti. A teljes fában N levelek és N-1 belső csomópont található. Ajánlott, hogy a Huffman-fának való építés során kizárják a fel nem használt karaktereket az optimális hosszúságú kódok megszerzése érdekében.
Prioritásos sort fogunk használni a Huffman-fa felépítésére, ahol a legkisebb gyakorisággal rendelkező csomópont a legmagasabb prioritást kap. Az alábbiakban a felépítés lépéseit írjuk le:
- Hozzunk létre levélcsomópontot minden karakterhez, és adjuk hozzá őket a prioritásos sorhoz.
- Amíg a sorban több mint egy levél van, végezzük el a következőket:
- Távolítsuk el a legmagasabb prioritású (legalacsonyabb gyakoriságú) két csomópontot a sorból;
- Hozzunk létre egy új belső csomópontot, ahol ezek a két csomópont az örökösök, és a megjelenési gyakoriság a két csomópont gyakoriságának összegével egyenlő lesz.
- Adjunk hozzá egy új csomópontot a prioritásos sorhoz.
- Az utolsó megmaradt csomópont gyökér lesz, ezzel befejeződik a fa felépítése.
Tegyük fel, hogy van egy szövegünk, amely csak a következő karakterekből áll: „a”, „b”, „c”, „d” és „e”, és ezek előfordulásának frekvenciája 15, 7, 6, 6 és 5. Az alábbiakban ábrák láthatók, amelyek tükrözik az algoritmus lépéseit.
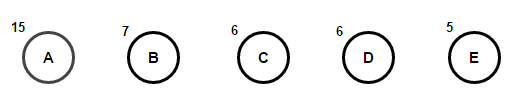
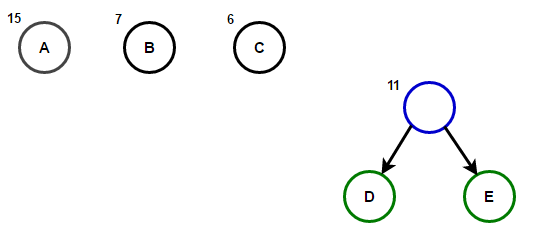
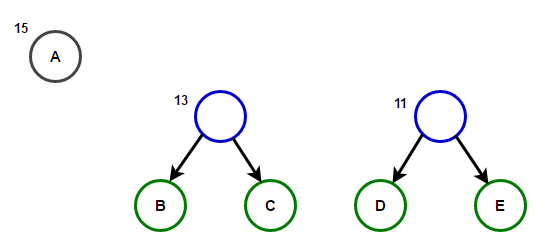
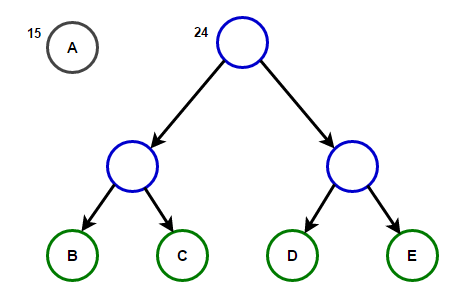
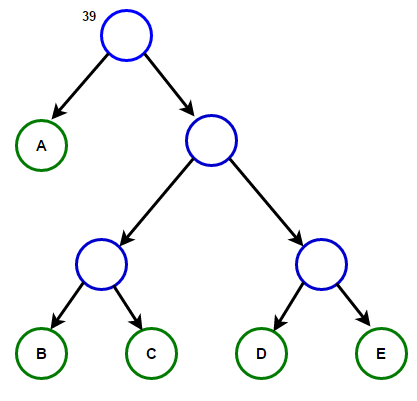
A gyökértől bármely levélcsomópontig vezető út tárolni fogja az optimális prefixkódot (más néven Huffman-kódot), amely megfelel a kapcsolódó levélcsomópontnak.
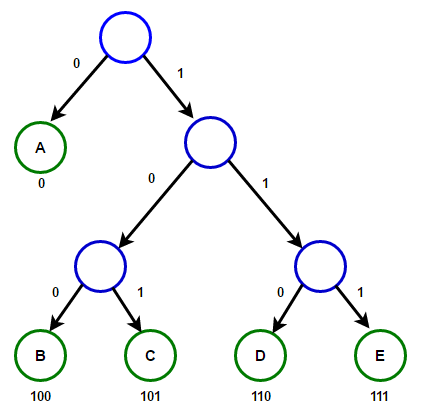
Huffman-fa
Itt megtalálja a Huffman-tömörítési algoritmus megvalósítását C++ és Java nyelveken:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Egy fa csomópont
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// Bejárja a Huffman fát és tárolja a Huffman kódokat
// egy térképen.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// Megtaláltunk egy levél csomópontot
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// Bejárja a Huffman fát és dekódolja a kódolt karakterláncot
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// Megtaláltunk egy levél csomópontot
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Felépíti a Huffman fát és a huffmanCode-t és dekódolja az adott szöveget
public static void buildHuffmanTree(String text)
{
// Megszámolja, hogy a karakterek hányszor jelennek meg
// és eltárolja egy térképen
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Létrehoz egy prioritási sort, hogy tárolja a Huffman fát
// Vegye észre, hogy a legmagasabb prioritású elemnek a legkisebb a frekvenciája
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Létrehoz egy levél csomópontot minden karakterhez,
// és hozzáadja a prioritási sorhoz.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// Folytassa, amíg több mint egy csomópont van a sorban
while (pq.size() != 1)
{
// Eltávolítja a legmagasabb prioritású két csomópontot
// (legalacsonyabb frekvencia) a sorból
Node left = pq.poll();
Node right = pq.poll();
// Létrehoz egy új belső csomópontot ezekkel a két csomóponttal mint gyermekek
// és a frekvenciájuk összegével. Hozzáadja az új csomópontot a prioritási sorhoz.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// A gyökér tárolja a Huffman fa gyökere vektorát
Node root = pq.peek();
// Bejárja a Huffman fát és tárolja a Huffman kódokat egy térképen
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// Kiírja a Huffman kódokat
System.out.println("A Huffman kódok:");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("Eredeti szöveg: " + text);
// Kiírja a kódolt szöveget
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("A kódolt szöveg: " + sb);
// Újra bejárja a Huffman fát, és ez alkalommal
// dekódolja a kódolt szöveget
int index = -1;
System.out.println("Dekódolt szöveg: ");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "A Huffman-kódolás egy adatok tömörítésére szolgáló algoritmus.";
buildHuffmanTree(text);
}
}Megjegyzés: A bemeneti sor által használt memória 47 * 8 = 376 bit, míg a kódolt sor mindössze 194 bitet foglal el, azaz az adatok körülbelül 48%-kal zsugorodnak. A fent bemutatott C++ programban a kódolt sor tárolására a string osztályt használjuk, hogy a program olvasható legyen.
Mivel a hatékony prioritási sorok adatstruktúrái beszúráshoz O(log(N)) időt igényelnek, és a teljes bináris fában N levelei 2N-1 csomópontot tartalmaz, és a Huffman-faként ismert fát egy teljes bináris fa alkotja, így az algoritmus O(Nlog(N)) idő alatt működik, ahol N – a karakterek száma.
Források:
Forrás: habr.com
